
编译原理 第七章——语义分析和中间代码生成
中间语言
常见的中间语言的形式: 后缀式(逆波兰式) 三地址代码 - 三元式 - 四元式 - 间接三元式 DAG图
后缀式
又称逆波兰表示法,把运算量(操作数)写在前面,把算 符写在后面(后缀)。 如:a+b 写成 ab+ a+b*c 写成 abc*+ 定义: 1.如果表达式E是一个变量或常量,则E的后缀式是E自身; 2.如果E是E1 op E2形式的表达式 (op为二元操作符) ,则E的 后缀式为E1’E2’op。E1’ 、E2’分别为E1、E2的后缀式; 3.如果E式(E1)形式的表达式,则E1的后缀式就是E的后缀式。 •这种表达式不需要括号 这种表达式不需要括号
(0) (=[ ],x,i) (1) (:=,(0),y)
([ ]=,y,-,x[i]) //变址存数四元式
(0) ( [ ]=,y,i) (1) (:=,x,(0))
(=[ ],y[i] ,-,x) //变址取数四元式
如a:=b*-c+b*-c
四元式
op (0) (1) (2) (3) (4) (5) arg1 arg2 resul t T1 uminus C
如a*(b+c) 写成 abc+* (a+b)*(c+d) 写成 ab+cd+*
* a b + c a + b c *
+
d
将表达式翻译为后缀式的语义规则
产生式
E→E1 op E2 E→(E) E→id
语义规则
E.code:=E1.code||E2.code|| op E.code:=E1.code E.code:=id
a:=b*-c+b*-c的三地址代码为:
T1 := -c T2 :=b*T1 T3 := -c T4 :=b*T3 T5 :=T2 +T4 a := T5
对于抽象语法树的代码 c c b * uminus b * uminus a assign
+
a:=b*-c+b*-c的三地址代码为:
T1 := -c T2 :=b*T1 T5 :=T2 +T2 a := T5
按行存放
A[1,1] A[1,2] A[2,1] A[2,2]
多维数组的地址计算
二维数组若按行存放:A[i1,i2]的相对地址为: ((i1×n2)+i2)×w+(base-(low1×n2)+low2)×w
在编译时可确定
将数组元素加入赋值语句后的翻译模式 在算术表达式中,当有两种不同类型的量进行运 算时,如整型量和实型量,规定首先必须把整型 转换成实型。
数组元素的引用
数组在存储器中的存放方式决定了数组元素的地址 计算法。 ①若数组存放在一片连续单元。假设A每个元素宽度为 w,则A[i]的起始地址为: base+(i-low)×w=i×w+(base-low×w)
记为C,可在数组说明时计算出来
②多维数组:按列存放
A[1,1] A[2,1] A[1,2] A[2,2]
assign • id a + • * • • • • 或
0 1 2 3
* • •
id id uminu s * id id uminu s * + id ……
b c 1 0 b c 5 4 3 a 8 6 7 2
4 5 6 7 8 9 10 11
id b uminus • id c
id b uminus • id c
(1) (4) (5)
(3) (4) (5)
:= * :=
X D Y
(2) (1) (4)
•当要调整运算顺序时,只需要重新安排间接码表。
说明语句
说明语句的翻译模式 P→D D→D;D D→id:T T→integer T→real T→array[num] of T1 T→↑T1 {offset:=0} {enter(,T.type,offset); offset:=offset+T.width} {T.type:=integer T.width:=4} {T.type:=real T.width:=8} {T.type:=array(num.val,T1.type); T.width:=num.val×T1.width} {T.type:=pointer(T1.type); T.width:=4}
赋值语句的翻译 1.简单算术表达式和赋值语句
S →id := E E→E1+E2 E→E1*E2 → E→ - E1 E→( E1) E→id { P:=lookup () ; if P≠nil then emit( P“:=”E.place) else error } {E.place:= newtemp; emit(E.place“:=” E1.place“+”E2.place)} {E.place:= newtemp; emit(E.place“:=” E1.place“*”E2.place)} { E.place:=newtemp; emit(E.place“:=”“uminus” E1.place)} { E.place:= E1.place} {E.place:=newtemp; P:=lookup(); if P≠nil then E.place:=P else error}
布尔表达式的翻译
三地址语句的种类
X :=Y op Z X := op Y X :=Y goto L if x relop y goto L 或if a goto L 用于过程调用的param x 和call p,n及 return y x :=y[i] 及 x[i] :=y x :=&y, x :=*y, *x :=y
T1:=y*20 T1:=T1+z T2:=A-84 T3:=4*T1 T2[T3]:= X
布尔表达式的翻译
布尔表达式的两个基本作用: -用于计算逻辑值 -用于控制流语句中的条件表达式 布尔表达式是用布尔运算符号(and,or,not)作用到 布尔变量或关系表达式上组成的。 关系表达式:E1 relop E2 relop为关系运算符 规定优先级not,and,or依次降低。
assign 9
三地址代码
三地址代码是由下面一般形式的语句构成的序列: X :=Y op Z。其中,X,Y,Z为名字,常数或编译时 产生的临时变量,op代表运算符号。 每个语句右边只能有一个运算符。
如:x+y*z 可翻译为: x+y z
T1 :=y*z T2 :=x+T1
T1,T2为编译时产生的临时变量。
E.code表示E的后缀式,op为二元操作符,“||”表示 后缀形式的连接。
图表示法
DAG 抽象语法树
DAG: 无循环有向图。对表达式的每个子表达式, DAG中都有一个结点。一个内部结点代表一个操作符, 它的孩子代表操作数。 在一个DAG图中,代表公共子表达式的结点具有多个 + 父结点。 如表达式a+a*(b-c)+(b-c)*d的DAG图为: +
对于DGA的代码 b a assign
+
* uminus c
a:=b*-c+b*-c的三地址代码为:
T1 := -c T2 :=b*T1 T3 := -c T4 :=b*T3 T5 :=T2 +T4 a := T5
对于抽象语法树的代码 对于DGA的代码
T1 := -c T2 :=b*T1 T5 :=T2 +T2 a := T5
S →L:= E
E→E1+st →Elist1,E
Elist →id[E
{ if L.offset=null then emit( L.place“:=”E.place) else emit( L.place ‘[’ L.offset ‘]’ ‘:=’E.place)} { E.place := newtemp; emit(E.place ‘:=’ E1.place ‘+’ E2.place)} { E.place:= E1.place} { if L.offset=null then E.place:=L.place; else begin E.place := newtemp; emit(E.place ‘:=’ L.place ‘[’ L.offset ‘]’ ) end} { L.place := newtemp; emit(L.place ‘:=’ Elist.array-C L.offset := newtemp; emit(L.offset ‘:=’ w ‘*’Elist.place)} { L.place:= id.place; L.offset := null } {t := newtemp; m := Elist1.ndim+1; emit(t ’:=’ Elist1.place ‘*’ limit(Elist1.array,m)); emit(t ‘:=’ t ’+’ E.place); Elist.array := Elist1.array; Elist.place := t; Elist.ndim := m} {Elist.place := E.place; Elist.ndim := 1; Elist.array := id.place }
x:=A[y,z]
设A为10×20的数组,w=4,则 x:=A[y,z]的三地址语句序列为:
T1:=y*20 T1:=T1+z T2:=A-84 T3:=4*T1 T4:=T2[T3] X:=T4
84=C=(1×20+1)×4
设A为10×20的数组,w=4,则 A[y,z] := x 的三地址语句序列为:
* a b - c * d
又如 a:=b*-c+b*-c
DAG图 assign a
+
抽象语法树 assign a * uminus c b uminus c b
语义分析和中间代码生成

7.1 中 间 语 言
本书常用的三地址语句
• 赋值语句x := y op z, x := op y, x := y
• 无条件转移goto L • 条件转移if x relop y goto L • 过程调用param x 和call p , n • 过程返回 return y • 索引赋值x := y[i]和 x[i] := y • 地址和指针赋值x := &y,x := y和x := y
7.2 说 明 语 句
处理嵌套过程中的说明语句
P M D {addwidth (top (tblptr), top (offset) ); pop(tblptr); pop (offset) }
M {t := mktable (nil); push(t, tblprt); push (0, offset) }
• (3)
x: integer;
• (4)
procedure readarray
• (5)
var i: integer;
• (6)
begin…a…end{readarray}
• (7)
procedure exchange(i,j:integer);
• (8)
begin
• (9)
x:=a[i]; a[i]:=a[j]; a[j]:=x
二维数组 • 列为主
A[1, 1], A[2, 1], A[1, 2], A[2, 2], A[1, 3], A[2, 3]
整理课件
7.3 赋 值 语 句
二维数组 • 列为主
A[1, 1], A[2, 1], A[1, 2], A[2, 2], A[1, 3], A[2, 3] • 行为主
程序设计语言编译原理第三版第7章

N→ Є
D →id: T { enter(top(tblptr), , T.type, top(offset)); top(offset):= top(offset) +T.width } 24
§7.2
说明语句
2.含嵌套说明的翻译模式:
(1)语义规则中的操作: Mktable (previous): 创建一张新符号表,并返回指向新表的一个指针; Enter (table, name, type, offset):
(2)置相对地址为当前offset之值, (3)使offset加上该名字所表示的数据对象的域宽。
20
§7.2 说明语句
3. 相应的翻译模式:
PD { offset:=0 } { enter (, T.type,offset);
DD;D
Did:T
offset:=offset+t.width } Tinteger
(0) (1) (2) (3) (4) (5)
(2) (3) (4)
16
§7.1 中间语言
4.间接三元式:便于代码优化处理
方法:间接码表+三元式表
按运算的先后顺序列出有关三元式在三元表中的位置 例: 语句X:=(A+B)*C;Y:=D↑(A+B)的间接三元式表示如下所示: 间接代码 三元式表 (1) (2) (3) (1) (4) (5)
30
已归约串
PLACE
输入串
语义动作
# #X # X:= # X:= # X:= # X:= # X:=
X:= -B*(C+D)# X := -B*(C+D)# X_ -B*(C+D)# X__ B*(C+D)# -B X__B *(C+D)# -E X__B *(C+D)# { E.place:=p=<B>} E1 X_T1 *(C+D)# {E1.place:=newtemp=T1; 生成四元式(1) } … … … … # X:=E*(C X_T1__C +D)# # X:=E*(E1 X_T1__C +D)# { E1.place:=p=<C> } … … … …
编译原理语义分析与中间代码生成
编译原理语义分析与中间代码生成在编译原理中,语义分析是编译器的重要组成部分之一,它负责验证和处理源代码中的语义信息,为后续的中间代码生成做准备。
本文将介绍语义分析的基本概念和流程,并探讨中间代码生成的相关技术。
一、语义分析的基本概念和流程语义分析是指对源代码进行语义检查和语义信息提取的过程。
其主要目标是确保源代码在语义上是正确的,并从中提取出各种语义信息,以便后续阶段使用。
语义分析的基本流程如下:1. 词法分析和语法分析:在进行语义分析之前,需要先对源代码进行词法分析和语法分析,以便将代码转化为具有结构的中间表示形式(如抽象语法树)。
2. 符号表的构建:符号表是语义分析的重要数据结构,用于存储程序中出现的各种标识符及其相关信息,如类型、作用域等。
在语义分析阶段,需要构建符号表并实时更新。
3. 类型检查:类型检查是语义分析的核心任务之一。
它通过对表达式、赋值语句、函数调用等进行类型推导和匹配,来验证程序是否存在类型错误。
4. 语义规则检查:除了类型检查外,语义分析还需要检查程序是否符合语言规范中的其他语义规则,如变量是否已声明、函数调用是否正确等。
5. 语义信息提取:语义分析还负责提取源代码中的各种语义信息,如函数调用关系、变量的定义和引用关系、控制流信息等。
这些信息将为后续的代码优化和代码生成提供依据。
二、中间代码生成的相关技术中间代码是指某种形式的中间表示形式,通常与源代码和目标代码之间存在一定的映射关系。
它在编译过程中起到连接前后两个阶段的桥梁作用,并且可以进行一些优化。
常见的中间代码形式之一是三地址码。
三地址码是一种低级的代码表示形式,每条指令最多包含三个操作数。
它具有简洁明了的特点,适合进行后续的优化工作。
在进行中间代码生成时,需要考虑以下几个方面的技术:1. 表达式的翻译:在将源代码转化为中间代码时,需要将源代码中的表达式进行翻译。
这包括对表达式的计算顺序、运算符优先级等方面的处理。
2. 控制流的处理:在编译过程中,需要将源代码中的控制流转化为中间代码中的条件分支和循环结构。
编译原理 语义分析和中间代码的产生
n 语义分析的概念:源程序经过词法分析、语法分析后,表明该源程序书写正确、符合程序语言所规定的语法,但语法分析并未对程序内部的逻辑含义加以分析,因此编译程序接着进行语义分析,即审查每个语法成分的静态语义。
如果静态语义正确,则生成与该语言成分等效的中间代码,或直接生成目标代码。
直接生成机器语言或汇编语言形式的目标代码的优点是编译时间短且无需中间代码到目标代码的翻译,而生成中间代码的优点是使编译结构在逻辑上更为简单明确,特别是使目标代码的优化较易实现。
语义分析进行的语义检查有两类:动态语义检查和静态语义检查。
动态语义检查需生成相应的目标代码,在运行时进行;静态语义检查在编译时进行。
教学要求n 掌握:n 1. 逆波兰式, DAG图, 抽象语法树, 三地址代码, 三元式, 四元式等中间代码表示;n 2. 简单赋值语句的翻译, 带数组元素引用的赋值句的翻译;n 3. 布尔表达式的翻译, 控制语句中布尔表达式的翻译;n 4. 控制语句的翻译。
n 了解理解:说明语句的翻译,过程调用和参数的处理。
教学内容n 7.1 中间语言n 后缀式,DAG,三地址码(四元式,三元式,间接三元式)n *7.2 说明语句的翻译n 7.3 赋值语句的翻译,数组元素引用的翻译n 7.4 布尔表达式的翻译n 求布尔式值的翻译,作为控制条件的翻译n 7.5 控制语句的翻译n if , while , goto , casen 7.6 过程调用的处理, 参数传递的处理n *7.7 类型检查(不作要求,不讲)7.1 中间语言n 要掌握几种中间语言的基本结构:n 逆波兰表示即后缀式n 抽象语法树n DAG图n 三地址代码(四元式、三元式、间接三元式)7.1.1 后缀式n 波兰逻辑学家卢卡西维奇(Lukasiewicz)发明的一种表示法,又称逆波兰式表示法。
n 后缀式这种方法是,把运算量(操作数)写在算符的前面,把算符写在运算量的后面(后缀)。
编译原理中间代码生成

编译原理中间代码生成在编译原理中,中间代码生成是编译器的重要阶段之一、在这个阶段,编译器将源代码转换成一种中间表示形式,这种中间表示形式通常比源代码抽象得多,同时又比目标代码具体得多。
中间代码既能够方便地进行优化,又能够方便地转换成目标代码。
为什么需要中间代码呢?其一,中间代码可以方便地进行编译器优化。
编译器优化是编译器的一个核心功能,它能够对中间代码进行优化,以产生更高效的目标代码。
在中间代码生成阶段,编译器可以根据源代码特性进行一些优化,例如常量折叠、公共子表达式消除、循环不变式移动等。
其二,中间代码可以方便地进行目标代码生成。
中间代码通常比较高级,比目标代码更具有表达力。
通过中间代码,编译器可以将源代码转换成与目标机器无关的形式,然后再根据目标机器的特性进行进一步的优化和转换,最终生成目标代码。
中间代码生成的过程通常可以分为以下几步:1.词法分析和语法分析:首先需要将源代码转换成抽象语法树。
这个过程涉及到词法分析和语法分析两个步骤。
词法分析将源代码划分成一个个的词法单元,例如标识符、关键字、运算符等等。
语法分析将词法单元组成树状结构,形成抽象语法树。
2.语义分析:在语义分析阶段,编译器会对抽象语法树进行静态语义检查,以确保源代码符合语言的语义规定。
同时,还会进行类型检查和类型推导等操作。
3.中间代码生成:在中间代码生成阶段,编译器会将抽象语法树转换成一种中间表示形式,例如三地址码、四元式、特定的中间代码形式等。
这种中间表示形式通常比较高级,能够方便进行编译器的优化和转换。
4.中间代码优化:中间代码生成的结果通常不是最优的,因为生成中间代码时考虑的主要是功能的正确性,并没有考虑性能的问题。
在中间代码生成之后,编译器会对中间代码进行各种优化,以产生更高效的代码。
例如常量折叠、循环优化、死代码删除等等。
5.中间代码转换:在完成了中间代码的优化之后,编译器还可以对中间代码进行进一步的转换。
这个转换的目的是将中间代码转换成更具体、更低级的形式,例如目标机器的汇编代码。
第7章 语义分析和中间代码生成
规约过程
树
15
图 x:=(a+b)*(a+b)图形表示的中间代码 (a) 树表示;(b) DAG表示
16
(1)E E(1) OP E(2) (2)E(E(1))
函数过程,建立一个以OP为 结点,E(1).optr和 E(2).optr为左右枝的子树, 回送新子树根的指针
{ E.nptr:= makenode (OP,E(1).optr,E(2).optr)} { E.optr:= E(1).optr } (3)E-E(1) { E.nptr := makenode (‘uminus’,E(1).optr)}
E→E1+E2 E. nptr:= mknode('+', E1. nptr, E2. nptr)
E. nptr:= mknode('*', E1. nptr, E2. nptr)
E. nptr:= mknode('-', 0, E1. nptr) E. nptr:= E1. nptr E. nptr:= mkleaf(id, id. place) E. nptr:=mkleaf(num,num.val)
30
(3)
x=y形式的赋值语句,将y的值赋给
χ。 (4) 无条件转移语句goto L,即下一个将 被执行的语句是标号为L的语句。 (5) 条件转移语句if x rop y goto L,其 中rop为关系运算符,如<、<=、==、!=、 >、>=等。若x和y满足关系rop就转去执 行标号为L的语句,否则继续按顺序执行 本语句的下一条语句。
47作用说明语句declarations用于对程序中规定范围内使用的各类变量常数过程进行说明编译要完成的工作在符号表中记录被说明对象的属性为执行做准备计算要占的存储空间计算相对地址48简单声明句的翻译程序中的每个名字如变量名都必须在使用之前进行说明而说明语句的功能就是为编译程序说明源程序中的每一个名字及其性质
程序设计语言 编译原理(第三版)第7章
8
§7.1 中间语言
例子:如图所示,为a+a*(b-c)+(b-c)*d的DAG
+
+
* a b c
*
d
9
§7.1 中间语言
2.抽象语法树
例子:(1)a:=b*-c+b*-c的图表示法
assign a * b uminus c b + * uminus c DAG
10
assign
a + * b uminus c
第七章
语义分析和中间代码产生
静态检查器
语法分析器
中间代码产生器
中间代码
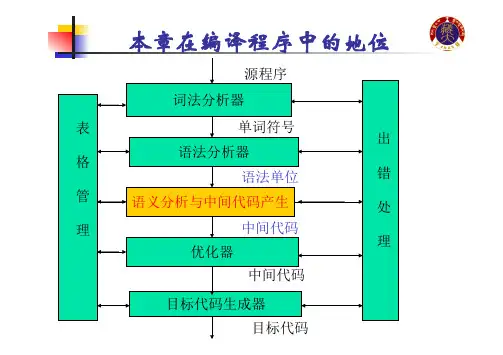
优化器 一般情况下,在词法分析程序和语法分析程序对源程序的语法结 构进行分析之后,
要么,由语法分析程序直接调用相应的语义子程序进行语义处理; 要么,首先生成语法树或该结构的某种表示,再进行语义处理。
1
第七章
语义分析和中间代码产生
7.7 类型检查 (略)
4
§7.1 中间语言
中间语言形式: 后缀式 三地址代码
间接三元式 DAG 抽象语法树
图表示法
三元式 四元式
5
§7.1 中间语言
一、后缀式—逆波兰式: 规则: (1)E-常量/变量: (2)E-E1 op E2: (3)E-(E1) : (4)E-op E1: 后缀式为E本身 E1’ E2’ op (E1’) E1’ op
6
§7.1 中间语言
例子: a*(b+c)— abc+* ab+cd+*
(a+b)*(c+d)—
x+y≤z∨a>0∧(8+z)>3— xy+z≤a0>8z+3>∧∨
编译原理chapter7 语义分析及中间代码生成
编译原理
chapter7
语义分三元式 三元式顾名思义就是带有三个域的记录结构。 三元式顾名思义就是带有三个域的记录结构。 一般形式为: (i)( ,arg1,arg2) 一般形式为: )(op, )( , ) 其中,( )为三元式的编号, 其中,(i)为三元式的编号,也代表了该式的运算 ,( 结果, , 的含义与四元式类似, 结果,op,arg1,arg2的含义与四元式类似,区别在 , 的含义与四元式类似 于arg可以是某三元式的序号,表示用该三元式的结果 可以是某三元式的序号, 可以是某三元式的序号 作为运算对象。 作为运算对象。
编译原理
chapter7
语义分析和中间代码生成
对于文法G[E]: E →E+T | T 例:对于文法 T→ digit 产生式 ) E→ E(1)+T E→ T T→ digit 语 法 分 析 栈 T + E … # 语义子程序 ) {E.Val=E(1).Val+T.Val} {E.Val=T.Val} {T.Val=digit} T.Val 语 义 ‘+’ ) E(1).Val 分 析 … 栈 #
编译原理
chapter7
语义分析和中间代码生成
三地址代码可以看成是抽象语法树一种线性表示。 三地址代码可以看成是抽象语法树一种线性表示。 线性表示 例: a=b*-c+b*-c = a + T1=-c T2=b*T1 T3=-c
*
b
* - b
c
c
T4=b*T3 T5=T2+T4 a=T5
编译原理
语义分析和中间代码生成
图表示法—抽象语法树 图表示法 抽象语法树 在语法树中去掉一些对翻译不必要的信息后 在语法树中去掉一些对翻译不必要的信息后,获得 去掉一些对翻译不必要的信息 的更有效的源程序的中间表示, 的更有效的源程序的中间表示,这种经过变换后的语法 树称为抽象语法树。 树称为抽象语法树。 内部结点代表操作符,它的孩子代表对应的操作数。 内部结点代表操作符,它的孩子代表对应的操作数。 例:a+a*(b-c)+(b-c)*d ( ) ( ) + + a a b
编译原理中的语法分析与中间代码生成
编译原理中的语法分析与中间代码生成编译原理是计算机科学中一门非常重要的学科,主要研究将高级语言翻译成机器语言的方法和技术。
其中,语法分析和中间代码生成是编译器实现的两个重要步骤。
一、语法分析语法分析是编译器将源代码转换成抽象语法树的过程。
在这个阶段,编译器会检查源代码的语法是否符合语言规范,并将代码转化为一系列的语法结构。
一个好的语法分析器能够快速准确地识别代码中的语言结构,同时能够在出现语法错误的时候给出有意义的错误报告。
常见的语法分析方法包括LL(1)分析、LR分析等。
LL(1)分析器通过构造预测分析表来实现分析,而LR分析器则采用自底向上的分析方法,通过状态迁移来实现分析。
在语法分析的过程中,编译器还需要处理语法的优先级,如算术运算符的优先级,逻辑运算符的优先级等。
对于不同的语言规范,将有不同的算法来处理语法。
例如,C语言中的运算符优先级和结合性与其他语言不同,因此需要特殊的处理方式。
二、中间代码生成中间代码生成是语法分析后的下一步,它的作用是将抽象语法树转化为中间表示,通常是三地址码或四地址码。
中间代码可以看作是目标代码的前一步,它是一种更加抽象的代码形式,方便后续的优化和翻译。
中间代码的生成方法有很多种,最常用的是遍历抽象语法树并根据语法结构生成中间代码。
不同的语言规范会对中间代码的生成方式有不同的要求。
例如,Java语言规范对着重于类型检查和异常处理的中间代码生成,而C语言的中间代码生成则着重于指针和数组的处理等。
在生成中间代码的过程中,编译器还需要考虑优化问题。
编译器能够在生成中间代码的时候进行一些基本的优化,例如删除冗余代码、常量合并等等,这样可以减少目标代码的大小和程序的运行时间。
总之,语法分析和中间代码生成是编译器实现的两个关键步骤。
它们需要一个好的算法和优秀的实现方式,以便在编译过程中产生高效、可靠的目标代码。
第七章语义分析和中间代码生成
第七章语义分析和中间代码生成知识结构:语义分析语法分析概述语法制导翻译逆波兰式表示三元式表示语义分析和中中间语言图型表示间代码生成四元式表示三地址语句表示赋值语句的翻译布尔表达式的翻译中间代码生成控制语句的翻译说明语句的翻译过程语句的翻译第一节语法制导翻译概述一、语义分析的任务在词法分析和语法分析的基础上进一步分析其含义,主要的工作是进行静态语义检查和翻译。
二、语义分析的功能1、类型检查检查运算的合法性(运算对象的一致性)。
2、一致性检查一个对象(标识符等)在一个分程序中只能被定义一次。
3、相关名字检查如果一个名字必须出现多次,检查使用的名字是否相同的。
4、控制流检查控制流语句必须使控制转移到合法的地方。
5、确定类型确定标识符所关联得数据类型。
6、识别含义确认程序中各种成分组合到一起的含义,并作相应的语义处理,对可执行的语句生成中间语言或目标语言。
三、生成的语言1、直接生成目标语言根据源程序中各语法成分的语义,直接生成机器语言或汇编语言。
其特点:⑴编译时间较短;⑵存储空间较大;⑶目标语言的质量较差。
2、生成中间语言介于源程序语言和机器语言之间的机内表示形式。
其特点:⑴编译程序的逻辑结构简单;⑵有利于编译程序的移植;⑶便于目标语言的优化。
四、语义分析方法1、语法制导翻译方法在语法分析过程中,使用语法规则进行归约的同时,根据每个产生式的语义动作进行翻译(在语法规则的制导下,通过对语义规则的计算,完成对输入字符串的翻译)的方法。
2、属性翻译方法指明语义规则的计算次序,陈述一些实现细节,以表达语义动作在语法分析过程中的执行时刻。
五、语义规则为文法中的每一条产生式配置计算属性的计算规则。
六、语法制导翻译为文法中每个产生式配备一组语义规则。
1、语义规则语义规则计算包括:产生代码、在符号表中存放信息、在分析工作栈中填写语义值(属性值),并生成相应的中间代码。
2、自上而下分析用一条产生式与输入符号匹配成功时, 执行相应语义子程序生成中间代码。