
第7章树和二叉树(1)-数据结构教程(Java语言描述)-李春葆-清华大学出版社
EF
G
H
16/36
兄弟结点。具有同一双亲的结点互相称之为兄弟结点。
A
B
C
D
结点E和F是兄弟结点
EF
G
H
17/36
结点层次。树具有一种层次结构,根结点为第一层,其孩子结点为第 二层,如此类推得到每个结点的层次。
A
1
B
C
D
2
EF
G
3
H
4
18/36
树的高度。树中结点的最大层次称为树的高度或深度。
A
1
26/36
树的运算主要分为三大类: 查找满足某种特定关系的结点,如寻找当前结点的双亲结点等; 插入或删除某个结点,如在树的当前结点上插入一个新结点或删 除当前结点的第i个孩子结点等; 遍历树中每个结点。
A
B
C
D
A、C、D、E为分支结点
EF
G
H
11/36
叶子结点(或叶结点)。度为零的结点称为叶子结点或终端结点。
A
B
C
D
B、H、F、G为叶子结点
EF
G
H
12/36
孩子结点。一个结点的后继称之为该结点的孩子结点。
A
结点A的孩子结点为B、C和D
B
C
D
EF
G
H
13/36
双亲结点(或父亲结点)。一个结点称为其后继结点的双亲结点。
R={r}
r={<ai,aj> | ai,aj∈D, 0≤i,j≤n-1,其中每个结点最多只有一个前驱 结点、可以有零个或多个后继结点,有且仅有一个结点即根
基本运算:
结点没有前驱结点 }
bool CreateTree():由树的逻辑结构表示建立其存储结构。 String toString():返回由树转换的括号表示串。 E GetParent(int i):求编号为i的结点的双亲结点值。 …
即
logm(n(m-1)+1) ≤ h <logm(n(m-1)+1)+1
因h只能取整数,所以h=logm(n(m-1)+1),结论得证。
25/36
【例7.1】 若一棵三次树中度为3的结点为2个,度为2的结点为1个,度为 1的结点为2个,则该三次树中总的结点个数和度为0的结点个数分别是多少?
解:设该三次树中总结点个数、度为0的结点个数、度为1的结点个数、 度为2的结点个数和度为3的结点个数分别为n、n0、n1、n2和n3。
A
B
C
D
EF
G
H
A(B,C(E(H),F),D(G)) 根(子树1,子树2, …,子树m)
8/36
结点的度。树中每个结点具有的子树数或者后继结点数称为该结 点的度。
度为3
A
度为1
B
C
D
EF
G
H
9/36
树的度。树中所有结点的度的最大值称之为树的度。
A
树的度为3
B
C
D
EF
G
H
10/36
分支结点。度大于0的结点称为分支结点或非终端结点。度为1的结点 称为单分支结点,度为2的结点称为双分支结点,依次类推。
}
4/36
树形表示法。这是树的最基本的表示,使用一棵倒置的树表示树结 构,非常直观和形象。
A
B
C
D
EF
G
H
5/36
文氏图表示法。使用集合以及集合的包含关系描述树结构。
A
B
C
D
EF
G
H
6/36
凹入表示法。使用线段的伸缩关系描述树结构。
A
B
C
D
EF
G
H
7/36
括号表示法。将树的根结点写在括号的左边,除根结点之外的其 余结点写在括号中并用逗号分隔。
A
结点E和F的双亲结点均为C
B
C
D
EF
G
H
14/36
子孙结点。一个结点的子树中除该结点外的所有结点称之为该结点的 子孙结点。
A
结点C结点的子孙结点为E、F和H
B
C
D
EF
G
H
15/36
祖先结点。从树根结点到达某个结点的路径上通过的所有结点称为该结 点的祖先结点(不含该结点自身)。
A
B
C
D
结点F的祖先结点为A、C
由性质2推出
23/36
性质4:具有n个结点的m次树的最小高度为logm(n(m-1)+1)。
证明:设具有n个结点的m次树的最小高度为h,若在该树中前h-1层都是 满的,即每一层的结点数都等于mi-1个(1≤i≤h-1),第h层(即最后一层) 的结点数可能满,也可能不满,则该树具有最小的高度。其高度h可计算如下:
推广 当一棵m次树的第i层有mi-1个结点(i≥1)时,称该层是满的,若一棵m
次树的所有叶子结点在同一层,所有层都是满的,称为满m次树。显然,满m 次树是所有相同高度的m次树中结点总数最多的树。
也可以说,对于n个结点,构造的m次树为满m次树或者接近满m次树, 此时树的高度最小。
22/36
性质3: 高度为h的m次树至多有 mh 1 个结点。 m1
h层全满
h-1层满
高度为h,结点个数最 多的情况
mh 1 m 1
高度为h,结点个数最 少的情况
mh1 1 +1
m 1
24/36
根据树的性质3可得:
mh1 1 < n ≤ mh 1
m 1
m 1
乘(m-1)后得:
mh-1 < n(m-1)+1 ≤ mh
以m为底取对数后得: h-1 < logm(n(m-1)+1) ≤ h
B
C
D
2
EF
G
3
H
4
高度是4
19/36
森林。零棵或多棵互不相交的树的集合称为森林。
AB
C
D
EF
G
H
4棵树构成的森林
20/36
性质1: 树中的结点数等于所有结点的度数加1。
A
B
C
D
EF
G
H
A
B
C
D
EF
G
H
度之和=分支数 分支数=n-1 所以,n=度之和+1
21/36
性质2:度为m的树中第i层上至多有mi-1个结点,这里应有i≥1。 数学归纳法证明
显然,每个度为i的结点在所有结点的度数之和中贡献i个度。依题意有: n1=2,n2=1,n3=2。由树的性质1可知
n = 所有结点的度数之和+1 = 0×n0+1×n1+2×n2+3×n3+1 = 1×2+2×1+3×2+1=11
又因为n=n0+n1+n2+n3 即:n0=n-n1-n2-n3=11-2-1-2=6 所以该三次树中总的结点个数和度为0的结点个数分别是11和6。
2/36
树是一种非线性数据结构,具有以下特点: 每一结点可以有零个或多个后继结点,但有且只有一个前驱结 点(根结点除外)。 数据结点按分支关系组织起来,清晰地反映了数据元素之间的 层次关系。
3/36
抽象数据类型树的描述
ADT Tree
{ 数据对象:
D={ai | 0≤i≤n-1,n≥0,ai为E类型} 数据关系:
提纲
CONTENTS
1/36
树是由n(n≥0)个结点组成的有限集合(记为T)。 如果n=0,它是一棵空树,这是树的特例。 如果n>0,这n个结点中存在(有仅存在)一个结点作为树的根结点 (root),其余结点可分为m(m≥0)个互不相交的有限集T1、T2、…、 Tm,其中每个子集本身又是一棵符合本定义的树,称为根结点的子树。
数据结构教程java语言描述李春葆程序

数据结构教程java语言描述李春葆程序摘要:1.数据结构教程概述2.Java语言描述数据结构的优点3.李春葆程序的特点与结构4.教程内容的详细介绍4.1 线性表4.2 栈与队列4.3 树与二叉树4.4 图4.5 排序算法4.6 查找算法5.教程在实际应用中的价值6.对李春葆程序的评价与展望正文:数据结构教程是一门计算机科学与技术专业的基础课程,旨在帮助学生掌握各种常用的数据结构和算法。
近年来,Java语言因其跨平台特性、丰富的类库和简洁的语法,成为了许多开发者编写数据结构教程的首选。
在这样的背景下,李春葆程序以Java语言为基础,为广大学习者提供了一部全面、易懂的数据结构教程。
Java语言描述数据结构的优点在于,它允许开发者直接使用面向对象的特性来表示各种数据结构,使得代码更加直观、易于理解。
此外,Java语言丰富的类库提供了许多现成的方法,方便开发者实现各种操作,从而降低了学习难度。
李春葆程序采用了模块化的设计,将教程划分为线性表、栈与队列、树与二叉树、图、排序算法和查找算法六个部分,每个部分自成体系,方便学习者根据自己的需求进行选择。
教程在讲解每个数据结构时,都从基本概念入手,通过实例和图解,让学习者逐步掌握其原理和应用。
此外,教程还提供了丰富的练习题,帮助学习者巩固所学知识。
在实际应用中,数据结构教程可以帮助开发者更好地理解各种算法和数据结构的原理,从而提高编程效率。
例如,掌握排序算法可以让我们在处理大量数据时更加得心应手;了解树结构可以方便我们实现文件系统、数据库等复杂系统。
总之,数据结构教程是计算机科学与技术专业学生必备的技能。
总的来说,李春葆程序的数据结构教程是一部内容全面、讲解清晰、实例丰富的教材。
当然,教程还可以在某些方面进行改进,例如增加更多的实际应用案例,提供更丰富的编程实践等。
数据结构教程java语言描述李春葆程序
数据结构教程java语言描述李春葆程序李春葆程序是一种经典的数据结构教程,以Java语言描述。
本文将详细介绍李春葆程序的内容和特点,并分析其对学习数据结构的帮助。
李春葆程序是一本由李春葆编写的数据结构教程,以Java语言描述。
该教程主要介绍了常见的数据结构和算法,包括线性表、栈、队列、树、图等。
通过对这些数据结构的介绍和实现,读者可以深入理解数据结构的原理和应用。
李春葆程序的特点之一是注重理论与实践的结合。
在每个章节中,教程首先介绍了数据结构的基本概念和原理,然后通过具体的Java代码实现来展示这些概念的应用。
这种理论与实践相结合的方式,使得读者可以更加直观地理解数据结构的运作方式,并能够通过实际编程来加深对数据结构的理解。
另一个特点是李春葆程序的编程风格简洁明了。
在代码实现中,作者使用了简洁的Java语法和清晰的注释,使得读者可以轻松理解代码的逻辑和功能。
同时,作者还提供了大量的示例代码和练习题,读者可以通过实际编程来巩固所学的知识。
李春葆程序还注重实际应用和问题解决能力的培养。
在每个章节的最后,作者都提供了一些实际应用的案例,读者可以通过这些案例来了解数据结构在实际问题中的应用。
此外,作者还提供了一些问题解决的思路和方法,读者可以通过这些思路和方法来解决实际问题。
通过学习李春葆程序,读者可以获得以下几方面的收益。
首先,读者可以系统地学习和掌握常见的数据结构和算法。
李春葆程序对各种数据结构的原理和实现进行了详细的介绍,读者可以通过学习这些内容来深入理解数据结构的运作方式和应用场景。
其次,读者可以提高编程能力和问题解决能力。
通过实际编程和解决实际问题的练习,读者可以提高自己的编程技巧和问题解决能力。
同时,通过学习数据结构和算法的思想和方法,读者可以培养自己的抽象思维和逻辑思维能力。
最后,读者可以为进一步学习和研究计算机科学领域打下坚实的基础。
数据结构是计算机科学的基础,掌握了数据结构,读者可以更好地理解和应用其他计算机科学领域的知识,如算法、数据库、操作系统等。
第7章图(5)-数据结构教程(Python语言描述)-李春葆-清华大学出版社
B A a2=4 C
D
E
a6=2
F
G a11=4
I
H
14/22
【例7.13】
B
A a2=4 C
E
D
a6=2
F
G a11=4
I
H
先进行拓扑排序,假设拓扑序列为:ABCDEFGHI 计算各事件的ee(v)如下:
ee(A)=0 ee(B)=ee(A)+c(a1)=6 ee(C)=ee(A)+c(a2)=4 ee(D)=ee(A)+c(a3)=5 ee(E)=MAX(ee(B)+c(a4),ee(C)+c(a5)}=MAX{7,5}=7
例如,计算机专业的学生必须完成一系列规定的基础课和专业课才能毕业, 假设这些课程的名称与相应代号有如下关系:
课程代号 C1 C2 C3 C4 C5 C6 C7
课程名称 高等数学 程序设计 离散数学 数据结构 编译原理 操作系统 计算机组成原理
先修课程 无 无 C1 C2,C3 C2,C4 C4,C7 C2
8/22
若用一个带权有向图(DAG)描述工程的预计进度,以顶点表示事件,有 向边表示活动,边e的权c(e)表示完成活动e所需的时间(比如天数), 或者说活动e持续时间 AOE网。 通常AOE网中只有一个入度为0的顶点,称为源点,和一个出度为0的顶点, 称为汇点。 在AOE网中,从源点到汇点的所有路径中,具有最大路径长度的路径称为 关键路径。完成整个工程的最短时间就是网中关键路径的长度。 关键路径上的活动称为关键活动,或者说关键路径是由关键活动构成的。 只要找出AOE网中的全部关键活动,也就找到了全部关键路径了。
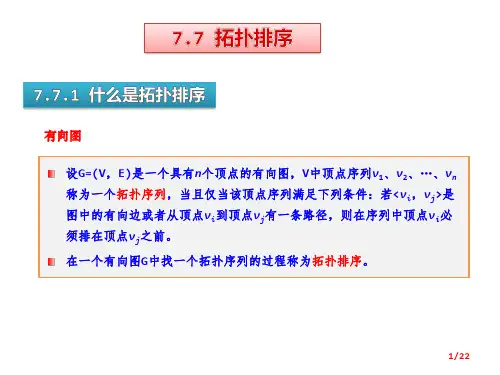
有向图 设G=(V,E)是一个具有n个顶点的有向图,V中顶点序列v1、v2、…、vn 称为一个拓扑序列,当且仅当该顶点序列满足下列条件:若<vi,vj>是 图中的有向边或者从顶点vi到顶点vj有一条路径,则在序列中顶点vi必 须排在顶点vj之前。 在一个有向图G中找一个拓扑序列的过程称为拓扑排序。
数据结构之树和二叉树ppt

G D E F
数据结构中讨论的一般都是有序树
清华大学出版社
数据结构(C++版) 数据结构( ++版 ++
5.1 树的逻辑结构
树的基本术语
森林: 棵互不相交的树的集合。 森林:m (m≥0)棵互不相交的树的集合。 棵互不相交的树的集合 A B E K L F C H D J
清华大学出版社
数据结构(C++版) 数据结构( ++版 ++
data parent
data:存储树中结点的数据信息 : parent:存储该结点的双亲在数组中的下标 :
清华大学出版社
数据结构(C++版) 数据结构( ++版 ++
5.1 树的逻辑结构
树的抽象数据类型定义
Parent 前置条件: 前置条件:树已存在 输入:结点x 输入:结点 功能:求结点x的双亲 功能:求结点 的双亲 输出:结点x的双亲的信息 输出:结点 的双亲的信息 后置条件: 后置条件:树保持不变 Depth 前置条件: 前置条件:树已存在 输入: 输入:无 功能: 功能:求树的深度 输出: 输出:树的深度 后置条件: 后置条件:树保持不变
清华大学出版社
数据结构(C++版) 数据结构( ++版 ++
5.1 树的逻辑结构
树的抽象数据类型定义
PreOrder 前置条件: 前置条件:树已存在 输入: 输入:无 功能: 功能:前序遍历树 输出:树的前序遍历序列 输出: 后置条件: 后置条件:树保持不变 PostOrder 前置条件: 前置条件:树已存在 输入: 输入:无 功能:后序遍历树 功能: 输出: 输出:树的后序遍历序列 后置条件: 后置条件:树保持不变 endADT
清华大学出版社
数据结构(C++版) 数据结构( ++版 ++
第7章树和二叉树(2)-数据结构教程(Java语言描述)-李春葆-清华大学出版社

二叉树也称为二分树,它是有限的结点集合,这个集合或者是空,或者由 一个根结点和两棵互不相交的称为左子树和右子树的二叉树组成。 二叉树中许多概念与树中的概念相同。 在含n个结点的二叉树中,所有结点的度小于等于2,通常用n0表示叶子结 点个数,n1表示单分支结点个数,n2表示双分支结与度为2的树是不同的。
度为2的树至少有3个结点,而二叉树的结点数可以为0。 度为2的树不区分子树的次序,而二叉树中的每个结点最多有 两个孩子结点,且必须要区分左右子树,即使在结点只有一棵 子树的情况下也要明确指出该子树是左子树还是右子树。
2/35
归纳起来,二叉树的5种形态:
Ø
4/35
3. 满二叉树和完全二叉树
在一棵二叉树中,如果所有分支结点都有左孩子结点和右孩子结点,并且 叶子结点都集中在二叉树的最下一层,这样的二叉树称为满二叉树。
可以对满二叉树的结点进行层序编号,约定编号从树根为1开始,按照层 数从小到大、同一层从左到右的次序进行。
满二叉树也可以从结点个数和树高度之间的关系来定义,即一棵高度为h 且有2h-1个结点的二叉树称为满二叉树。
R={r} r={<ai,aj> | ai,aj∈D, 1≤i,j≤n,当n=0时,称为空二叉树;否则其中
有一个根结点,其他结点构成根结点的互不相交的左、右子树,该 左、右两棵子树也是二叉树 } 基本运算: void CreateBTree(string str):根据二叉树的括号表示串建立其存储结构。 String toString():返回由二叉树树转换的括号表示串。 BTNode FindNode(x):在二叉树中查找值为x的结点。 int Height():求二叉树的高度。 … }
5
E
第7章图(4)-数据结构教程(Python语言描述)-李春葆-清华大学出版社
{0,1,2,3,5,4,6} {}
{0, 4, 5, 6, 10, 9, 16} {0, 0, 1, 0, 5, 2, 4}
最小的顶点:2
{0,1,2} {3,4,5,6}
{0, 4, 5, 6, 11, 9, ∞} {0, 0, 1, 0, 1, 2, -1}
13/45
41
0
6
7
1
6
2
6
24
3
5
46
1
6
8
5
S
U
{0,1,2} {3,4,5,6}
{0,1,2,3} {4,5,6}
dist[]
0 123 456
path[]
S
v
i
U=V-S
j
6/45
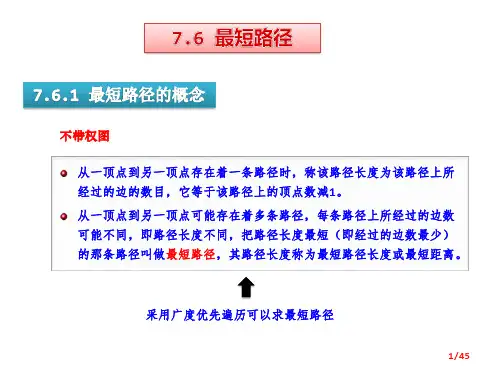
(2)从U中选取一个顶点u,它是源点v到U中最短路径长度最小的顶点, 然后把顶点u加入S中(此时求出了源点v到顶点u的最短路径长度)。
U=V-S S
u v
i
7/45
(3)以顶点u为新考虑的中间点,修改顶点u的出边邻接点j的最短路 径长度,此时源点v到顶点j的最短路径有两条,即一条经过顶点u,一条 不经过顶点u:
采用广度优先遍历可以求最短路径
1/45
带权图 把一条路径上所经边的权值之和定义为该路径的路径长度或称带权路径 长度。 从源点到终点可能不止一条路径,把带权路径长度最短的那条路径称为 最短路径,其路径长度(权值之和)称为最短路径长度或者最短距离。
采用广度优先遍历可以求最短路径:不适合
2/45
Edsger Wybe Dijkstra 1930年5月11日~2002年8月6日
12/45
示例
41
数据结构教程李春葆课后答案第7章树和二叉树
教材中练习题及参考答案
1. 有一棵树的括号表示为 A(B,C(E,F(G)),D),回答下面的问题: (1)指出树的根结点。 (2)指出棵树的所有叶子结点。 (3)结点 C 的度是多少? (4)这棵树的度为多少? (5)这棵树的高度是多少? (6)结点 C 的孩子结点是哪些? (7)结点 C 的双亲结点是谁? 答:该树对应的树形表示如图 7.2 所示。 (1)这棵树的根结点是 A。 (2)这棵树的叶子结点是 B、E、G、D。 (3)结点 C 的度是 2。 (4)这棵树的度为 3。 (5)这棵树的高度是 4。 (6)结点 C 的孩子结点是 E、F。 (7)结点 C 的双亲结点是 A。
12. 假设二叉树中每个结点值为单个字符,采用二叉链存储结构存储。设计一个算法 计算一棵给定二叉树 b 中的所有单分支结点个数。 解:计算一棵二叉树的所有单分支结点个数的递归模型 f(b)如下:
f(b)=0 若 b=NULL
6 f(b)=f(b->lchild)+f(b->rchild)+1 f(b)=f(b->lchild)+f(b->rchild)
表7.1 二叉树bt的一种存储结构 1 lchild data rchild 0 j 0 2 0 h 0 3 2 f 0 4 3 d 9 5 7 b 4 6 5 a 0 7 8 c 0 8 0 e 0 9 10 g 0 10 1 i 0
答:(1)二叉树bt的树形表示如图7.3所示。
a b c e h j f i d g e h j c f i b d g a
对应的算法如下:
void FindMinNode(BTNode *b,char &min) { if (b->data<min) min=b->data; FindMinNode(b->lchild,min); //在左子树中找最小结点值 FindMinNode(b->rchild,min); //在右子树中找最小结点值 } void MinNode(BTNode *b) //输出最小结点值 { if (b!=NULL) { char min=b->data; FindMinNode(b,min); printf("Min=%c\n",min); } }
第7章图(2)-数据结构教程(Python语言描述)-李春葆-清华大学出版社
4/59
或者
def DFS1(G,v): print(v,end=' ') visited[v]=1 for p in G.adjlist[v]: w=p.adjvex if visited[w]==0: DFS1(G,w)
#邻接表G中从顶点v出发的深度优先遍历 #访问顶点v #置已访问标记 #处理顶点v的所有出边顶点 #取顶点v的一个邻接点w
图采用邻接矩阵为存储结构,其广度优先遍历算法如下:
from collections import deque
MAXV=100
#全局变量,表示最多顶点个数
visited=[0]*MAXV
def BFS(g,v):
#邻接矩阵g中顶点v出发广度优先遍历
qu=deque()
#将双端队列作为普通队列qu
print(v,end=" ")
#访问顶点v
visited[v]=1
#置已访问标记
qu.append(v)
#v进队
while len(qu)>0:
#队不空循环
v=qu.popleft()
#出队顶点v
for w in range(g.n):
if g.edges[v][w]!=0 and g.edges[v][w]!=INF:
#全局变量,表示最多顶点个数
#邻接表G中顶点v出发广度优先遍历 #将双端队列作为普通队列qu #访问顶点v #置已访问标记 #v进队
#队不空循环 #出队顶点v
#处理顶点v的所有出边 #取顶点v的第j个出边邻接点w #若w未访问 #访问顶点w #置已访问标记 #w进队
时间复杂度为O(n+e)。
11/59
第7章图(3)-数据结构教程(Python语言描述)-李春葆-清华大学出版社
15/31
V-U={j|lowcost[j]≠0} j
min=INF k=-1 for j in range(g.n):
if lowcost[j]!=0 and lowcost[j]<min: min=lowcost[j] k=j
U
v i
closest[j]
U
V-U
V-U
v
lowcost[j]
j
j
表示为
i
closest[j]=i
V-U中顶点j到U中的最小边为(i, j)
将V-U中顶点j到整个U的最小边表示 为(j,closest[j]):lowcost[j]
13/31
对于任意顶点i,如何知道它属于集合U还是集合V-U呢?
U={i|lowcost[i]=0} V-U={j|lowcost[j]≠0}
v j
i
14/31
初始时,U中只有一个顶点v,其他顶点i均在V-U中。
U={i|lowcost[i]=0} V-U={j|lowcost[j]≠0}
v
i
如果(v,i)有一条边,它就是i到U的最小边,置closest[i]=v, lowcost[i]=g.edges[v][i]。 如果(v,i)没有条边,不妨认为有一条权为∞的边,同样置 closest[i]=v,lowcost[i]=g.edges[v][i]
(1)初始化U={v}。以v到其他顶点的所有边为候选边。 (2)重复以下步骤n-1次,使得其他n-1个顶点被加入到U中:
① 从候选边中挑选权值最小的边加入TE(所有候选边一定是连接两个顶点集 U和V-U的边),设该边在V-U中的顶点是k,将顶点k加入U中。
第七章-数据结构教程(Java语言描述)-李春葆-清华大学出版社
第二阶段通常用C语言完成,以便实现更复杂的功能, 也使程序有更好的可读性和可移植性。这个阶段的任 务有: 初始化本阶段要使用到的硬件设备。 检测系统内存映射。 将内核映像和根文件系统映像从Flash读到RAM。 为内核设置启动参数。 调用内核。
ห้องสมุดไป่ตู้
7.1.4常见的BootLoader
(1)Redboot Redboot (Red Hat Embedded Debug and Bootstrap)是Red Hat公司开发的一个独立运行在嵌入式系统上的BootLoader程序, 是目前比较流行的一个功能、可移植性好的BootLoader。 Redboot是一个采用eCos开发环境开发的应用程序,并采用了 eCos的硬件抽象层作为基础,但它完全可以摆脱eCos环境运行, 可以用来引导任何其他的嵌入式操作系统,如Linux、Windows CE等。
BootLoader是嵌入式系统在加电后执行的第一段代码, 在它完成CPU和相关硬件的初始化之后,再将操作系 统映像或固化的嵌入式应用程序装载到内存中然后跳 转到操作系统所在的空间,启动操作系统运行。
对于嵌入式系统而言,BootLoader是基于特定硬件平 台来实现的。因此,几乎不可能为所有的嵌入式系统 建立一个通用的BootLoader,不同的处理器架构都有 不同的BootLoader。
第7章 嵌入式Linux系统移植及调试
目录
7.1 Boot Loader基本概念与典型结构 7.2 U-Boot 7.3 交叉开发环境的建立 7.4 交叉编译工具链 7.5 嵌入式Linux系统移植过程 7.6 Gdb调试器 7.7 远程调试 7.8 内核调试
一个嵌入式linux系统通常由引导程序及参数、 linux内核、文件系统和用户应用程序组成。 由于嵌入式系统与开发主机运行的环境不同, 这就为开发嵌入式系统提出了开发环境特殊化 的要求。交叉开发环境正是在这种背景下应运 而生。