
聚类分析案例
聚类分析案例
聚类分析是一种数据分析方法,用于将数据集中的对象分成不同的群组,使得群组内的对象相似度较高,而不同群组之间的相似度较低。
以下是一个聚类分析的案例。
假设一个公司试图了解他们的客户群体,以便更好地进行市场细分和定位。
该公司采集了一系列与客户相关的特征,比如年龄、性别、购买行为等。
他们打算使用聚类分析来将这些客户划分为不同的群组,以便更好地了解每个群组的特征和需求。
首先,该公司需要对数据进行预处理。
他们将删除一些不相关或重复的特征,并对缺失数据进行填充。
然后,他们需要选择一个合适的聚类算法来检测潜在的群组结构。
在这个案例中,他们选择了k-means算法,因为它是一个简单而高效的方法,
适用于大规模数据集。
接下来,他们需要选择聚类的数量。
为了确定最佳的聚类数量,他们使用了“肘部法则”。
该方法计算了不同聚类数量下的聚类误差平方和(SSE),并绘制了一个聚类数量和SSE的折线图。
根据折线图,他们选择了一个聚类数量,使得SSE的降幅明
显减缓的那个点。
在这个案例中,他们选择了5个聚类。
最后,他们使用选定的聚类数量运行k-means算法,并获取每
个客户所属的聚类。
然后,他们对每个聚类进行分析,比如计算平均年龄、男女比例、购买偏好等。
通过对聚类结果的比较,他们可以发现不同群组之间的差异和相似之处,从而得出关于每个群组的特征和需求的结论。
通过这个聚类分析,该公司发现客户群体可以分为以下几个群组:青年女性购买群体、中年男性购买群体、中老年女性购买群体、青年男性购买群体和普通购买群体。
他们发现不同群组的平均年龄、男女比例和购买偏好存在显著差异,这为他们的市场细分和推广战略提供了有力的支持。
综上所述,聚类分析是一个有用的数据分析方法,可以帮助企业了解客户群体的特征和需求,从而更好地进行市场细分和定位。
通过对数据的预处理、选择合适的聚类算法和聚类数量,以及对聚类结果的分析,企业可以获得有关客户群体的深入洞察,并为营销决策提供有力的支持。
聚类分析数据

聚类分析数据聚类分析是一种数据挖掘方法,用于将相似的数据点分组成簇。
它能够匡助我们发现数据中的潜在模式和结构,从而提供洞察力和指导性的决策支持。
在本文中,我们将探讨聚类分析的基本概念、常用的聚类算法以及应用案例。
一、聚类分析的基本概念聚类分析是一种无监督学习方法,它不依赖于预先标记的训练数据。
其主要目标是通过将相似的数据点分组成簇,使得簇内的数据点相似度较高,而簇间的数据点相似度较低。
聚类分析通常用于探索性数据分析和数据预处理阶段,以匡助我们理解数据的内在结构和特征。
在聚类分析中,我们需要考虑以下几个关键概念:1. 数据相似度度量:聚类算法需要一种度量方法来衡量数据点之间的相似度或者距离。
常用的度量方法包括欧氏距离、曼哈顿距离、余弦相似度等。
2. 聚类算法:聚类算法是用于将数据点分组成簇的数学模型或者算法。
常见的聚类算法包括K均值聚类、层次聚类、DBSCAN等。
3. 聚类评估指标:为了评估聚类结果的质量,我们需要一些指标来衡量聚类的密切度和分离度。
常用的评估指标有轮廓系数、Davies-Bouldin指数、Calinski-Harabasz指数等。
二、常用的聚类算法1. K均值聚类算法:K均值聚类是一种基于距离的聚类算法,它将数据点分配到K个簇中,使得簇内的数据点与簇中心的距离最小化。
它的基本思想是通过迭代优化来不断更新簇中心和数据点的分配,直到达到收敛条件。
2. 层次聚类算法:层次聚类是一种基于距离或者相似度的聚类算法,它通过逐步合并或者分割簇来构建聚类层次结构。
层次聚类可以分为凝结型层次聚类和分裂型层次聚类两种方法。
3. DBSCAN算法:DBSCAN是一种基于密度的聚类算法,它将数据点分为核心点、边界点和噪声点三类。
DBSCAN通过计算数据点的密度来确定核心点,并将密度可达的数据点分配到同一个簇中。
三、聚类分析的应用案例聚类分析在各个领域都有广泛的应用,下面是几个常见的应用案例:1. 市场细分:聚类分析可以匡助企业将客户细分为不同的市场群体,从而针对不同的群体制定个性化的营销策略。
CDA数据分析师Level 2考试题库库案例之聚类问题
CDA数据分析师LevelⅡ考试题库案例之聚类问题
案例:
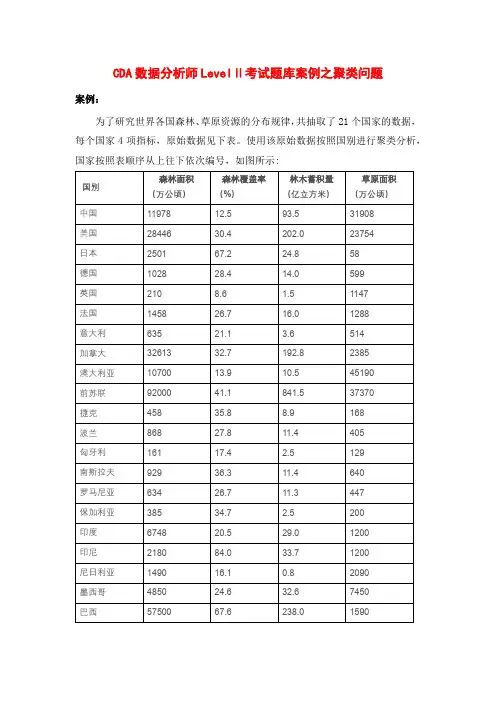
为了研究世界各国森林、草原资源的分布规律,共抽取了21个国家的数据,每个国家4项指标,原始数据见下表。
使用该原始数据按照国别进行聚类分析,国家按照表顺序从上往下依次编号,如图所示:
使用SPSS软件分析结果如下:
问题1:聚类分析常用的方法不包括哪个()
A、动态聚类法
B、合成法
C、加入法
D、分解法
答案:B
问题2:从聚类结果来看,与其他国家相似度最低,处于最高类别的国家是()
A、巴西
B、中国
C、俄罗斯
D、美国
答案:C
问题3:下列各项关于聚类分析的描述中,不正确的是()
A、相关聚类度量是表示两个事物之间关联度的值,常见的计算方法包括SAD、SSD、MAE、MSE等
B、层次聚类算法是自下而上的一种分类方法
C、层次聚类算法的缺点是必须提前知道数据有多少组/类,即K值,否则会造成严重的错误和偏差
D、常用的聚类算法包括层次聚类、K-均值聚类和DBSCAN聚类
答案:C
问题4:在聚类分析中不会使用的距离是()
A、Minkowski距离
B、绝对距离
C、笛卡尔距离
D、欧式距离
答案:C
问题5:在聚类结果中,与中国最应该聚为一类的国家是()
A、澳大利亚
B、印尼
C、日本
D、加拿大
答案:A。
聚类算法经典案例

聚类算法经典案例聚类算法是一种机器学习技术,它通过将数据分成不同的类别或群集并分配标签来发现数据内在的结构和模式。
下面将介绍几个聚类算法的经典案例。
1. K-Means算法K-Means算法是聚类算法中最常见和最简单的方法之一。
它将数据分成K个类别,并在每个类别中放置一个聚类质心。
接着,算法计算每个数据点到聚类质心的距离,并将其分配给最近的质心,形成一个聚类。
最后,算法更新每个聚类的质心,并重新分配每个数据点,直到收敛为止。
经典案例:在市场细分中,K-Means算法可以用来将消费者分成不同的群体。
例如,可以使用购买历史和口味偏好来将消费者分成健康食品用户、零食用户和高端餐饮用户等。
2. 层次聚类算法层次聚类算法也是一种常见的聚类算法,它将数据分成不同的类别,并使用树状结构来表示聚类过程。
层次聚类算法可以分为凝聚式和分裂式两种。
经典案例:在癌症治疗中,层次聚类算法可以用来识别患者是否属于某种分子亚型,以确定他们的最佳治疗方案。
3. DBSCAN算法DBSCAN算法是一种密度聚类算法,它将数据分成具有相似密度的群集。
该算法定义了两个核心参数:半径和密度。
接着,算法将密度高于某个阈值的点分配给一个聚类,并且任何不在聚类中的点都被视为噪声。
经典案例:在地理空间数据分析中,DBSCAN算法可以用来识别热点区域或者犯罪高发区,同时排除低密度的区域。
综上所述,聚类算法广泛用于分类、市场细分、癌症治疗、地理空间数据分析等领域。
不同的聚类算法可以应用于不同的问题,选择适当的算法可以帮助得出准确的结论。
SPSS聚类分析加具体案例
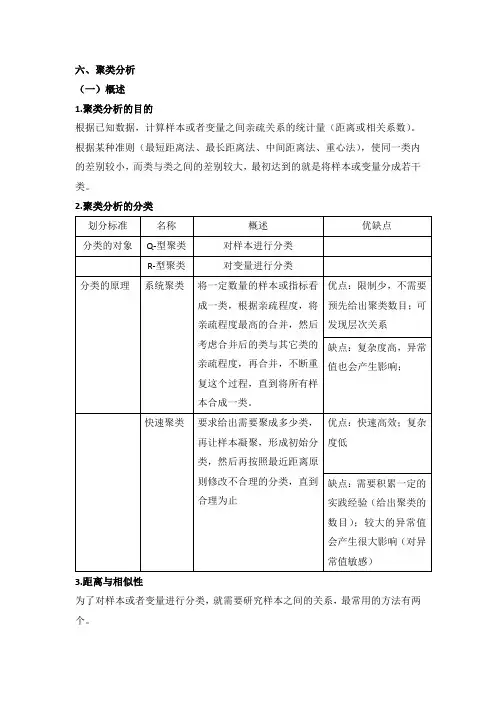
六、聚类分析(一)概述1.聚类分析的目的根据已知数据,计算样本或者变量之间亲疏关系的统计量(距离或相关系数)。
根据某种准则(最短距离法、最长距离法、中间距离法、重心法),使同一类内的差别较小,而类与类之间的差别较大,最初达到的就是将样本或变量分成若干类。
2.聚类分析的分类3.距离与相似性为了对样本或者变量进行分类,就需要研究样本之间的关系,最常用的方法有两个。
(二)系统聚类1.系统聚类的步骤距离的具体定义及计算方式计算n各样本两两之间的距离将距离接近的数据依次合并为一类,再计算,再合并 画聚类图,解释类与类之间的关系2.亲疏程度度量方法3.系统聚类的分类4.SPSS操作及实例SPSS采用的是凝聚法。
案例:根据30个省的23个主要行业的平均工资情况,通过聚类分析来判断哪些地区平均工资水平高。
SPSS操作及结果:打开SPSS上方菜单栏中的分析->分类->系统聚类选择变量->勾选统计量->在绘制里选择树状图和冰柱图勾选方法(通常使用组间联接)->度量区间->选择标准化方式(全距从0到1)下图为近似矩阵表,标注了相关系数,数值越大,距离越接近下图为聚类分析结果表,第一类表示这是聚类分析的第几步,第二三列表示该步中那几个样本或者小类聚成一类,第四列表示距离,第五六列表示本步骤中参与的是个体还是小类(0表示样本,非0表示第n步生成的小类),第七列表示本步骤的聚类结果将在以下第几步中用到。
下面是冰柱图和树状图的结果,根据树状图可以看出,如果分为三类的话,第一类包括北京上海,第二类包括天津、广东、浙江、江苏、西藏,剩下的归为一类。
(三)快速聚类(适合大样本聚类)1.快速聚类的步骤指定聚类数目K确定K个初始类的中心(自定义或者根据数据中心初步确定)根据距离最近的原则进行分类根据新的中心位置,重新计算每一记录距离新的类别中心的的距离,并重新分类重复步骤4,直到达到标准2.SPSS操作及实例打开SPSS上方菜单栏中的分析->分类->K-均值聚类选择变量->勾选统计量->定义变量值选择迭代次数->选项(勾选初始聚类中心、每个个案的聚类信息)->定义变量值->保存(勾选聚类成员、聚类中心距离)下图为输出的初始聚类中心下图为最终距离中心,第一类平均工资最高,第二类次之,第三类最低下图为每个聚类中的案例数和聚类成员。
层次聚类分析案例
层次聚类分析案例层次聚类分析是一种常用的数据挖掘技术,它通过对数据集进行分层聚类,将相似的数据点归为一类,从而实现对数据的有效分类和分析。
本文将以一个实际案例为例,介绍层次聚类分析的应用过程和方法。
案例背景。
某电商平台希望对其用户进行分类,以便更好地进行个性化推荐和营销活动。
为了实现这一目标,我们将运用层次聚类分析方法对用户进行分类,并找出具有相似特征的用户群体。
数据准备。
首先,我们需要收集用户的相关数据,包括用户的购买记录、浏览记录、点击记录、收藏记录等。
这些数据将构成我们的样本集合,用于进行层次聚类分析。
数据预处理。
在进行层次聚类分析之前,我们需要对数据进行预处理,包括数据清洗、数据标准化等工作。
通过数据预处理,我们可以排除异常值和噪声,使得数据更加适合进行聚类分析。
层次聚类分析。
在数据预处理完成之后,我们将使用层次聚类分析算法对用户进行分类。
该算法通过计算不同用户之间的相似度,将相似度较高的用户归为一类。
通过层次聚类分析,我们可以得到用户的不同分类结果,从而实现对用户群体的有效划分。
结果分析。
最后,我们将对层次聚类分析的结果进行分析和解释。
通过对不同用户群体的特征和行为进行分析,我们可以更好地理解用户群体的特点和需求,为电商平台的个性化推荐和营销活动提供有力的支持。
总结。
通过本案例的介绍,我们可以看到层次聚类分析在用户分类和群体分析中的重要作用。
通过对数据的分层聚类,我们可以更好地理解用户群体的特征和行为,为个性化推荐和营销活动提供有力的支持。
希望本文能够对层次聚类分析的应用有所启发,为相关领域的研究和实践提供参考和借鉴。
结语。
层次聚类分析是一种强大的数据挖掘工具,它在用户分类、群体分析等领域具有广泛的应用前景。
通过本文的介绍,相信读者对层次聚类分析有了更深入的理解,希望大家能够在实际应用中灵活运用层次聚类分析方法,为相关问题的解决提供更好的支持。
数据聚类算法在客户细分中的实际案例分析
数据聚类算法在客户细分中的实际案例分析随着大数据时代的到来,企业们意识到了数据的重要性,并开始利用数据来帮助他们做出更明智的决策。
其中一个非常重要的数据应用领域就是客户细分。
通过客户细分,企业可以更好地了解不同类型的客户,为他们提供定制化的产品和服务。
而数据聚类算法作为一种常用的数据挖掘技术,可以有效地对客户进行分组和分类,从而实现客户细分的目标。
本文将通过一个实际案例分析,来探讨数据聚类算法在客户细分中的应用。
假设我们是一家电子商务公司,我们希望通过客户细分,了解我们的客户,并为他们提供更好的购物体验。
首先,我们需要收集客户的相关数据。
这些数据可以包括客户的购买记录、浏览记录、个人信息等。
以这些数据作为输入,我们可以通过聚类算法对客户进行分组。
常用的聚类算法包括K均值算法、层次聚类算法和密度聚类算法等。
在本案例中,我们选择了K均值算法来进行客户细分。
K均值算法是一种非监督式学习方法,它将n个客户数据点划分为k个簇,每个簇都有一个代表点,称为聚类中心。
算法的核心思想是最小化每个数据点与其所属簇的聚类中心之间的距离。
在本案例中,我们将通过K均值算法将客户划分为不同的群组。
在执行K均值算法之前,我们需要对数据进行预处理和特征选择。
预处理包括缺失值处理、异常值处理和数据归一化等。
特征选择则是保留与客户细分相关的特征,对于电商公司来说,可以选择购买力、购买频率、商品类别偏好等作为特征。
完成数据预处理和特征选择之后,我们可以开始执行K均值算法。
首先,我们需要确定簇的数量k。
一种常用的方法是采用肘部法则,即通过改变簇的数量k,计算每个k值对应的平均平方误差(SSE),选取使得SSE急剧下降的k值作为最佳的簇数。
在本案例中,我们将假设最佳的簇数k为3。
根据K均值算法的原理,我们随机选择3个初始的聚类中心点,然后迭代地计算每个数据点与各个聚类中心点之间的距离,并将其划分到距离最近的簇中。
在执行完若干次迭代之后,K均值算法会收敛并得到最终的结果。
SPSS教程-聚类分析-附实例操作
各地区各行业工资水平的分析(2009年数据)小组成员:张艺伟、赵月、陈媛、邹莉、朱海龙、曾磊、胡瑛、候银萍1.研究背景及意义1.1 研究背景工资水平是指一定区域和一定时间内劳动者平均收入的高低程度。
生产决定分配,只有经济发展才能提供更多的可分配的社会产品,因此一个地区的工资水平在一定程度上反映了其经济发展的水平。
1.2 研究意义1. 通过多元统计分析方法,探究一个地区的工资水平与其经济发展水平之间的内在联系。
2. 将平均工资水平划分为3类,分析哪些地区、哪些行业的工资水平较高,可以为大学生就业提供宏观上的方向指引。
2.数据来源与描述2.1 数据来源——《中国劳动统计年鉴─2010》(URL:/Navi/YearBook.aspx?id=N2011010069&floor=1###)主编单位:国家统计局人口和就业统计司,人力资源和社会保障部规划财务司出版社:中国统计出版社简介:《中国劳动统计年鉴─2010》是一部全面反映中华人民共和国劳动经济情况的资料性年刊。
本刊收集了2009年全国和各省、自治区、直辖市、香港特别行政区、澳门特别行政区的有关劳动统计数据。
本书资料的取得形式主要有国家和部门的报表统计、行政记录和抽样调查。
2.2 数据描述本数据集记录了全国31个省市(港、澳、台除外)的工资状况,各省市分别记录了其23个主要行业的平均工资水平,这23个主要行业包括:企业、事业、机关、金融业、制造业、建筑业、房地产业、农林牧渔业等等,具体数据格式参见图-0。
图-03.分析方法及原理3.1 通过描述统计分析方法,判断哪些行业平均工资水平较高描述统计分析方法主要是从基本统计量(诸如均值、方差、标准差、极大/小值、偏度、峰度等)的计算和描述开始的,并辅助于SPSS提供的图形功能,能够把握数据的基本特征和整体的分布特征。
在本案例中,通过比较不同行业(诸如企业、事业、机关、建筑业、制造业……)工资的均值、极大/小值,可以从总体上判断哪些行业的平均工资水平较高,哪些行业的较低。
spss样本聚类案例分析
原数据名称总人口从业人员土地面积耕地面积财政收入粮食产量龙固镇58089.0029906.005302.002670.004435.0026564.00杨屯頸56235.0024033.004100.002040.001874.0028327.00大屯镇82418.0035558.007380.003793.005370.0037803.00沛城镇84487.0052675.006600.005161.006085.0050950.00胡寨镇37952.0020190.004594.002727.001779.0032305.00魏庙镇53677.0031875.005200.003706.001974.0029220.00五段镇45860.0021148.004700.002800.002099.0042762.00张庄镇90950.0042858.0011200.006800.001695.0035511.00张寨镇89017.0038344.0010634.006847.003028.004739.00敬安镇63200.0031940.009600.005003.002638.0026260.00河口镇58895.0029580.008257.005324.001655.0010821.00栖山頸63711.0026292.008951.006386.002203.00494.00鹿楼镇71143.0035285.0012540.005991.002250.0040500.00朱寨镇60112.0025776.007900.004482.001449.0033611.00安国镇85083.0051974.0013329.005634.004313.0033911.00------------1・1样本聚类(Q聚类)JJU .00 Ib^.UU Jbbll.UU 30方0D 4739.00.00.00至统嶷类分析:统才蛍.00.00.00.00 ◎无迥)' •单一方买⑤鬆类»(Bj:最小惑数勉:[缝绫II取希II帮助I聚类表通过系数做出其散点图群集成员案例群集数使用平均联接(组间)的树状图重新调整距离聚类合并1.2变量聚类(R 聚类)近似矩阵案例矩阵文件输入总人口从业人 员土地面积耕地面 积 财政收 入粮食产 量总人口 1.000 .857 .698 .714 .512 .043 从业人.8571.000.597.570.643.277员土地面.698.5971.000.856.044-.147积耕地面.714.570.8561.000 -.001-.335积21M8.C0 U70J.C0 2EO3.C0 GEODCO羽丸d 31940 2^60CO 26292 CO劇a 标皿35265 CO®EXal|N):5776 CO 引97」CO卡方血 0计砲• |転瓦ndzn 距阉O 二分卷回:咖SUB忝统蟹凭分析:力链厂沱屯<3丄)I 卿符弓也丄刼碇到01全距归4255B.C011ZOD.CO 咖 3427G2.C01SK.C0 2S511.CO[齢]躺般|/总人口 少丛业人员 少土地面枳 炉辭地而枳细 Q...方法妙财政收.512 .643 .044 001 1.000 .342 入粮食产.043 .277 -147 335 .342 1.000 量聚类表群集成员案例粮您产蜀财政收入耕地面枳土地面枳从业人员总人口使用平均联接(纽间)的树状图2. K—均值聚类原数据描述统计量:均值聚类分析:…冈星H 初始聚类中心(!)ffl gNOVA 表(A)■■“ ••“ ••“ •■“ •••• •■“ ・•••••••••••••••••••••••••• •••• •••• IN极小值 极大值均值 标准差身髙月平均增长19.3411.03 1.88422. 5634率2体重月平均增长19.4950. 30 5. 6363 11. 718率14胸围月平均增长19.1611.81 1.49582. 7933率9坐髙月平均增长19.1411.27 1. 71112. 8070率9有效的N (列表19状态)66153049J714212-.12513K3-.046697卅K 均佰垦艮分・・・区)|E 标准©O[竝]确用|缺失值@按列表排除个案也)O按对排除个案Q输出结果:初始聚类中心迭代历史记录4a.由于聚类中心内没有改动或改动较小而达到收敛。
主成分分析案例聚类分析案例
主成分分析案例/聚类分析案例我国各地区行业结构分析摘要:近年来,我国各行各业得到了高速发展,许多新兴行业也伴随着人们的多样化需求而日益成熟。
文章利用主成分分析、聚类分析、典型相关分析和判别分析方法对我国各地区行业工资进行分析,探讨我国各区域之间行业结构的差异,从而为各地政府根据地区间的行业结构差异制定更加合理的引导性政策提供更加有效的决策依据。
关键词:行业结构主成分分析聚类分析典型相关分析判别分析1.相关经济指标及数据选取1.1相关经济指标本文以2013年我国各地区城镇私营单位就业人员平均工资为标准,选取了农、林、牧、渔业,制造业,电力、热力、燃气及水生产和供应业,建筑业,批发和零售业,交通运输、仓储和邮政业,住宿和餐饮业,信息传输、软件和信息技术服务业,金融业,房地产业,租赁和商务服务业,科学研究和技术服务业,水利、环境和公共设施管理业、居民服务、修理和其他服务行业,教育,卫生和社会工作,文化、体育和娱乐业作为标准,对我国各地区的行业结构进行分析。
1.2数据选取本文数据来自2014年中国统计年鉴,由于西藏人烟稀少,缺少数据,因此选取了30个省的部分数据。
表1-1 分地区按行业分城镇私营单位就业人员平均工资(2013年)地区农、林、制造业电力、热力、建筑业批发和零售交通运输、住宿和餐饮信息传输、北京32531 42809 41939 40942 40742 34213 34517 73626 天津41255 42765 34968 39704 40093 48095 38877 46580 河北24198 28983 27760 28852 25345 30108 24783 27827 山西21064 27348 27199 29185 25978 22411 20577 21177 内蒙古31246 33368 41316 35242 29201 40449 29899 33239 辽宁24194 29354 25658 33830 28330 31019 26197 30848 吉林18281 22915 19804 24389 25170 25836 22530 29716 黑龙江18992 24899 24063 27687 23335 22793 22768 26667 上海22722 30443 31231 32413 27420 36601 28119 58420 江苏32507 36188 36986 37051 34213 37625 32144 48032 浙江27932 33186 28185 39113 33766 38760 30096 46003安徽21159 31943 26903 35024 27437 38871 27810 21489 福建30234 35460 29918 39207 33192 40793 28951 46072 江西25854 26924 31275 32085 25652 29388 22678 30168 山东30394 34705 39881 35392 31817 35833 30311 37675 河南19869 23142 23711 27104 23086 24919 21798 22215 湖北17742 25696 26030 27611 23028 23379 23694 33526 湖南23363 27287 32001 29932 23271 25321 23264 35898 广东25709 35646 21670 37488 40866 41074 29401 61935 广西22762 29315 27879 30752 25026 28395 24300 26484 海南16593 27836 20408 33335 29126 37389 27086 29651 重庆27961 35398 34641 36539 32919 34703 27616 38615 四川25127 29652 30099 30850 29149 29386 26066 28671 贵州18034 27183 43575 26704 22260 23913 21155 35040 云南21580 24646 26405 27603 28732 28718 25552 25011 陕西22480 25582 25193 26140 24392 25359 23418 33454 甘肃19319 24212 24873 25256 26544 25435 18656 25994 青海18363 27676 33502 24730 27760 25290 24295 24681 宁夏24172 31638 32293 36178 28035 30101 28544 29269 新疆30308 32990 33911 41001 27373 37746 24646 312792.主成分分析2.1构造因子变量的前提主成分分析的目的是从众多原有变量中提炼少数具有代表性的因自变量。
混合聚类分析方法
06 混合聚类分析的案例研究
案例一:基因表达数据的混合聚类分析
总结词
基因表达数据的混合聚类分析有助于 发现不同基因之间的模式和关联,揭 示生物过程的内在机制。
详细描述
通过对基因表达数据的混合聚类分析, 可以识别出不同细胞类型或不同生理 状态下基因表达的差异,进一步了解 细胞发育和疾病发生过程中的基因调 控机制。
竞争者分析
通过混合聚类分析,可以将竞争者分成不同的组,有助于了解各组的竞争优势 和劣势。
图像处理
图像分割
混合聚类分析可以将图像分割成多个区域, 有助于识别图像中的不同物体或特征。
图像压缩
通过混合聚类分析,可以将相似的像素点归 为一组,从而实现图像的压缩和降噪。
文本挖掘
主题建模
混合聚类分析可以用于识别文本中相似的主题或观点,有助于理解文本的内容和结构。
特点
混合聚类分析能够同时处理不同 形状和密度的聚类,并能够识别 出不同规模的聚类,从而更准确 地反映数据的内在结构。
混合聚类分析的重要性
01
揭示数据集的复杂结构
混合聚类分析能够揭示数据集中存在的不同聚类,这些聚类可能由不同
的分布或模式组成,有助于深入了解数据的内在规律和特征。
02
提高聚类的稳定性和可解释性
聚类结果应具有可解释性,能够为业务提供有意义的洞察和指导。
可视化展示
通过可视化技术,如热图、散点图等,直观展示聚类结果和数据特 征。
03 混合聚类分析的常用方法
K-means聚类
总结词
一种迭代算法,通过不断将数据点分配给最近的聚类中心来 形成聚类。
详细描述
K-means聚类是一种非常流行的聚类算法,它通过迭代过程 将数据点分配给最近的聚类中心,并重新计算每个聚类的中 心点,直到达到收敛条件。该算法需要预先设定聚类的数量 ,并且对初始聚类中心的选择敏感。