
ascii字符 字库的建立
0x00,0x00,0xC0,0x38,0xE0,0x00,0x00,0x00,0x20,0x3C,0x23,0x02,0x02,0x27,0x38,0x20,
然后将所有的字模数据复制到一个文本文件,删除其中的空行,换行,注释等与字模数据无关的内容,并将文件最后的一个逗号改为ASCII字符的句号,得到一个纯字模数据文件ascii_zk.txt
#include <stdio.h>
#include <stdlib.h>
/*
*将一个ascii字符转换为数
*/
unsigned char c2x(char ch)
{
unsigned char temp=0;
if(ch>=0x30 && ch<=0x39)
temp = ch-0x30;
else if(ch>=0x41 && ch<=0x46)
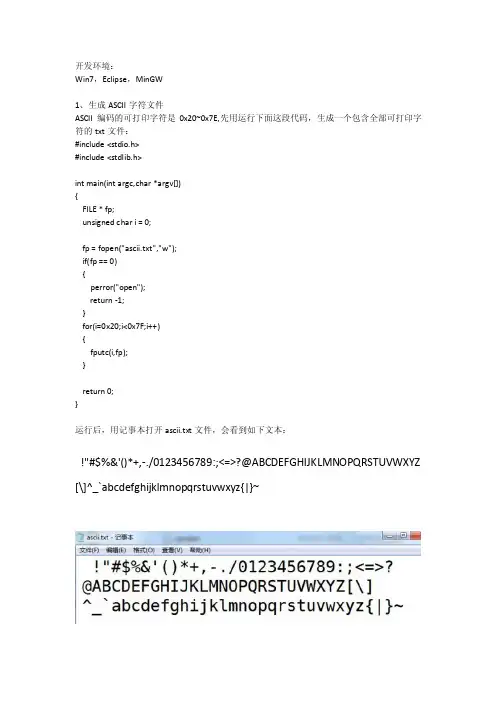
!"#$%&'()*+,-./0123456789:;<=>?@ABCDEFGHIJKLMNOPQRSTUVWXYZ[\]^_`abcdefghijklmnopqrstuvwxyz{|}~
2、生成字模数据
使用字模提取V2.1软件,设置字体为宋体、12,纵向取模,字节倒序(即高位在下)。这些设置可以根据实际情况设置。用C51格式生成字模,大小是8*16,每个字符用16个字节表示。如字符A的显示如下:
int displaychar(FILE *fp,char dispch,char fillch,char start_x,char start_y);
int main(void)
{
FILE* fp=0;
int i = 0;
const char * teststring="I love Julia";
return 0;
}
/*
*以点阵方式显示一个ASCII字符
* dispch是要显示的字符,fillch是填充点阵的字符
* start_x,start_y是显示的起始坐标
*/
int displaychar(FILE *fp,char dispch,char fillch,char start_x,char start_y)
4、字库文件ascii_zk.bin的使用
ascii_zk.bin文件从ASCII码的空格(0x20)开始,每16个字节表示一个字符的点阵字模。以字母A为例,它的ASCII码是0x41,那么,它的字模数据的开始位置就是:
(0x41-0x20)*16
从这个位置开始依次读取16个字节,就是字母A的字模数据,将其显示即可。
例:用Linux的终端模拟显示点阵字符,终端屏幕中的每个字符位置就是一个点,程序如下。
[cpp] view plain copy
#include <stdio.h>
#include <unistd.h>
#include <curses.h>
#define START 0x20
#define DATANUM 0x10
unsigned char ch=0;
int i=0;
FILE *frp=0;
FILE *fwp=0;
for(i=0; i<5; i++)
buffer[i] = 0;
frp=fopen("ascii_zk.txt","r");
fwp=fopen("ascii_zk.bin","w");
while(buffer[4] != 0x2e) //全部数据以句号结尾
{
FILE * fp;
unsigned char i = 0;
fp = fopen("ascii.txt","w");
if(fp == 0)
{
perror("open");
return -1;
}
for(i=0x20;i<0x7F;i++)
{
fputc(i,fp);
}
return 0;
}
运行后,用记事本打开ascii.txt文件,会看到如下文本:
{
int location = ((dispch-START) * DATANUM);
char x=start_x;
char y=start_y;
int i=0;
int j=0;
char buf=0;
//将文件流指针移到到dispch字符点阵数据的起始位置
fseek(fp,location,SEEK_SET);
}
else
{
x++;
}
}
return 0;
}
该程序在Fedora12的终端中运行,效果如下:
fp=fopen("ascii_zk.bin","r");
initscr();
for(i=0;(teststring[i]!=0);i++)
{
displaychar(fp,teststring[i],'*',0+(i*8),0);
}
refresh();
while(1);
endwin();
fclose(fp);
开发环境:
Win7,Eclipse,MinGW
1、生成ASCII字符文件
ASCII编码的可打印字符是0x20~0x7E,先用运行下面这段代码,生成一个包含全部可打印字符的txt文件:
#include <stdio.h>
#include <stdlib.h>
int main(int argc,char *argv[])
{
for(i=0; i<5; i++)
buffer[i]=fgetc(frp);
ch = c2x(buffer[2]);
ch = ch*16;
ch = ch+c2x(buffer[3]);
fputc(ch,fwp);
}
fclose(frp);
fclose(fwp);
return 0;
}
字库文件制作完毕。
3、将字模数据文件转换为二进制文件
将ascii_zk.txt文件中的每个字模数据转换为占一个字节的数,将所有的数据填充为一个二进制文件ascii_zk.bin。这样,按照ASCII码的顺序,ascii_zk.bin中每16个字节就可以绘制一个字符。文件转换的程序如下:
[cpp] view plain copy
for(i=0;i<DATANUM;i++)
{
buf = fgetc(fp);
//显示一个字节
for(j=0;j<8;j++)
{
move(y+j,x);
if(buf & (0x01<<j))
addch(fillch);
}
if(x == (start_x+7))
{
x = start_x;
y = (start_y+8);
temp = 0x0a+(ch-0x41);
else if(ch>=0x61 && ch<=0x66)
temp = 0x0a+(ch-0x61);
else
temp =0xff;
retuБайду номын сангаасn temp;
}
//将ascii_zk.txt转换为二进制文件
int main(void)
{
char buffer[5];
计算机中的常用编码

计算机中的常用编码计算机中的常用编码字符又称为符号数据,包括字母和符号等。
计算机除处理数值信息外,大量处理的是字符信息。
例如,将高级语言编写的程序输入到计算机时,人与计算机通信时所用的语言就不再是一种纯数字语言而是字符语言。
由于计算机中只能存储二进制数,这就需要对字符进行编码,建立字符数据与二进制数据之间的对应关系,以便于计算机识别、存储和处理。
1. ASSII码目前,国际上使用的字母、数字和符号的信息、编码系统种类很多,但使用最广泛的是ASCII码(American Standard Code for Interchange)。
该码开始时是美国国家信息交换标准字符码,后来被采纳为一种国际通用的信息交换标准代码。
ASCII码总共有128个元素,其中包括32个通用控制字符,10个十进制数码,52个英文大、小写字母和34个专用符号。
因为ASCII码总共为128个元素,故用二进制编码表示需用7位。
任意一个元素由7位二进制数D7D6D5D4D3D2D1表示,从0000000到1111111共有128种编码,可用来表示128个不同的字符。
ASCII码是7位的编码,但由于字节(8位)是计算机中常用单位,故仍以1字节来存放一个ASCII字符,每个字节中多余的最高位D7取为0。
表1-3所示为7位ASCII编码表(省略了恒为0的最高位D7)。
表1-3 7位ASCII编码表要确定某个字符的ASCII码,在表中可先查到它的位置,然后确定它所在位置相应的列和行,最后根据列确定高位码(D6D5D4),根据行确定低位码(D3D2D1D0),把高位码与低位码合在一起就是该字符的ASCII码(高位码在前,低位码在后)。
例如,字母A的ASCII码是1000001,符号"+"的ASCII码是0101011。
ASCII码的特点如下。
编码值0~31(0000000~0011111)不对应任何可印刷字符,通常为控制符,用于计算机通信中的通信控制或对设备的功能控制;编码值为32(0100000)是空格字符,编码值为127(1111111)是删除控制DEL码;其余94个字符为可印刷字符。
计算机中信息的表示方法

计算机中信息的表示方法计算机要处理的信息是多种多样的,如日常的十进制数、文字、符号、图形、图像和语言等。
但是计算机无法直接“理解”这些信息,所以计算机需要采用数字化编码的形式对信息进行存储、加工、和传送。
信息的数字化表示就是采用一定的基本符号,使用一定的组合规则来表示信息。
计算机中采用的二进制编码,其基本符号是“0”和“1”。
一、进制计数的方法有很多种,在日常生活中我们最常见的是国际上通用的计数方法——十进制计数法。
但是除了十进制外还有其他计数制,如一天24小时,称为24进制,一小时60分钟,称为60进制,这些称为进位计数制。
计算机中使用的是二进制。
这几种进制采用的都是带权计数法,它包含两个基本要素:基数、位权。
基数是一种进位计数制所使用的数码状态的个数。
如十进制有十个数码:0、1、2……7、8、9,因此基数为10。
二进制有两个数码:0和1,因此基数为2。
位权表示一个数码所在的位。
数码所在的位不同,代表数的大小也不同。
如十进制从右面起第一位是个位,第二位是十位,第三位是百位,……。
“个(100)、十(101)、百(102)、千(103)……”就是十进制位的“位权”。
每一位数码与该位“位权”的乘积表示该位数值的大小。
如十进制中9在个位代表9,在十位上代表90。
二进制的表示一般一个长度为n 的二进制数a n-1……a1a0,用科学计数法表示为:a n-1……a1a0= a n-1×2n-1+……a1×21+a0×20。
例如,二进制数10101用科学计数法表示:10101=1×24+0×23+1×22+0×21+1×20。
进制转换在计算机世界中还涉及到八进制、十进制和十六进制。
下面将讲述这几种进制之间的转换。
1.二进制与十进制的转换(1)二进制转十进制方法:“按权展开求和”例:(1011.01)2=(1×23+0×22+1×21+1×20+0×2-1+1×2-2)10=(8+0+2+1+0+0.25)10=(11.25)10(2)十进制转二进制·十进制整数转二进制数:“除以2取余,逆序输出”例:(89)10=(1011001)22 892 44 (1)2 22 02 11 02 5 (1)2 2 (1)2 1 00 (1)·十进制小数转二进制数:“乘以2取整,顺序输出”例:(0.625)10= (0.101)20.625X 21.02.八进制与二进制的转换例:将八进制的37.416转换成二进制数:3 7 .4 1 6011 111 .100 001 110即:(37.416)8 =(11111.10000111)2例:将二进制的10110.0011 转换成八进制:0 1 0 1 1 0 .0 0 1 1 0 02 6 .1 4即:(10110.011)2=(26.14)83.十六进制与二进制的转换例:将十六进制数5DF.9 转换成二进制:5 D F .90101 1101 1111 .1001即:(5DF.9)16=(10111011111.1001)2例:将二进制数1100001.111 转换成十六进制:0110 0001 .11106 1 . E即:(1100001.111)2=(61.E)16二进制的运算:算术运算:加法:0+0=0 ,0+1=1,1+0=1,1+1=10减法:0-0=0,1-0=1,1-1=0,10-1=1乘法:0*0=0,0*1=0,1*0=0,1*1=1位运算与:0 and 0=0 , 0 and 1=0 , 1 and 0=0 , 1 and 1=1或:0 or 0 =0 , 0 or 1=1 , 1 or 0=1 , 1 or 1=1非:not 0=1 , not 1=0异或:0 xor 0=0 , 0 xor 1=1 , 1 xor 0 =1 , 1 xor 1 =0位移运算左移(二进制数k左移n位):k shl n = k * 2n右移(二进制数k右移n位):k shr n = k div 2n例:求下列二进制数运算的结果101+101=1010101*11=11111000-11=1011001 shl 2=1001001100110 shr 2 =11001二、计算机中数的表示在普通数字中,用“+”或“—”符号在数的绝对值之前来区分数的正负。
ascii字符字库的建立
开发环境:Win7,Eclipse,MinGW1、生成ASCII字符文件ASCII编码的可打印字符是0x20~0x7E,先用运行下面这段代码,生成一个包含全部可打印字符的txt文件:#include <stdio.h>#include <stdlib.h>int main(int argc,char *argv[]){FILE * fp;unsigned char i = 0;fp = fopen("ascii.txt","w");if(fp == 0){perror("open");return -1;}for(i=0x20;i<0x7F;i++){fputc(i,fp);}return 0;}运行后,用记事本打开ascii.txt文件,会看到如下文本:!"#$%&'()*+,-./0123456789:;<=>?@ABCDEFGHIJKLMNOPQRSTUVWXYZ [\]^_`abcdefghijklmnopqrstuvwxyz{|}~2、生成字模数据使用字模提取V2.1软件,设置字体为宋体、12,纵向取模,字节倒序(即高位在下)。
这些设置可以根据实际情况设置。
用C51格式生成字模,大小是8*16,每个字符用16个字节表示。
如字符A的显示如下:取模数据为:0x00,0x00,0xC0,0x38,0xE0,0x00,0x00,0x00,0x20,0x3C,0x23,0x02,0x02,0x27,0x38,0x20,然后将所有的字模数据复制到一个文本文件,删除其中的空行,换行,注释等与字模数据无关的内容,并将文件最后的一个逗号改为ASCII字符的句号,得到一个纯字模数据文件ascii_zk.txt3、将字模数据文件转换为二进制文件将ascii_zk.txt文件中的每个字模数据转换为占一个字节的数,将所有的数据填充为一个二进制文件ascii_zk.bin。
字库显示方法

我们知道英文字母数量比较少,我们只要用一个字节(8位)就足以表达。
但是汉字非常多。
要怎么表达呢?前人采用的一个方法就是把ASCII码的高128位作为汉字的内码,低128位仍然作为英文字母的内码,然后用两个字节来表示一个汉字。
通过这个内码,我们可以获取汉字的字模信息。
然后再根据这些字模的信息,把相应的汉字显示出来。
二、什么是汉字字库?如何寻址?点阵字库其实就是按照汉字内码的顺序,把汉字的字模信息存起来。
16×16的点阵字库有94区,每个区有94个汉字的字模。
这样总的有94×94个汉字。
我们之前说了,一个汉字由两个ASCII扩展码构成。
第一个ASCII扩展码用来存放汉字的区码,第二个ASCII扩展码用来存放汉字的位码。
具体是这样的:第一个扩展ASCII码= 128 + 汉字的区码第二个扩展ASCII码= 128 +汉字的位码这样,如果我们用char HZ[2]来表示一个汉字。
则:区码= HZ[0] - 128位码= HZ[1] - 128这样,算出区位码之后,我们就可以用它在汉字库里面寻址找字模了。
具体的方式是:该汉字的偏移地址 = (区码-1)×94×一个字占用的字节数+位码×一个字占用的字节数这样我们就很容易的写出显示汉字字模的函数:INT8U *HZK = (INT8U *)0x801c0000; /* 汉字字库的存储地址*/INT8U *ASCII = (INT8U *)0x801fba00; /* ASCII码字库的存储地址 */INT8U const cmp_w[8]={128,64,32,16,8,4,2,1};/********************************************************************************** ************************* Function : DisplayHZ()** Description: 该函数用于在F DGK/GUI上显示一个汉字。
AscII码字模提取方法
LCM19264液晶屏显示中ASCII码字模库的提取办法并构建一个二维数组
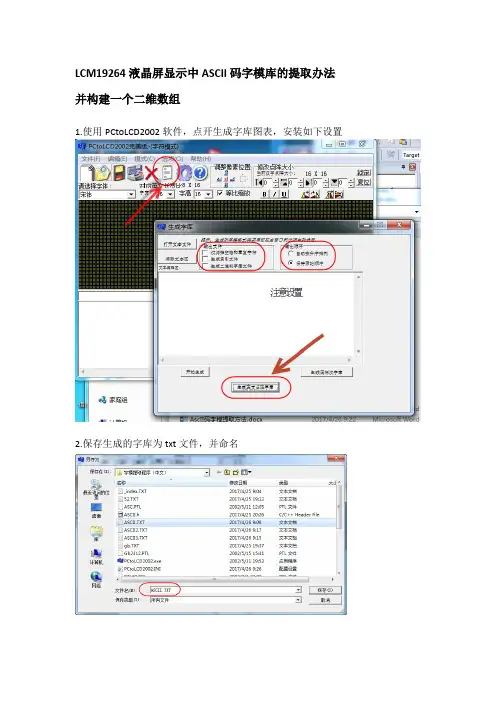
1.使用PCtoLCD2002软件,点开生成字库图表,安装如下设置
2.保存生成的字库为txt文件,并命名
3.打开刚刚生成的TXT文件,里面的每一行代表一个ASCII码的字码。
注意:31以上(包括31为不可见字符,我们不需要)
4. 在keil下新建文件Ascii.h,用了保存ASCII码字模Ascii.h文件内内容如下
以上声明了一个二维数组nAscii[][] ,并使用Code关键字将数组定义在Flash空间内,二维数组的第二位大小为16 ,此值为一个Ascii码字模的大小。
5. 将第3步文件中的可见字符复制到Ascii.h文件内的二维数组nAscii[][16] 中。
最后内容如下。
ASCII

我们需要了解的最早编码是ASCII码。它用7个二进制位来表示,由于那个时期生产的大多数计算机使用8位大小的字节,因此用户不仅可以存放所有可能的 ASCII字符,而且有整整一位空余下来。如果你技艺高超,可以将该位用做自己离奇的目的:WordStar中那个发暗的灯泡实际上设置这个高位,以指示一个单词中的最后一个字母,同时这也宣示了WordStar只能用于英语文本。
注意,虽然说utf是为了使用更少的空间而使用的,但那只是相对于unicode编码来说,如果已经知道是汉字,则使用GB2312/GBK无疑是最节省的。不过另一方面,值得说明的是,虽然utf编码对汉字使用3个字节,但即使对于汉字网页,utf编码也会比unicode编码节省,因为网页中包含了很多的英文字符。
英文名:ChineseInternal Code Specification
中文名:汉字内码扩展规范1.0版
双字节编码,GB2312-80的扩充,在码位上和GB2312-80兼容
范围:8140~FEFE(剔除xx7F)共23940个码位
2. 国家标准汉字交换码
我国制定了“中华人民共和国国家标准信息交换汉字编码”,标准代号为GB2312—80,这种编码又称为国标码。在国标码的字符集中共收录了一级汉字3755个,二级汉字3008个,图形符号682个,三项字符总计7445个。
在国标GD2312—80中规定,所有的国标汉字及符号分配在一个94行、94列的方阵中,方阵的每一行称为一个“区”,编号为01区到94区,每一列称为一个“位”,编号为01位到94位,方阵中的每一个汉字和符号所在的区号和位号组合在一起形成的四个阿拉伯数字就是它们的“区位码”。区位码的前两位是它的区号,后两位是它的位号。用区位码就可以唯一地确定一个汉字或符号,反过来说,任何一个汉字或符号也都对应着一个唯一的区位码。汉字“母”字的区位码是3624,表明它在方阵的36区24位,问号“?”的区位码为0331,则它在03区3l位。
【实训】谈一谈你所理解的汉字信息在计算机里的存储与表达的过程与原理,并同英文的处理做比较。
一、汉字信息在计算机中的处理与存储计算机对每一个字符进行编码形成其对应的唯一一个内码就是汉字的存储,然而同一个字符(例如“中”字)不同编码对应的内码不一样。
计算机中汉字编码一般采用两个高位( 左边第一位)为1 的ASCⅡ码表示一个汉字,即用两个字节表示一个汉字。
汉字在计算机内的编码很复杂,涉及汉字的各种代码,如汉字输入码,汉字机内码,汉字交换码,汉字字形码等。
1、汉字输入码汉字输入码也叫外码,是为了通过键盘字符把汉字输入计算机而设计的一种编码。
汉字的输入码种类繁多,大致有4种类型,即音码、形码、数字码和音形码。
2、汉字机内码汉字机内码又称内码或汉字存储码。
该编码的作用是统一了各种不同的汉字输入码在计算机内的表示。
汉字机内码是计算机内部存储、处理的代码。
3、汉字交换码汉字交换码主要是用作汉字信息交换的。
4、汉字字形码汉字字形码是指确定一个汉字字形点阵的代码(汉字字形码)。
一般采用点阵字形表示字符.普遍使用的汉字字型码是用点阵方式表示的 称为“点阵字模码”。
所谓“点阵字模码” 就是将汉字像图像一样置于网状方格上 每格是存储器中的一个位 16×16点阵是在纵向16点、横向16点的网状方格上写一个汉字 有笔画的格对应1 无笔画的格对应0。
这种用点阵形式存储的汉字字型信息的集合称为汉字字模库 简称汉字字库。
通常汉字显示使用16×16点阵 而汉字打印可选用24×24点阵、32×32点阵、64×64点阵等。
汉字字形点阵中的每个点对应一个二进制位 1字节又等于8个二进制位 所以16×16点阵字形的字要使用32个字节 16×16÷8字节 32字节 存储 64×64点阵的字形要使用512个字节。
在16×16点阵字库中的每一个汉字以32个字节存放 存储一、二级汉字及符号共8836个 需要282.5KB磁盘空间。
而用户的文档假定有10万个汉字 却只需要200KB的磁盘空间 这是因为用户文档中存储的只是每个汉字 符号 在汉字库中的地址 内码 。
字库生成程序使用方法
字库生成程序使用方法MakeFontLibV34.exe可用来生成SCL2008/SuperComm播放文本文件或直接输出文字所需要的字库文件。
1. 运行该程序2. 生成英文字库2.1 在Width和Height中输入英文文字大小(一般英文字符占半个汉字位置)2.2 如果显示屏要旋转90度使用,则选中Rotate 90 d2.3 点ASCII按钮弹出字体对话框,选择所需的字体,注意字体大小应与2.1中输入的大小一致,否则程序会自动缩放到2.1中输入的大小2.4 点确定后显示你所选择的字体信息,若正确则点Accept按钮弹出另存为对话框,选择或输入文件名点保存生成英文字库文件2.5 程序在窗口的最下方编辑框里输出字库定义字符串,须添加到CONFIG.LY文件中3. 生成中文字库3.1 在Width和Height中输入中文文字大小3.2 在1st Byte和2nd Byte处选择文字编码的起始位置:GB2312简体字编码,在1st Byte处选A0H,在2nd Byte处选A0H;Big5繁体字编码,在1st Byte处选80H,在2nd Byte处选40H。
其它编码请查阅其编码表3.3 点Local Languange按钮弹出字体对话框,选择所需的字体,注意字体大小应与2.1中输入的大小一致,否则程序会自动缩放到2.1中输入的大小3.4 点确定后显示你所选择的字体信息,若正确则点Accept按钮弹出另存为对话框,选择或输入文件名点保存生成中文字库文件3.5 程序在窗口的最下方编辑框里输出字库定义字符串,须添加到CONFIG.LY文件中4. 加载字库到控制卡4.1 修改CONFIG.LY文件,将生成字库后最下方编辑框里输出的文字添加到CONFIG.LY文件中。
并根据实际字库数量修改FontCount 的值4.2 将CONFIG.LY文件和所生成的字库上传到控制卡上即可。
字体库制作的方法和流程哦
字体库制作的方法和流程利用现有程序进行字库制作如果你是专业字体设计师,那么你一定有过制作一套属于自己的全新的中文字库之梦;但是,毕竟中文字库属大字符集当然是或大于6763个字符的字库,个人想徒手直接设计一整套中文字体谈何容易其繁复程度足以使任何人却步;但是,当今世界上图形图像程序软件已经如此发达,难道没有什么办法利用现在已有的通用软件,将复杂的工作简化,使设计师自己可以独立完成这一艰巨的工作的吗本文就时装字体的设计经验,介绍一种相对简单的方法,帮你完成的心愿;这种方法的意义在于能够使得字体设计工作化繁为简;大前提:如果你仅仅是为了设计新字样或仅只几个字,那么研读本文对你没多大帮助;本文并不介绍新字样的设计;本文是帮你在已产生了字体设计的设想之后,如何利用已有资源、不花费太大力气地将整个字库6763汉字或更多,如欲英文、数字、标点一起处理的话,包括进来即可制作出来;因此,你必须会使用图形处理的通用软件,这包括:PhotoShop、Illustrator、CorelDRAW考虑到字库制作的特殊性,应当以矢量软件为主;什么程度算是“会使用”本文是在介绍字库设计方法,不是软件教学,所以,软件使用方法点到为止;如果不能看明白,说明你还不会熟练使用,即请自行加强研究;这样做的主要目的是为了在尽量短的文字里多介绍具体方法的关键之处;关于硬件要求;说起来似乎可笑:介绍软件应用的文章,说什么硬件要求尽管如此,还是想说说:CPU当然越快越好,硬盘也是越快越大越好;硬盘设定提醒:最好把Windows的临时文档和应用图形图像软件的临时文档不要放到同一分区上,找一个空没有存放任何文件的分区更好,另放一张空的物理硬盘最好;如有条件,专门软件可做一个内存虚拟的硬盘,把那些需要倒来倒去的文件放在上面,速度会快不少;关键是内存一定要大;会使用PS的人都知道,如果图大,内存又不很充足的话,PS的某些特效是不能使用的;Illustrator有过之而无不及;即便内存足够充分,也会经常出现out of memory的要求放弃选框;我们最好不要让它出现;内存越大越好;最小1G;为什么要这么强调计算机的物理指标因为我们希望一次性地将GB2312里面的6763个字符处理完毕,这样才可以达到简化字符操作之目的;所以我们最好把所有文字放在一个文件里;在建立文件的时候,如果有可能,当然建立一个包含6763个汉字的文档;这样才能在以后动作时不必反复操作;这时就看出机器物理指标的重要性了;如果你一时无法满足要求,那么就只好退而求其次,将6763个字分割成为几块,分块处理,也没什么别的,就是麻烦点;具体方法1. 启动PS,将现有字体按照需要排列在一起,位图化;注意:1,字与字之间留有足够的空隙,以免在分割字符的时候相互影响;2,字要足够大,一般应当在10cm10cm 以上,否则矢量化的时候,精密程度会受影响;2. 按照事先的设想,对每一个字的位图笔画进行分层划分,一层一种笔画;例如1层,丶;2层,一;3层,丨;4层,丿;5层…….汉字所有不同的笔画加在一起,大概在40~50之间,应当不会超过255个,PS最多能够接受255层,满足一般的设计要求应当没有问题;或许有人会问:如果超过255怎么办也好办,再Copy一份即可;注意事项:1,汉字笔画种类虽然不多,但同一种笔画,有长短之分;不同长短之间,不同的字体设计,往往会有不同的处理方式,若相互混淆,就不美妙了;所以,在分层之初,先要做好样本测试;不要上来就干,否则事倍功半;3. 启动CorelDRAW Trace,对分层的位图进行中心矢量化;保存成为矢量文件,譬如wmf文档;4. 同样地,再在矢量软件我用的是Illustrator里建起一张分层的矢量图,将所有的矢量化的图形分层堆叠在一起;当然得有所调整,否则对不齐;5. 针对不同的层笔画,用矢量软件的填充功能一般矢量软件都有这种功能进行填充;6. 利用各种“笔刷”、“画笔”填充之后,你几乎可以得到这种结构字体除了结构变化之外的所有变化;当然,如果你水平高,或许也能填充出结构有所改观的字体来不可能脱胎换骨;但是如果想找到原字体,大概连影子也看不到了;该方法总的来说应当仅仅是一个思路;具体操作起来可以有各种变通;譬如使用CorelDRAW比较熟练的朋友,从CorelDRAW就可以完成这个工作;使用FreiHand 比较熟练的朋友,使用FreeHand也可以单独完成这个工作;完成之后,如果需要转换成为AI格式的文档,另存转换一下就可以了;当然也可以直接转换为BMP位图; FontLAB可以接受Ai的剪贴板,如果你在Illustrator里面制作的话,直接使用拷贝粘贴的方法就可以创作一个全新的字库了;直接使用Illustraor Copy&Past到FontLAB里面的好处是你设计的画笔的节点就是FontLAB里面的二阶控制点;这样所Copy出来的字库本身就是一个精密字库;关于精密字库和率意字库之区别,请参阅“提高字库质量”一文;如果你没有人力,还也希望快速得到这个字体字库,那就只有找做字网了;我们可以快速帮助你完成这个工作;但是我们的这个服务是收费的;当然,速度快,且收费价格低廉;这里,我们提供一种我们已经制作好了的、包含6763个汉字和一般常用英文、数字、标点的Illustrator的AI格式的文件;文件尽管还有各种毛病,但是基本够用;如果你有兴趣,可以下载之后自己试一试;选结构制作这种字体,首先需要确定的是你需要以一种什么样的字体结构创作你的新字;因为基于这种字体的结构,你将不止制作一个字库,而是将反复使用多次;所以,你对结构基础用字应当慎之又慎;因为你还需要对这个字体下大功夫处理,一旦感觉得不好,想换,可以,但你以前的劳动就白费了;所以说要慎之又慎;结构的变化更具有视觉的基本性;所以,理论上讲,只有达到了结构变形,整个字体才真的改变了;但是怎样才能够达到结构的变化呢大至以下几种方法可供参考:1,两字叠加法;找到两种字体,用和两种字体的结构进行叠加,从而达到创建一种新的字体结构的目的;该方法尽管理论可行,但是找到两种可以叠加的字体并不容易;因为你想叠加的字体往往参差不齐,如何修理这种参差不齐就成为该方法成败的关键;因为不是仅仅能修就可以了,而且得相对省事才行,否则过于繁琐,等于不能做;具体方法如下:A,找到两种笔画结构基本相近的字形;B,按照统一的格式进行排版,并且保证各笔画可以相互叠加到一起;C,叠加后的字形必然是参差不齐的,可用橡皮进行涂擦;D,如果嫌该涂擦过程过于繁琐,可以先行中心矢量化,转而将矢量文件导入PS,用画笔填充后,转为位图,再涂擦,这样可以稍微省事一些,不过基本的劳动还是得付出的;2,不论是在PS里面还是Illustrator里面,都有“变形”工具,可以利用它进行字体结构的变化;当然,最好这种变化是和笔画的设计结合起来的;否则过于简单机械,意思不大;具体方法是:先排版,解散群组,然后变形处理;注意,中心矢量化之后是不能够进行变形的;因为矢量化之后的图像本来就没有群组,如果变形,都是单独笔画自己在变形,也应当属于后果不可预料和控制一类;3,从一个字库的结构走向另一个字库的结构;还有一种创新字体结构的方法,就是从一种字体结构出发,利用笔画填充的技巧,令该字库的结构发生某种应当说是微量变化,然后将新字文件轮廓化之后,导成位图,再矢量化,如此反复,可令字体结构发生变化;如果你手段高明,别人或许还以为你新创作了一种字体结构;只是这种结构控制的方法比较繁琐,况且,每次都得分割笔画,投入也比较大;分块处理由于机器内存太小或软件不支持等等,很有可能在程序里不能够一次性完成6763个汉字字符的处理;这时只有分块处理;根据我们的经验,比较方便的是将文字排列为正方形,这样有利于后期的对齐和分割测量工作;刚开始需要建立位图,位图的占地面积应当充足地大;否则会影响精密度;关于如何分块这是一个分块的技巧问题;1, 分成方块,而不是长方形块;务必注意字间距和行间距;间距最好大一些,给后期处理留下一个方便的空间;否则悔之晚矣;2, 在程序能够接受的范围内,尽量少分;能少分一块,就少分一块,使用时就减少一次麻烦,劳动强度也会减少一些;也许有人会问,我使用ATN,多一块与少一块有什么区别有区别;因为我们的这种对字体的处理方法是基于Illustrator等矢量图形处理软件的;而ATN在Illustrator里面从来都不像是在PS里面一样好用;否则我们就会发布单字符的AI文件;譬如针对PS,我们就有相对的单字文件集;3, 最好把常用字和非常用字分开处理;因为有可能你会认为一次处理6763个字太麻烦,从而希望先少处理一些,看看效果以后再说,有了这种区分,就比较好处理了;否则将难以为继;4, 最好按照笔画数排序Access里面可以进行后再分块处理;不同的笔画数的填充可能会有所变化;譬如少笔画数的字的笔画填充可能需要粗一些的图案,而多笔画的字的笔画填充,笔画就得相应变细一些;有了笔画数的区分,你的处理就会方便很多;5, 英文大小写、阿拉伯数字、标点符号这些部分应当单独作为一块进行处理;因为这些东西和中文字没什么关系,也没有笔画对应的必然性;关于字符处理数和排版形状我们现在绝大多数大陆的书报刊市场使用GB2312标准的字库;GB2312内有6763个简体中文字字符;能不能处理更大的字符集当然可以,只是更麻烦罢了;其实GB2312就已经够用;如果是在一个小范围内使用的话,仅处理GB2312内的常用字3755个汉字字符也可以够用;处理3755的好处当然是更加简单方便;为什么一定要正方形主要是考虑到后期对字库进行处理时,需要对字符进行分割,在对位图进行百分比划分时,正方形易于使用PS的网格参考线对齐;如果不是正方形就会十分麻烦;此外,使用正方形也容易估测字间距与行间距;当然,如果你用不到这些,也就无所谓是否正方形了;对于6763汉字,如果作为一块正方形处理,就应当是83行×83列,略有余数;如果分为10块,大致是26行×26列;如果只处理3755个常用字,也须以正方形对行列进行开平方计算处理;文字制作技巧不分层行不行有人为了省事,希望直接用现成的字体进行填充;当然可以实现,只不过由于中心矢量化是程序自动进行的,在其过程中无法进行人工干涉,而程序进行的结果会在所有笔画分叉处形成断点,这在以后的填充当中会产生既无法预料也无法控制的结果;这一般不是我们所需要的;利用已经中心矢量化的文件,直接分层利用中心矢量化,直接对字体进行跟踪、分层,在某些情况下会比利用PS更加方便;好处是对笔画的选取比较方便直观,不像在PS里面要用橡皮擦来擦去的,既不容易擦好,也不容易消除尖角点;但也有不便宜之处:直接矢量化对于稍粗的笔画,尤其是对于有交叉的粗笔画,会产生倾斜失真;因为在中心矢量化的时候,Trace并不能智能处理你的交叉笔画;在Illustrator里面分解,矢量线在结点处被切断,需要将其连接起来;转到PS里面,用画笔描绘一遍,然后再次中心矢量化,所有断裂的笔画就全部自动缝合起来了;这样做唯一的缺点是文件格式反复翻转,会对字体细节有一定的损失;应当注意;每次翻转的时候要严格与原作相符合才好;细化字体笔画,建立精确结构你在矢量化字体的时候,一定会发现,在中心细化的过程中,细笔画的字体,还原比较真实;笔画越粗,失真越严重;所以,我们建议对于所有需要使用的字体,使用前都进行一次细化处理;注意,这种细化处理不是在PS里,而是在Illustrator里,使用距离位移工具进行;具体大小得看你图像和字体原始设置的大小;为什么一定要使用Illustrator为什么不能使用PS这里涉及到两种不同的图形图像处理方式,原理说起来比较复杂,在此从略;总而言之,使用Illustrator的距离位移工具细化字体笔画,可以最大限度地接近于原始真实,这是用PS不能或不便达到的;关于矢量化的方向问题什么是矢量矢量是一个有方向有大小的量;现在的程序对矢量的大小似乎还没有多少控制,但是矢量的方向却是有意义的;你在中心矢量化之后所得到的矢量笔画描述就是一个有方向的描绘;其作用体现在当你在Illustrator里填充一个自己已经设计好的图形笔画的时候,如果不能掌握该矢量的方向,就有可能会将头尾倒置或各笔画的头尾顺序不一;CorelDRAW Trace的跟踪方向是从左上角向右下角进行的,所以,你的位图图像当中的笔画,最好是顺同这个方向的;如果不顺怎么办好办,旋转一下,顺过来就是了;至于在旋转图像之后整造成的图像面积变化,可暂不理睬;因为矢量化后,无图像的空白部分会自动消除,你只需要在Illustrator里面打开、对齐就可以了;对于有弯曲的笔画,也需要如此处理;弯曲越多,越得小心谨慎;最好是把同一个弯曲方式的笔画编排在一起;否则将难以控制;关于字库软件及方法如果你真的想使用FontLAB Copy&Past制作一个字库的话,你当然最好有一个正版的;FontLAB公司的FontLab Studio for Win US$,网上虽可找到盗版;但不论哪种,都只支持6400个字符;这显然是冲着中文来的;你当然可以把一个字库分割成为两个部分进行,然后再在FontCreat里面合成;不过这样FontLAB所支持的多种文件格式也就都都没用了——这就是FontLAB的销售和推广策略;专门为亚洲文字设计的AsiaFont Studio 4 for Windows US$1999;据说为防盗版,须有解密U盘;其实AsiaFont就是FontLAB的一个多字符版本而已,没有更多新鲜处;大概是嫌亚洲文字当然就是中文使用者买得少,所以,到之后,再没兴趣把AsiaFont与FontLAB并驾齐驱地再开发了;其实并不是我们不买他的账,的确是它仅解决了字库文件格式问题,而没有解决汉字其它困难问题;大概以为都是字库,中西文是一回事,只因不愿意购买正版而弃之不用;其实南辕北辙,差着老大一截子哩看来跨文化、跨语言的字库制作工具绝不那么简单;关于借助外力当你会使用上述方法之后,现在所面临的问题就已经不是字体设计,而是如何简便从事,并且赚到钱;最简单的就是花钱雇人;谁都想借助外力完成自己的工作;问题在于价格;譬如你自己完全可以徒手设计一套字体,但是如果你的劳动不足以回报你的价值,如果字库不能卖出一个好价钱,你自然也没有心情去做;怎样才能够得到一个好的价钱这不是本文所讨论的问题,各位都是字体设计专家,相信各自都有自己的服务对象和销售渠道;想提醒各位的是:市场需要培育;别想一口吃成个胖子;现在中文字库市场,由于受盗版排挤,正规市场已消亡殆尽;对你来讲,所剩或许只有你所联系的需要字库的单位;倘你能将自己设计的字库销售出去,不亏本,略有盈余,就已经赚了,因为你还用字库做了个广告;这个广告难道不等于白赚吗不要小看这个广告,多少人搞了一辈子字体设计,书也不知道出了多少本,却还从未做成过一个字库哩况且,凭此广告,你完全可以进行更大规模的新一轮推销;长此以往,才能建立起一个围绕着你自己的字库市场;在你已经基本上可以比较简单地完成整个字库的设计工作后,现在的繁琐劳动主要表现在前期的笔画分解和后期的字库扫描两个方面;怎样简化劳动,尤其是简化简单劳动在此给你提点建议:笔画分解是可以雇人完成的;分解笔画比较简单,水平低一点的学生、计算机初学者等等,都可以在你的指导下完成;就像打字一样,只不过这是图像处理罢了;现在我们提供的分解文件就是请人帮忙完成的;对于字库扫描,学生们也可以做,只是生手做起来不容易做到均匀码放;我们做字网专门制作字库;具体过程请参阅价格策略部分;关于精密字库作字体设计的人,都希望自己的字库制作成为一款精密字库,而不希望制作成为率意字库;这是可以理解的;做字网只制作率意字库而不制作精密字库;如果想要精密字库,请另请高明抑或使用Copy&Past的方法,在FontLAB里面进行;可以顺利完成,就是麻烦一点而已;。
新建数据库字符集
新建数据库的字符集设置可以根据实际需求进行选择。
以下是几种常用的字符集:
UTF-8:UTF-8是一种常用的字符集,支持存储大多数Unicode字符,包括一些emoji表情。
如果应用需要存储国际化的数据或包含emoji的数据,选择UTF-8字符集是一个不错的选择。
GBK:GBK是中国大陆地区广泛使用的一种字符集,支持基本的ASCII字符和中文汉字。
如果你的应用只需要存储基本的ASCII字符,并且需要支持中文汉字,那么GBK是一个适合的选择。
Latin1:Latin1是一种支持基本的ASCII字符的字符集。
与UTF-8相比,Latin1可以节省存储空间,并且在一些性能敏感的场景下,也具有一定的优势。
如果你的应用只需要存储基本的ASCII字符,并且对存储空间有较高的要求,那么Latin1是一个不错的选择。
除了以上几种常用的字符集,MySQL还支持其他一些字符集,如GB2312、ISO-8859-1等。
如果你的应用需要和特定的字符集进行兼容,可以选择对应的字符集。
在选择字符集时,建议根据实际需求进行选择,以确保数据的正确存储和显示。