
ECM误差修正模型
协整与误差修正模型在处理时间序列数据时,我们还得考虑序列的平稳性。
如果一个时间序列的均值或自协方差函数随时间而改变,那么该序列就是非平稳的。
对于非平稳的数据,采用传统的估计方法,可能会导致错误的推断,即伪回归。
若非平稳序列经过一阶差分变为平稳序列,那么该序列就为一阶单整序列。
对一组非平稳但具有同阶的序列而言,若它们的线性组合为平稳序列,则称该组合序列具有协整关系。
对具有协整关系的序列,我们算出误差修正项,并将误差修正项的滞后一期看做一个解释变量,连同其他反映短期波动关系的变量一起。
建立误差修正模型。
建立误差修正模型的步骤如下:首先,对单个序列进行单根检验,进行单根检验有两种:ADF (Augument Dickey-Fuller )和DF(Dickey-Fuller)检验法。
若序列都是同阶单整,我们就可以对其进行协整分析。
在此我们只介绍单个方程的检验方法。
对于多向量的检验参见Johensen 协整检验。
我们可以先求出误差项,再建立误差修正模型,也可以先求出向量误差修正模型,然后算出误差修正项。
补充一点的是,误差修正模型反映的是变量短期的相互关系,而误差修正项反映出变量长期的关系。
下面我们给出案例分析。
案例分析在此,我们考虑从1978年到2002年城镇居民的人均可支配收入income 与人均消费水平consume 的关系,数据来自于《中国统计年鉴》,如表8.1所示。
根据相对收入假设理论,在一定时期,人们的当期的消费水平不仅与当期的可支配收入、而且受前期的消费水平的影响,具有一定的消费惯性,这就是消费的棘轮效应。
从这个理论出发,我们可以建立如下(8.1)式的模型。
同时根据生命周期假设理论,消费者的消费不仅与当期收入有关,同时也受过去各项的收入以及对将来预期收入的限制和影响。
从我们下面的数据分析中,我们可以把相对收入假设理论与生命周期假设理论联系起来,推出如下的结果:当期的消费水平不仅与当期的可支配收入有关,而且还与前期的可支配收入、前两期的消费水平有关。
在此先对人均可支配收入和人均消费水平取对数,同时给出如下的模型t t t lincome lconsume lconsume 2110∂+∂+∂=- t=1,2,…,n (8.1) 如果当期的人均消费水平与当期的人均可支配收入及前期的人均消费水平均为一阶单整序列,而它们的线性组合为平稳序列,那么我们可以求出误差修正序列,并建立误差修正模型,如下:t ecm lconsume lincome lconsume t t t t 4131210βββββ++∇+∇+=∇-- t=1,2,…,n(8.2)t ecm = 12110--∂-∂-∂-t t t lincome lconsume lconsume t=1,2,…,n(8.3)从(8.2)式我们可以推出如下的方程:tlincome lincome lconsume lconsume lconsume t t t t t 4030123222131131)()()1(ββββββββββ+∂-+∂--+∂--++=---(8.4)在(8.2)中lconsume ∇、 lincome ∇分别为变量对数滞后一期的值,)1(-ecm 为误差修正项,如(8.3)式所示。
(8.2)式为含有常数项和趋势项的形式,我们省略了只含趋势项或常数项及二项均无的形式。
分析步骤:1、单位根检验。
我们先介绍ADF检验。
在检验过程中,若ADF检验值的绝对值大于临界值的绝对值,则认为被检验的序列为平稳序列。
在此我们先以对lincome的检验为例,在主菜单中选择Quick/Series Statistics/Unit Root Test,屏幕提示用户输入待检验序列名,输入lincome,单击OK进入单位根检验定义的对话框,如图8.1。
图8.1对话框由三部分构成。
检验类型(Test Type)中默认项是ADF检验。
Test for unit root In 中可选择的是对原序列、一阶差分序列或是二阶差序列做单位根检验,在此我们保持默认的level,即原序列。
右上方的Include in test equation中,有三个选项,依次为含常数项,含常数项和趋势项,没有常数项且没有趋势。
在右下方的空格里默认为2,但我们一般根据AIC最小来确定滞后期数,本文选定为滞后一期。
检验的顺序为:先选含趋势项和常数项的检验,如果趋势项的T统计量不明显,就再选只含常数项的,如果常数项的T统计量不明显,就选择常数项和趋势项均不包括的一项。
当我们选含趋势项和常数项的检验时,会出现下面的结果,如图8.2所示。
图8.2在检验的结果输出窗口中,左上方为ADF检验值,右上方为1%、5%和10%的显著水平下的临界值,从图8.1中可以看出ADF统计的检验值为-3.117,其绝对值小于10%的显著水平的临界值–3.2856的绝对值。
同时趋势值的T统计来看,在5%的水平下显著。
注意,这里的T统计量不同于我们在做最小二乘时用的T统计值。
这些T统计检验的临界值在Fuller(1976)中给出.从上面的分析我们可以认为该序列为非平稳的序列,且该序列有趋势项和常数项。
在下文中我们会进行一步介绍只含常数项的和常数项与趋势项均不包括的ADF检验的过程。
在上面分析的基础上,我们回到图8.1的窗口,检验lincome差分一阶的平稳性。
在图8.1中的Test for unit root In中选差分一阶,同时在Include in test equation中选取含趋势项和常数项这一项,我们同样根据AIC和SC最小来选择滞后两期。
此时会出现如下图8.3的结果:图8.3从上图中可以看出ADF的绝对值小于5%水平下的临界值的绝对值,大于10%的检验值的绝对值。
但此时趋势项的T检验值不明显。
所以我们回到图8.1的窗口,在Include in test equation中选取含常数项这一项。
其结果如下图8.4所示,结果显示ADF的绝对值为3.4546大于5%水平下的临界值的绝对值,此时常数项的T检验值为3.34572,大于在显著水平为5%水平下的T临界值为2.61,所以常数项T检验值很明显。
我们认为lincome序列差分一阶后为平稳的。
值得注意的是,我们在此选择10%为临界值来判断非平稳的情况,而选择5%的临界值来判断平稳的情况,也就是,当ADF检验值的绝对值大于5%水平下的临界的绝对值。
图8.4同时我们也可以用命令来执行单位根检验,格式如下:uroot(lags,options,h) series_name其中,lags指式中滞后的阶数,options中可以选三个c、t和n,其中c代表含趋势项,t代表含趋势项和常数项,n代表不含趋势项也不含常数项。
H表示采用pp检验, series_name即为序列名。
DF检验相当于ADF检验中的不含趋势项的常数项的情况。
我们在此不再叙述。
2、协整检验。
在上面的例子中我们分析出城镇居民可支配收入为一阶单整序列,同时我们采用同样的分析方法,可知城镇居民的人均消费支出也为一阶单整。
由此,可以对序列进行协整估计。
用变量lgdp对变量lm2进行普通最小二乘回归,在主窗口命令行中输入:ls lconsume c lconsume(-1) lincome回车得到回归模型的估计结果,如图8.5所示。
图8.5此时系统会自动生成残差,我们令残差为ecm,命令如下:ecm=resid对残差项进行单位根检验,滞后期为1,结果如表8.2所示,从表中可以看出,残差序列为平稳序列,该协整关系成立。
表8.2ADF Test Statistic-2.8314481% CriticalValue*-2.67565% CriticalValue-1.957410% CriticalValue-1.62383、误差修正模型。
上面的分析可以证明序列lconsume、lincome及lconsme(-1)之间存在协整关系,故可以建立ecm(误差修正模型)。
先分别对序列lconsume、lincome及lconsme(-1)进行一阶差分,然后对误差修正模型进行估计。
在主窗口命令行中输入:ls d(lconsume) c d(lincome) d(lconsume(-1)) ecm(-1)此时的常数项系数不明显,我们去掉常数项后再进行回归,结果如下图8.6所示图8.6从上式可以看出上式中的T检验值均显著,误差修正项的系数为-0.252,这说明长期均衡对短期波动的影响不大。
下面我们短期会给出另一种估计方式。
我们可以直接进行估计,命令为:ls lconsume c lincome lconsume(-1) lconsume(-2) lincome(-1)结果如下图8.7所示:图8.7比较两种估计方法的结果,可知,第二种估计方法的拟合优度要好于第一种的拟合优度。
但第一种方法似乎比第二种方法更能说明经济问题,因为没有差分的模型表现的是长期的均衡关系,而差分后的方程则反映了短期波动的决定情况,其中的误差项反映了长期均衡对短期波动的影响。
注意,我们同样可以根据前面的(8.1)、(8.2)及(8.3)式,把第一种方法通过代数变换,转换成第二种形式,在此我们省略了变换过程。
eviews第三讲:误差修正模型

SC信息准则
SC值最小 SC信息准则,又称施瓦兹准则,即 Schwarz Criterion 其检验思想也是通过比较不同分布滞后模 型的拟合优度来确定合适的滞后期长度。 检验过程是:在模型中逐期添加滞后变量 ,直到SC值不再降低时为止,即选择使SC 值达到最小的滞后期k。
AIC最小原则是判定模型好坏标准之一, 犹如R2(R平方)一样。 AIC和SC(舒瓦茨 信息)常常一并作为判断模型拟合程度的 标准之一,特别是在滞后阶数的选择上。 比如,一个VAR(向量自回归模型),经 济理论往往无法确定滞后阶数,这时往往 采用AIC或者SC最小原则,即观察不同的 阶数的VAR模型,哪个模型的AIC或者SC 值最小就选用哪个模型进行分析。 AIC、 SC都会在模型参数中给出。
步骤2: 对方程进行回归 Yt 0 1 X t t 得出残差项 步骤3:对残差项进行单位根检验,
t t 1 i t 1 et
i 1 m
若原假设 0 成立,说明残差不平稳,即为 I(1);若残差项平稳(即为0阶单整),则两变 量之间存在协整关系(即长期稳定的某种关 系)。
确定序列具有单位根的阶数
ADF检验形式的选择
操作:数据(gini2,lnpergdp)
第一步:输入变量(略) 打开序列,点击Quick---Estimate Equation 对变量 gini gini(-1) c t进行自回归
目的:查看常数项和时间趋势项是否显著
第二步:上图结果显示常数项显著,因 此对原始数据单位根检验中同时加入常 数项
同理,相同的过程处理序列GDP 原始数据ADF检验
stata误差修正模型命令
Stata误差修正模型命令简介误差修正模型(Error Correction Model,ECM)是一种用于描述时间序列数据之间长期和短期关系的经济模型。
它是自回归移动平均模型(ARMA)和协整关系的结合,可以用于分析变量之间的长期均衡关系和短期调整速度。
Stata是一款功能强大的统计分析软件,提供了许多用于估计和分析误差修正模型的命令。
本文将介绍Stata中常用的误差修正模型命令及其使用方法。
命令介绍vecintrovecintro命令用于估计向量自回归(Vector Autoregression,VAR)模型,并进行协整检验。
在估计VAR之前,我们需要先检验变量之间是否存在协整关系。
vecintro命令可以帮助我们进行协整检验并选择适当的滞后阶数。
使用示例:vecintro y x1 x2, lags(1/4)其中,y表示因变量,x1和x2表示自变量。
lags(1/4)表示选择滞后阶数为1至4。
vecrankvecrank命令用于估计向量错误修正模型(Vector Error Correction Model,VECM)。
VECM是一种描述协整关系和短期调整速度的模型。
使用示例:vecrank y x1 x2, lags(1/4) rank(2)其中,y表示因变量,x1和x2表示自变量。
lags(1/4)表示选择滞后阶数为1至4,rank(2)表示选择协整关系的阶数为2。
vecvec命令用于估计向量错误修正模型,并进行残差诊断和模型拟合优度检验。
使用示例:vec y x1 x2, lags(1/4) rank(2)其中,y表示因变量,x1和x2表示自变量。
lags(1/4)表示选择滞后阶数为1至4,rank(2)表示选择协整关系的阶数为2。
常用参数lags在估计误差修正模型时,我们需要选择合适的滞后阶数。
Stata中的误差修正模型命令通常都提供了lags参数来指定滞后阶数范围。
使用示例:vec y x, lags(1/4)上述示例中的lags参数指定了滞后阶数范围为1至4。
误差修正模型ECM

Error Correction Model 用EVIEWS怎么做一、利用EG两步法做协整检验。
在两个变量情况下(设为Y、X),包括两序列单整检验、两变量最小二乘法回归并得到残差序列并命名为e、对e作单位根检验。
二、在证明Y、X两序列间存在协整后,才可以建立ECM。
其中,误差修正项ecm的值就是之前的回归模型的残差序列e。
三、直接输入以下命令:ls y c y(-1) x x(-1)得到的估计结果在实际预测时比较方便,不过需要计算得到ecm项的系数。
四、也可以直接输入以下命令:ls y c x e(-1)其中,e(-1)项的系数就是ecm项的系数。
这个模型的优点是直观,但是不便于预测。
五、两种估计是等价的。
六、建议参考阅读易丹辉:《数据分析与EViews应用》,中国统计出版社2002年版。
(也许有新版也不一定)对于误差修正模型,需要先建立一个模型,然后进行回归分析,分析它的短期均衡关系。
操作:举个例子说,比如试图建立y对y(-1)和x的误差修正模型。
STEP1 建立长期关系ls y c y(-1) xSTEP2 对残差进行单位根检验来检验协整关系ecm=residuroot(10,h) ecmSTEP3 建立误差修正模型ls d(y) c d(y(-1)) d(x) ecm(-1)教程:案例1上面的分析可以证明序列lconsume、lincome及lconsme(-1)之间存在协整关系,故可以建立ecm(误差修正模型)。
先分别对序列lconsume、lincome及lconsme(-1)进行一阶差分,然后对误差修正模型进行估计。
在主窗口命令行中输入:ls d(lconsume) c d(lincome) d(lconsume(-1)) ecm(-1)此时的常数项系数不明显,我们去掉常数项后再进行回归,结果如下图8.6所示图8.6从上式可以看出上式中的T检验值均显著,误差修正项的系数为-0.252,这说明长期均衡对短期波动的影响不大。
实验报告二——误差修正模型的建立与分析
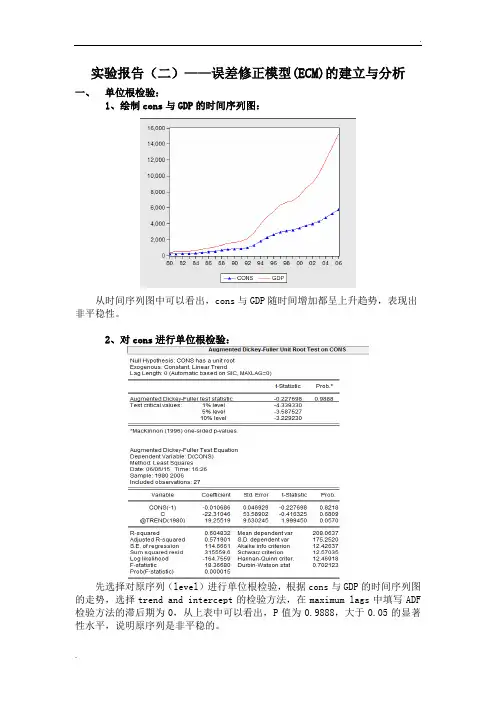
实验报告(二)——误差修正模型(ECM)的建立与分析一、单位根检验:1、绘制cons与GDP的时间序列图:从时间序列图中可以看出,cons与GDP随时间增加都呈上升趋势,表现出非平稳性。
2、对cons进行单位根检验:先选择对原序列(level)进行单位根检验,根据cons与GDP的时间序列图的走势,选择trend and intercept的检验方法,在maximum lags中填写ADF 检验方法的滞后期为0,从上表中可以看出,P值为0.9888,大于0.05的显著性水平,说明原序列是非平稳的。
选择cons的一阶差分(1st)和trend and intercept,从上表中可以看出,经过一阶差分后,P值(=0.5099)仍然没有通过0.05的置信水平检验,说明是不平稳的,需要继续改进。
再试用ADF检验,在滞后期(maximum lags)中填入8,选择一阶差分和trend and intercept,得出上表,可以看出P值=0.0801,大于0.05,没有通过0.05的置信水平检验,说明是不平稳的,需要继续改进。
再试用ADF检验,在滞后期(maximum lags)中填入6,选择二阶差分和trend and intercept,得出上表,可以看出P值=0.0137,小于0.05,通过0.05的置信水平检验,说明是平稳的。
3、对GDP进行单位根检验:先选择对原序列(level)进行单位根检验,根据cons与GDP的时间序列图的走势,选择trend and intercept的检验方法,在maximum lags中填写ADF 检验方法的滞后期为0,从上表中可以看出,P值为1.0000,大于0.05的显著性水平,说明原序列是非平稳的。
选择GDP的一阶差分(1st)和trend and intercept,从上表中可以看出,经过一阶差分后,P值(=0.5574)仍然没有通过0.05的置信水平检验,说明是不平稳的,需要继续改进。
第4讲 协整与误差修正模型
现在的问题是:何原因造成的残差序列自相关? 首先,模型没问题,因散点图呈线性关系。 其次,遗漏重要解释变量了吗?需要考虑政策变量吗? 再次,是滞后性吗?需要考虑前期收入对即期消费的影响吗? 有人做过研究:如用年度数据,发现前期收入比当期收入对消费的 影响都大。 最后,看时序图:
不难看出:x和y有明显共同趋势,需检验是否存在协整关系。 下面我们用EG两步法: 第一步:构建协整回归(见前) 第二步:对e做单位根检验 定义:genr e=y-yf,对e做单位根检验:
第4 讲
一、协整关系
协整与误差修正模型(ECM)
协整模型常用在经济学领域分析相关变量的长期均衡关系,也常 被用来分析金融中的套利等。自从20世纪90年代以来,国际著名杂志 发表了大量的相关文章。 协整分析是基于非平稳序列基础之上,而利用非平稳序列进行回 归,经常出现伪回归。而另一种情况却是更有应用价值的协整关系。
对二者取自然对数后进行单位根检验,发现在10%的水平下都不能拒 绝变量含有单位根。
如果暂时忽略非平稳性,直接设立以下回归方程,即 cont=c+βinct+et
回归后得:cont=−0.167+1.008inct
R2=0.998,且各系数也具有统计显著性。 试问:是不是伪回归呢?
为此,考察:et=cont − c − βinct
1 3 y x 是误差修正项,即(1) 可见(3)即为ECM模型,其中 (1 2 ) 中ecm 。
如果 xt 和 yt 间存在长期均衡关系,即 y ax ,则上述(3)式中 的ecm 正好可以改写成: 1 3
y
(1 2 )
x
可见,短期波动 yt 的影响因素有二:
第二步:做回归 (1)建立回归方程
误差修正模型课件

单方程误差修正模型是针对单个经济变量进行建模的方法,主要目的是检验和估计长期均衡关系及其短期调整机 制。
详细描述
单方程误差修正模型基于经济理论,通过一个经济变量对它的长期均衡关系及其短期调整机制进行建模。它通常 采用一阶差分法或协整法来处理非平稳时间序列数据,以识别和估计变量的长期均衡关系及其短期调整机制。
通常用长期均衡方程来描述。
在长期均衡方程中,变量的系数 映了其在长期均衡关系中的贡
献程度。
长期均衡关系通常是在市场机制 的作用下,通过供求关系自发调
节而形成的。
短期调整机制
短期调整机制是指当经济变量受到外 部冲击或其他因素的影响,导致其偏 离长期均衡状态时,系统会自动调整 以重新回到均衡状态的过程。
与
06
误差修正模型在经济学中的地位与作用
经济学的核心工具
误差修正模型(ECM)是现代经 济学中用于研究长期均衡关系和 短期调整机制的重要工具,尤其 在宏观和微观经济学中占据核心 地位。
揭示经济规律
通过ECM,研究者可以深入探究 经济变量之间的内在关系,揭示 其背后的经济规律和动态机制, 为政策制定提供科学依据。
外汇市场汇率调整的误差修正模型
总结词
该模型用于研究外汇市场汇率的调整机制, 通过分析汇率的短期波动和长期均衡趋势来 预测汇率变化。
详细描述
外汇市场汇率调整的误差修正模型关注汇率 的动态变化,并考虑国内外经济基本面的差 异对汇率的影响。它利用误差项来衡量短期 非均衡程度,并通过调整机制预测长期均衡 汇率的回归,有助于分析汇率的稳定性和波 动性。
短期调整机制通常是通过误差修正机 制来实现的,即系统会根据误差的大 小和方向,自动调整变量的取值,以 使其重新回到长期均衡状态。
实验八:协整关系检验与误差修正模型(ECM)new
实验八:协整关系检验与误差修正模型(ECM)new实验八:协整关系检验与误差修正模型(ECM)一、实验目的通过上机实验,使学生加深对时间序列之间协整关系的理解,能够运用Eviews 软件检验时间序列数据之间的协整关系并以此估计误差修正模型(ECM)。
二、预备知识(1)用EViews估计线性回归模型的基本操作;(2)时间序列数据的协整关系及其检验方法;(3)误差修正模型的结构及估计方法。
三、实验内容(1)用EViews检验两个时间序列数据的协整关系;(2)用EViews估计误差修正模型;四、实验步骤(一)、建立工作文件sy8.wf1及导入数据打开sy8.xls文件,运用前面学过的方法,在EViews新建一个工作文件sy8.wf1,把sy8.xls的数据导入到EViews,并根据得到人均消费(consp)和人均GDP(gdpp)两个序列,分别计算对应的自然对数,即lnc=log(consp)、lngdp=log(gdpp)。
(二)、分别检验序列lnc和lngdp的单整阶数。
运用图示法观察序列的时间路径图,如图8-1所示。
可见,lnc和lngdp都随时间不断上升,表明两者都是非平稳的。
(再运用自相关函数法,判断lnc 的平稳性。
打开lnc 序列的窗口,点击view\Correlogram ,设定滞后阶数为12,可得样本自相关系数图,操作和结果分别如图8-2和图8-3所示。
可见,lnc 是非平稳的。
再分析lnc 的一阶差分是否平稳。
在自相关函数图中,设定显示序列的一阶差分(1st differenc )后,再观察其样本自相关函数图,设定和结果如图8-4和图8-5所示。
可见,lnc 取一阶差分后就达到平稳,因此,lnc 是一阶单整序列,即I(1)序列。
如果采用单位根检验,结果相同。
同理,也可检验得到lngdp 序列是I(1)序列。
(三)运用Engle-Granger 方法(即EG 检验)检验consp 与gdpp 的协整关系。
r语言ecm模型
r语言ecm模型R语言ECM模型:时间序列分析中的必备工具引言时间序列分析是经济学、金融学、统计学等领域中常用的一种分析方法,通过对一系列按时间顺序排列的数据进行分析,揭示出数据中的趋势、周期性和随机性等重要特征。
在时间序列分析中,误差修正模型(Error Correction Model,ECM)是一种非常常用且有效的模型。
本文将介绍R 语言中的ECM模型,从安装R软件到具体应用,逐步介绍ECM模型的原理和使用方法。
一、安装R软件R语言是一种开源的统计计算和图形化编程语言,它提供了丰富的数据分析和统计建模功能,被广泛应用于学术研究和工业界。
R语言的优点在于它具有强大的社区支持和丰富的扩展包,可以满足不同领域、不同需求的数据分析任务。
要使用R语言进行ECM模型的分析,首先需要安装R软件。
在官网(二、载入数据在使用ECM模型前,首先需要准备好要分析的时间序列数据。
R语言提供了丰富的数据获取和导入方法,可以从本地文件、网络数据源等获取数据,并将数据导入到R的工作环境中进行分析和建模。
以一个简单的例子为例,假设我们想分析某公司每月销售额的变化。
我们已经准备好了一份名为“sales.csv”的数据文件,其中包含两列数据,分别是日期和销售额。
首先,我们需要将这个数据文件导入到R中进行分析。
使用如下代码将数据文件读取到R的工作环境中:Rsales <- read.csv("sales.csv")销售数据现在存储在一个名为“sales”的数据框中,我们可以使用该数据框进行后续的分析。
三、数据预处理在进行ECM模型的建模前,我们通常需要对原始数据进行预处理。
这包括数据清洗、缺失值处理、时序特性检验等步骤,以确保数据的准确性和可靠性。
1. 数据清洗在进行数据清洗时,我们需要检查数据是否存在异常值、重复值等问题,并进行相应的处理或修正。
R语言提供了强大的数据操作和处理函数,可以快速、高效地对数据进行清洗。
误差修正模型(Error Correction Model,ECM)
误差修正模型(Error Correction Model,ECM)第二节 误差修正模型(Error Correction Model ,ECM )一、误差修正模型的构造对于y t 的(1,1)阶自回归分布滞后模型:t t t t t y x x y εβββα++++=--12110在模型两端同时减y t-1,在模型右端10-±t x β,得:tt t t t t t t tt t t t x y x x y x y x x y εααγβεββββαββεββββα+--+∆=+---+--+∆=+-+++∆+=∆------)(])1()1()[1()1()(1101012120120121100其中,12-=βγ,)1/()(200ββαα-+=,)1/(211ββα-=。
记 11011-----=t t t x y ecm αα (5-5) 则 t t t t ecm x y εγβ++∆=∆-10 (5-6) 称模型(5-6)为“误差修正模型”,简称ECM 。
二、误差修正模型的含义如果y t ~ I(1),x t ~ I(1),则模型(5-6)左端)0(~I y t ∆,右端)0(~I x t ∆,所以只有当y t 和x t 协整、即y t 和x t 之间存在长期均衡关系时,式(5-5)中的ecm~I(0),模型(5-6)两端的平稳性才会相同。
当y t 和x t 协整时,设协整回归方程为:t t t x y εαα++=10它反映了y t 与x t 的长期均衡关系,所以称式(5-5)中的ecm t -1是前一期的“非均衡误差”,称误差修正模型(5-6)中的1-t ecm γ是误差修正项,12-=βγ是修正系数,由于通常1||2<β,这样0<γ;当ecm t -1 >0时(即出现正误差),误差修正项1-t ecm γ< 0,而ecm t -1 < 0时(即出现负误差),1-t ecm γ> 0,两者的方向恰好相反,所以,误差修正是一个反向调整过程(负反馈机制)。
误差修正模型
第二节 误差修正模型(Error Correction Model ,ECM ) 一、误差修正模型的构造 对于y t 的(1,1)阶自回归分布滞后模型:t t t t t y x x y εβββα++++=--12110在模型两端同时减y t-1,在模型右端10-±t x β,得:tt t t t t t t tt t t t x y x x y x y x x y εααγβεββββαββεββββα+--+∆=+---+--+∆=+-+++∆+=∆------)(])1()1()[1()1()(1101012120120121100其中,12-=βγ,)1/()(200ββαα-+=,)1/(211ββα-=。
记 11011-----=t t t x y ecm αα (5-5)则 t t t t ecm x y εγβ++∆=∆-10 (5-6) 称模型(5-6)为“误差修正模型”,简称ECM 。
二、误差修正模型的含义如果y t ~ I(1),x t ~ I(1),则模型(5-6)左端)0(~I y t ∆,右端)0(~I x t ∆,所以只有当y t 和x t 协整、即y t 和x t 之间存在长期均衡关系时,式(5-5)中的ecm~I(0),模型(5-6)两端的平稳性才会相同。
当y t 和x t 协整时,设协整回归方程为:t t t x y εαα++=10它反映了y t 与x t 的长期均衡关系,所以称式(5-5)中的ecm t -1是前一期的“非均衡误差”,称误差修正模型(5-6)中的1-t ecm γ是误差修正项,12-=βγ是修正系数,由于通常1||2<β,这样0<γ;当ecm t -1 >0时(即出现正误差),误差修正项1-t ecm γ< 0,而ecm t -1 < 0时(即出现负误差),1-t ecm γ> 0,两者的方向恰好相反,所以,误差修正是一个反向调整过程(负反馈机制)。