
碎纸片的拼接复原的数学模型
碎纸片的拼接复原摘要本文主要采用了模糊模型识别、灰度相关、傅里叶变换等方法对碎纸自动拼接进行了深入探讨。
文中主要结合司法物证复原、历史文献修复、军事情报获取这一背景,针对横纵切碎自动拼接展开探究。
提出一种基于最大梯度和灰度相关的全景图拼接法。
同时采用边界提取法使图像预处理达到最好的效果,期间采用傅里叶变换对图像进行处理,最后再利用匹配准则等方法处理图像的拼接。
最终应用模糊模型识别法建立模型,通过隶属函数的建立实现最终的碎纸拼接。
期间有些碎纸片计算机无法识别,需要进行人工干预,从而才能得到一副完整的复原图。
图像拼接的主要工作流程可以概括为以下三个步骤:(1) 对图像碎片进行预处理,即对物体碎片数字化,得到碎片的数字图像。
(2) 图像碎片匹配,通过匹配算法找到相互匹配的图像碎片。
(3) 图像碎片的拼接合并,将相互匹配的图像碎片拼接在一起得到最终结果。
!针对问题一:将图像导入MATLAB 进行相应的转化,由于数据量较大,所以对数据进行优化提取。
计算提取数据的均值与方差,找出其模糊集,建立符合题意的隶属函数。
由于模糊集的边界是模糊的,如果要把模糊概念转化为数学语言,需要选取不同的置信水平(01)λλ≤≤ 来确定其隶属关系,从而实现纵切图像的全景拼接。
(如表一、表二)针对于问题二:由于是横纵切碎纸片,所得图像较多,采用提取像素法对图片进行灰度分析,通过中介量阈值的确定来找出像素点的差别,梯度值在这一过程中也是作为衡量两张碎纸片是否匹配的标准。
从而对数据进行处理,最后导入MATLAB 软件实现拼接。
(如表三、表四)针对问题三:它是在问题一和问题二上加深了难度,采用提取像素点,傅里叶变换,灰度相关、模糊相似优先比等方法对问题进行分析,通过(0,1)矩阵的简化运算以及傅里叶变换得到最后的结果,但对于傅里叶变换需说明一点,变换之后的图像在原点平移之前四角是低频,最亮,平移之后中间是低频最亮,也就是说幅角比较大。
此过程中同时也需要人工干预,最终实现拼接。
(如表五、表六)关键词:模糊模型识别灰度相关傅里叶变换梯度值自动拼接一、问题重述1.1问题的背景\社会的飞速发展离不开秘要文件的建立,“斯塔西”情报机构官员将大量绝密文件撕成六亿多张碎纸片丢进1600个垃圾袋中,到了当代,历史学家觉得很有恢复的必要,但如果人工拼接将是一个巨大的工程,将要耗费四百年时间。
所以这将推动了计算机自动拼接技术的发展。
在司法界中,物证额提取也是一项较为重要的环节,所以拼接技术得到了空前的发展。
德国等发达国家对破碎文件的修复技术已经进行了相当长时间的研究,但由于技术封锁的原因我们得到的资料是有限的。
在国内,碎片拼接技术还不是相当的成熟,因此,结合碎纸拼接技术的重要性这一背景,把计算机视觉和模式识别应用于碎纸复原,所以,对碎片自动拼接技术的探究是十分有必要的,发展到今天,随着拼接技术的提高,应用的领域也越来越广,同时对技术的研究也具有重要的现实意义。
1.2问题的提出随着计算机的发展,数字图像处理也随之产生。
碎纸拼接技术是图像处理与模式识别领域中的一个很典型的应用。
在司法物证还原,历史文献修复以及军事情报获取等领域具有重大的贡献。
传统上,拼接复原工作一般由人工完成,虽然具有较高的准确率,但是效率太低。
特别当碎纸片数量较大时,人工拼接很难完成此任务。
随着计算机技术的发展,人们试图开发碎纸自动拼接技术,高效的完成高难度任务。
下面考虑三个问题:(1)对于给定的仅纵切的中英文各一页文件的碎纸片数据进行拼接复原,期间如果涉及到人工干预需写出干预的时间节点,复原结果以图片形式及表格形式表达。
(2)对于给定既横切又纵切的中英文各一页文件的碎纸片数据进行拼接复原,如需进行人工干预同上。
表达结果要求同上。
\(3)以上两问均为单面打印,但在现实生活中,大多数情况下是双面打印,此问给出的是一页英文印刷文字双面打印文件的碎纸片数据,表达结果要求同上。
二、 模型的基本假设(1)假设给出的文件文字清晰,不存在损坏缺失; (2)假设在裁剪过程中碎纸片不存在磨损; (3) 假设裁剪出的碎纸片形状、大小相同; (4) 假设纸张是方形的;(5)假设横切面和纵切面与边缘分别平行;《三、 符号说明a :矩阵的均值;2σ :矩阵的方差;i x :任意碎片中提取的样本;j x :提取样本后在剩余样本抽取的碎片; (1)(,)f x y :待拼接的左图像;'(1)(,)f x y ∇:左图像的梯度图像; (2)(,)f x y :待拼接的右图像; (2)(,)f x y ∇:右图像的梯度图像; ()(,)T f x y :拼接模板; ()(,)T f x y ∇:模板的梯度图像; (3)(,)f x y :右图像中某一子图像;(3)(,)f x y ∇:右图像中某一子图像的梯度图像;g(s,t):表示滤波前的图像;,(,)f x y :表示滤波后的图像;xy S :表示像素(,)x y 的某个领域;(,)GD T R :表示梯度图像()(,)T f x y ∇ 和(2)(,)f x y ∇ 相应位置的梯度差异四、问题分析这是一个利用计算机技术将碎纸片拼接的问题,一种典型的解决平面图像碎片的方法:匹配算法。
它是定义一个判别式,把不符合判别式的一对对候选匹配通过多尺度方法逐步从原可能匹配的集合中删除,最后剩下的少量匹配对可能就是真正匹配的图像碎片对。
对于问题一,将碎纸片导入MATLAB 转化为矩阵,这时生成十九个1980×72的矩阵,由于数据繁多,运算量过大,通过计算方差对数据进行优化处理,选取具有代表性的部分进行分析处理,从而完成纵切的图片拼接。
(如表一,表二)对于问题二,由于横纵切图片,所以形成的碎纸片数量较大,如果在采用问题一的做法显然是不明智的,所以,我们采用灰度相关进行匹配,具体做法是:在一幅图中选取一块子图像作为模板,根据某个相似度评价函数对第二幅图像中的像素灰度值进行比较,找出两幅图像的匹配点。
同时采用傅里叶变换辅助灰度相关匹配进行拼接。
如果灰度相关方法上遇到数据量处理较大的问题,采用变换多分辨率模板将灰度相关变换到不同分辨率上进行,从而精简计算过程。
针对问题三,则是在问题一、问题二上增加了难度,必须满足双面拼接,所以我们在这一问运用弹性匹配,灰度相关,提取像素点,傅里叶变换等方法对图片进行拼接。
具体操作流程如下图:;[最后采用模糊模型识别法建立整体模型,最终实现五张碎纸文件的成功拼接。
五、模型的建立与求解问题一模型的建立与求解/我们认为,可以采用模糊识别模式。
首先针对第一问我们采取将图片导入MATLAB软件,生成19个1980×72的矩阵,由于较大数据量所以我们提取优化的一部分数据进行分析,提取结果如下:255255255255255&255255255255255255255255}255255255255255255255255《120128142139214255255255|25525549005208255…255255255255790089:2552552552552552551040]121255255255255255255—00122255255255255,109255 25511300122255255`25525525525511700122}2552552552552552551210、122255255255255255243【12300120242232206218】2550000000、12625500000、0012625546130《20383310126255255:2800122255255255248(255222000122255255<255255255160000122`2552552552552559900)12225525525525525529…00012223195189255<2550000113190)4525225502600122*107001502550960:122230902224336;1280012225510200—12810512800122255188~091183********(255252661872552511280、122255255255255255255~12800122255255255255!25525512800122255255)255255234 25512800122·255255255251255255 128 0 ~122 255 255 255 255 255 255 #128122255255255255~255由上表数据分析得:()221()1,2,,nii a a i n nσ=-==⋅⋅⋅∑,综上可以算出优化后提取的矩阵的均值和方差,代入相关数据,经计算可得:=215.8462a , 2=11.2915σ](1)若已知n 个类型在被识别的全体对象U 上的隶属函数,则可按隶属原则进行归类。
此处介绍的是针对正态模型模糊的情形。
对于正态型模糊变量x ,其隶属度为2()()x a bA x e--=其中,a 为均值,222b σ=,2σ为相应方差。
按泰勒级数展开,取近似值得若有n 种类型m 个指标的情形,则第i 种类型在第j 种指标上的隶属函数是21,()0,x a x a b A x b x a b ⎧-⎛⎫--<⎪ ⎪=⎨⎝⎭⎪-<⎩1,(1,2,,)nii aa i n n===⋅⋅⋅∑(1)2(1)(1)(1)(1)(2)2(2)(2)(2)(2)0,1,1,1,0,ij ij ijij ij ij ij ij ij ijij ij ij ij ij ij ij x a b x a a b x a b A a x a x a a x a b b a b x ⎧≤-⎪⎛⎫⎪---<< ⎪⎪ ⎪⎪⎝⎭⎪=≤≤⎨⎪⎛⎫-⎪-<<+ ⎪⎪ ⎪⎝⎭⎪⎪+<⎩~其中,(1)ij a 和(2)ij a 分别是第i 类元素第j 种指标的最小值和最大值,222ij ijb σ=,而2ij σ 是第i 类元素第j 种指标的方差。
(1)若有n 种类型12(,,,)n A A A ⋅⋅⋅,每类都有m 个指标,且均为正态型模糊变量,相应的参数分别为(1)ij a ,(2)ij a ,ij b (i =1,2,⋅⋅⋅,n ;j =1,2,⋅⋅⋅,n )。
其中,{}(1)min ij ij a x =,{}(2)max ij ij a x =,222ijij b σ=,而2ij σ是ij x 的方差。
待判别对象的B 的m 个指标分别具有参数j a ,(1,2,,)j b j m =⋅⋅⋅,且为正态型模糊变量,则B 与各个类型的贴近度为(1)2(1)(1)(1)(1)(2),2(2)(2)(2)(2)0,()11,()2()1,11,()20,()j ij j ij j ijij j ij j ij j ij ij ij j ijj ij ij j ij j ij j ij ij j ij j a a b b a a a b b a a b b A B a a a a a a a a b b b b a b b a ⎧≤--⎪⎛⎫⎪----<< ⎪⎪ ⎪-⎪⎝⎭⎪=≤≤⎨⎪⎛⎫-⎪-<<++ ⎪⎪ ⎪-⎝⎭⎪⎪++≤⎩记{},1min i ij j mS A B ≤≤=,又有{}01min i i j nS S ≤≤=,按贴近原则可认为B 与0i A 最贴近。
基于图像处理的碎纸片拼接数学模型分析

基于图像处理的碎纸片拼接数学模型分析【摘要】本文基于图像处理技术,通过建立数学模型分析碎纸片拼接的过程。
首先介绍研究背景和研究意义,接着详细阐述数学模型的建立和图像处理方法的应用。
通过实验结果分析和误差分析,发现现有模型存在一定的问题,并提出模型优化方法。
总结研究成果,展望未来可能的研究方向。
通过本文的研究,可以更加深入地理解碎纸片拼接的数学模型,为相关领域的研究提供参考和帮助。
【关键词】碎纸片、图像处理、数学模型、拼接、实验结果、误差分析、模型优化、研究背景、研究意义、研究成果、未来展望。
1. 引言1.1 研究背景碎纸片拼接是一种常见的问题,它在实际生活和工程应用中具有重要意义。
碎纸片拼接可以用于恢复损坏的文件或图像,也可以用于数字化文物等领域。
在实际操作中,由于碎片形状、大小、颜色等的多样性,导致碎纸片拼接过程复杂且耗时。
基于图像处理的碎纸片拼接方法能够有效地解决这一问题,通过利用计算机视觉技术对碎纸片进行识别、匹配和拼接,实现自动化碎纸片拼接的目的。
目前,针对碎纸片拼接问题的研究已经取得了一定的进展,但仍然存在一些挑战和问题。
碎纸片的形状复杂多样,容易出现匹配错误或漏配现象;碎纸片之间可能存在重叠或遮挡情况,导致图像处理的难度增加。
有必要建立一个有效的数学模型,结合图像处理方法来对碎纸片拼接进行深入研究和分析。
本研究旨在探讨基于图像处理的碎纸片拼接数学模型,提出相应的算法和优化方法,为解决碎纸片拼接问题提供新的思路和方法。
1.2 研究意义碎纸片拼接是一个常见的问题,它涉及到图像处理、数学建模等多个领域。
通过对碎纸片进行拼接,可以恢复原始图像,这在很多场景下都具有重要的应用意义。
对于破损的文件进行修复、对于涂抹的照片进行修复等。
碎纸片拼接数学模型的建立和图像处理方法的应用,可以帮助我们更好地理解碎纸片拼接问题的本质,并且为实际问题的解决提供重要的理论支持。
通过对实验结果进行分析和误差分析,可以不断优化模型,并且为碎纸片拼接问题的应用提供更加精确和稳定的解决方案。
碎纸片拼接复原的数学模型_杨武
121数学学习与研究2014.11碎纸片拼接复原的数学模型◎杨武李博(江苏南京农业大学工学院210000)【摘要】本文对碎片的拼接复原问题,建立了碎纸片拼接模型,编写matlab 程序,利用人机交互指令实现碎片的快速拼接.对2013年“高教社杯”全国大学生数学建模竞赛的B 题中所给11x 19个碎片文件进行拼接.【关键词】碎片拼接模型;matlab ;灰度值矩阵;Kmeans 聚类;人机交互一、研究背景及意义近年来,大量政府机关、企事业单位采用碎纸机对废弃文件或失效的机密文件进行破碎,这种破碎方法产生的碎片多为规则的.这使得在进行破碎文件的复原拼接时,只能根据文字内容进行匹配,为此,本文考虑应用当前的计算机识别技术开发碎纸片的自动拼接技术,对所有碎片搜索和筛选,寻找能够在某种指标上匹配的碎片进行拼接.提高拼接复原效率,从而大大降低人工工作量和难度.对碎片自动拼接问题的研究,不仅具有广阔的应用前景,而且具有很强的理论意义.二、图像碎片预处理首先,利用matlab 图像处理功能对碎纸片进行图像预处理.即将碎纸片数字化,转化为图片文件的数据.即一个二维数组构成的灰度值矩阵,这个矩阵存储着一张碎纸片各个像素点的颜色值,其中255表示白色,0表示黑色,图片中颜色均处在黑白、或黑白之间,图片数字化后的数字范围在0 255之间.三、碎纸片拼接模型的假设1.假设碎片原文件都存在上、下、左、右的页边距,且边距大于行间距和列间距;2.假设相邻碎片间纸张信息的损失可以忽略不计;3.假设碎纸机是沿平行或垂直于文字的方向对纸张进行切割的.四、碎纸拼接模型的建立1.挑出每行最左边的图片:根据图片的边缘留有空白部分的特性,挑选出图片最左边存在空白部分的图片作为左边界的候选图片.方法实现:计算图片左边距留白宽度:即可用灰度值矩阵中左端竖列上全为255(即左侧完全空白)的连续列数度量,由matlab 检测出每张图片的留白宽度.留白宽度排序:对上面得到的留白宽度进行排列,取排在前面的11张图片作为拼接过程的起始碎片.2.图片按行分类:根据Kmeans 聚类算法,对碎片进行按行分类.分类实现:①先根据底端一行是否为纯空白将209幅图分为下端有纯空白行和下端有被截文字两类.②对于空白行一类,下端空白行数相同或相近的纸条属于原文件同一行;③对于下端有被截文字的一类,下端被截文字高度相同或相近的纸条属于原文件同一行.④分析确定好的最左端图片的特征,依此为11个聚类中心,利用matlab 程序分类.3.对同行碎片进行拼接①拼配原则———突变数将所有的碎片进行处理后得到灰度值矩阵,分别记作M i (i =1,…,n )(n 为图片的数量)通过对每一张碎片的数据进行了分析,不难发现在每一张碎片上,同一行相邻两个点的像素值从0变为255或者从255变到0的比例仅有0.016%左右.将相邻两个像素值由0变到255或者由255变到0定义为一次突变.定义两张碎片的突变数如下:设Ri 为某张碎片M i 的最右侧一列像素值,L j 为另一张碎片M j 的最左侧一列像素值(Ri 和L j 均为180行的列向量),碎片M i 和M j 的突变数:T ij =∑180k =1flag (k )ij ,flag (k )ij =1R(k )i -L (k )j =2550R(k )i -L (k )j <{255,其中R(k )i 表示向量Ri 的第k 个分量,L (k )j 表示向量L j 的第k 个分量.②匹配过程以上面确定的最左边的碎片为起点,计算该碎片所在行的可能的碎片与其的突变数T.理论上T 值越小,两个图片的匹配的可能性最大,将T 进行由小到大的排序,在matlab 程序中让起始碎片优先与T 值最小的匹配,若匹配不成功再依次考虑T 值较大的,直至匹配成功.4.人工干预①人工干预时机:本文对209个已有碎片,分析发现若其余碎片与其的突变数仅有一个为0,则突变数为零的那个碎片一定与该碎片相匹配,一旦出现突变数均不为0,则需进行人工干预.②人工干预方法:为减少人工干预次数,做如下工作:1)计算碎片M i 灰度值矩阵最右一列Ri 与位于M i 行的其余碎片灰度值矩阵最左一列L j 的偏差平方和S 作为人工干预的指标:S =∑180i =1(Ri-L i )2.2)对偏差平方和S 由大到小进行排序,将碎片的序号放入集合US 中,S 大的最有可能与碎片M i 相匹配③在matlab 程序中让碎片M i 依次与集合US 中的图片进行匹配,每次对两个图进行匹配时,令命令窗口弹出这两个图匹配在一起的图片,进行人工观察.通过对拼接处文字字形和语义的分析,人工检查该匹配是否合理.5.纵向拼接①观察11条已拼好的横切纸条,根据所有纸条的上边缘特征确定位于原文件顶端的横切纸条,并以该纸条为起始纸条.②根据起始纸条的下边缘灰度值特征,利用上述步奏拼出整张文件.五、模型的评价与改进1.模型的优点:模型采用突变数和偏差平方和作为评价函数评定碎片间邻边的相关度,高效而且实用.能大大减少人工干预的次数.2.模型的局限性:由于研究的是碎纸机产生的碎片.该模型只考虑了对多个相同的形状规则的碎片进行拼接,且当碎片的数量增加且单个碎片的文字覆盖率越小时,更易产生灰度分布情况相似的碎片,需要进行人工干预的次数会相应增多.六、结论本文对碎纸片的匹配原则和人工干预进行了探讨和研究,建立了一个可靠高效的数学模型,利用图片数字化后数值之间的分布规律和相关度引入突变值和偏差平方和作为评价指标,利用matlab 软件实现快速拼接.并为了提高拼接准确性,巧妙地使用人机交互指令进行人工的检测干预.【参考文献】[1]何鹏飞,等.基于蚁群优化算法的碎纸拼接.计算机工程与科学,2011,33(7).[2]邓薇.MATLAB 函数速查手册.北京:人民邮电出版社,2010.[3]宋晓闯.基于灰度和几何特征的图像匹配算法研究.万方数据库,2013-09-13.。
基于matlab的碎纸片拼接问题的数学模型

片进行上下顺序 的匹配排序即可完成 文件 的复原 。
左 列 向量 计 算相 关 度 ,记 下相 关 度 最 大 的一 组 ,认 为其 最 匹 配 。
1碎 片边缘 匹配
这样每 一个碎片都找到 了其右侧相邻的碎 片,将其依次连接
利用 matlab,可 以提取 出一幅 图片的灰度矩 阵,我们只需 起 来 即 可 。
摘 要 :对于碎纸 片的拼接复原 问题 给出一个简单实用的数学模型 ,借助于matlab软件 ,利用图像 的灰度矩阵对
图像边 缘进行分析 ,从而对碎纸 片的边缘进行 匹配。该模 型对 于碎纸机产生的边 缘规 则的矩形碎片 的拼接复原
问题给 出比较 完善 的解决方案。
关键 词g拼接复原 matlab 数学模型 灰度 矩阵
中图分类号 :TP391.41
文献标识码 :A
文章编号 :1007.3973(2013)012.232.02
破 碎文件 的拼接 技术 在诸多领 域都 占有十 分重要 的地
其中,n=19,Au为 180x72矩阵(i,j=l,2,…,n)。
位,特别是在司法物 证复原、文献修复以及 军事情报获取等各
—
—
斟m论坛 ·2013年第 l2期(下 )——
出现错误 。如图 1所示 切 口。
(n)
图 1 切 口处为 空白
【bJ
图 4 横行碎 片排序
(2)两碎 片相邻边缘相似度极 高,但实 际并不相邻 。两个
同理 ,若切 口处为文字部分,只需找到另一个切 口处为文
碎片 的相邻边缘几 乎完全相 同,但实际并不是正确 的匹配。如 字 的横行碎片 ,使两横行切 口处的文字部分高度之和恰好为
碎纸片拼接复原的数学方法

碎纸片拼接复原的数学方法拼图游戏,一种看似简单却富含深度的游戏,给人们带来了无穷的乐趣。
然而,大家是否想过,这样的游戏其实与数学有着密切的?让我们一起探索碎纸片拼接复原背后的数学方法。
碎纸片拼接复原,其实就是一个计算几何问题。
在数学领域,欧几里得几何和非欧几里得几何是两个基本而又重要的分支。
欧几里得几何主要研究的是在平面上两点之间的最短距离,这是我们日常生活中常见的几何学。
而非欧几里得几何则研究的是曲面上的几何学,这种几何学并不符合我们日常生活中的直觉。
碎纸片拼接复原的问题就是一种非欧几里得几何问题。
在计算机科学中,图论是研究图形和网络的基本理论。
其中,图形遍历算法可以用来解决碎纸片拼接复原问题。
这种算法的基本思想是:从一点出发,尽可能多地遍历整个图形,并在遍历的过程中对图形进行重建。
对于碎纸片拼接复原问题,我们可以将每一张碎纸片看作是图中的一个节点,当两张碎纸片拼接在一起时,它们就形成了一个边。
通过这种方式,我们可以将所有的碎纸片连接起来,形成一个完整的图形。
在计算机科学中,碎纸片拼接复原问题被广泛应用于图像处理、数据恢复等领域。
例如,在数字图像处理中,如果一张图片被切割成若干块,我们可以通过类似的方法来恢复原始的图片。
在数据恢复领域,当一个文件被删除或格式化时,我们也可以通过类似的方法来恢复文件。
碎纸片拼接复原的问题不仅是一个有趣的拼图游戏,更是一个涉及计算几何、图论等多个领域的数学问题。
通过运用这些数学方法,我们可以有效地解决这个问题,从而更好地理解和应用这些数学理论。
在我们的日常生活中,我们经常会遇到一些破碎的物品,例如碎镜子、破碎的瓷器,或是碎纸片等。
这些物品的复原过程都需要一种科学的方法来帮助他们重新拼接起来。
这种科学方法就是碎纸片拼接复原技术。
碎纸片拼接复原技术是一种基于数学模型的方法,它通过比较碎纸片边缘的形状、纹理、颜色等特征,来找到碎纸片之间的相似性和关联性,从而将它们拼接起来。
碎纸片自动拼接复原模型的实现
式) a =( a , 1 , …, 口 : ) 与a , =( 日 , 以 1一 , ), 我们定义相似度:
通过对图 中碎片的观察与分析 , 我们发现这些碎片具有共同的
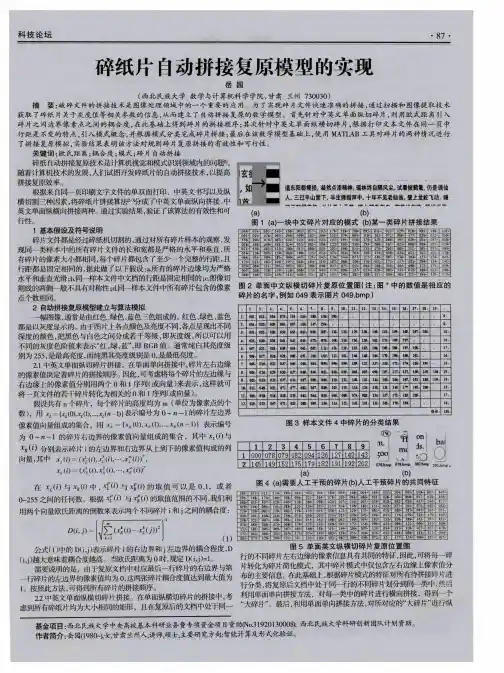
特征。 如图 4 6 ) 中碎片上被标记的部分所示。 l 8 O ∑n 0 n 由图 4 6 ) 可以看出, 这些图片都是有一行 缺少英文字符 , 使得碎片 ( , Z ) 这些特殊的5 ' , -  ̄ l t 图片都是可以人工干预处理的。 ( 2 ) 对应的模式比较异常。 在 此基 础上 考虑 碎 片拼接 过程 , 先 对分 类 的碎 片左 右 拼接 , 匹配 仅 其中 为临界值。若 , x o 则我们认为 与 同属一类, 对于 在所在行匹配合成 。 上下匹配还要考虑行内其他元素的上下匹配。 合成 那些存在特殊情况的碎片 , 我们在分好类的基础上 , 再进行人工干预处 时整行都要合成。 综合考虑以上因素 , 我们对所有可以拼接的数据进行 理。c 同 类碎片拼接。 按照单面纵向拼接方法对每—类中的所有碎片进 拼接整 合 。( 图5 ) 行拼接 ,则可得到 同一类中碎片的拼接方案 ,进而得到横 向的 “ 大碎 在这里,处理特殊碎片需遵循 的原则 :以第二次拼接 的图片为底 片” 。c L 不同类“ 大碎片” 的拼接。“ 大碎片” 为横向的, 但此 问题- 仍 属于单 图, 剩下的 1 8 块依次和底图匹配 , 匹配原则包含经此处理之后便于观 面单向的拼接问题 , 因此可采用计算灰度值耦合度的方法进行拼接。 察整体拼接隋况, 但是拼接后在合成部分已做断开划线处理 , 这样便于 2 . 2 . 2英文单面纵横切碎片拼接。 考虑到英文的特殊 陛, 根据英文的 将剩下 的碎片进行拼接分析。 经过此次拼接过程 , 可以观察已组合部分 书写版式原则 , 可以将整篇文章放在带有英文四线格的底面中。 既然可 是否匹配正确 , 若不匹配 的话 , 可 以暂时先将那块碎片剔除, 放到第 三 以放在 四线格中, 这里我们把一行四线格看成一行, 可以确定每相邻行 部分再进行匹配组合。 碎片四边都要依次匹配 , 匹配度最高的就是缺少 的行间距是一定的。行宽也是一定的, 考虑字母仅占有上中、 中、 中下 、 块部分。按 以上方法对样本文件 4中的碎片进行拼接 ,结果见图 5所 上中下等几种情况 , 可 以确定每一个字母都是在中间有书写笔画的, 四 不 。 线格中上下行都具有英文笔画的是少数。 结束 语 基于这种考虑, 可以对每一行四线格的中间内容进行求和, 当其和 通过 研究 规 则切割 碎 纸片 的拼 接复原 问题 ,我们 针 对单 面 中英 文 的值小于某一值的时候我们忽略四线格上面和下面的内容 ,进而只考 纵向切割碎片以及单面中英文纵横双向切割碎片提 出了不同的拼接复 虑 四线 格 的中 间部 分 。 对 于那些 特殊 的碎 片 , 我们 可采用 人 工干预 的方 原模型以及方法。该方法将一张张碎片文件转换成 了一个个像素点值 式将其挑出, 所以将英文中四线格的上半部分和下半部分的内容忽略 , 矩阵, 对于计算机来说 , 碎片文件 的处理就变成了矩阵集合 的操作 ; 另 可以采取中文碎片模式转换的类似方法, 从而到英文碎片的模式。 外引入欧式距离将图像的拼接转化为耦合度的计算 ;接着考虑到印刷 3 实验 结果 及分析 文本文件的排版特点 , 引入模式识别的概念 , 可 以将大量杂乱碎片进行 实验是在 Mi c r o s o f t Wi n d o w s 7系统上进行 ,内存限定是 2 G B , 算 分类 , 然后逐类拼接 , 最终将双向拼接问题转化为单 向拼接问题 ; 最后 法实现语言为 M A T L A B 7 . 0版本。根据不同的样本文件使用相应的拼 所建立的模型效率好 , 精度高, 从实验结果上可以看 出该模型的可行性 接算 法 , 从 而得到 下面 的模拟 结果 。 和有 效 胜。 3 . 1 中英文单面纵切拼接实验。 样本文件 1 和2 分别为中英文单面 致谢 纵切碎片数据 ,其中每页纸被切为 1 9 条碎片 ,分别用 O 0 0 . b mp 一 0 1 8 . 感谢对此项研究工作提供基金资助的西北民族大学 中央高校基本 b mp 编号命名。利用 MA T L A B工具中的 自 带 函数 i m2 b w和 i m r e a d , 将 科研业务费专项资金 N o . 3 1 9 2 0 1 3 0 0 0 8 ) t ) 2 及西北民族大学科研创新 团 图像转化为仅包含 0和 1 的向量 ,接着根据中英文单面纵切算法可以 队计划 , 同时感谢参与本论文讨论的赵习猛 、 任宗秀和王本涛。 得到碎片的耦合度矩阵 , 由此可得样本文件 1 , 即中文单面纵切碎片的 参考 文献 拼接 复 利l 赙 为:
基于斑马线算法的碎纸片的拼接复原模型_(杜函敏)

碎纸片的拼接复原是图片拼接技术的一种。碎纸拼接,就是利用计算机将碎片恢复。主要应用于 历史文物的修复工作和司法鉴定。拼接碎片不用手工完成的原因是:如果碎片的数量过大,手工拼接 会费时费力。本文第一问只考虑列向量对匹配结果的影响;第二问既要考虑列向量,又要考虑行向 量对匹配结果的影响;第三问针对第二问又增加了正反面对匹配结果的影响。针对此特点,我们对 问题一提出来边沿差分极值算法;对第二问,在第一问的基础上,加以人工干扰,提出了斑马线算 法和顶端、底端颜色长度结合的算法。对第三问,结合第二问提出了适合英文拼接的改进斑马线算 法。 对于问题一,在只考虑列向量时,我们建立单列匹配模型模型,对模型进行了合理的理论证明 和推导,然后借助于边沿差分极值算法和 MATLAB 软件,对附件中的所有数据进行匹配,通过数据 模拟,结果显示,模型符合要求。程序结果见附录 1,2。 对于问题二,在考虑行,列向量对模型的影响的基础上,我们提出了行列匹配模型。该模型是 建立在问题一的算法基础上,使用斑马线算法将所有图片处理成只有黑行和白行的数据,且左边沿 和右边沿特征列向量相等。使用边沿特征列向量对碎片进行相互比对,得到了上黑下黑、上白下黑、 上黑下白、上白下白四个类别,再在每个类别内部根据黑白颜色的长度分类得到 13 个小类剩余 5 个 碎片。对每一类碎片使用计算机结合人工干预进行拼接,通过数据模拟,结果显示,模型符合要求。 结果见附录 3,4。 对于问题三,我们在问题二的基础上,对斑马线算法进行了修改, 结合问题二中分类方法根据 黑白颜色的长度分类得到 24 个小类剩余 10 个碎片,对每一类碎片使用计算机结合人工干预进行拼 接,通过数据模拟,结果显示,模型符合要求。结果见附录 5。 由于图片边沿灰度值噪点较多,容易影响匹配结果。因此,我们考虑对样本图片在输入之前进 行预处理,即采用去噪声和边沿锐化的技术对样本图片进行预处理,这样可以提高匹配质量,减少 人工干预。 关键词:碎片拼接 人工干预 特征提取 边沿差分极值算法 斑马线算法
碎纸片的拼接还原研究
碎纸片的拼接复原摘要碎纸片的拼接复原是一门借助计算机,把大量碎纸片重新拼接成初始纸张的技术。
针对问题一,本文首先利用碎纸片图像灰度矩阵的边缘矩阵,建立了两个碎纸片之间的匹配度函数,求得了每一张图片之间左右边缘匹配度矩阵。
然后根据左边边缘位置的碎片的左边空白部分最多的特点,确定了左边位置的碎纸片。
接着根据拼接碎纸片的拼接复原时,所有碎纸片匹配度之和取极大值的原则,采用贪心算法,得到了所有碎纸片的初始位置,拼接复原了附件1和附件2中纸片。
针对问题二,由于附件3碎片数量太多,并且碎片的拼接复原,是一个以碎纸片总匹配度为目标函数的组合优化问题。
所以本文采用遗传算法将碎纸片的编号作为基因,并将基因均匀分成19段,按顺序每一段对应一个初始纸片列位置,进行了求解。
然后,根据边缘碎纸片某些边的空白部分多的特征,对初始基因进行了优化。
接着,根据碎纸片的黑色像素密度不同的特点,将碎纸片分成三类,根据同类纸片优先匹配的原则,对遗传算法的运行过程进行了优化,拼接复原了附件3和附件4中纸片。
针对问题三,随着碎纸片量的增多,计算量急剧增加。
在上述拼接复原碎纸片的基础上,又引进了同行位置碎纸片的上部(或下部)空白位置宽度相近的聚类思想。
先对每个类内部拼接,在合并所有类并做一次整体拼接。
由于时间有限,我们未能完成最后一次的整体的拼接,但我们会在比赛后继续探究。
关键词:边缘矩阵匹配度函数遗传算法聚类一、问题重述碎片拼接实际用途已经越来越广泛,传统上拼接复原工作由人工完成,碎片拼接的准确率较高,但效率很低。
并且当碎片数量很大时,人工短时间内拼接出来几乎是不可能的。
所以开发碎纸的拼接技术,以提高拼接复原效率已成为越来越多人的期望。
现在,在碎纸片是规则的情况下,题目要求我们在以下条件建立碎纸片拼接复原模型和算法。
1.来自同一页印刷文字文件(中文、英文各一页)的碎纸机破碎纸片(仅纵切)拼接复原,并将附件1和附件2复原。
2.对碎纸机既纵切又横切文件的情形,将碎纸片拼接完整。
2013国赛 碎纸片的拼接复原数学建模B解题思路分析
2, 图片为文字,所以可以确认文字的形状,但大多为残字,故 可以补全剩余部分。 #根据残字,进行文字预算,找到字体可能是的字,补全字体,找图 片能补全的部分。 3, 图片文字都为从左到右书写,有固定的行。 #文字又从左到右书写,故可以对字的上下画线,从而将文字的拼接, 改为图形线性的匹配。 4,图片可能正反双面,也就是说可以双向确定但是,由于不知道什 么是正面,什么是反面,所以无法确定,故可以将其当做一副。 #广范围查询。 ¥还可以计算他的下一个或上一个字的位置。
பைடு நூலகம்
故可以对字的上下画线从而将文字的拼接4图片可能正反双面也就是说可以双向确定但是由于不知道什么是正面什么是反面所以无法确定故可以将其当做一副
残纸碎片平拼接
图片信息:
1, 图片边缘完整,语言不是普通话,故无法用语法辨别。 2, 图片为文字,所以可以确认文字的形状,但大多为残 字,故可以补全剩余部分。 3, 图片文字都为从左到右书写,有固定的行。 4,图片可能正反双面,也就是说可以双向确定但是,由 于不知道什么是正面,什么是反面,所以无法确定,故可 以将其当做一副。
基于欧氏距离的规则碎纸片拼接复原模型
其中, D 中第 i 行第 J 列元素表示第 i 号二值
矩 阵 所属 的碎 片 的左 边缘 和第 J 号 二值 矩 阵所 属 的
d 一 0 =
, j 等于 1 或2
( 5 )
d 一 =
, j 等于 1 或2
( 4 )
氏距 离 ( i , l = 0 , 1 , 2 , …, n ) 。
其中, d u - U 表示列向 量磊 与列向量 之间的欧
3 - 3 分割横 向复原图片并纵 向拼接
根据 已知每横行碎片个数 ,分割碎片横向拼接
图片,仅取各个横 向复原拼接图片的第一个碎片二 值矩阵的第一行与最后一行 , 组成矩阵 s ’ , 转置得到
矩阵 s i T计算 中各 列 向量 间的欧 氏距 离 。 记第 i 幅分 割后 的横 向拼 接 图片 中第 一 个碎 片
一
列之间的排列顺序 , 继而得到碎片的复原顺序。 由于 些碎片的边缘全为白色, 无法确定其位置 , 此时需
虑将碎纸片横向复原 , 得到横向呈带状的拼接图片 ; 然后根据附件 5的每横行碎片个数 , 分割横 向拼接 图片并进行纵 向复原 , 最后对无法判定 的碎片进行
人工 干 预 。
要 人 工干 预 。
运用 Ma t l a b 软件 , 得到附件 5 所有碎片数据的
二值 矩 阵 。
记碎片的正面的二值矩 阵为第 1 号至第 n 号, 碎片的反面的二值矩阵为第 n + l 号至 n + 2号 , 将所 有读人碎片的二值矩阵的第一列和最后一列取 出, 组成矩阵 s , 计算 s中各列 向量间的欧氏距离。 记第 i 号二值矩阵的第一列为 , 最后一列为
碎纸片的拼接复原数学模型的构建
碎纸片的拼接复原数学模型的构建摘要院本文讨论在碎纸机以不同方式破碎纸片的情况下建立碎纸片的拼接复原模型,以解决碎片数量巨大时人工拼接的难题,本文建立了三个具有针对性的模型。
模型一:方差分析法下的碎纸片拼接模型。
在以纵切方式破碎纸片的情况下,提取碎纸片左右边缘的灰度列向量,利用碎纸片边缘处为单边同宽空白区域的特殊性对碎纸片进行定位,再利用方差分析法和欧式距离解决了纵切碎纸片的拼接复原问题。
模型二:文字行间距一致性的碎纸片拼接模型。
以纵横方式破碎纸片,利用同行文字行间距一致性的主要特性可解决横向碎纸片的拼接复原问题,简化了模型,将离散的像素灰度矩阵平均化处理,进而利用欧氏距离对碎纸片进行匹配,得到了碎纸片复原后的完整图片。
模型三:二值化Otsu 算法的碎纸片拼接复原模型。
本文从双面纵横破碎纸片的问题出发,建立了纸片二值化Otsu 法拼接模型,先对碎纸片分组预处理,为将复杂模型简单化,再利用全局阈值方法中典型的Otsu 法求取碎纸片的最佳阈值,以该阈值对碎纸片中所含灰度值信息进行划分实现二值化处理,将边缘区域明显化,利用统计学方法求取拼接后的纸片间成功匹配的像素点占纸片边缘的概率,最终双面纵横破碎纸片的拼接复原问题得以解决。
Abstract: This paper discusses the construction of splicing scrap recovery model under the condition of shredder breaking paper intopieces in different ways, so as to solve the problem of artificial splicing when there is a great amount of pieces. This paper establishes threecorresponding model.Model One: Paper Scrap Splicing Model under Analysis of Variance.Shredding paper through longitudinal mode, the paper selects the gray scraps of paper around the edge extraction column vector,locates the paper scrap by using edge of paper scraps as blank area with same width, then solves the problem of reconstruction of thelongitudinal cutting paper splicing through analysis of variance method and Euclid Distance.Model Two: Paper Scrap Splicing Model with Consistency of Text Line Spacing.Shredding paper through vertical and horizontal mode, its main characteristics of peer text line spacing consistency can solve theproblem of reconstruction of splicing transverse paper scraps, simplifies the model, processes the pixel matrix of discrete in average andmatches the paper scraps through Euclid Distance and then gets the complete picture of paper scrap afterrecovery.Model Three: Paper Scrap Splicing Model Based on Binaryzation Otsu Algorithm.This paper firstly expounds the double side's vertical and horizontal mode, establishes the paper scrap splicing model based onbinaryzation Otsu algorithm. The paper firstly does preconditioning for paper scraps into groups, simplifies the complex model, and then getsthe optimal threshold of the paper scraps by using typical Otsu algorithm of global threshold method. The paper classifies the gray valueinformationof paper scraps through this threshold to realize binaryzation processing, specifies the edge area, evaluates the probability ofsuccessful matching pixels on edge of splicing paper, and finally solves the mosaic and restoration problems of double side's vertical andhorizontal mode.关键词院离散;方差分析;置信区间;阈值;Otsu 算法Key words: discrete;analysis of variance;confidence interval;threshold;Otsu algorithm中图分类号院TQ018 文献标识码院A 文章编号院1006-4311(2014)25-0238-031模型一考虑以为空间拼接情况,为了获取拼接图像所必须的数据,文章以像素为单位离散所得碎片:利用VC++使用了Windows.H 头文件并调用RGB 等结构定义获得不同像素点的g 值[1],生成了多个灰度矩阵。