
MySQL创建数据库连接池
C3P0 数据源介绍c3p0是一个开源的jdbc连接池,我们熟悉的Hibernate和Sprint 框架使用的都是该数据源创建连接池对象方法1:直接创建对象,设置参数ComboPooledDataSource cpds = new ComboPooledDataSource();cpds.setDriverClass("com.mysql.jdbc.Driver");cpds.setJdbcUrl("jdbc:mysql://localhost:3306/jdbc3");cpds.setUser("root");cpds.setPassword("root");cpds.setInitialPoolSize(5);cpds.setMaxPoolSize(15);方法2:读取配置文件ComboPooledDataSource cpds = newComboPooledDataSource("itcast");配置文件为c3p0-config.xml 该文件需要放在类路径下<c3p0-config><default-config><!—- 默认配置–-><propertyname="initialPoolSize">5</property><propertyname="maxPoolSize">15</property><propertyname="driverClass">com.mysql.jdbc.Driver</propert y><propertyname="jdbcUrl">jdbc:mysql://localhost:3306/jdbc3</ property><propertyname="user">root</property><propertyname="password">root</property></default-config><named-configname="xwh"><propertyname="initialPoolSize">5</property><propertyname="maxPoolSize">15</property><propertyname="driverClass">com.mysql.jdbc.Driver</propert y><propertyname="jdbcUrl">jdbc:mysql://localhost:3306/jdbc3</ property><propertyname="user">root</property><propertyname="password">root</property></named-config></c3p0-config>三、ResultSetMetaData对象元数据,可以理解为描述数据的数据jdbc中的元数据是指数据库、表、列的定义信息ResultSetMetaData对象表示结果集ResultSet对象的元数据获得该对象:ResultSetMetaDatametaData = rs.getMetaData();常用方法:getColumnCount() 返回resultset对象的列数getColumnName(int column) 获得指定列的名称getColumnTypeName(int column) 获得指定列的类型四、jdbc优化使用jdbc对数据库进行crud操作时,会有很多重复的代码,仔细分析不难发现其实变化的只是其中几行代码对于cud(增删改)操作,代码几乎完全一样,唯一的区别就是sql语句不同,我们完全可以把相同的代码抽取出来定义在一个工具方法中,然后定义一个参数来接收sql语句对于r(查询)操作,除SQL语句不同之外,根据操作的实体不同,对ResultSet结果集的处理也有所不相同,因此可义一个query方法,除以参数形式接收变化的SQL语句外,可以使用策略模式由qurey 方法的调用者决定如何把ResultSet中的数据映射到实体对象中优化后的工具类JdbcUtils// 通用的增删改方法public static int update(String sql, Object[]params) throws SQLException {Connection conn =null;PreparedStatementpstmt = null;ResultSet rs = null;try {// 获得连接conn =getConnection();// 预编译sqlpstmt =conn.prepareStatement(sql);// 将参数设置进去for(int i=0; params!=null&&i<params.length; i++) { pstmt.setObject(i+1,params[i]);}// 发送sqlint num = pstmt.executeUpdate();return num;} finally {// 释放资源release(conn,pstmt, rs);}}// 优化查询public static Object query(String sql, Object[] params,ResultSetHandler rsh) throws SQLException { Connection conn =null; PreparedStatementpstmt = null;ResultSet rs = null;try {// 获得连接conn =getConnection();// 预编译sqlpstmt =conn.prepareStatement(sql);// 将参数设置进去for(int i=0; params!=null&&i<params.length;i++) { pstmt.setObject(i+1,params[i]);}// 发送sqlrs =pstmt.executeQuery();// 不知道别人想如何处理结果集// 干脆想别人所要一个结果集的处理器// 为了让当前代码继续,定义一个结果集处理器接口// 策略模式,规定算法,具体的算法留给将来的调用者实现Object obj =rsh.handle(rs);return obj;} finally {// 释放资源release(conn,pstmt, rs);}}结果集处理器接口public interface ResultSetHandler {// 处理结果集的方法public Objecthandle(ResultSet rs);}实现类:BeanListHandlerpublic class BeanListHandler implements ResultSetHandler{private Classclazz;publicBeanListHandler(Class clazz) {this.clazz =clazz;}public Objecthandle(ResultSet rs) {try {// 取出结果集所有的记录,封装到bean,存入list返回List list= new ArrayList();while(rs.next()) {Objectbean = clazz.newInstance();// 获得元数据ResultSetMetaDatametaData = rs.getMetaData();// 获得列的数量intcount = metaData.getColumnCount();// 遍历列for(inti=1; i<=count; i++) {// 取列名StringcolumnName = metaData.getColumnName(i);// 取这列的值Objectvalue = rs.getObject(columnName);// 反射出属性Fieldfield = clazz.getDeclaredField(columnName);// 设置属性field.setAccessible(true);field.set(bean,value);}// 加入listlist.add(bean);}returnlist;} catch(Exception e) {throw newRuntimeException(e);}}}BeanHandlerpublic class BeanHandler implements ResultSetHandler {private Classclazz;publicBeanHandler(Class clazz) {this.clazz =clazz;}public Objecthandle(ResultSet rs) {// 不知道有几列数据,不知道列名,不知道封装到什么样的bean // 表的列明和javabean的字段名一致try {if(rs.next()){// 创建beanObjectbean = clazz.newInstance();// 封装数据// 获得结果集的元数据ResultSetMetaDatametaData = rs.getMetaData();intcount = metaData.getColumnCount();// 迭代取每一列的数据for(inti=1; i<=count; i++) {// 获得列名usernameStringcolumnName = metaData.getColumnName(i);// 获得数据dddObjectvalue = rs.getObject(columnName);// 根据列名反射出映射的属性usernameFieldfield = clazz.getDeclaredField(columnName);// 为属性赋值field.setAccessible(true);field.set(bean,value);}returnbean;}return null;} catch(Exception e) {throw newRuntimeException(e);}}}ArrayHandler// 取出第一行的所有记录存入一个Object数组public class ArrayHandler implements ResultSetHandler {public Objecthandle(ResultSet rs) {try {if(rs.next()) {// 指向了第一行的记录// 获得元数据ResultSetMetaDatametaData = rs.getMetaData(); // 获得列数intcount = metaData.getColumnCount();// 创建数组Object[]arr = new Object[count];// 迭代所有列的值,存入数组for(inti=1; i<=count; i++) {Objectvalue = rs.getObject(i); // 获得指定列的值arr[i-1]= value;}returnarr;}return null;} catch(Exception e) {throw newRuntimeException(e);}}}。
MySQL中的数据库连接数和线程池配置

MySQL中的数据库连接数和线程池配置在使用MySQL数据库时,数据库连接数和线程池的配置对于系统的性能和稳定性起着重要的作用。
本文将探讨MySQL中的数据库连接数和线程池的配置,并讨论它们之间的关系,以及如何进行合理的调优。
一、数据库连接数的概念和作用数据库连接是指应用程序与数据库之间建立的通信渠道,用于发送命令和获取结果。
每个连接都会占用一定的系统资源,包括内存、CPU等。
因此,数据库连接数的设置直接影响到系统的性能和稳定性。
数据库连接数的设置应该根据系统的实际情况进行合理调整。
如果连接数设置过小,可能会导致系统无法处理并发请求,从而导致性能瓶颈;如果连接数设置过大,可能会消耗过多的系统资源,导致系统崩溃或运行缓慢。
二、线程池的概念和作用线程池是一种管理和复用线程的机制,用于提高系统的性能和资源利用率。
在MySQL中,线程池对于管理数据库连接非常重要。
它可以复用已经建立的连接,并根据系统负载动态调整连接的个数,从而减少连接的创建和销毁开销,提高系统的响应速度。
线程池的配置包括线程池的大小以及一些相关的参数。
合理的线程池配置可以提高系统的并发能力,减少资源的消耗,从而提高系统的性能和稳定性。
三、数据库连接数与线程池的关系在MySQL中,数据库连接数与线程池的配置是密切相关的。
数据库连接数决定了系统最大能够同时处理的连接数,而线程池的配置则决定了系统最大能够同时处理的请求数。
当系统的并发请求超过数据库连接数时,线程池将控制请求的排队和等待,以保证不超过最大连接数。
当一个请求到达时,线程池会尝试使用已经建立的空闲连接,如果没有空闲连接,则会根据线程池的配置来创建新的连接。
在这个过程中,数量合理的数据库连接数和线程池配置可以有效地提高系统的性能和稳定性。
如果连接数设置过小,将无法满足系统的并发请求,影响系统的响应速度;如果连接数设置过大,将消耗过多的系统资源,可能会导致系统崩溃。
四、合理调优数据库连接数和线程池配置的方法在实践中,我们可以通过以下几个步骤来进行合理调优数据库连接数和线程池配置。
pymysqlpool用法

pymysqlpool用法pymysqlpool是一个用于管理MySQL数据库连接的Python库,可以提供一个实用的数据库连接池中间件,以避免在应用中频繁地创建和释放数据库连接资源。
以下是一个基本的使用pymysqlpool的示例:1. 首先,需要安装pymysqlpool库。
可以使用pip命令进行安装:Plain Textpip install pymysqlpool2. 导入所需的模块:Pythonimport pymysqlfrom pymysql.pool import PooledMySQLConnection, Pool3. 创建一个连接池对象,并指定连接池的参数:Pythonpool = Pool(host='localhost',user='your_username',password='your_password',database='your_database',charset='utf8',max_pool_size=10,step_size=2)在这个示例中,连接池的参数包括数据库地址(host)、用户名(user)、密码(password)、默认选择的数据库(database)、字符集(charset)、最大连接数(max_pool_size)和每次增加的连接数大小(step_size)。
4. 从连接池中获取一个连接对象:Pythonconn = pool.get_connection()这将返回一个pymysql.Connection对象,可以用于执行数据库操作。
5. 执行数据库操作:Pythoncursor = conn.cursor()cursor.execute('SELECT * FROM your_table')rows = cursor.fetchall()for row in rows:print(row)cursor.close()conn.close()在执行完数据库操作后,记得关闭游标和连接对象。
MySQL中的连接池和连接超时设置方法

MySQL中的连接池和连接超时设置方法引言:在开发Web应用程序时,数据库连接是一个关键的方面。
数据库连接的管理和性能优化对于应用程序的性能和稳定性至关重要。
MySQL是一种开源的关系型数据库管理系统,广泛应用于各种规模的应用程序中。
本文将探讨MySQL中连接池和连接超时设置方法,以帮助开发者更好地管理数据库连接。
一、连接池的概念和作用连接池是一种数据库连接管理技术,通过维护一组可重复使用的数据库连接,提供高效的数据库连接和释放机制,减少了每次请求时建立和关闭数据库连接的开销,从而提升应用程序的性能。
连接池可分为两大类:物理连接池和逻辑连接池。
物理连接池是指在连接池中维护了一定数量的数据库连接,应用程序每次从连接池中获取一个连接来执行数据库操作。
逻辑连接池是指在连接池中维护一定数量的逻辑连接,应用程序从逻辑连接池中获取一个逻辑连接,然后使用该逻辑连接去获取物理连接,执行数据库操作。
连接池的主要作用包括:1. 提高性能:通过减少数据库连接的建立和关闭操作,在一定程度上减少了网络传输开销和服务器资源消耗,提高了数据库请求的响应速度。
2. 降低资源占用:连接池可以重复使用已经创建的数据库连接,减少了频繁创建和释放连接对服务器资源的占用,提高了系统资源的利用率。
3. 控制连接数:连接池可以根据应用程序的并发访问需求,合理控制连接的数量,避免连接过多导致服务器资源不足和性能下降。
二、MySQL中连接池的实现方式MySQL中实现连接池的方式主要有两种:手动管理连接池和使用第三方连接池库。
下面分别介绍这两种方式。
1. 手动管理连接池:手动管理连接池是指开发者自己编写代码来管理数据库连接池。
在这种方式下,开发者需要自行维护连接池中的连接,包括连接的创建、释放和错误处理等。
以下是一个使用Java语言手动管理连接池的示例代码:```javaimport java.sql.Connection;import java.sql.DriverManager;import java.sql.SQLException;import java.util.ArrayList;import java.util.List;public class ConnectionPool {private static final String DRIVER = "com.mysql.jdbc.Driver";private static final String URL = "jdbc:mysql://localhost:3306/database";private static final String USERNAME = "root";private static final String PASSWORD = "password";private List<Connection> connectionPool;private int poolSize;public ConnectionPool(int poolSize) {this.poolSize = poolSize;connectionPool = new ArrayList<>();try {Class.forName(DRIVER);for (int i = 0; i < poolSize; i++) {Connection connection = DriverManager.getConnection(URL, USERNAME, PASSWORD);connectionPool.add(connection);}} catch (ClassNotFoundException | SQLException e) {e.printStackTrace();}}public synchronized Connection getConnection() {while (connectionPool.isEmpty()) {try {wait();} catch (InterruptedException e) {e.printStackTrace();}}Connection connection = connectionPool.remove(0);return connection;}public synchronized void releaseConnection(Connection connection) {connectionPool.add(connection);notifyAll();}}```在上述代码中,我们使用一个`List`数据结构来维护连接池中的连接,通过`synchronized`关键字实现对连接池的线程安全操作。
mysql dblink创建语句

mysql dblink创建语句要在MySQL中使用dblink,需要先创建一个到远程数据库的连接。
下面是创建dblink连接的SQL语句:```sqlCREATE SERVER remote_dbFOREIGN DATA WRAPPER mysqlOPTIONS (HOST 'remote_host', PORT 3306, DATABASE 'remote_db'); CREATE USER 'user'@'localhost' IDENTIFIED BY 'password'; GRANT USAGE ON *.* TO 'user'@'localhost';CREATE DATABASE link_db;USE link_db;CREATE TABLE table1 (id INT PRIMARY KEY,name VARCHAR(50));INSERT INTO table1 VALUES (1, 'John');CREATE TABLE table2 LIKE table1;CREATE USER 'link_user'@'localhost' IDENTIFIED BY 'password';GRANT ALL PRIVILEGES ON link_db.* TO 'link_user'@'localhost';CREATE DATABASE link_db;CREATE USER 'link_user'@'%' IDENTIFIED BY 'password';GRANT ALL PRIVILEGES ON link_db.* TO 'link_user'@'%';CREATE SERVER remote_serverFOREIGN DATA WRAPPER mysqlOPTIONS (USER 'link_user', PASSWORD 'password', HOST 'remote_host', PORT 3306, DATABASE 'link_db');CREATE TABLE table1 (id INT PRIMARY KEY,name VARCHAR(50)) ENGINE=FEDERATED CONNECTION 'remote_server/table1';```这个示例中,首先在本地创建一个数据库link_db和表table1。
MySQL中的连接方式与连接字符串配置

MySQL中的连接方式与连接字符串配置MySQL是一个开源的关系型数据库管理系统,被广泛应用于各种规模的应用程序中。
在使用MySQL进行数据库操作时,连接方式和连接字符串的配置是非常重要的一部分。
本文将对MySQL中的连接方式以及连接字符串的配置进行详细介绍。
一、连接方式在MySQL中,有多种连接方式可供选择,包括本地连接、远程连接、连接池等。
不同的连接方式适用于不同的场景,下面分别介绍这些连接方式的特点和用法。
1. 本地连接本地连接是指在同一台机器上进行MySQL数据库的连接。
当应用程序和数据库位于同一台服务器上时,可以使用本地连接方式。
本地连接速度较快,适用于对响应时间要求较高的场景。
2. 远程连接远程连接是指通过网络连接到另一台机器上的MySQL数据库。
远程连接需要指定远程服务器的IP地址或域名、端口号以及登录凭证等信息。
远程连接具有灵活性,能够在不同的机器之间进行数据库操作,适用于分布式系统或跨地域合作的场景。
3. 连接池连接池是一种重复使用数据库连接的技术,在多用户并发访问数据库的情况下,可以减少数据库连接的创建与关闭的开销。
连接池会创建一定数量的数据库连接,在应用程序需要时分配给不同的线程,使用完毕后又归还给连接池。
连接池可以提高数据库的性能和并发访问能力。
二、连接字符串配置连接字符串是用于连接数据库的一串参数值组成的字符串。
不同的数据库管理系统有不同的连接字符串格式和参数。
在MySQL中,连接字符串的配置可以通过以下几个方面进行设置。
1. 主机名或IP地址连接MySQL需要指定要连接的主机名或IP地址。
可以使用域名解析将域名映射到对应的IP地址,也可以直接使用IP地址进行连接。
主机名或IP地址用于标识数据库所在的服务器。
2. 端口号MySQL默认的端口号是3306,但在实际应用中,可能由于安全设置或其他原因而修改了默认端口号。
连接MySQL时需要指定正确的端口号,否则将无法建立连接。
springboot配置MySQL数据库连接、Hikari连接池和Mybatis的简单配置方法
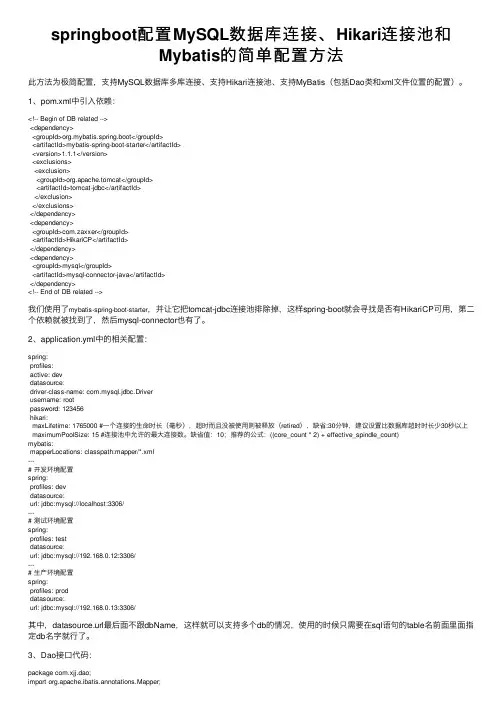
springboot配置MySQL数据库连接、Hikari连接池和Mybatis的简单配置⽅法此⽅法为极简配置,⽀持MySQL数据库多库连接、⽀持Hikari连接池、⽀持MyBatis(包括Dao类和xml⽂件位置的配置)。
1、pom.xml中引⼊依赖:<!-- Begin of DB related --><dependency><groupId>org.mybatis.spring.boot</groupId><artifactId>mybatis-spring-boot-starter</artifactId><version>1.1.1</version><exclusions><exclusion><groupId>org.apache.tomcat</groupId><artifactId>tomcat-jdbc</artifactId></exclusion></exclusions></dependency><dependency><groupId>com.zaxxer</groupId><artifactId>HikariCP</artifactId></dependency><dependency><groupId>mysql</groupId><artifactId>mysql-connector-java</artifactId></dependency><!-- End of DB related -->我们使⽤了mybatis-spring-boot-starter,并让它把tomcat-jdbc连接池排除掉,这样spring-boot就会寻找是否有HikariCP可⽤,第⼆个依赖就被找到了,然后mysql-connector也有了。
设置mysql最大连接数的方法mysql连接池设置
设置mysql最⼤连接数的⽅法mysql连接池设置数据库安装完成后,默认数是100,⼀般流量稍微⼤⼀点的论坛或这个连接数是远远不够的,增加默认MYSQL连接数的⽅法有两个⽅法⼀:进⼊MYSQL安装⽬录打开MYSQL配置⽂件 my.ini 或 f查找 max_connections=100 修改为 max_connections=1000 服务⾥重起MYSQL即可⽅法⼆:MySQL的最⼤连接数默认是100客户端登录:mysql -uusername -ppassword设置新的最⼤连接数为200:mysql> set GLOBAL max_connections=200显⽰当前运⾏的Query:mysql> show processlist显⽰当前状态:mysql> show status退出客户端:mysql> exit查看当前最⼤连接数:mysqladmin -uusername -ppassword variables⽅法三:以centos 4.4 下⾯的mysql 5.0.33 ⼿⼯编译版本为例说明: vi /usr/local/mysql/bin/mysqld_safe 找到safe_mysqld编辑它,找到mysqld启动的那两⾏,在后⾯加上参数: -O max_connections=1500 具体⼀点就是下⾯的位置: ⽤红字特别说明: then $NOHUP_NICENESS $ledir/$MYSQLD $defaults --basedir=$MY_BASEDIR_VERSION --datadir=$DATADIR $USER_OPTION --pid-file=$pid_file --skip-external-locking -O max_connections=1500 >> $err_log 2>&1 else eval "$NOHUP_NICENESS $ledir/$MYSQLD $defaults --basedir=$MY_BASEDIR_VERSION --datadir=$DATADIR $USER_OPTION --pid-file=$pid_file --skip-external-locking $args -O max_connections=1500 >> $err_log 2>&1" 保存。
JSP 配置MySQL数据库连接池
JSP 配置MySQL数据库连接池连接池可以预先建立一些连接,并且这些连接允许共享,因此这样就节省了每次连接的时间开销。
本练习以MySQL数据库为例,通过一个简单的例子,带领读者学习数据库连接池在Tomcat中的配置与使用。
具体步骤如下:(1)创建数据库。
在MySQL中创建Student数据库,它有一个表student,此表包含id(int)、name(char)、addr(char)、tel(char)四个字段,分别用来存放学生的编号、姓名、地址、电话的信息。
(2)配置server.xml文件。
在Tomcat的安装目录下找到文件夹conf,进入该rl指定要连接的数据库;driverClassName指定连接数据库使用的驱动程序;userna me与password分别指定连接数据库的用户名与密码;maxWait指定最大建立连接等待时间,如果超过此时间将接到异常;maxIdle指定连接池中连接的最大空闲数;maxActive指定连接池最大连接数。
(3)配置web.xml文件。
在Web应用程序中找到web.xml,它在站点的WEB在上述元素中加入如下子元素:Description为描述信息;res-ref-name指定参考数据源名称,同上一步的属性n ame;res-type为资源类型;res-auth为连接名,res-sharing-scope指定是否可以被共享。
(4)配置context.xml文件。
这个文件与server.xml文件所在的位置相同。
用记事本打开,找到如下元素:name与同步骤(2)的name属性值相同,也与步骤(3)的res-ref-name属性值相同;type同样取“javax.sql.DataSource”;global同本步骤的name属性值。
(5)测试配置的数据库连接池。
使用已经配置好的Student数据库连接池,从。
如何使用MySQL连接多个数据库
如何使用MySQL连接多个数据库MySQL是一种非常流行的关系型数据库管理系统,被广泛应用于各种应用程序和网站的后台数据存储和管理。
在开发过程中,有时候我们需要连接和管理多个数据库,本文将介绍如何使用MySQL连接多个数据库。
一、MySQL的多数据库连接概述在MySQL中,连接数据库是指通过用户名和密码等认证方式,将客户端程序与数据库服务器建立通信和交互的过程。
通常情况下,我们使用MySQL的客户端工具(如Navicat、SQLyog等)来连接数据库进行操作。
多数据库连接是指在一个应用中连接和操作多个数据库实例,比如一个应用需要同时连接多个数据库来处理不同的业务需求。
在实际开发中,多数据库连接的需求很常见,例如一个电商平台可能会有一个数据库用于存储用户信息,另一个数据库用于存储商品信息,还有一个数据库用于存储订单信息等。
二、使用MySQL的多数据库连接方式MySQL提供了多种方式来实现多数据库连接,下面将介绍几种常用的方式。
1. 使用多个数据库连接对象在编程时,我们可以创建多个数据库连接对象,每个连接对象连接一个数据库。
这样就可以通过不同的连接对象来操作不同的数据库。
例如,使用Python的MySQLdb模块创建多个数据库连接对象的示例代码如下:```pythonimport MySQLdb# 连接第一个数据库conn1 = MySQLdb.connect(host="localhost", user="user1", passwd="password1", db="database1")# 连接第二个数据库conn2 = MySQLdb.connect(host="localhost", user="user2", passwd="password2", db="database2")# 然后可以使用conn1和conn2来执行不同的SQL语句```2. 使用MySQL的命名空间方式MySQL支持使用命名空间的方式来连接多个数据库。
MySQL连接池的配置和使用方法
MySQL连接池的配置和使用方法引言:MySQL是目前最流行的开源数据库之一,在Web应用中广泛使用。
在高并发的场景下,为了保证数据库的稳定性和性能,合理地配置和使用MySQL连接池非常重要。
本文将介绍MySQL连接池的概念、配置和使用方法,帮助读者更好地理解和应用MySQL连接池。
一、什么是MySQL连接池MySQL连接池是为了解决数据库连接请求频繁创建和销毁的性能问题而设计的。
连接池允许应用程序创建一组预先初始化的数据库连接,这些连接保存在连接池中以供应用程序重复使用。
通过重用连接,可以减少创建和销毁连接的开销,提高数据库的性能和效率。
二、MySQL连接池的配置方法配置MySQL连接池需要了解以下几个关键参数:1. 连接池大小(pool size):指的是连接池中允许存在的最大连接数。
连接池大小应根据数据库服务器的处理能力和应用程序的并发请求数进行合理的估算。
2. 最小空闲连接数(min idle connections):连接池中保持的最小空闲连接数。
这些连接准备好并可立即使用,以便快速地响应应用程序的连接请求。
3. 最大空闲连接数(max idle connections):连接池中允许存在的最大空闲连接数。
当连接池中的连接数超过最大空闲连接数时,多余的连接将被关闭。
合理设置最大空闲连接数可以避免连接数过多导致内存和数据库资源浪费。
4. 连接超时时间(connection timeout):当连接池无法分配连接给应用程序时,连接请求的超时时间。
如果超过连接超时时间,连接请求将被拒绝。
5. 连接最大使用次数(max usage count):连接在被回收之前允许的最大使用次数。
通过设置连接最大使用次数,可以防止某些连接长时间占用而不释放。
6. 连接生存时间(connection lifespan):连接在连接池中保持的最长时间。
过期的连接将被连接池关闭和回收。
三、MySQL连接池的使用方法使用MySQL连接池可以提高数据库性能,并且减少连接资源的占用。