
shell字符串的处理(截取,连接,匹配,替换,翻转)
shell字符串的处理(截取,连接,匹配,替换,翻转)
shell 字符串的处理(截取,连接,匹配,替换,翻转)
本节分享下,字符串处理的内容,包括:截取,连接,匹配,替换,翻转等。
1,字符串的截取
⽅法⼀:
代码⽰例:echo $a|awk ’{print substr( ,1,8)}’
substr是awk中的⼀个⼦函数,对第⼀个参数的进⾏截取,从第⼀个字符开始,共截取8个字符,如果不够就从第⼆个字符中补充
⽅法⼆
代码⽰例:echo $a|cut -b2-8
cut:对标准输⼊的字符串进⾏处理
cut -bn-m:以byte为单位,从第n个byte开始,取m个
cut -bn,m:以byte为单位,截取第n,m个byte
cut -b-n,m:以byte为单位,截取1-n,和第m个
-c:以charactor为单位
-d:指定分隔符,默认为tab
-s:使标准输⼊中没有delimeter
cut -f1:截取第1个域
⽅法三a=123456
echo $
⽅法四
使⽤sed截取字符串的最后两位
代码⽰例:echo $test |sed ’s//(.*/)/(../)$//’
截取字符串的前2位
代码⽰例:echo $test |sed ’s/^/(../)/(.*/)//’
2,字符串的⽐较
好像没有什么可以⽐较的
3,字符串的连接
$a$b
或者$string
4,字符串的翻转
⽅法⼀:
使⽤rev
⽅法⼆:
编写脚本实现
代码⽰例:#!/usr/bin/awk -f
{
revline = ""
for (i=1;i<=length;i++)
{
revline = substr(,i,1) revline
}
}
END{print revline}
5,字符串的匹配
grep
egrep
fgrep
6,字符串的排序
sort
7,字符串的替换
bash中:
代码⽰例:%x=ababcd
%echo $ # 只替换⼀个
bbcdabcd
%echo $ # 替换所有
bbcdbbcd
sh中:
如何替换/
使⽤sed
替换所有匹配
代码⽰例:echo $test |sed ’s/xx/yy’
替换单个匹配
8,得到字符串的长度:
bash当中
$
或者expr "$VAR" : ’.*’
9,判断字符串是否为数字
10,得到字符串中某个字符的重复次数
代码⽰例:echo $a |tr "x" "/n" | -l
得到的结果需要减去1
或者
代码⽰例:echo $a |awk -F"x" ’{print NF-1}’
11,得到字符串中某个string的重复次数
12,将⼀批⽂件中的所有string替换
代码⽰例:for i in file_list
do
vi $i <<-!
:g/xxxx/s//XXXX/g
:wq
!
done
13,如何将字符串内每两个字符中间插⼊⼀个字符
使⽤
代码⽰例:echo $test |sed ’s/../&[insert char]/g’
======================================================================================================================================
概述
我们⽇常应⽤中都离不开⽇志。可以说⽇志是我们在排查问题的⼀个重要依据。但是⽇志并不是写了就好了,当你想查看⽇志的时候,你会发现线上⽇志堆积的长度已经超
越了你⼀⾏⾏浏览的耐性的极限了。于是,很有必要通过⼀些⼿段来⾼效地辅助你来快速的从⽇志中找到你要找的问题。本⽂通过⼀个从项⽬中衍⽣出来的例⼦从查找⽇志,筛
选⽇志和统计⽇志3个⽅⾯层层递进来简述⽇志⽂件查看中⼀些有⽤的⼿段。(注:在linux环境下)
⽬录
例⼦背景:
后台跑⼀个定时任务,对指定时间段的订单数据表中的每⼀条记录进⾏以此任务处理。在⽇志中输出:
1.订单id
2.订单处理状态 3.⽇志类别
准备⼯具:sort, tail, less, uniqu,grep,sed,awk
⽰例⽇志:demo.log
[plain]
1. 2011-08-23 19:57:00,610 [] INFO bo.CommodityCerOrderBO - =====>属性订正任务执⾏开始|每页读取100条数据
2. 2011-08-23 19:57:05,012 [] INFO bo.CommodityCerOrderBO - 当前正在处理页数:1
3. 2011-08-23 19:57:30,688 [] INFO bo.CommodityCerOrderBO - order-fix.curr_id:10117,status:attr_ids不含0跳过
4. 2011-08-23 19:57:30,709 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10117,status:添加属性id,但由于认证分类参数有误默认取匹配属性名称的第⼀个属性
id:100104
5. 2011-08-23 19:57:31,721 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10117,status:添加属性id,但由于认证分类参数有误默认取匹配属性名称的第⼀个属性
id:100105
6. 2011-08-23 19:57:32,727 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10117,status:添加属性id,但由于认证分类参数有误默认取匹配属性名称的第⼀个属性
id:100107
7. 2011-08-23 19:57:32,782 [] INFO bo.CommodityCerOrderBO - order-fix.curr_id:10117,status:attr_ids成功保存为0|100104|0|100105|100107
8. 2011-08-23 19:57:32,782 [] INFO bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:attr_ids不含0跳过
9. 2011-08-23 19:57:32,805 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100104 10. 2011-08-23 19:57:33,828 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100107 11. 2011-08-23 19:57:33,838 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:46 12. 2011-08-23 19:57:34,850 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100106 13. 2011-08-23 19:57:35,860 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100105 14. 2011-08-23 19:57:36,871 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:3 15. 2011-08-23 19:57:36,884 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:3 16. 2011-08-23 19:57:36,891 [] INFO bo.CommodityCerOrderBO - order-fix.curr_id:10226,status:attr_ids成功保存为6|100104|0|0|100107|46|100106|100105|3|3
17. 2011-08-23 19:57:36,891 [] INFO bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:attr_ids不含0跳过
18. 2011-08-23 19:57:36,928 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:3 19. 2011-08-23 19:57:36,942 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100104 20. 2011-08-23 19:57:36,955 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100105 21. 2011-08-23 19:57:36,969 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100107 22. 2011-08-23 19:57:36,980 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:46 23. 2011-08-23 19:57:36,992 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:100106 24. 2011-08-23 19:57:37,011 [] ERROR bo.CommodityCerOrderBO - order-fix.curr_id:10222,status:添加属性id,但由于没有属性在该分类下默认取匹配属性名称的第⼀个属
性id:3
0.⼀些最基础的⽇志查看命令
最简单的⽇志查看命令就是浏览⽇志⽂件了,⼀般会从有限浏览⽂件末尾的
[plain]
1. tail -400f demo.log #监控最后400⾏⽇志⽂件的变化 等价与 tail -n 400 -f (-f参数是实时)
shell字符串处理总结
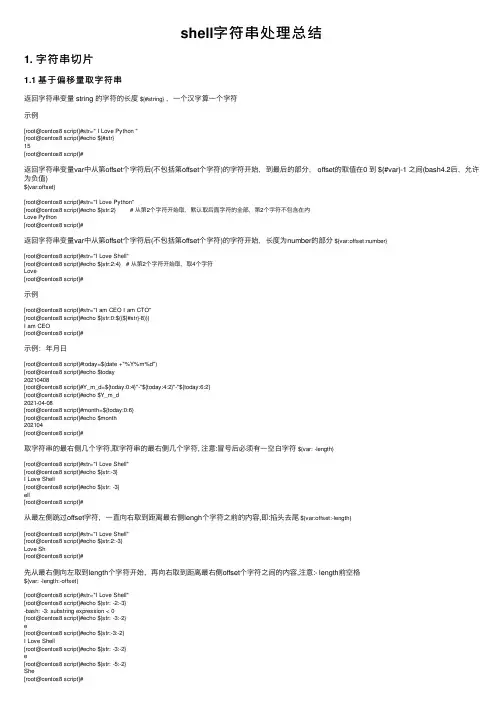
shell字符串处理总结
1. 字符串切⽚
1.1 基于偏移量取字符串
返回字符串变量 string 的字符的长度 ${#string} ,⼀个汉字算⼀个字符
⽰例
[root@centos8 script]#str=" I Love Python "
[root@centos8 script]#echo ${#str}
15
[root@centos8 script]#
返回字符串变量var中从第offset个字符后(不包括第offset个字符)的字符开始,到最后的部分, offset的取值在0 到 ${#var}-1 之间(bash4.2后,允许
为负值)
${var:offset}
[root@centos8 script]#str="I Love Python"
[root@centos8 script]#echo ${str:2} # 从第2个字符开始取,默认取后⾯字符的全部,第2个字符不包含在内
Love Python
[root@centos8 script]#
返回字符串变量var中从第offset个字符后(不包括第offset个字符)的字符开始,长度为number的部分 ${var:offset:number}
[root@centos8 script]#str="I Love Shell"
[root@centos8 script]#echo ${str:2:4} # 从第2个字符开始取,取4个字符
Love
[root@centos8 script]#
⽰例
[root@centos8 script]#str="I am CEO I am CTO"
[root@centos8 script]#echo ${str:0:$((${#str}-8))}
I am CEO
[root@centos8 script]#
⽰例:年⽉⽇
[root@centos8 script]#today=$(date +"%Y%m%d")
[root@centos8 script]#echo $today
shell编程中的字符串截取方法小结

shell编程中的字符串截取⽅法⼩结
⼀、Gnu Linux shell 截取字符变量的前8位,有⽅法如下:
1.expr substr “$a” 1 8
2.echo $a|awk ‘{print substr(,1,8)}'
3.echo $a|cut -c1-8
4.echo $
5.expr $a : ‘\(.\\).*'
6.echo $a|dd bs=1 count=8 2>/dev/null
⼆、按指定的字符串截取
1、第⼀种⽅法:
${varible##*string} 从左向右截取最后⼀个string后的字符串
${varible#*string}从左向右截取第⼀个string后的字符串
${varible%%string*}从右向左截取最后⼀个string后的字符串
${varible%string*}从右向左截取第⼀个string后的字符串
“*”只是⼀个通配符可以不要
例⼦:
复制代码 代码如下:
$ MYVAR=foodforthought.jpg
$ echo ${MYVAR##*fo}
rthought.jpg
$ echo ${MYVAR#*fo}
odforthought.jpg
2、第⼆种⽅法:${varible:n1:n2}:截取变量varible从n1到n2之间的字符串。
可以根据特定字符偏移和长度,使⽤另⼀种形式的变量扩展,来选择特定⼦字符串。试着在 bash 中输⼊以下⾏:
复制代码 代码如下:
$ EXCLAIM=cowabunga
$ echo ${EXCLAIM:0:3}
cow
$ echo ${EXCLAIM:3:7}
abunga
这种形式的字符串截断⾮常简便,只需⽤冒号分开来指定起始字符和⼦字符串长度。
三、按照指定要求分割:
⽐如获取后缀名
复制代码 代码如下:
ls -al | cut -d “.” -f2
linux_shell_字符串函数_解释说明

linux shell 字符串函数 解释说明
1. 引言
1.1 概述
在Linux操作系统中,Shell是一种强大的命令行解释程序,它提供了执行和控制操作系统功能的接口。Shell脚本是由一系列命令按照特定顺序组合而成的脚本文件。
在Shell脚本中,字符串是最常用的数据类型之一。字符串函数是一类重要的工具,用于处理、操作和管理字符串数据。这些函数提供了丰富的功能,可以快速完成对字符串的长度计算、比较、复制、连接以及其他常见处理任务。
1.2 文章结构
本文将详细介绍Shell中的字符串函数,并逐个解释这些函数的作用和用途。文章主要分为以下几个部分:
- 字符串函数概述:介绍了字符串基本概念以及Shell中对字符串的表示方法。
- 字符串长度与比较函数:详细说明了strlen()、strcmp()和strncmp()这三个常用函数,它们用于分别获取字符串长度以及进行字符串比较。
- 字符串复制与连接函数:重点讲解了strcpy()、strncpy()和strcat()这三个常见函数,它们可实现将一个字符串复制到另一个位置或将多个字符串连接起来。 - 其他常用字符串处理函数:介绍了一些其他常用的字符串处理函数,包括strtok()、strchr()/strrchr()、strstr()/strcasestr()等,它们在处理字符串时也十分有用。
- 结论:对本文进行总结和回顾。
通过对这些字符串函数的详细讲解,读者将能够更好地理解并灵活运用Shell脚本中的字符串处理功能,提高编程效率和代码质量。
1.3 目的
本文旨在帮助读者全面了解Linux Shell脚本中的字符串函数。通过逐个解释说明每个函数的作用和用途,读者将能够掌握常见字符串处理任务的方法,并且能够根据实际需求进行灵活应用。
无论是初学者还是有一定经验的开发人员,通过阅读本文都能够更深入地理解Shell脚本中的字符串函数,并且在实际编程过程中运用自如。对于那些需要频繁处理字符串数据的开发人员来说,掌握这些函数将大大提高工作效率和代码质量。
shell正则匹配 字符串 简书

- 1 - shell正则匹配 字符串 简书
在Shell编程中,正则表达式是一个非常常用的工具,可以用来匹配和处理字符串。在本文中,我们将介绍Shell中如何使用正则表达式来匹配字符串。
首先,我们需要知道Shell中支持的正则表达式语法。在Shell中,通常使用的是基于POSIX标准的正则表达式语法,其语法与其他编程语言中的正则表达式语法类似,但也有些许不同。
接下来,我们将介绍几个常用的正则表达式匹配方式:
1. 基本的正则表达式匹配:使用'='符号进行匹配,例如:
```
if [ '$str' = 'hello' ]; then
echo 'match'
fi
```
2. 使用通配符进行匹配:使用'*'通配符来匹配任意字符,例如:
```
if [[ '$str' =~ 'he*llo' ]]; then
echo 'match'
fi
```
3. 使用正则表达式进行匹配:使用'=~'符号进行匹配,例如:
``` - 2 - if [[ '$str' =~ ^hel*o$ ]]; then
echo 'match'
fi
```
除了以上介绍的几种匹配方式,还有其他更加复杂的匹配方式,例如使用字符组、量词、反向引用等等。具体的语法可以参考Shell的帮助文档或者其他相关资料。
总之,在Shell编程中,正则表达式是一项非常重要的工具,可以帮助我们快速、高效地处理字符串。希望本文可以帮助大家更好地掌握Shell正则表达式的使用。
高级Shell脚本编写技巧使用正则表达式进行文本替换和转换

高级Shell脚本编写技巧使用正则表达式进行文本替换和转换
在Shell脚本编写过程中,使用正则表达式进行文本替换和转换是非常重要的技巧。正则表达式可以用来匹配、搜索和替换文本中的特定模式,以实现自动化处理和转换文本的目的。本文将介绍一些高级Shell脚本编写技巧,以帮助读者运用正则表达式进行文本替换和转换。
一、正则表达式的基本概念
正则表达式是一种用来匹配和处理文本的强大工具。它由字符和特殊符号组成,用于描述和匹配字符串。
1.1 基本元字符
正则表达式中的基本元字符包括字母、数字和其他特殊字符。其中一些基本元字符具有特殊含义,如下所示:
- . :匹配除换行符外的任意字符。
- ^ :匹配字符串的开头。
- $ :匹配字符串的结尾。
- * :匹配前一个字符0次或多次。
- + :匹配前一个字符1次或多次。
- ? :匹配前一个字符0次或1次。
- [] :匹配字符集中的任意一个字符。 - () :分组,用于对表达式进行分组。
1.2 定义字符集
正则表达式中的字符集用于匹配一组字符。字符集可以使用方括号
[] 来定义,如 [abc] 匹配字符 a、b 或 c。也可以使用连字符 - 来定义连续的字符范围,如 [a-z] 匹配从 a 到 z 的任意小写字母。
1.3 特殊字符的转义
在正则表达式中,一些字符有特殊含义,如 .、^ 和 $ 等。如果要匹配这些字符本身,需要在其前面加上反斜杠 \ 进行转义,如匹配 . 字符需要使用 \.。
二、在Shell脚本中使用正则表达式
在Shell脚本中,可以使用各种工具来处理正则表达式,如grep、sed和awk等。下面将分别介绍这几个工具的使用方法。
2.1 grep命令
grep命令用于在文本中搜索指定模式的行,并将匹配到的行输出。它的基本用法是:
```
grep pattern file
```
其中,pattern是要搜索的正则表达式模式,file是要搜索的文件名。 2.2 sed命令
shell操作字符串

SHELL的字符替换
SHELL的字符替换
shell的字符替换
变量替换:
一:简单赋值和替换
a=bcd
$ echo $a
bcd
$ echo ${a}
bcd
二:变量扩充
除了shell中的meta,其它的[^a-zA-Z0-9_]几乎都可以作单词边界。
同sed中关于单词边界[^a-zA-Z0-9_]的描述。
这些功能有时候会在程序中有意想不到的作用!
例如:
$ a=bcd
$ echo ${a}.b
$ echo $
$ echo $a%b
bcd%b
$ echo /$a/bc
/bcd/bc
对于shell中的meta字符,则backslash。
$ echo $a\*b
bcd*b
三:变量中的变量
$ a=bcd
$ b=efg
$ c=$a$b
$ echo $c
bcdefg
$ d=$
$ echo $d
思考:若变量互相嵌套,会怎样呢
四:变量的特异功能
到网中人的啦!(ps:重写真是没激情啊)
file=/dir1/dir2/dir3/
我们可以用 ${ } 分别替换获得不同的值:
${file#*/}:从变量file的字符串左边开始,删除字符直到第一个“/”:dir1/dir2/dir3/
${file##*/}:从变量file的字符串左边开始,删除字符直到最后一个“/”:
${file#*.}:从变量file的字符串左边开始,删除字符直到第一个“.”:
${file##*.}:从变量file的字符串左边开始,删除字符直到最后一个“.”:txt
其实,在“#”后面,无非就是一个匹配问题,不限于两个,你可以放任意个字符,还可以用shell中另外的通配符“”“[…]”“[!…]”,例如:
$ echo ${file#}
1/dir2/dir3/
$ echo ${file#*[0-9]}
/dir2/dir3/
$ echo ${file#/dir1/dir[0-9]}
Shell脚本编写的高级技巧利用正则表达式进行字符串匹配
Shell脚本编写的高级技巧利用正则表达式进行字符串匹配
Shell脚本编写的高级技巧:利用正则表达式进行字符串匹配
Shell脚本是一种强大的脚本语言,广泛用于自动化任务、数据处理和系统管理等方面。在Shell脚本编写中,利用正则表达式进行字符串匹配是一项重要的高级技巧。本文将介绍如何在Shell脚本中运用正则表达式实现字符串匹配及相关应用。
一、正则表达式简介
正则表达式是一种用于在文本中查找、匹配和操作字符串的强大工具。通过使用正则表达式,我们可以实现高效、灵活和复杂的字符串匹配。
正则表达式由一些特殊字符和普通字符组成,其中特殊字符具有特殊的含义。我们可以根据需要使用这些特殊字符来定义我们想要匹配的模式,然后将其应用于Shell脚本中。
二、使用正则表达式进行字符串匹配
在Shell脚本中,我们可以使用不同的命令和工具来实现正则表达式的字符串匹配。这里我们将介绍三种常用的方式:grep命令、sed命令和awk命令。
1. grep命令 grep命令是一种强大的文本搜索工具,它可以根据正则表达式来在文件中搜索指定的模式,并将匹配的行输出。例如,我们可以使用以下命令来在文件中查找包含"hello"的行:
```shell
grep "hello" file.txt
```
2. sed命令
sed命令是一种流式文本编辑器,它可以对输入的文本按照指定的规则进行处理和转换。我们可以使用正则表达式来指定匹配的模式,并使用sed命令进行相应的操作。例如,我们可以使用以下命令将文件中的所有"hello"替换为"world":
```shell
sed 's/hello/world/g' file.txt
```
3. awk命令
awk命令是一种文本处理工具,它可以对输入的文本按照指定的字段进行处理和转换。我们可以使用正则表达式来定义字段的匹配模式,并使用awk命令进行相应的操作。例如,我们可以使用以下命令打印文件中匹配"hello"的行:
shell提取最后匹配字符串的函数
shell提取最后匹配字符串的函数
Shell脚本是一种用于执行操作系统命令的编程语言。它可以用于自动化任务、批处理作业以及系统管理等操作。在Shell编程中,我们经常需要对文本进行处理,并且有时需要提取字符串中最后一个匹配的子字符串。本文将详细介绍如何编写一个函数来提取最后一个匹配的子字符串,并给出一些示例以加深理解。
在Shell中,我们可以使用正则表达式来匹配文本。为了提取最后一个匹配的子字符串,我们将使用grep命令配合正则表达式来实现。下面是一个简单的示例函数来演示如何提取最后一个匹配的子字符串:
shell
extract_last_match() {
local pattern="1"
local input="2"
local last_match=(echo "input" grep -o "pattern" tail -n 1)
echo "last_match"
}
在这个示例函数中,我们定义了一个名为`extract_last_match`的函数。该函数接受两个参数:`pattern`和`input`。`pattern`是一个正则表达式模式,用于指定我们要匹配的子字符串。`input`是我们要在其中查找匹配的文本。
函数的核心在于使用了grep命令。在这个命令中,我们使用了`-o`参数来指定只输出匹配的部分,并使用了`tail -n 1`命令来获取输出的最后一行,即最后一个匹配的子字符串。
最后,我们使用`echo`命令将该子字符串输出到屏幕上。
下面是一个示例来展示如何使用我们的函数来提取最后一个匹配的子字符串:
shell
input="Hello, this is a test string. I want to extract the last 'string' in
this sentence."
pattern="string"
shell 字符串 正则
shell 字符串 正则
Shell 字符串正则表达式是一种用于匹配和操作字符串的强大工具。本文将介绍Shell 字符串正则表达式的基本概念和常用语法,以及如何在实际应用中灵活运用。
一、基本概念
在Shell 编程中,字符串是一种重要的数据类型,而正则表达式则是一种强大的模式匹配工具。正则表达式通过一系列的特殊字符和普通字符组成,用于描述字符串的特征和规则。Shell 字符串正则表达式可以用于字符串的匹配、替换、提取等操作,大大增强了Shell 脚本的功能和灵活性。
二、常用语法
1. 普通字符:普通字符是正则表达式的基本组成单位,它可以是字母、数字或其他符号。例如,正则表达式abc 匹配包含abc 三个连续字符的字符串。
2. 元字符:元字符是具有特殊含义的字符,用于描述字符串的特殊模式。常见的元字符包括点号.(匹配任意字符)、星号*(匹配前面的字符零次或多次)、加号+(匹配前面的字符一次或多次)等。
3. 字符类:字符类用于匹配指定范围内的字符。例如,正则表达式[0-9] 匹配任意一个数字字符。
4. 边界匹配:边界匹配用于限定字符串的开头和结尾。例如,正则表达式^abc 匹配以abc 开头的字符串。 5. 重复匹配:重复匹配用于匹配重复出现的字符或字符串。例如,正则表达式a{3} 匹配连续出现三次的字符a。
6. 分组和引用:分组和引用用于将多个字符或子表达式组合在一起,并对其进行引用。例如,正则表达式(abc){2} 匹配连续出现两次的字符串abc。
三、实际应用
在实际应用中,Shell 字符串正则表达式常用于字符串的匹配和替换操作。例如,在处理文本文件时,可以使用正则表达式快速提取符合特定模式的字符串。下面是一些常见的应用场景:
1. 数据清洗:在处理数据文件时,经常需要清理和过滤不符合要求的数据。可以使用正则表达式匹配并删除包含特定字符或模式的字符串,从而实现数据的清洗和筛选。
Shell脚本编写高级技巧使用sed命令进行字符串替换
Shell脚本编写高级技巧使用sed命令进行字符串替换
在Shell脚本编写中,使用sed命令进行字符串替换是一项重要的高级技巧。sed(Stream Editor)是一种流式文本编辑器,它可以对文本进行查找和替换操作,十分灵活和强大。在本文中,我们将介绍sed命令的基本用法,并分享一些应用场景和技巧,帮助读者更好地掌握sed命令的高级用法。
一、基本用法
sed命令的基本用法是将指定的文本流进行处理,并将结果输出到标准输出。它的基本语法如下:
```
sed [选项] ‘命令’ 文件
```
其中,选项可以控制sed命令的行为,命令用于指定sed的操作。常用的选项有:
- `-n`:只打印经过sed处理后的结果,不打印未经处理的文本。
- `-e`:允许对输入文本指定多个sed命令。
命令是sed的核心部分,用于指定sed的操作。常用的命令有:
- `s/old/new/g`:将文本中所有匹配到的old替换为new。 - `p`:打印匹配到的行。
- `d`:删除匹配到的行。
二、替换字符串的常见用法
使用sed命令进行字符串替换时,最常见的用法是将字符串替换为指定的内容。下面是一些常见的sed命令示例:
1. 将指定行中的字符串替换为新的字符串:
```
sed '2s/old/new/g' file.txt
```
这个命令将文件file.txt中第2行的所有匹配到的old替换为new。
2. 将文件中所有匹配到的字符串替换为新的字符串:
```
sed 's/old/new/g' file.txt
```
这个命令将文件file.txt中所有匹配到的old替换为new。
3. 限制只替换指定范围内的字符串:
```
sed '2,4s/old/new/g' file.txt ```
这个命令将文件file.txt中第2行到第4行之间的所有匹配到的old替换为new。
三、应用场景和技巧