
Clustalx 多重序列比对图解教程(图解使用)
Clustalx 多重序列比对图解教程(By Raindy)
本帖首发于Raindy'blog,转载请保留作者信息,谢谢!欢迎有写生物学软件专长的战友,加入生信教程写作群:,接头暗号:你所擅长的生物学软件名称
软件简介:
CLUSTALX-是CLUSTAL多重序列比对程序的Windows版本。
Clustal X为进行多重序列和轮廓比对和分析结果提供一个整体的环境。
序列将显示屏幕的窗口中。
采用多色彩的模式可以在比对中加亮保守区的特征。
窗口上面的下拉菜单可让你选择传统多重比对和轮廓比对需要的所有选项。
主要功能:
你可以剪切、粘贴序列以更改比对的顺序;
你可以选择序列子集进行比对;
你可以选择比对的子排列(Sub-range)进行重新比对并可插入到原始比对中;
可执行比对质量分析,低分值片段或异常残基将以高亮显示。
当前版本:1.83
PS:如果你是新手或喜欢中文界面,推荐使用本人汉化的Clustalx 1.81版链接地址::ist&ID=7435(请完整复制)
应用:Clustalx比对结果是构建系统发育树的前提
实例:植物呼肠孤病毒属外层衣壳蛋白P8(AA序列)为例
流程:载入序列―>编辑序列―>设置参数―>完全比对―>比对结果
1.载入序列:运行ClustalX,主界面窗口如下所图(图1),依次在程序上方的菜单栏选择“File”-“Load Sequence”载入待比对的序列,如图2所示,如果当前已载入序列,此时会提示是否替换现有序列(Replace existing sequences),根据具体情形选择操作。
图1
图2
2.编辑序列:对标尺(Ruler)上方的序列进行编辑操作,主要有Cut sequences(剪切序列)、Paste sequences(粘贴)、Select All sequences(选定所有序列),Clear sequence Selection(清除序列选定)、Search for string(搜索字串)、Remove All gaps(移除序列空位)、Remove Gap-Only Columns(仅移除选定序列的空位)
图3
3.参数设置:可以根据分析要求设置相对的比对参数。
通常情况下,我们可以使用默认参数。
比对参数主要有六个,分别是Reset New Gaps before Alignment(比对前重置新的空位参数),Reset All Gaps before Alignment(比对前重置所有空位参数),Pairwise Alignment Parameters(两两序列比对参数),Multiple Alignment Parameters(多重序列比对参数),Protein Gap Parameters(蛋白空位参数),Secondary structure Parameters(二级结构参数),如图4所示:
图4
修改参数只需点击相应标签,示例比对的是多序列比对,故可选择“Multiple Alignment Parameters”弹出参数设置窗口,如图5所示:
图5
4.完全比对:返回菜单栏选择“Complete Alignment”标签,此时会弹出输出文件路径的设置窗口,设置Guide Tree File(向导树或指导树文件)、Alignment File(比对文件)的保存位置(存放路径),点击“Align”按钮程序自动开始序列的完全比对,比对所需时间因序列文件大小和长度、计算机性能而异,如图6-8所示:
图6
图7
图8
当主界面的左下状态栏会提示“CLUSTAL-Alignment File created []”时说明比全完毕,这时文件保存位置的目录下会生成生成两个文件,分别是*.aln 和*.dnd,aln是序列比对的文件,可以进一步用于构树系统发育树,dnd是向导树文件(指导树),这两个文件可以用Windows系统中的“记事本”或第三方程序“UltraEdit”等打开,如:
图9 ALN文件
图10 dnd文件
5.后续分析:
1)Clustalx比对生成的结果可读性不是太好,一般需要专业的序列着色软件处理,如Boxshade、ESPript,这两个工具都是在线进行,其中Boxshade图解教程详见本Blog日志。
Boxshade在线网址:.org/software/BOX_form.html
ESPript在线网址:/cgi-bin/ESPript.cgi
2)转换ALN文件,进一步构建系统发育树,转换格式依不同软件而有所不同,如在PHYLIP分析前需要将ALN格式转换为PHY格式方可...
注意事项:
1)dnd是向导树文件,可以用TreeViews软件查看树图。
注意:向导树不是系统发育树,两者区别敬请关注近期-系统发育分析专题。
2)多重比对文件推荐要求为规范的FASTA格式,文件扩展名不限,格式大致如下:引用:
>RGDV_BAA02676 MSRQAWIETSALIECISEYGTKCSFRHLWVIMSFIAVFGRYYTVN
>RGDV_ABC75537 MSRQAWIETSALIECISEYGTKCSFCHLWVIMSFIAVFGRYYTVN
>RGDV_AAO64253 MSRQAWIETSALIERISEYGTKCSFRHLWVIMSFIAVFGRYYTVN
>RGDV_AAY14576
常见问题:
正在整理中,欢迎大家将使用过程存在的问题在此提出,以便于解答...。
多序列比对软件Clustalw使用方法
多序列比对软件Clustalw使用方法2011年06月23日星期四 16:44Clustal的基本思想是基于相似序列通常具有进化相关性这一假设。
比对过程中,先对所有的序列进行两两比对并计算它们的相似性分数值,然后根据相似性分数值将它们分成若干组,并在每组之间进行比对,计算相似性分数值。
根据相似性分数值继续分组比对,直到得到最终比对结果。
比对过程中,相似性程度较高的序列先进行比对,而距离较远的序列添加在后面。
作为程序的一部分,Clusal可以输出用于构建进化树的数据。
Clustal程序有许多版本,ClustalW(Thompson等,1994),根据对亲缘关系较近的序列间空位情况,确定如何在亲缘关系较远的序列之间插入空位。
同样,相似性较高的序列比对结果中的残基突变信息,可用于改变某个特殊位置空位罚分值的大小,推测该位点的序列变异性。
ClustalW是一种渐进的多序列比对方法,先将多个序列两两比对构建距离矩阵,反应序列之间两两关系;然后根据距离矩阵计算产生系统进化指导树,对关系密切的序列进行加权;然后从最紧密的两条序列开始,逐步引入临近的序列并不断重新构建比对,直到所有序列都被加入为止。
ClustalX是CLUSTAL多重序列比对程序的Windows版本。
Clustal X为进行多重序列和轮廓比对和分析结果提供一个整体的环境。
软件下载地址:使用步骤如下:Step 1: 软件初始化界面Step 2:选择1 进入如下界面Step 3:输入序列名1Seq_650_300.txt.txt 进入如下界面Step 4:选择2 进入如下界面Step 5:选择9 进入如下界面Step 6:选择1 进入如下界面Step 7:选择4 进入如下界面Step 8:选择0 进入如下界面Step 9:直接按Enter键后进入如下界面Step 10:输入X键后进入如下界面Step 11:输入H键后进入如下界面Step 12:输入X键后进入如下界面Step 13:输入X键后进入如下界面Step 14:再次输入X键后退出界面。
多序列比对软件Clustalw使用方法
多序列比对软件Clustalw使用方法2011年06月23日星期四 16:44Clustal的基本思想是基于相似序列通常具有进化相关性这一假设。
比对过程中,先对所有的序列进行两两比对并计算它们的相似性分数值,然后根据相似性分数值将它们分成若干组,并在每组之间进行比对,计算相似性分数值。
根据相似性分数值继续分组比对,直到得到最终比对结果。
比对过程中,相似性程度较高的序列先进行比对,而距离较远的序列添加在后面。
作为程序的一部分,Clusal可以输出用于构建进化树的数据。
Clustal程序有许多版本,ClustalW(Thompson等,1994),根据对亲缘关系较近的序列间空位情况,确定如何在亲缘关系较远的序列之间插入空位。
同样,相似性较高的序列比对结果中的残基突变信息,可用于改变某个特殊位置空位罚分值的大小,推测该位点的序列变异性。
ClustalW是一种渐进的多序列比对方法,先将多个序列两两比对构建距离矩阵,反应序列之间两两关系;然后根据距离矩阵计算产生系统进化指导树,对关系密切的序列进行加权;然后从最紧密的两条序列开始,逐步引入临近的序列并不断重新构建比对,直到所有序列都被加入为止。
ClustalX是CLUSTAL多重序列比对程序的Windows版本。
Clustal X为进行多重序列和轮廓比对和分析结果提供一个整体的环境。
软件下载地址:使用步骤如下:Step 1: 软件初始化界面Step 2:选择1 进入如下界面Step 3:输入序列名1Seq_650_300.txt.txt 进入如下界面Step 4:选择2 进入如下界面Step 5:选择9 进入如下界面Step 6:选择1 进入如下界面Step 7:选择4 进入如下界面Step 8:选择0 进入如下界面Step 9:直接按Enter键后进入如下界面Step 10:输入X键后进入如下界面Step 11:输入H键后进入如下界面Step 12:输入X键后进入如下界面Step 13:输入X键后进入如下界面Step 14:再次输入X键后退出界面。
ClustalX使用方法解读
第一步:输入序列文件。
第二步:设定比对的一些参数。
参数设定窗口。
第三步:开始序列比对。
第四步:比对完成,选择保存结果文件的格式
在线的clustalw分析
1.EBI提供的在线clustalw服务
/clustalw/
2.我们构建的在线clustalw服务
• 使用clustalx程序,对给定的多序列, 选择合适的参数,进行多序列比对,输 出结果文件维phylip格式。 • 相同的文件,使用ebi和我们提供的在线 服务,进行多序列比对。
• 对上述计算机程序比对的结果进行手工 改动(bioedit,seaview),使得多序 列比对结果跟符合要求。
1.同步法 将序列两两比对时的二维动态规划矩 阵扩展到三维矩阵。即用矩阵的维数来 反映比对的序列数目。这种方法的计算 量很大,对于计算机系统的资源要求比 较高,一般只有在进行少数的较短的序 列的比对的时候才会用到这个方法。
自动多序列比对的算法
2.其基本思想就是基于相似序列通常具 有进化相关性的这一假设。
Clustalx的工作界面 (多序列比对模式)
Clustalx的工作界面 (剖面(profile)比对模式)
Clustal的工作原理
Clustal输入多个序列 快速的序列两两比对,计算序列间的 距离,获得一个距离矩阵。 邻接法(NJ)构建一个树(引导树) 根据引导树,渐进比对多个序列。
Clustal的应用
/biopro/clustalw.html
EBI提供
的在线
Clustalw
服务
更为详细的教程
可以在这里得到更多关于clustal的帮助:
trasbg.fr/BioInfo/ClustalX/Top.html
Clustalx 多重序列比对图解教程(图解使用)

Clustalx 多重序列比对图解教程(By Raindy)本帖首发于Raindy'blog,转载请保留作者信息,谢谢!欢迎有写生物学软件专长的战友,加入生信教程写作群:,接头暗号:你所擅长的生物学软件名称软件简介:CLUSTALX-是CLUSTAL多重序列比对程序的Windows版本。
Clustal X为进行多重序列和轮廓比对和分析结果提供一个整体的环境。
序列将显示屏幕的窗口中。
采用多色彩的模式可以在比对中加亮保守区的特征。
窗口上面的下拉菜单可让你选择传统多重比对和轮廓比对需要的所有选项。
主要功能:你可以剪切、粘贴序列以更改比对的顺序;你可以选择序列子集进行比对;你可以选择比对的子排列(Sub-range)进行重新比对并可插入到原始比对中;可执行比对质量分析,低分值片段或异常残基将以高亮显示。
当前版本:1.83PS:如果你是新手或喜欢中文界面,推荐使用本人汉化的Clustalx 1.81版链接地址::ist&ID=7435(请完整复制)应用:Clustalx比对结果是构建系统发育树的前提实例:植物呼肠孤病毒属外层衣壳蛋白P8(AA序列)为例流程:载入序列―>编辑序列―>设置参数―>完全比对―>比对结果1.载入序列:运行ClustalX,主界面窗口如下所图(图1),依次在程序上方的菜单栏选择“File”-“Load Sequence”载入待比对的序列,如图2所示,如果当前已载入序列,此时会提示是否替换现有序列(Replace existing sequences),根据具体情形选择操作。
图1图22.编辑序列:对标尺(Ruler)上方的序列进行编辑操作,主要有Cut sequences(剪切序列)、Paste sequences(粘贴)、Select All sequences(选定所有序列),Clear sequence Selection(清除序列选定)、Search for string(搜索字串)、Remove All gaps(移除序列空位)、Remove Gap-Only Columns(仅移除选定序列的空位)图33.参数设置:可以根据分析要求设置相对的比对参数。
MAFFT多重序列比对图解教程
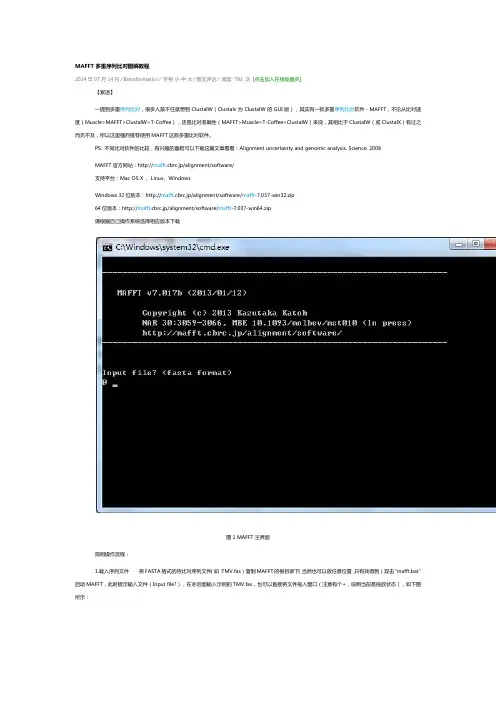
MAFFT多重序列比对图解教程2014年07月14日⁄ Bioinformatics ⁄字号小中大⁄暂无评论⁄阅读793 次[点击加入在线收藏夹]【絮语】一提到多重序列比对,很多人禁不住就想到ClustalW(Clustalx为ClustalW的GUI版),其实有一款多重序列比对软件-MAFFT,不论从比对速度(Muscle>MAFFT>ClustalW>T-Coffee),还是比对准确性(MAFFT>Muscle>T-Coffee>ClustalW)来说,其相比于ClustalW(或ClustalX)有过之而无不及,所以这里强烈推荐使用MAFFT这款多重比对软件。
PS: 不同比对软件的比较,有兴趣的童鞋可以下载这篇文章看看:Alignment uncertainty and genomic analysis. Science, 2008MAFFT官方网站:http://mafft.cbrc.jp/alignment/software/支持平台:Mac OS X 、Linux、WindowsWindows 32位版本:http://mafft.cbrc.jp/alignment/software/mafft-7.037-win32.zip64位版本:http://mafft.cbrc.jp/alignment/software/mafft-7.037-win64.zip请根据自己操作系统选择相应版本下载图1 MAFFT主界面简明操作流程:1.载入序列文件将FASTA格式的待比对序列文件(如:TMV.fas)复制MAFFT的根目录下(当然也可以放任意位置,只有找得到),双击“mafft.bat”启动MAFFT,此时提示输入文件(Input file?),在@后面输入示例的TMV.fas,也可以直接将文件拖入窗口(注意有个+,说明当前是拖放状态),如下图所示:加载后回车,当显示“OK”时说明载入文件成功。
生物信息学 实验四 用 Clustal, MUSLCE 和 T-Coffee 进行多条序列比对

实验四用Clustal, MUSLCE 和T-Coffee 进行多条序列比对准备工作FASTA序列“>”之后加上物种和序列名称,然后加空位,方便在多序列比对过程中分清每条序列分别来自哪个物种。
1 clustalX将上述序列文件用英文命名,且其中无空格,在D盘下建立一个用英文命名的文件夹并将序列文件放在其中。
点击开始->程序->clustalX2->clustalX2。
点主菜单File->Load Sequence-选择你刚保存的序列文件,点打开设置两条序列、多序列比对及输出格式参数后:Alignment->Alignment Parameters->Pairwise Alignment Parameters;Alilgnment->Alignment Parameters ->Multiple Alignment Parameters;Alignment->Output Format Options1.1常规比对点击Aliglnment->Do Complete Alignment。
此时出现一个对话框,提示比对结果保存的位置,在上一步选择了多少种输出格式,这里就会给出多少个文件的路径。
点OK 即可。
比对结束后生成的aln文件是多条序列比对的结果,推荐用notepad++打开浏览。
*对应的是完全匹配的列,保守替换(理化性质高度相似氨基酸之间的替换)用:表示,有一定保守的替换用.表示,如果下方没有标识,说明这列为非保守替换。
生成的dnd文件是比对过程中利用NJ方法生成的进化树(guide tree),可以用Figtree软件浏览。
1.2、迭代比对选择Alignment->iteration->iterate each alignment step(或iterate final alignment),然后再点击Aliglnment->Do Complete Alignment进行比对。
【软件使用】clustalX2使用以及相关的问题
【软件使⽤】clustalX2使⽤以及相关的问题Clustalx的操作第⼀步:输⼊序列⽂件。
第⼆步:设定⽐对的⼀些参数。
参数设定窗⼝。
第三步:开始序列⽐对。
第四步:⽐对完成,选择保存结果⽂件的格式相关问题CLUSTALX-是CLUSTAL多重序列⽐对程序的Windows版本。
Clustal X为进⾏多重序列和轮廓⽐对和分析结果提供⼀个整体的环境。
这⾥总结⼀下在使⽤做序列⽐对过程中⼀些常见的问题~1,从⽹上看来说CLUSTALX软件使⽤的时候,开始要输⼊FASTA格式准备的DNA序列test.seq⽂件。
请问这种⽂件怎么⽣成啊?记事本?其实没有规定的⽂件名,不⼀定是叫test.seq,任何你想要的都可以,除了中⽂名(下⾯会说明)。
主要⾥⾯的内容是正确的格式就⾏了~。
Clustal⽀持的格式有多种,如NBRF/PIR, EMBL/SWISSPROT, Pearson (Fasta), Clustal (*.aln), GCG/MSF (Pileup), GCG9/RSF and GDE 等2,什么使⽤时,总是导⼊不了序列,出现 ERROR:Can not open output file??这个问题挺多⼈碰到过的~这是因为你导⼊的⽂件的路径包含有中⽂名。
把⽂件放在其它地⽅看看。
最好路径也不要有空格了。
当然前提是你的格式要正确了。
这个问题同样适⽤于ClustalW或其它dos类的软件3,ClustalX⽐对后的结果中.aln⽂件是什么?这个是序列⽐对结果的⽂件。
关于这部分,你可以看4,ClustalX⽐对后的结果中.dnd⽂件是什么?。
Clustal多重序列比对图解教程图解使用
C l u s t a l x多重序列比对图解教程(B y R a i n d y) 本帖首发于Raindy'blog软件简介:CLUSTALX-是CLUSTAL多重序列比对程序的Windows版本。
ClustalX为进行多重序列和轮廓比对和分析结果提供一个整体的环境。
序列将显示屏幕的窗口中。
采用多色彩的模式可以在比对中加亮保守区的特征。
窗口上面的下拉菜单可让你选择传统多重比对和轮廓比对需要的所有选项。
主要功能:你可以剪切、粘贴序列以更改比对的顺序;你可以选择序列子集进行比对;你可以选择比对的子排列(Sub-range)进行重新比对并可插入到原始比对中;可执行比对质量分析,低分值片段或异常残基将以高亮显示。
当前版本:1.83PS:如果你是新手或喜欢中文界面,推荐使用本人汉化的Clustalx1.81版链接地址:ist&ID=7435(请完整复制)应用:Clustalx比对结果是构建系统发育树的前提实例:植物呼肠孤病毒属外层衣壳蛋白P8(AA序列)为例流程:载入序列―>编辑序列―>设置参数―>完全比对―>比对结果1.载入序列:运行ClustalX,主界面窗口如下所图(图1),依次在程序上方的菜单栏选择“File”-“LoadSequence”载入待比对的序列,如图2所示,如果当前已载入序列,此时会提示是否替换现有序列(Replaceexistingsequences),根据具体情形选择操作。
图1图22.编辑序列:对标尺(Ruler)上方的序列进行编辑操作,主要有Cutsequences(剪切序列)、Pastesequences(粘贴)、SelectAllsequences(选定所有序列),ClearsequenceSelection(清除序列选定)、Searchforstring(搜索字串)、RemoveAllgaps(移除序列空位)、RemoveGap-OnlyColumns(仅移除选定序列的空位)图33.参数设置:可以根据分析要求设置相对的比对参数。
多重比较excel的做法
上节对一组试验数据通过平方和与自由度分解,将所估计的处理均方与误差均方作比较,由F测验推论处理间有显著差异。
但我们并不清楚那些处理间存在差异,故需要进一步做处理平均数间的比较。
一个试验中k个处理平均数间可能有k(k-1)/2个比较,因而这种比较是复式比较亦称为多重比较(multiple comparisons)。
多重比较有多种方法,本节将介绍常用的三种:最小显著差数法(LSD法)、复极差法(q法)和Duncan氏新复极差法(SSR法)。
【最小显著差数法(LSD法)、复极差法(q法)和Duncan氏新复极差法(SSR法)本质上都属于t检验法。
因此,使用这三种方法必须满足方差齐性。
因为使用T检验是有条件的,其中之一就是要符合方差齐次性,这点需要F检验来验证。
方差齐次性检验(Homogeneity-of-variance)结果,从显著性慨率:各组方差无差异),c说明各组的方差在看,p>0.05,接受零假设(零假设Ha=0.05水平上没有显著性差异,即方差具有齐次性。
这个结论在选择多重比较方法时作为一个条件(方差齐次时有齐次时的多重比较法,非齐次时有非齐次时的多重比较法)。
比较计算所得F值与某显著水平(如0.05)下F值,可得处理间差异是否显著。
若处理间差异显著,则需进一步比较哪些处理间差异是显著的。
也就是只有在方差分析中F检验存在差异显著性时,才有比较(多重比较)的统计意义。
进行方差分析时需要满足独立样本、方差齐性、正态分布等条件,如果方差不具备齐性(F检验),可首先进行数据转换,如通过对数变换、平方根变换、倒数变换、平方根反正弦变换等方法变换后再进行方差齐性检验,若还不行只能进行非参数检验。
】7.2.1 最小显著差数法最小显著差数法(least significant difference,简称LSD法),LSD 法实质上是t测验。
其程序是:在处理间的F测验为显著的前提下,计算出显著水平为α的最小显著差数;任何两个平均数的差数如其绝对值≥,即为在α水平上显著;反之则为不显著。
多序列比对程序及使用技巧
多序列比对程序及使用技巧序列比对是生物信息学中非常重要的一个分析任务,它用于检测不同序列之间的相似度和差异性,帮助我们理解生物序列的功能和演化关系。
多序列比对是在序列比对的基础上进行的,用于比对多个序列。
1. ClustalW/X: ClustalW是最早的多序列比对程序之一,它使用一种基于多重比对的算法,可以处理小到中等规模的序列集。
ClustalX是ClustalW的GUI版本,提供更方便的操作界面。
2.MAFFT:MAFFT是一种快速且准确的多序列比对工具,它采用迭代策略和反向比对来提高比对质量。
它适用于大规模序列集的比对,可以处理成千上万条序列。
3. Muscle: Muscle是一种高性能的多序列比对程序,具有较高的比对准确性和计算效率。
它采用迭代和分支定界的方法,根据序列间的局部区域相似性进行比对。
4. T-Coffee: T-Coffee是一种将多个局部比对结果组合成一体的多序列比对程序。
它使用模板比对的方法,将不同序列的局部对齐结果组合成全局比对。
1. 选择适当的比对程序:根据序列的规模和所需的比对准确性,选择适合的比对程序。
小规模序列集可以使用ClustalW/X或MAFFT,而大规模序列集则可以选择MAFFT或Muscle。
2.调整比对参数:根据实际需求,对比对参数进行调整。
例如,可以调整比对阈值、比对算法、迭代次数等参数,以优化比对结果。
3. 检查比对质量:比对结果可以通过多种方式进行检查,例如可视化比对结果、评估比对一致性或使用其他评估指标(例如Gap比例、Kappa统计量等)进行质量评估。
4.处理大规模序列集:对于大规模序列集,可以考虑使用并行化技术或分割序列集进行比对,以提高比对效率和准确性。
5.结果解读和分析:根据比对结果,进行序列功能、结构和演化等方面的分析。
可以使用其他生物信息学工具进行进一步的分析,如序列聚类、进化树构建等。
总结:多序列比对是生物信息学中常用的分析任务,采用合适的比对程序和技巧可以获得准确且高效的比对结果。