
oracle rollup用法
oracle rollup用法
Oracle Rollup语法是一种用于SQL查询的高级特性,能够在对数据进行聚合计算时,对多个维度进行交叉分组操作。在SQL中,使用Rollup函数可以将多列分别聚合,实现多维度统计。本文将详细介绍Oracle Rollup语法的用法,包括语法、示例以及注意事项等方面。
一、Rollup语法
Oracle Rollup函数的语法如下所示:
SELECT column_name(s), aggregate_function(column_name)
FROM table_name
WHERE condition
GROUP BY column_name(s) WITH ROLLUP;
SELECT语句用于查询需要聚合的列和对应的聚合函数,FROM语句用于指定数据源表,WHERE语句用于指定查询条件,GROUP BY语句用于指定需要分组的列,WITH ROLLUP则表示需要对指定的列进行Rollup操作。
我们有如下一张销售数据记录表Sales:
| Product | Region | Year | Sales |
| ------ | ------ | ---- | ----- |
| A | East | 2020 | 100 |
| A | East | 2021 | 200 |
| A | West | 2020 | 150 |
| A | West | 2021 | 250 |
| B | East | 2020 | 300 |
| B | East | 2021 | 400 |
| B | West | 2020 | 350 |
| B | West | 2021 | 450 | 我们希望对该表进行按Product、Region、Year进行分组统计,计算Sales的总和。使用Rollup函数的语句如下:
SELECT Product, Region, Year, SUM(Sales) AS TotalSales
FROM Sales
GROUP BY Product, Region, Year WITH ROLLUP;
执行该语句后,输出的结果如下:
| Product | Region | Year | TotalSales |
| ------ | ------ | ---- | --------- |
| A | East | 2020 | 100 |
| A | East | 2021 | 200 |
| A | East | NULL | 300 |
| A | West | 2020 | 150 |
| A | West | 2021 | 250 |
| A | West | NULL | 400 |
| A | NULL | NULL | 700 |
| B | East | 2020 | 300 |
| B | East | 2021 | 400 |
| B | East | NULL | 700 |
| B | West | 2020 | 350 |
| B | West | 2021 | 450 |
| B | West | NULL | 800 |
| B | NULL | NULL | 1500 |
| NULL | NULL | NULL | 2200 |
从结果中可以看出,Rollup函数实现了对Product、Region、Year三个维度的多层次分组统计,同时还计算了多级合计信息。对于每个维度,NULL表示了该维度的总和。 二、Rollup示例
Rollup函数在实际应用中非常常用,下面我们将使用多个示例来演示该函数的用法。
1. 汇总统计
假设我们有一个员工销售数据记录表employee_sales,其中包括员工ID,销售日期,销售额等信息。我们需要对该表按照员工ID、销售日期进行分组统计销售额,并显示对应的总和。
使用Rollup函数的SQL语句如下:
SELECT employee_id, sale_date, SUM(sale_amount)
FROM employee_sales
GROUP BY employee_id, sale_date WITH ROLLUP;
执行以上语句后,将得到按照员工ID、销售日期进行分组统计销售额的结果,并且在每个分组的最后加上了对应的总和。
2. 平均数统计
使用Rollup函数还可以实现对某一列数据的平均数进行分组统计,并显示对应的平均值。
我们有一个学生分数记录表student_scores,其中包含学生ID、科目、成绩等信息。我们需要对该表按照学生ID、科目进行分组统计平均成绩,并显示对应的平均值。
使用Rollup函数的SQL语句如下:
SELECT student_id, subject, AVG(score)
FROM student_scores
GROUP BY student_id, subject WITH ROLLUP;
执行以上语句后,将得到按照学生ID、科目进行分组统计平均成绩的结果,并且在每个分组的最后加上了对应的平均值。
3. 求和、平均数等函数的组合使用
在实际开发中,我们可能会需要对某些列数据同时进行汇总、平均数、最大值、最小值等多种函数的统计分析,Rollup函数也可以帮助我们轻松实现这些需求。 我们有一个销售记录表sales,其中包含销售日期、销售额、成本、利润等信息。我们需要对该表按照销售日期进行分组统计销售额、成本、利润及其对应的平均值,并显示对应的平均值。
使用Rollup函数的SQL语句如下:
SELECT sale_date, SUM(sale_amount) AS TotalSales, SUM(cost) AS TotalCosts,
SUM(profit) AS TotalProfits, AVG(sale_amount) AS AvgSales, AVG(cost) AS AvgCosts,
AVG(profit) AS AvgProfits
FROM sales
GROUP BY sale_date WITH ROLLUP;
执行以上语句后,将得到针对销售金额、成本、利润和平均数的多个函数进行的分组统计结果,并且在每个分组的最后加上了对应的汇总信息及平均值。
三、注意事项
在使用Rollup函数进行多维度分组统计时,需要注意以下几点:
1. Rollup函数会在每个分组的最后加上对应的汇总信息,因此在使用时需要根据具体需求进行选择。
2. Rollup函数不支持对所有列进行多维度分组,因为这可能会导致分组数量成倍增加,从而影响查询效率。
3. 在使用Rollup函数时,需要注意掌握相关聚合函数的用法,例如SUM、AVG、MAX、MIN等。
4. 在多个维度进行分组统计时,需要注意分组列的顺序,因为顺序不同会影响结果。
5. 在进行Rollup操作时,注意按维度顺序排列,否则可能会得到不符合预期的结果。
Rollup函数是SQL查询中非常实用的特性,它可以帮助我们实现多维度分组统计、汇总、平均数等复杂统计需求,大大提高了数据分析的效率。
Oracle Exists用法

Oracle Exists用法
一) 用Oracle Exists替换DISTINCT:
当提交一个包含一对多表信息(比如部门表和雇员表)的查询时,避免在SELECT子句中使用DISTINCT。一般能够考虑用Oracle EXIST替换,Oracle Exists使查询更为迅速,因为RDBMS核心模块将在子查询的条件一旦满足后,立即返回结果。
例子:
SELECT DISTINCT DEPT_NO,DEPT_NAME FROM DEPT D,EMP E WHERE D.DEPT_NO =
E.DEPT_NO;
SELECT DEPT_NO,DEPT_NAME FROM DEPT D WHERE Exists (SELECT ‘X' FROM EMP E
WHERE E.DEPT_NO = D.DEPT_NO);
二)exists和in的效率问题:
使用EXISTS,Oracle会首先检查主查询,然后运行子查询直到它找到第一个匹配项,这就节省了时间。Oracle在执行IN子查询时,首先执行 子查询,并将获得的结果列表存放在一个加了索引的临时表中。在执行子查询之前,系统先将主查询挂起,待子查询执行完毕,存放在临时表中以后再执行主查询。 这也就是使用EXISTS比使用IN通常查询速度快的原因。
1) select * from T1 where exists(select 1 from T2 where T1.a=T2.a) ;
2) select * from T1 where T1.a in (select T2.a from T2) ;
T1数据量小而T2数据量非常大时,T1<
T1数据量非常大而T2数据量小时,T1>>T2 时,2) 的查询效率高。
1)Select name from employee where name not in (select name from student);
oracle return into 用法
oracle return into 用法
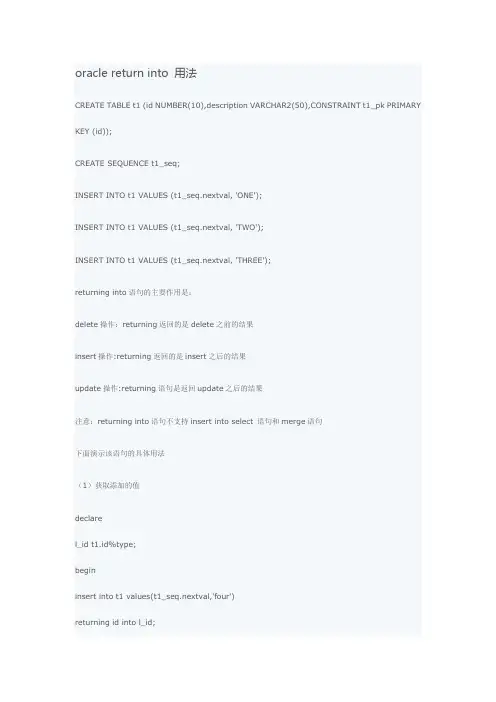
CREATE TABLE t1 (id NUMBER(10),description VARCHAR2(50),CONSTRAINT t1_pk PRIMARY
KEY (id));
CREATE SEQUENCE t1_seq;
INSERT INTO t1 VALUES (t1_seq.nextval, 'ONE');
INSERT INTO t1 VALUES (t1_seq.nextval, 'TWO');
INSERT INTO t1 VALUES (t1_seq.nextval, 'THREE');
returning into语句的主要作用是:
delete操作:returning返回的是delete之前的结果
insert操作:returning返回的是insert之后的结果
update操作:returning语句是返回update之后的结果
注意:returning into语句不支持insert into select 语句和merge语句
下面演示该语句的具体用法
(1)获取添加的值
declare
l_id t1.id%type;
begin
insert into t1 values(t1_seq.nextval,'four')
returning id into l_id; commit;
dbms_output.put_line('id='||l_id);
end
运行结果 id=4
(2)更新和删除
1 DECLARE l_id t1.id%TYPE;
2 BEGIN
3 UPDATE t1
4 SET description = 'two2'
5 WHERE ID=2
6 RETURNING id INTO l_id;
7 DBMS_OUTPUT.put_line('UPDATE ID=' || l_id);
8 DELETE FROM t1 WHERE description = 'THREE'
Oracle分析函数的使用(主要是rollup用法)

Oracle分析函数的使⽤(主要是rollup⽤法)
分析函数是oracle 8.1.6中就引⼊的⼀个全新的概念,为我们分析数据提供了⼀种简单⾼效的处理⽅式.在分析函数出现以前,我们必须使⽤⾃联查询,⼦查询或者内联视图,甚⾄复杂的存储过程实现的语句,现在只要⼀条简单的sql语句就可以实现了,⽽且在执⾏效率⽅⾯也有相当⼤的提⾼.
分析函数的使⽤⽅法1. ⾃动汇总函数rollup,cube,2. rank 函数, rank,dense_rank,row_number3. lag,lead函数4. sum,avg,的移动增加,移动平均数5. ratio_to_report报表处理函数6. first,last取基数的分析函数
本⼈在项⽬中由于⽤到⼩计、合计的统计,前⾯想到⽤union all,但这样有点⿇烦并且效率也不⾼,就从⽹上查到资料说是oracle 8i、oracl 9i、oracle 10g 中已经分析函数对数据统计的处理,于是就顺便学习了⼀下这些函数的⽤法,拿出来分享给⼤家共同学习。
1、Oracle ROLLUP和CUBE ⽤法 Oracle的GROUP BY语句除了最基本的语法外,还⽀持ROLLUP和CUBE语句。如果是Group by ROLLUP(A, B, C)的话,⾸先会对(A、B、C)进⾏GROUP BY,然后对(A、B)进⾏GROUP BY,然后是(A)进⾏GROUP BY,最后对全表进⾏GROUP BY操作。
如果是GROUP BY CUBE(A, B, C),则⾸先会对(A、B、C)进⾏GROUP BY,然后依次是(A、B),(A、C),(A),(B、C),(B),(C),最后对全表进⾏GROUP BY操作。 grouping_id()可以美化效果。除了使⽤GROUPING函数,还可以使⽤GROUPING_ID来标识GROUP BY的结果。
也可以 Group by Rollup(A,(B,C)) ,Group by A Rollup(B,C),…… 这样任意按⾃⼰想要的形式结合统计数据,⾮常⽅便。
SQL中ROLLUP用法

SQL中ROLLUP⽤法
ROLLUP 运算符⽣成的结果集类似于 CUBE 运算符⽣成的结果集。
下⾯是 CUBE 和 ROLLUP 之间的具体区别:
CUBE ⽣成的结果集显⽰了所选列中值的所有组合的聚合。
ROLLUP ⽣成的结果集显⽰了所选列中值的某⼀层次结构的聚合。
ROLLUP 优点:
(1)ROLLUP 返回单个结果集,⽽ COMPUTE BY 返回多个结果集,⽽多个结果集会增加应⽤程序代码的复杂性。
(2)ROLLUP 可以在服务器游标中使⽤,⽽ COMPUTE BY 则不可以。
(3)有时,查询优化器为 ROLLUP ⽣成的执⾏计划⽐为 COMPUTE BY ⽣成的更为⾼效。
下⾯对⽐⼀下GROUP BY 、CUBE 和 ROLLUP后的结果
创建表:
CREATE TABLE DEPART (部门 char(10),员⼯ char(6),⼯资 int)
INSERT INTO DEPART SELECT 'A','ZHANG',100 INSERT INTO DEPART SELECT 'A','LI',200 INSERT INTO DEPART SELECT
'A','WANG',300 INSERT INTO DEPART SELECT 'A','ZHAO',400 INSERT INTO DEPART SELECT 'A','DUAN',500 INSERT INTO
DEPART SELECT 'B','DUAN',600 INSERT INTO DEPART SELECT 'B','DUAN',700
部门 员⼯ ⼯资
A ZHANG 100 A LI 200
A WANG 300 A ZHAO 400
A DUAN 500 B DUAN 600
B DUAN 700
(1)GROUP BY
SELECT 部门,员⼯,SUM(⼯资)AS TOTAL FROM DEPART GROUP BY 部门,员⼯
Oracle分组ROLLUP、GROUP BY、GROUPING、GROUPING SETS区别和作用+++

Oracle分组ROLLUP、GROUP BY、GROUPING、GROUPING SETS区别和作用
1.ROLLUP
ROLLUP的作用相当于
SQL> set autotrace on
SQL> select department_id,job_id,count(*)
2
from employees
3
group by department_id,job_id
4
union
5
select department_id,null,count(*)
6
from employees
7
group by department_id
8
union
9
select null,null,count(*)
10 from employees;
最后面的SA_REP表示此jobid没有部门,为null
这里的union系统默认进行了排序
使用ROLLUP能达到上面GROUP BY的功能,但性能开销更小
SQL> ed
已写入
file afiedt.buf
1
select department_id,job_id,count(*)
2
from employees
3* group by rollup (department_id,job_id)
SQL> /
2.为什么ROLLUP会比GROUP BY性能好
ROLLUP(a,b,c)=a,b,c+a,b+a+All
通过一次全表扫描,得出a,b,c的分组统计信息后;分组统计a,b 相同,c不同的项即可得到a,b;依此类推……,就不用去多次全表扫描
3.ROLLUP的另类用法ROLLUP(a,(b,c))
ROLLUP((a,b))
SQL> ed
已写入 file afiedt.buf
1 select department_id,job_id,count(*)
oracle中的mergeinto用法解析
oracle中的mergeinto⽤法解析
oracle中的merge into⽤法解析
merge into的形式
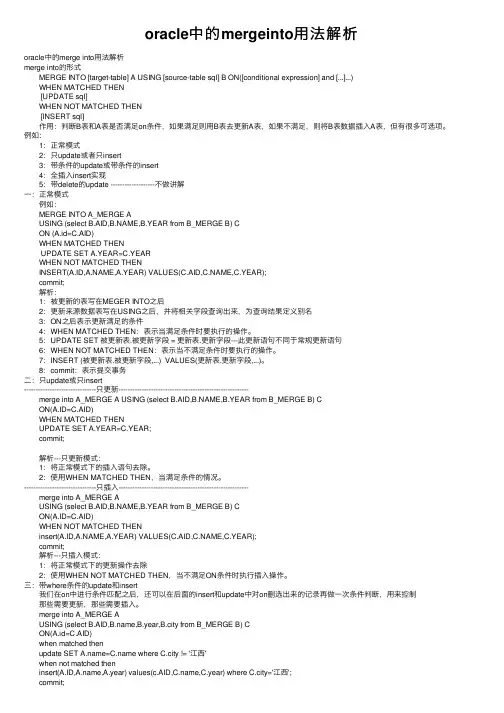
MERGE INTO [target-table] A USING [source-table sql] B ON([conditional expression] and [...]...)
WHEN MATCHED THEN
[UPDATE sql]
WHEN NOT MATCHED THEN [INSERT sql]
作⽤:判断B表和A表是否满⾜on条件,如果满⾜则⽤B表去更新A表,如果不满⾜,则将B表数据插⼊A表,但有很多可选项。
例如:
1:正常模式
2:只update或者只insert
3:带条件的update或带条件的insert
4:全插⼊insert实现
5:带delete的update -------------------不做讲解
⼀:正常模式
例如:
MERGE INTO A_MERGE A
USING (select B.AID,,B.YEAR from B_MERGE B) C
ON (A.id=C.AID)
WHEN MATCHED THEN UPDATE SET A.YEAR=C.YEAR
WHEN NOT MATCHED THEN
INSERT(A.ID,,A.YEAR) VALUES(C.AID,,C.YEAR);
commit;
解析:
1:被更新的表写在MEGER INTO之后
2:更新来源数据表写在USING之后,并将相关字段查询出来,为查询结果定义别名
3:ON之后表⽰更新满⾜的条件
4:WHEN MATCHED THEN:表⽰当满⾜条件时要执⾏的操作。
5:UPDATE SET 被更新表.被更新字段 = 更新表.更新字段---此更新语句不同于常规更新语句
6:WHEN NOT MATCHED THEN:表⽰当不满⾜条件时要执⾏的操作。
ORACLE SQL LOADER用法(excel导入oracle)
心之所向,所向披靡
SQL*LOADER是ORACLE的数据加载工具,通常用来将操作系统文件迁移到ORACLE数据库中。SQL*LOADER是大型数据仓库选择使用的加载方法,因为它提供了最快速的途径(DIRECT,PARALLEL)。
首先,我们认识一下SQL*LOADER。
在windows下,SQL*LOADER的命令为SQLLDR,在UNIX下一般为sqlldr/sqlload。
如执行:
c:\sqlldr
SQL*Loader: Release 8.1.6.0.0 - Production on 星期二 1月 8 11:06:42 2002
(c) Copyright 1999 Oracle Corporation. All rights reserved.
用法: SQLLOAD 关键字 = 值 [,keyword=value,...]
有效的关键字:
userid -- ORACLE username/password
control -- Control file name
log -- Log file name
bad -- Bad file name
data -- Data file name
discard -- Discard file name
discardmax -- Number of discards to allow (全部默认)
skip -- Number of logical records to skip (默认0)
load -- Number of logical records to load (全部默认)
errors -- Number of errors to allow (默认50)
oracle基本用法
oracle基本⽤法
作为企业版的后台数据⽀撑,就⾸先要掌握oracle的使⽤⽅法
注册⽤户之前,需要使⽤system管理员来进⾏注册功能1.⾸先创建新⽤户
2.这样就能使创建的新⽤户能够登陆吗?不,还需要分配权限这样我们就能使⽤新的⽤户名来登陆了,我们来检索⼀下该⽤户下的表数据
⼆.使⽤MyEcplicse连接oracle
步骤⼀:window->show view->other->在⽂本框输⼊db,选择dbBrower。页⾯如下:
右键新建,配置如下
完成
三.使⽤控制台连接oracle数据库,sqlplus密令
这样就可以在cmd控制台中查看oracle中的数据了
四。锁定⽤户名和解锁⽤户名
锁定⽤户名如下:取消锁定如下:
五:如何修改⽤户密码(使⽤cmd控制台)
密令⾏:.alter user system identified by 新密码;
Oracle Level的用法
Oracle树查询level的用法
首先创建
一张表menu记录菜单的层级情况。
表结构如下:menu_idnumber,
parent_idnumber,
menu_namenvarchar2(20)
插入数据:insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(1,null,'AAAA');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(2,1,'BBBB');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(3,1,'CCCC');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(4,1,'DDDD');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(5,2,'EEEE');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(6,2,'FFFF');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(7,2,'GGGG');
insertintoMENU(MENU_ID,PARENT_ID,MENU_NAME)
values(8,3,'HHHH');
commit;
查询语句:selectrpad('',(level-1)*3)||menu_namefrommenu
connectbyparent_id=priormenu_id
startwithparent_idisnull
connectby子句定义表中的各个黄是如何相互联系的
startwith子句定义数据黄查询的初始起点
level表示查询深度
===================================oracleLPAD和RPAD收藏
oracle Rollup 和 Cube用法
oracle Rollup 和 Cube用法
Oracle的GROUP BY语句除了最基本的语法外,还支持ROLLUP和CUBE语句。
如果是ROLLUP(A, B, C)的话,首先会对(A、B、C)进行GROUP BY,然后对(A、B)进行GROUP BY,然后是(A)进行GROUP BY,最后对全表进行GROUP BY操作。
如果是GROUP BY CUBE(A, B, C),则首先会对(A、B、C)进行GROUP BY,然后依次是(A、B),(A、C),(A),(B、C),(B),(C),最后对全表进行GROUP BY操作。
grouping_id()可以美化效果:
Oracle的GROUP BY语句除了最基本的语法外,还支持ROLLUP和CUBE语句。
除本文内容外,你还可参考:
分析函数参考手册: /post/419/33028
分析函数使用例子介绍:/post/419/44634
SQL> create table t as select * from dba_indexes;
表已创建。
SQL> select index_type, status, count(*) from t group by index_type, status;
INDEX_TYPE STATUS COUNT(*)
--------------------------- -------- ----------
LOB VALID 51
NORMAL N/A 25
NORMAL VALID 479
CLUSTER VALID 11
下面来看看ROLLUP和CUBE语句的执行结果。
SQL> select index_type, status, count(*) from t group by rollup(index_type, status);
INDEX_TYPE STATUS COUNT(*)