
SPSS之三
3、Width(变量长度):系统默认为8字符, 实际根据变量名和变量值较大者定义。 4、Decimals(小数位数):系统默认为2位 5、Label(变量名标签):补充说明变量名, 最多可由256个字符组成。 6、Values(变量值标签):简化数据的输入和 处理,如用“1,2”代表“男,女”,“1,2” 就是变量值标签。
SPSS中基本运算有三种: 1、算术表达式 2、关系表达式 3、逻辑表达式
三种运算符号
数学运算符 符号 + * / ** () 意义 加 减 乘 除 幂 括号 符号 < > <= >= = ~= 关系运算符 运算符 LT GT LE GE EQ NT 意义 小于 大于 小于等于 大于等于 等于 不等于 符号 & | ~ 逻辑运算符 运算符 AND OR NOT 意义 逻辑与 逻辑或 逻辑非
10、Measure(数据类型): Scale定距数据,如人的身高、体重等连 续性数据,或者学生人数、课程数等离 散性数据。 Ordinal顺序水准数据,如高、中、低级 职称用1、2、3分别表示,有内在的大小 或高低顺序。 Nominal名义水准数据,如民族用 “汉”、“回”、“满“等表示,只是 一种名义上的指代,并不存在内部固有 的大小或高低顺序。
变量类型: 2、变量类型:系统默认的变量类型为Numeric(标 准数值型),其余有: 准数值型),其余有: ),其余有 Comma:带逗号的数值型, Comma:带逗号的数值型,如,1,234.5 Dot:圆点数值型,如1.234,5 Dot:圆点数值型, 1.234, Notation:科学计数法, Scientific Notation:科学计数法,如 1.23E+3,1.23+3, 1.23E+3,1.23+3,1.23D+3 Dollar:带美元符号数值型, Dollar:带美元符号数值型,如$1,234.5 Currency:自定义数值型(P20) Custom Currency:自定义数值型(P20) Date:日期型,有二十几种格式。 Date:日期型,有二十几种格式。 String:字符型。 字符型。
7、Missing(缺失值定义):指在数据收集过 程中无记录或失真的数据。 对于无记录系统默认为系统缺失值,String 型变量为空格,数值型变量显示一小点。 对于失真数据,用户可以自定义,在分析时 排除在外。 8、Column(变量屏幕显示宽度),默认为8 位 9、Align(数值对齐方式):默认数值型为右 对齐,字符型为左对齐。
逻辑表达式
符号与运算符等价。 &(AND):前后两个量均为真时,逻辑表 达式的值为“真”,否则为“假”。 |(OR):前后两个量只要有一个为“真” 时,逻辑表达式的值就为“真”。只有当两 个量均为假时,逻辑表达式的值才为“假”。
~(NOT):是前置算符,它对后面的量作
出逻辑非运算。即NOT(真)=假
数据输入后就可对其进行编辑工作,如数 据定位、插入和删除一个个案、插入和删 除一个变量等。
SPSS数据定位
插入一个个案
删除一个个案
插入一个变量
删除一个变量
构建新变量 在进行数据的分析处理时,常常需要根据 已经存在的的变量构建新变量。如根据高 数、线代、概率的成绩求平均成绩。
SPSS中的表达式 SPSS中的表达式
算术表达式
1.算术运算符可以连接数值型的常数、变 量和函数构成算术表达式,其运算结果 为数值型常数。 2.运算优先顺序:括号、函数、乘幂、乘 除、加减;同一优先级按照从左到右的 顺序
关系表达式
1. 是比较两个量之间的关系或判断关系是否 成立。如果成立表达式的值为“真”(1), 否则为“假”(0)。 2.比较无论是数值或字符都可以。 3.符号与运算符等价。如:A>5等价于AGT5
Hale Waihona Puke 定义变量1、变量名:不多于8个字符。首字母是英文、 变量名:不多于8个字符。首字母是英文、 中文或符号“ ,其后可为数字、字母、 中文或符号“@”,其后可为数字、字母、汉 和除了“?!* 的符号等, 字、和除了“?!*”的符号等,且不能以 作为最后一个字符。 “_”和“.”作为最后一个字符。 和 作为最后一个字符 英文不区分大小写。 英文不区分大小写。 变量名不能与SPSS的保留字相同, all、 SPSS的保留字相同 变量名不能与SPSS的保留字相同,如all、 and、by等13个保留字 and、by等13个保留字
数据统计分析软件—— 数据统计分析软件—— SPSS
三、数据的输入与编辑
数据输入的方法: 数据输入的方法: 直接在SPSS SPSS的数据编辑窗键入资料 (1)直接在SPSS的数据编辑窗键入资料 EXCEL中导入 (2)从EXCEL中导入 (3)从文本中导入 (4)从其他分析软件及数据库中导入
个学生的高数、 例1、调查 个学生的高数、线代和概率论 、调查10个学生的高数 的成绩,并将数据输入到SPSS文件中。 文件中。 的成绩,并将数据输入到 文件中 定义变量; ( ⅰ )定义变量; 输入数据。 ( ⅱ )输入数据。
注意:
• 逻辑与的运算顺序高于逻辑或。 • 在SPSS中不存在IF…THAN…ELSE,也没 有FOR…NEXT。 • 不能使用5<x<8这类不等式连续表达方 式。
例:如果使用逻辑表达式选择月薪(salary) 在3000-5000元的男性(sex=m),以及月薪 (salary)在2000-4000元的女性(sex=f), 则其IF表达式为: Salary>=3000&salary<5000&sex=m or Salary>=2000&salary<4000&sex=f
SPSS统计分析基础3

散点图示有直线趋势
图示 应变量的残差有随自变量增大而加大的趋 势。故应行加权线性回归。
Model Summabry, c
Model 1
本例中冠心病复发者参加体育锻炼的比例为1020冠心病复发者未参加体育锻炼的比例为1080二者比值为0208025无冠心病复发者参加体育锻炼的比例为62104596无冠心病复发者未参加体育锻炼的比例为42104404二者比值为05960404148参加体育锻炼者冠心病复发的or0251480169结论
Coe fficie na,tbs
UnstandardizeSdtandardized Coefficients Coefficients
Model
B Std. Error
1
(Constan-t.)172 1.051
年龄 40.951 4.808
Beta .949
t -.164 8.517
Sig. .874 .000
1
.813 20.968
Residual .233
6
.039
Total
1.046
7
a.Predictor s : (Constant), 年龄
b.Dependent Variable: 尿肌酐含量(m m ol/24h)
Sig. .004a
Coefficien a ts
UnstandardizS etdandardized CoefficientsCoefficients
决定系数r2
由自变量x解释的部分占y的百分数,例如
spss课程作业三 产品销售额
作业三
打开“产品销售额.sav”,数据是某产品销售额的信息。
1.绘制销售额的时间序列图,
2.判断它的变动趋势。
3.使用时间序列分析方法,通过对比分析建立一个比较好的模型。
4.利用建立的模型对2013年销售额进行预测。
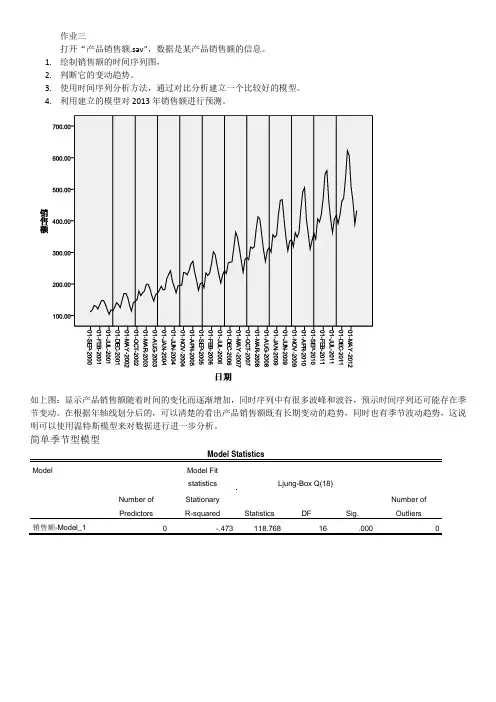
如上图:显示产品销售额随着时间的变化而逐渐增加,同时序列中有很多波峰和波谷,预示时间序列还可能存在季节变动。
在根据年轴线划分后的,可以清楚的看出产品销售额既有长期变动的趋势,同时也有季节波动趋势,这说明可以使用温特斯模型来对数据进行进一步分析。
Winters可加性模型
Winter相乘性模型
由于已知销售额具有季节波动趋势和长期波动趋势,又上述的个个模型的的R值的大小的对比可得,Winter相乘性模型是满足上述要求的最好模型。
由Winter相乘性模型预测得2013年销售额为450。
SPSS知识3 t检验(两个总体均数比较)

t检验前言:一、t检验有3种:单样本t检验、配对样本t检验、两组独立样本t检验。
二、t检验条件:数据资料服从正态或近似正态分布。
两组独立样本t检验还要求两组方差齐(不齐则要进行校正)。
正文:一、单样本t检验理论:单样本t检验是检验样本均数X和总体均数μ【已知的理论值(如脉搏72)、标准值或公认值】的比较。
T=(样本均数-总体均数)/样本均数的标准误Spss操作:前提:建立数据库(一列变量)第一步:正态性检验Analyze→Npar tests→1-sample K-S→数据调入右框(test variable list),选中Test Distribution中的normal→OK。
第二步:看output,判断数据资料正态性与否。
看统计量Z 和P值。
P>0.05,资料正态分布。
第三步:t检验。
正态性,则进行样本均数与总体均数的比较,即单样本t检验。
Analyze→compare means→one-sample T test→将数据调入右框(test variable),在右框下的Test Value右边框中输入总体均数μ→OK第四步:看output中的P值,判断差异是否有统计学意义。
P>0.05,差异无统计学意义。
二、配对样本t检验理论:配对设计有3种情况:1、同一样本分为2份,用2种不同的方法测定;2、自身比较,同一样本处理前后的比较(处理前后的过程中,应保持其他非处理因素的齐同性,并且处理周期不宜太长;3、将某些因素相同的样本组成配伍组,随即分为两组。
T=每一配对的测量值之差的均数/每一配对的测量值之差的均数的标准误。
(各自公式见理论)Spss操作:前提:建立数据库(两列:如before和after)第一步:两组数据做正态性检验Analyze→Npar tests→1-sample K-S→两组数据皆调入右框(test variable list),选中Test Distribution中的normal →OK。
spss课程作业三 产品销售额
作业三
打开“产品销售额.sav”,数据是某产品销售额的信息。
1.绘制销售额的时间序列图,
2.判断它的变动趋势。
3.使用时间序列分析方法,通过对比分析建立一个比较好的模型。
4.利用建立的模型对2013年销售额进行预测。
如上图:显示产品销售额随着时间的变化而逐渐增加,同时序列中有很多波峰和波谷,预示时间序列还可能存在季节变动。
在根据年轴线划分后的,可以清楚的看出产品销售额既有长期变动的趋势,同时也有季节波动趋势,这说明可以使用温特斯模型来对数据进行进一步分析。
Winters可加性模型
Winter相乘性模型
由于已知销售额具有季节波动趋势和长期波动趋势,又上述的个个模型的的R值的大小的对比可得,Winter相乘性模型是满足上述要求的最好模型。
由Winter相乘性模型预测得2013年销售额为450。
统计软件spss操作3_常用假设检验与相关分析

例:
二、连续变量的统计推断:t-检验
例: 以张文彤《SPSS统计分析基础教程》261页 案例数据做配对检验。(文件:配对样本t检 验(治疗前后舒张压拘束比较:张文彤261页 案例).sps)
二、连续变量的统计推断:t-检验
结果解读: 输出结果中”均值“”标准差“”标准误“和” 可信区间“等都是针对配对差值的统计量。由 结果可见,差值均值为10,相应的 P=0.027>0.025,故可以认为该药物对血压治 疗有影响。由于治疗前-治疗后的差值均值为 正,故可推断是使得病人血压下降。
例5:在轿车拥有率案例中,控制城市影响条 件下,更准确研究收入与轿车拥有率的关系。
三、无序分类变量的统计推断:卡方检验
五)分层卡方检验 (控制某些分类因素) 操作: “分析”—“描述统计”—“交叉表” (“层”框中选入城市变量S0) (“统计量”选中“风险”、 “Cochran‟s…”)
三、无序分类变量的统计推断:卡方检验
功能:比较两个总体样本的均值是否相等。实际功 能可以理解为判断是一个总体的样本还是两个总体 的样本,又称为成组设计两样本均数比较。(通常 数据中有一个变量显示分组情况) 也有前面说的两种情况,SPSS只做一种。 操作:“分析”—“比较均值”—“独立样本 t 检验”
例:
比较“均值比较”数据中男女生“自信心”的均值 是否有差异。(即,是同属于一个总体还是分属两 个不同总体)
用p-p图检验CCSS的年龄S3是否符合正态分布。
“分析”—“描述统计”—“p-p图”
一、分布类型检验
三)用p-p图直观数据分布形状 例3:
用茎叶图比较index和S3分布形状。
SPSS第三章参数估计

利利利利
t 21.192
Mean df Sig. (2-tailed) Difference 32 .000 8.86364
结论: 结论
1:33家平均受益量为 8.8636万元 万元, 表1:33家平均受益量为 8.8636万元,标准 差为2.4027万元. 2.4027万元 差为2.4027万元.
新电池 ):18.2\10.4\12.6\18.0\11.7\15.0\24.0\17.6\ (日):18.2\10.4\12.6\18.0\11.7\15.0\24.0\17.6\23 .6\24.8\19.3\20.5\19.8\17.1\ .6\24.8\19.3\20.5\19.8\17.1\16.3 旧电池 ):12.1\17.5\8.6\13.9\7.8\15.1\17.9\10.6\ (日):12.1\17.5\8.6\13.9\7.8\15.1\17.9\10.6\13.8 14.2\15.3\ \14.2\15.3\11.6
挂牌上课态度反映得分(X) 挂牌上课态度反映得分( 10—20 10 20 20—30 20 30 30—40 30 40 40—50 40 50 50—60 50 60 60—70 60 70 合计 人数(f ) 人数( 2 6 10 12 20 10 60
案例1 案例1
(1分表示"很不同意" (1分表示"很不同意",7分表示"很同 分表示 分表示" 10项态度分累加后得一总态度分 项态度分累加后得一总态度分, 意",将10项态度分累加后得一总态度分,这种 量叫7级李克累加量表): 量叫7级李克累加量表): 试计算: 试计算: 学生态度得分的平均值和标准差; (1)学生态度得分的平均值和标准差; 构造学生态度得分平均值的98%置信区间. 98%置信区间 (2)构造学生态度得分平均值的98%置信区间.
spss实验三
“习题10.5xls”在spss中打开【文件】→【打开】→【数据】,选择习题10.5xls打开,【从第一行数据选取变量】不选取,确定打开得到数据。
整理数据:删除数据第一、二行,将A、B、C三个企业的数据合并成一列命名为【使用寿命】,增加一列命名为【企业】,将V1改名为【实验号】。
在变量视图中将数据类型都改为【数值型】,度量标准都改为【度量】,用1、2、3值分别表示A、B、C三个企业。
点击菜单【分析】→【比较均值】→【单因素】,将【使用寿命】加入到【因变量列表】,【企业】加入到【因子】框中。
再点击【选项】,选取【描述性】、【均值图】,【继续】,【确定】,得到以下结果:由以上数据分析得,观测变量电池使用寿命的离差平方总和为832.000,不同企业可解释的变差为615.600,抽样误差引起的变差为216.400,它们的变差分别为307.800和18.033,相除所得的F统计量的观测值为17.068,对应的概率P值近似为0,显著性水平α为0.05,由于概率P值小于显著性水平α,则应拒绝原假设,认为不同企业对电池的平均寿命有显著影响。
点击菜单【分析】→【比较均值】→【单因素】,将【使用寿命】加入到【因变量列表】,【企业】加入到【因子】框中。
再点击【两两比较】,选取【LSD】,【继续】,【确定】,得到以下结果:由以上数据看出,A企业和B企业、B企业和C企业有显著性差异(因为P 值分别为0和0.001),A企业和C企业没有显著差异(P值为0.515)。
“习题10.6xls”:在spss中打开【文件】→【打开】→【数据】,选择习题10.6xls打开,【从第一行数据选取变量】不选取,确定打开得到数据。
整理数据:删除数据第一、二行,将A、B、C三种培训方式的数据合并成一列命名为【产品组装时间】,增加一列命名为【培训方式】。
在变量视图中将数据类型都改为【数值型】,度量标准都改为【度量】,用1、2、3值分别表示A、B、C 三种培训方法。
spss第三章课后答案详细步骤
1、利用第2章第7题数据,采用SPSS数据筛选功能将数据分成两份文件。
其中,第一份数据文件存储常住地是“沿海或中心繁华城市”且本次存款金额在1000至5000之间的调查数据:第二份数据文件是按照简单随机抽样所选取的70%的样本数据。
第一份文件:选取数据数据一选择个案一如果条件满足一存款>= 1000&存款<5000&常住地=沿海或中心繁华城市。
第二份文件:选取数据数据一选择个案一随机个案样本一输入70。
2、利用第2章第7题数据,将其按常住地(升序)、收入水平(升序)、存款金额(降序)进行多重排序。
排序数据一排序个案一把常住地、收入水平、存款金额作为排序依据分别设置排列顺序。
3、利用第2章第9题的完整数据,对每个学生计算得优课程数和得良课程数,并按得优课程数的降序排序。
计算转换一对个案内的值计数输入目标变量及日标标签,把所有课程选取到数字变量,定义值一设分数的区间,之后再排序。
4、利用第2章第9题的完整数据,计算每个学生课程的平均分以及标准差。
同时,计算男生和女生各科成绩的平均分。
方法- -:利用描述性统计,数据一转置学号放在名称变量,全部课程放在变量框中,确.定后,完成转置。
分析--描述统计一描述,将所有学生变量全选到变量框中,点击选项勾选均值、标准差。
先拆分数据_ 拆分文件按性别拆分,分析一描述统计一描述,全部课程放在变量框中,选项一均值。
方法二:利用变量计算,转换--计算变量分别输入日标变量名称及标签一--均值用函数mean完成平均分的计算,标准差用的数SD完成标准差的计算。
数据一分类汇总一性别作为分组变量、全部课程作为变量摘要、(创建只包含汇总变量的新数据集并命名)一确定5、利用第2章第7题数据,大致浏览存款金额的数据分布状况,并选择恰当的组限和组距进行组距分组。
根据存款金额排序,观察其最大值与最小值,算出组数和组距。
转换重新编码为其他变量一将存款金额作为输出变量一定义输出变量的名称及标签一设定旧值和新值.6、在第2章第7题数据中,如果认为调查中“今年的收入比去年增加”月.预计未来一两年收入仍会增加”的人是对自己收入比较满意和乐观的人,请利用SPSS的计数和数据筛选功能找到这些人。
SPSS 教程 第三章 基本分析
描述性统计分析(Descriptive Statistics)统计分析往往是从了解数据的基本特征开始的。
描述数据分布特征的统计量可分为两类:一类表示数量的中心位置,另一类表示数量的变异程度(或称离散程度)。
两者相互补充,共同反映数据的全貌。
这些内容可以通过SPSS中的“Descriptive Statistics”菜单中的过程来完成。
1 频数分析 (Descriptive Statistics - Frequencies)频数分布分析主要通过频数分布表、条形图和直方图,以及集中趋势和离散趋势的各种统计量来描述数据的分布特征。
下面我们通过例子来学习单变量频数分析操作。
1) 输入分析数据在数据编辑器窗口打开“data1-2.sav”数据文件。
2)调用分析过程在主菜单栏单击“Analyze”,在出现的下拉菜单里移动鼠标至“Descriptive Statistics”项上,在出现的次菜单里单击“Frequencies”项,打开如图3-4所示的对话框。
图3-4 “Frequencies” 对话框3)设置分析变量从左则的源变量框里选择一个和多个变量进入“Variable(s):”框里。
在这里我们选“三化螟蚁螟 [虫口数]”变量进入“Variable(s):”框。
4)输出频数分布表Display frequency tables,选中显示。
5)设置输出的统计量单击“Statistics”按钮,打开图3-5所示的对话框,该对话框用于选择统计量:图3-5 “Statistics”对话框① 选择百分位显示“Percentiles Values”栏:Quartiles:四分位数,显示25%、50%和75%的百分位数。
Cut points for 10 equal groups:将数据平分为输入的10个等份。
Percentile(s)::用户自定义百分位数,输入值0—100之间。
选中此项后,可以利用“Add”、“Change”和“Remove”按钮设置多个百分位数。
SPSS课件第三章 基本统计分析功能
吸烟史 病例
吸烟 647 不吸烟 2 合计 649
男性 对照 622 27 649
合计 1269
29 1298
病例 41 19 60
女性 对照 28 32 60
合计 69 51 120
辽宁医学院
SPSS统计软件应用
温有锋
一、Report(数据汇总报告菜单)
OLAP Cubes即时汇总过程 Cases Summary数据汇总 Report Summaries in Rows行汇 总报告
Report Summaries in Columns 列汇总报告
辽宁医学院
SPSS统计软件应用
温有锋
1、Frequencies(频数分布分析 )
频数分布分析主要通过频数分布表、条形图 和直方图,以及集中趋势和离散趋势的各种 统计量,描述数据的分布特征;
利用频数分布表可以方便地对数据按组进行 归类整理,形成各变量的不同水平(分组) 的频数分布表和图形,以便对各变量的数据 的特征和观测量分布状况有一个概括的认识。
Quartiles(四分位数) Cut point for(将数据平分 为所设定的相等等分。2~ 100之间) Percentile(s)(用户自定义 百分位数)
辽宁医学院
SPSS统计软件应用
温有锋
Statistics
Central Tendency (中心趋势)
Mean(均值) Median(中位数) Mode(众数) Sum(总和)
reportolapcubes即时汇总过程casessummary数据汇总reportsummariesrows行汇总报告reportsummariescolumns列汇总报告descrptivestatistics描述性统计分析frequencies频数分析descrptive描述统计量分析explore探索分析crosstabs多维频数分布ratio比率统计分析frequencies利用频数分布表可以方便地对数据按组进行归类整理形成各变量的不同水平分组的频数分布表和图形以便对各变量的数据的特征和观测量分布状况有一个概括的认识