
主存与cache的地址映射关系
主存与Cache的地址映射
CPU对存储器的访问,通常是一次读写一个字单元。
当CPU访Cache不命中时,需将存储在主存中的字单元连同其后若干个字一同调入Cache中,之所以这样做,是为了使其后的访存能在Cache中命中。
因此,主存和Cache之间一次交换的数据单位应该是一个数据块。
数据块的大小是固定的,由若干个字组成,且主存和Cache的数据块大小是相同的。
从Cache-主存层次实现的目标看,一方面既要使CPU的访存速度接近于访Cache的速度,另一方面为用户程序提供的运行空间应保持为主存容量大小的存储空间。
在采用Cache-主存层次的系统中,Cache对用户程序而言是透明的,也就是说,用户程序可以不需要知道Cache的存在。
因此,CPU每次访存时,依然和未使用Cache的情况一样,给出的是一个主存地址。
但在Cache-主存层次中,CPU首先访问的是Cache,并不是主存。
为此,需要一种机制将CPU的访主存地址转换成访Cache地址。
而主存地址与Cache地址之间的转换是与主存块与Cache块之间的映射关系紧密联系的,也就是说,当CPU访Cache未命中时,需要将欲访问的字所在主存中的块调入Cache中,按什么样的策略调入,直接影响到主存地址与Cache地址的对应关系,这也就是本小节要解决的主存与Cache的地址映射问题。
主要有三种地址映射方式,分别为全相联映射、直接相联映射和组相联映射。
1. 全相联映射
全相联映射是指主存中任一块都可以映射到Cache中任一块的方式,也就是说,当主存中的一块需调入Cache时,可根据当时Cache的块占用或分配情况,选择一个块给主存块存储,所选的Cache块可以是Cache中的任意一块。
例如,设Cache共有2C块,主存共有2M块,当主存的某一块j需调进Cache中时,它可以存入Cache的块0、块1、…、块i、… 或块2C -1的任意一块上。
如图4-28所示。
图4-28 全相联映射方式
在全相联映射方式下,CPU的访主存地址为如下形式:
其中,M为主存的块号,W为块内的字号。
而CPU访Cache的地址形式为:
其中,C为Cache的块号,W为块内的字号。
主存地址到Cache地址的转换是通过查找一个由相联存储器实现的块表来完成的,其形成过程如图4-29示。
图4-29 全相联映射的地址转换
当一个主存块调入Cache中时,会同时在一个存储主存块号和Cache 块号映射表的相联存储器中进行登记。
CPU访存时,首先,根据主存地址中的主存块号M在相联存储器中查找Cache块号,若找到,则本次访Cache命中,于是将对应的Cache块号取出,并送访Cache地址的块号C 字段;紧接着将主存地址的块内字号W直接送Cache地址的块内字号W 字段,从而形成一个访Cache的地址;最后根据该地址完成对Cache单元的访问.
全相联映射方式的优点是Cache的空间利用率高,但缺点是相联存储器庞大,比较电路复杂,因此只适合于小容量的Cache之用。
2. 直接相联映射
直接相联映射方式是指主存的某块j只能映射到满足如下特定关系的Cache块i中:
i=j mod 2C(4.2)
图4-30 直接相联映射方式
上图中,主存的第0、2C、2C+1、… 块只能映射到Cache的第0块,主存的第1、2C+1、2C+1+1、… 块只能映射到Cache的第1块,… … ,主存的第2C-1、2C+1-1、…2M-1块只能映射到Cache的第2C-1块。
在直接相联映射方式下,CPU的访主存地址为如下形式:
其中,T为标志号,C为Cache的块号,W为块内的字号。
在这里,原主存的块号M实际上被分成了两个字段:T和C,其中C用于指出主存的块可以映射的Cache的块。
一般来讲,主存的块数是Cache的块数的整数倍,也就是说主存的块数2M和Cache的块数2C满足关系式:2M=n·2C
在直接相联映射方式下,标志号T是随Cache的每个块一起存储的,其地址转换过程如图4-31所示。
图4-31 直接相联映射的地址转换
当一个主存块调入Cache中时,会同时将主存地址的T标志存入Cache块的标志字段中。
当CPU送来一个访存地址时,首先,根据该主存地址的C字段找到Cache的相应块,然后将该块标志字段中存放的标志与主存地址的T标志进行比较,若相符,说明主存的块目前已调入该Cache块中,则命中,于是使用主存地址的W字段访问该Cache块的相应字单元;若不相符,则未命中,于是使用主存地址直接访主存。
直接相联映射方式的优点是比较电路最简单,但缺点是Cache块冲突率较高,从而降低了Cache的利用率。
由于主存的每一块只能映射到Cache的一个特定块上,当主存的某块需调入Cache时,如果对应的Cache特定块已被占用,而Cache中的其它块即使空闲,主存的块也只能通过替换的方式调入特定块的位置,不能放置到其它块的位置上。
3. 组相联映射
以上两种方式各有优缺点,而且非常有趣的是,它们的优缺点正好相反,也就是说,对于全相联映射方式来说为优点的恰是直接相联映射方式的缺点,而对于全相联映射方式来说为缺点的恰是直接相联映射方式的优点。
那么,可否找到一种能较好地兼顾这两种方式的优点的映射方式呢?下面我们就来看看组相联映射方式在这种方式下,将Cache分成2u组,每组包含2v块。
主存的块与Cache的组之间采用直接相联映射,而与组内的各块则采用全相联映射。
也就是说,主存的某块只能映射到Cache的特定组中的任意一块。
主存的某块j与Cache的组k之间满足如下关系:
k=j mod 2u(4.3)
设主存共有2s×2u块(即M=s+u),则它们的映射关系如下图4-32示。
图4-32 组相联映射方式
图中,主存的块0、2u、2u+1、…、(2s-1)2u可以映射到Cache的第0组的任意一块,主存的块1、2u+1、2u+1+1、…、(2s-1)2u+1可以映射到Cache的第1组的任意一块,… … ,主存的块2u-1、2u+1-1、…、2M-1可以映射到Cache的第2u-1组的任意一块。
在组相联映射方式下,CPU的访主存地址和访Cache地址分别为如下形式:
其中,u为Cache的组号,v为组内的块号。
Cache的块号C=u+v,而主存的块号M=s+u。
也就是说,主存块地址的后u位指出了主存的这一块所能映射的Cache的组。
与全相联映射方式类似的是,在组相联映射方式下,主存地址到Cache地址的转换也是通过查找一个由相联存储器实现的块表来完成的,其形成过程如图4-33所示。
图4-33 组相联映射的地址转换
当一个主存块调入Cache中时,会同时将其主存块地址的前s位写入一个由相联存储器实现的快表的对应Cache块项的s字段中。
例如,设主存的某块调入Cache的第1组的第2块中,则在快表的组1第3项的s字段会登记下该主存块地址的前s位。
CPU访存时,首先,根据主存地址中的主存块号中的u字段找到快表的相应组,然后将该组的所有项的前s位同时与主存地址的s字段作比较,若相符,则说明主存块在Cache中,于是将Cache中该项的v字段取
出,作为Cache地址的v字段,而Cache地址的u、W字段直接由主存地址的u、W字段形成,最后形成一个完整的访Cache地址。
当然,若比较结果是没有相符项,则未命中,由主存地址直接访主存。
其实,全相联映射和直接相联映射可以看成是组相联映射的两个极端情况。
若u=0,v=C,则Cache只包含1组,此即全相联映射方式;若u=C,v=0,则组内的块数等于1,此即直接相联映射。
在实际应用中,相联映射方式每组的块数一般取值较小,典型值为2、4、8、16等,分别称为两路组相联、四路组相联等。
这样一方面使得比较器的规模较小,实现较容易,例如两路组相联采用两路比较,四路组相联采用四路比较等;另一方面,Cache每组增加的可映射块数可有效减少冲突,提高Cache访问的命中率。
2016年上半年上午 软件设计师 试题及答案与解析-软考考试真题-基础知识
2016年上半年上午软件设计师考试试题-答案与解析一、单项选择题(共75分,每题1分。
每题备选项中,只有1个最符合题意)●第1题.VLIW是(1)的简称。
A.复杂指令系统计算机B.超大规模集成电路C.单指令流多数据流D.超长指令字【参考答案】D【答案解析】VLIW:(VeryLongInstructionWord,超长指令字)一种非常长的指令组合,它把许多条指令连在一起,增加了运算的速度。
●第2题.主存与Cache的地址映射方式中,(2)方式可以实现主存任意一块装入Cache中任意位置,只有装满才需要替换。
A.全相联B.直接映射C.组相联D.串并联【参考答案】A【答案解析】全相联映射是指主存中任一块都可以映射到Cache中任一块的方式,也就是说,当主存中的一块需调入Cache时,可根据当时Cache的块占用或分配情况,选择一个块给主存块存储,所选的Cache块可以是Cache中的任意一块。
●第3题.如果“2X”的补码是“90H”,那么X的真值是(3)。
A.72B.-56C.56D.111【参考答案】B【答案解析】90H即为二进制的:10010000。
说明此数为负数,其反码为:10001111,其原码为:11110000,即-112,2X=-112,所以X=-56。
●第4题.移位指令中的(4)指令的操作结果相当于对操作数进行乘2操作。
A.算术左移B.逻辑右移C.算术右移D.带进位循环左移【参考答案】A【答案解析】移位运算符就是在二进制的基础上对数字进行平移。
按照平移的方向和填充数字的规则分为三种:<<(左移)、>>(带符号右移)和>>>(无符号右移)。
在数字没有溢出的前提下,对于正数和负数,左移一位都相当于乘以2的1次方,左移n位就相当于乘以2的n 次方。
●第5题.内存按字节编址,从A1000H到B13FFH的区域的存储容量为(5)KB。
A.32B.34C.65D.67【参考答案】C【答案解析】(B13FF+1-A1000H)/1024=65KB。
计算机组成原理部分答案

4.6 某机字长为32位,其存储容量是64KB ,按字编址的寻址范围是多少?若主存按字节编址,试画出主存字地址和字节地址的分配情况。
解:主存容量64KB ,如果按字编址,有64KB / 4B = 16K 个可寻址单元寻址范围是 214或0 ~ 16K-1如果按字节编址,有64K 个可寻址单元。
每个字包含4个字节。
用二进制表示的地址,字地址的最低2位是00。
4、7. 一个容量为16K ×32位的存储器,其地址线和数据线的总和是多少?当选用下列不同规格的存储芯片时,各需要多少片?1K ×4位,2K ×8位,4K ×4位,16K ×1位,4K ×8位,8K ×8位解:地址线和数据线的总和 = 14 + 32 = 46根;选择不同的芯片时,各需要的片数为:1K ×4:(16K ×32) / (1K ×4) = 16×8 = 128片2K ×8:(16K ×32) / (2K ×8) = 8×4 = 32片4K ×4:(16K ×32) / (4K ×4) = 4×8 = 32片16K ×1:(16K ×32)/ (16K ×1) = 1×32 = 32片4K ×8:(16K ×32)/ (4K ×8) = 4×4 = 16片8K ×8:(16K ×32) / (8K ×8) = 2×4 = 8片4.15 设CPU 共有16根地址线,8根数据线,并用MREQ (低电平有效)作访存控制信号,W /R 作读写命令信号(高电平为读,低电平为写)。
现有下列存储芯片:ROM (2K ×8位,4K ×4位,8K ×8位),RAM (1K ×4位,2K ×8位,4K ×8位),及74138译码器和其他门电路(门电路自定)。
组成原理-武汉纺织大学题库填空题
首页课程导学教学内容课程实验课程作业自我测试课程交流测试试卷课程答疑教学资料您当前的位置:自我测试返回填空题1、 请在括号内填入适当答案。
在CPU 中: (1) 保存当前正在执行的指令的寄存器是; (2) 保存当前正要执行的指令地址的寄存器是; (3) 算术逻辑运算结果通常放在和。
查看答案正确答案:指令寄存器IR 程序计数器PC 通用寄存器 数据缓冲寄存器DR 查看点评2、 硬布线器的设计方法是:先画出流程图,再利用写出综合逻辑表达式,然后用等器件实现。
查看答案正确答案:指令(周期) 布尔(逻辑)代数 门电路和触发器查看点评3、 微程序控制器由、、三大部分组成,其中是ROM 存储器,用来存放。
查看答案正确答案:控制存储器 微指令寄存器 地址转移逻辑 控制存储器 微程序查看点评4、 流水CPU 中的主要问题是:相关、相关和相关。
查看答案正确答案:资源 数据 控制查看点评5、 并行处理技术主要有三种形式:并行、并行和并行。
查看答案正确答案:时间 空间 时间及空间查看点评6、 微程序设计技术是利用方法设计的一门技术,具有规整性、、可维护性等一系列优点。
查看答案计算机组成原理C o m p u t e r O r g a n i z a t i o n P r i n c i p l e 返回平台首页正确答案:软件 控制器 灵活性查看点评7、 微指令格式中,微指令的编码通常采用以下三种方式:、和。
查看答案正确答案:直接表示法 编码表示法 混合表示法查看点评8、 由于数据通路之间的结构关系,微操作可分为和两种。
查看答案正确答案:相容性 相斥性查看点评9、 在程序执行过程中,控制器控制计算机的运行总是处于、分析指令和的循环当中。
查看答案正确答案:取指令 执行指令查看点评10、 CPU从主存取出一条指令并执行该指令的时间叫,它常用若干个来表示,而后者又包含若干个。
查看答案正确答案:指令周期 机器周期 时钟周期查看点评11、 CPU的四个主要功能是、、和。
以下习题来自《计算机系统结构》第七章 存储体系。

以下习题来自《计算机系统结构》第七章存储体系。
7.1解释下列术语直接映像:每个主存地址映像到Cache中的一个指定地质的方式称为直接映像。
全相联映像:任何主存地址可映像到任何Cache地址的方式称为全相联映像。
组相联映像:组相联映像指的是将存储空间的页面分成若干组,各组之间是直接映像,而组内各块之间是全相联映像。
全写法:全写法也称直达法,即写操作将数据同时写入Cache和缓存。
写回法:写Cache时不写主存,仅当被写Cache数据块要被替换出去时才写回主存。
虚拟存储器:虚拟存储器是主存的扩展,当主存的容量不能满足要求时,数据可存放在外存中,在程序中仍然按地址访问外存空间。
大小取决于计算机的访存能力。
段式管理:把主存按段分配的存储管理方式称为段式管理。
页式管理:把虚拟存储空间和实际存储空间等分成固定大小的页,各虚拟页可装入主存中不同的实际页面位置。
段页式管理:段页式管理式段式管理和页式管理的结合,他将存储空间按逻辑模块分成段,每段又分成若干个页,访存通过一个段表和若干个页表进行。
段的长度必须是页的长度的整数倍,段的起点必须是某一页的起点。
快表:为了提高页表中常用项的访问速度,采用快速硬件构成的比全表小的多的部分表格。
慢表:存放在主存中的整个页表。
高速缓存:高速缓冲存储器是位于CPU和主存之间的高层存储子系统。
时间局部性:如果一个存储项被访问,则可能该项会很快再次被访问。
空间局部性:如果一个存储项被访问,则该项及其邻近的相也可能很快被访问。
段表:在对虚拟内存进行管理时,系统中用于指明各段在主存中的位置的表,表中包括段名或段号、段起点、装入位和段长等。
页表:在对虚拟内存进行管理时,系统中用于指明各页在主存中的位置的表,表中包括页号、每页在主存中的起始位置、表示该页是否已装入主存的装入位等。
块表:存储系统中的一个用于解决块和页的定位、标志、和寻址问题的表。
7.2 有人认为,随着存储器芯片集成度的提高,主存的容量将越来越大,虚拟存贮器将被淘汰,未来的计算机中将不采用虚拟存储器。
Cache基础知识介绍
• 两极cache相比较而言,L1 cache的容量小,但数据存取速 度较快,L2 cache的容量大,但数据存取速度较慢。部分 系统中也存在三级cache的结构。
Microprocessor
Fastest
CPU
Level 1 cache
Fast
Level 2 cache
Slow
memory
Cache的作用是什么
• 通过优化代码提高cache命中率
对数组int x[1024][4]进行求和 代码段A for(i=0;i<1024;i++) for(j=0;j<4;j++) sum += x[i][j]
Entry 0 Way 0 x[i][0] x[i][1]
代码段B for(j=0;j<4;j++) for(i=0;i<1024;i++) sum += x[i][j]
• 块:块是cache与主存的传输单位。 • 路(way): 路是组相联映射方式的cache结构中的基本存 储单位,每一路存储一个块的数据。 • 组(entry):组是组相联映射方式的cache对块进行管理的 单位。 • 区 (tag) :块的地址对应的主存储器中的区。 • 块内偏移地址(offset): 用来标示块内一个字节的地址。 • 组相联映射方式下主存储器的地址空间由,区,组和块内 偏移地址组成。
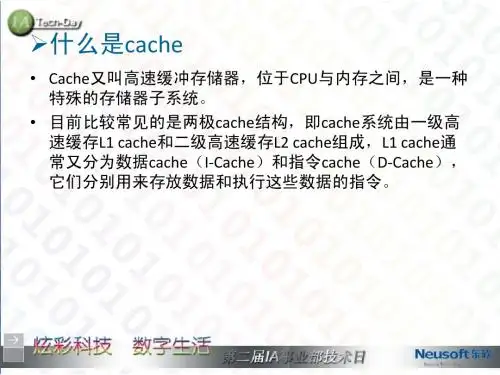
什么是cache
• Cache又叫高速缓冲存储器,位于CPU与内存之间,是一种 特殊的存储器子系统。 • 目前比较常见的是两极cache结构,即cache系统由一级高 速缓存L1 cache和二级高速缓存L2 cache组成,L1 cache通 常又分为数据cache(I-Cache)和指令cache(D-Cache), 它们分别用来存放数据和执行这些数据的指令。
cache三种方式

第三章存储系统第五节Cache存储器二、主存与Cache的地址映射由于Cache比主存小的多,因此必须使用一种机制将主存地址定位到Cache中,即地址映射。
这个映射过程全部由硬件实现,对程序员透明。
1.地址映射方法:采用查表法(用专用快速硬件实现表格)表中内容:映射的Cache地址、标记(命中判断)、有效位2.地址映射的三种方式:(1)全相联映射方式:灵活,但映射函数复杂,不易实现。
(2)直接映射方式:映照简单,不需计算,快速,但效率不高,易颠簸;。
(3)组相联映射方式:组内全相联映射,组间直接映射(1)全相联映射方式·任一主存块能映射到Cache中任意行(主存块的容量等于Cache行的容量),见图1:·映射过程:(见图2)①存入Cache:块表标记中存放主存的块号②检索:访问主存地址的块号与所有Cache行标记比较(图2阴影区)·符合,即数据在Cache中,形成访问Cache的地址(地址映射),访问Cache;·不符合:访问主存,并将该块调入Cache。
·优点:灵活,不易产生冲突;缺点:比较电路难于实现,且效率低,速度慢。
例:设访问存储器地址的块号序列为22、26、22、26、16、4、16、18,采用全相联映射方式时,Cache行分配情况(见图3)。
全相联映射方式实例演示(2)直接映射方式直接映射方式实例演示·某一主存块只能能映射到Cache的特定行,见图4:i = j mod m 其中:i:Cache的行号;j:主存的块号;m:Cache的总行数。
·映射过程:(见图5)①存入Cache:快表标记中存放主存地址的区号(将块地址分为二部分:·块(行)地址·标记(区号))②检索:根据访问主存地址的中间字段(行号),找到Cache快表中的这一行,读取该行中的标记字段与主存地址高位字段(区号)比较(图5阴影区)·符合:即数据在Cache中,形成访问Cache的地址(地址映射),访问Cache;·不符合:访问主存,并将该块调入Cache。
4.3主教材习题解析
4.3 主教材习题解析4.1 说明1M×l位DRAM片子的刷新方法,刷新周期定为8ms。
解:1M×l位DRAM片子的组织为1024×1024,(1024行1024列),每次刷新2048单元,在一个刷新周期内刷新512次,每次刷新间隔为8ms / 512 = 15.625微秒,即每隔15.625微秒刷新2行,在不到8ms时间全部刷新一遍(即刷新周期定为8ms)。
刷新时,送9位行地址A8~A0,行地址选通信号RAS#=L,写信号WE#=H (刷新是假读)4.2 用16k×8位的DRAM芯片构成64K×32位的存储器:画出该存储器的组成逻辑框图解:采用字位扩展法,4片16k×8位芯片组成一组为位扩展,形成32位字共用4组字扩展,构成64k×32的存储器。
4.3 设有一个具有20位地址和32位字长的存储器,求(1)该存储器能存储多少个字节的信息?(2)若存储器由512k×8位SRAM芯片组成,需要多少片?(3)需要多少位地址作芯片选择?解:(1)220×32 / 8 = 4MB(2)4MB / 512k×8位= 8片,2片构成1MB, 4MB需4组(3)2片构成1MB, 4MB需4组,用2位地址作芯片选择。
4.4. 用下列芯片构成存储系统,各需要多少个RAM芯片?需要多少位地址作为片外地址译码?设系统为20位地址线,采用全译码方式。
(1)512×4位RAM构成16KB的存储系统;(2)1024×1位RAM构成128KB的存储系统;(3)2K×4位RAM构成64KB的存储系统;(4)64K×1位RAM构成256KB的存储系统;解:1) 需要16KB/512×4=64片片外地址译码需11位地址线。
2) 需要128KB/1K×1=1024片片外地址译码需10位地址线。
中级软件设计师2013年11月上午试题_真题(含答案与解析)-交互
中级软件设计师2013年11月上午试题(总分75, 做题时间90分钟)单选选择本试卷的试题中有A、B、C、D四个选项,请选择一个最恰当的选项。
1.在程序执行过程中,Cache与主存的地址映像由______。
SSS_SINGLE_SELA 硬件自动完成B 程序员调度C 操作系统管理D 程序员与操作系统协同完成分值: 1答案:A[解析] CPU对存储器的访问,通常是一次读写一个字单元。
当CPU访问Cache 不命中时,需将存储在主存中的字单元连同其后若干个字一同调入Cache中。
由于CPU首先访问的是Cache,并不是主存。
为此,需要一种机制将CPU的访主存地址转换成访Cache地址。
而主存地址与Cache地址之间的转换是与主存块与Cache块之间的映射关系紧密联系的。
2.指令寄存器的位数取决于______。
SSS_SINGLE_SELA 存储器的容量B 指令字长C 数据总线的宽度D 地址总线的宽度分值: 1答案:B[解析] 当CPU执行一条指令时,先把它从内存储器读取到缓冲寄存器中,再送入指令寄存器IR暂存,IR是用来存放要执行的指令的,所以很明显跟指令的长度有关。
3.若计算机存储数据采用的是双符号位(00表示正号、11表示负号),两个符号相同的数相加时,如果运算结果的两个符号位经______运算得1,则可断定这两个数相加的结果产生了溢出。
SSS_SINGLE_SELA 逻辑与B 逻辑或C 逻辑同或D 逻辑异或分值: 1答案:D[解析] 本题考查逻辑运算,两个相同符号位经过异或可以得到1。
4.某指令流水线由4段组成,各段所需要的时间如下图所示。
连续输入8条指令时的吞吐率(单位时间内流水线所完成的任务数或输出的结果数)为______。
SSS_SINGLE_SELA 8/56ΔtB 8/32ΔtC 8/28ΔtD 8/24Δt分值: 1答案:C[解析] 吞吐率是指单位时间里流水线处理机流出的结果数。
对指令而言,就是单位时间里执行的指令数。
2009-2013年计算机组成考研原试题与答案
2009年全国硕士研究生计算机学科入学统一考试计算机组成原理试题分析一、选择题(每个题2分)11.冯·诺依曼计算机中指令和数据均以二进制形式存放在存储器中,CPU区分它们的依据是A.指令操作码的译码结果B.指令和数据的寻址方式C.指令周期的不同阶段D.指令和数据所在的存储单元[答案] C[解析] 1、指令执行步骤,在取指期间取来的是指令,读数据期间读来的是数据;2、指令和数据性质上的区别,虽然二者都用二进制表示,但属于完全不同性质的信息,数据是计算机加工处理的“原材料”,指令是告知计算机运行功能和执行步骤的命令类信息。
12.一个C语言程序在一台32位机器上运行。
程序中定义了三个变量x、y和z,其中x和z为int型,y为short型。
当x = 127,y = -9时,执行赋值语句z = x+y后,x、y和z的值分别是A.x = 0000007FH,y = FFF9H,z = 00000076HB.x = 0000007FH,y = FFF9H,z = FFFF0076HC.x = 0000007FH,y = FFF7H,z = FFFF0076HD.x = 0000007FH,y = FFF7H,z = 00000076H[答案] D[解析] 1、十进制整数到二进制的转换,数据的补码表示;2、补码加法运算,2两个不同位数的补码数相加时需要进行符号扩展;X=127,[X]补=0000007FH(32位整数),运算后其值不变Y=-9,[Y]补=FFF7H (16位整数),运算后其值不变[Z]补= [X补+Y补]=0000007FH+FFFFFFF7H=00000076H3、解题技巧,也可先求出127+(-9)=118,再变成补码后去与可供选择的答案对比。
补码位扩展规则:高位补符号位13.浮点数加、减运算过程一般包括对阶、尾数运算、规格化、舍入和判溢出等步骤。
设浮点数的阶码和尾数均采用补码表示,且位数分别为5位和7位(均含2位符号位)。
中级软件设计师上午试题-计算机组成与结构(一)-1
中级软件设计师上午试题-计算机组成与结构(一)-1(总分:50.00,做题时间:90分钟)一、{{B}}单项选择题{{/B}}(总题数:2,分数:50.00)地址编号从80000H到BFFFFH,且按字节编址的内存容量为______KB,若用16K×4bit的存储器芯片构成该内存,共需______片。
(分数:45.00)(1).∙ A.128∙ B.256∙ C.512∙ D.1024(分数:2.50)A.B. √C.D.解析:(2).∙ A.8∙ B.16∙ C.32∙ D.64(分数:2.50)A.B.C. √D.解析:[解析] 从80000H到BFFFFH有BFFFFH-80000H+1个地址单元,即40000H个地址单元。
若按字节编址,有218个字节,即256KB。
若用16K×4bit的存储芯片,需要(256K×2×4bit)/(16K×4bit)=32片芯片。
(3).在程序执行过程中,Cache与主存的地址映像由______。
∙ A.硬件自动完成∙ B.程序员调度∙ C.操作系统管理∙ D.程序员与操作系统协同完成(分数:2.50)A. √B.C.D.解析:[解析] CPU对存储器的访问,通常是一次读写一个字单元。
当CPU访问Cache不命中时,需将存储在主存中的字单元连同其后若干个字一同调入(Cache中。
由于CPU首先访问的是Cache,并不是主存。
为此,需要一种机制将CPU的访主存地址转换成Cache地址。
而主存地址与Cache地址之间的转换是与主存块与Cache块之间的映射关系紧密联系的。
(4).______不属于按寻址方式划分的一类存储器。
∙ A.随机存储器∙ B.顺序存储器∙ C.相联存储器∙ D.直接存储器(分数:2.50)A.B.C. √D.解析:[解析] 相联存储器是按内容访问的一种存储器,是按访问方式划分的。
存储器按访问方式可分为按地址访问的存储器和按内容访问的存储器。