
SQL命令语句基本常用的
既然你已经理解了INSERT语句是怎样工作的了,让我们转到EMPLOYEES表中的其他部分:INSERT INTO EMPLOYEES V ALUES('Bunyan','Paul','1970-07-04','Boston',12,70000);INSERT INTO EMPLOYEES V ALUES('John','Adams','1992-01-21','Boston',20,100000);INSERT INTO EMPLOYEES V ALUES('Smith','Pocahontas','1976-04-06','Los Angles',12,100000);INSERT INTO EMPLOYEES V ALUES('Smith','Bessie','1940-05-02','Boston',5,200000);INSERT INTO EMPLOYEES V ALUES('Jones','Davy','1970-10-10','Boston',8,45000);INSERT INTO EMPLOYEES V ALUES('Jones','Indiana','1992-02-01','Chicago',NULL,NULL);在最后一项中,我们不知道Jones先生的工薪级别和年薪,所以我们输入NULL(不要引号)。
NULL是SQL中的一种特殊情况,我们以后将进行详细的讨论。
现在我们只需认为NULL表示一种未知的值。
有时,像我们刚才所讨论的情况,我们可能希望对某一些而不是全部的列进行赋值。
除了对要省略的列输入NULL 外,还可以采用另外一种INSERT语句,如下:INSERT INTO EMPLOYEES(FIRST_NAME, LAST_NAME,HIRE_DATE, BRANCH_OFFICE)V ALUE('Indiana','Jones','1992-02-01','Indianapolis');这样,我们先在表名之后列出一系列列名。
未列出的列中将自动填入缺省值,如果没有设置缺省值则填入NULL。
请注意我们改变了列的顺序,而值的顺序要对应新的列的顺序。
如果该语句中省略了FIRST_NAME和LAST_NAME项(这两项规定不能为空),SQL操作将失败。
让我们来看一看上述INSERT语句的语法图:INSERT INTO table[(column { ,column})]V ALUES(columnvalue [{,columnvalue}]);和前一篇文章中一样,我们用方括号来表示可选项,大括号表示可以重复任意次数的项(不能在实际的SQL语句中使用这些特殊字符)。
V ALUE子句和可选的列名列表中必须使用圆括号。
SELECT语句SELECT语句可以从一个或多个表中选取特定的行和列。
因为查询和检索数据是数据库管理中最重要的功能,所以SELECT语句在SQL中是工作量最大的部分。
实际上,仅仅是访问数据库来分析数据并生成报表的人可以对其他SQL语句一窍不通。
SELECT语句的结果通常是生成另外一个表。
在执行过程中系统根据用户的标准从数据库中选出匹配的行和列,并将结果放到临时的表中。
在直接SQL(direct SQL)中,它将结果显示在终端的显示屏上,或者将结果送到打印机或文件中。
也可以结合其他SQL语句来将结果放到一个已知名称的表中。
SELECT语句功能强大。
虽然表面上看来它只用来完成本文第一部分中提到的关系代数运算“选择”(或称“限制”),但实际上它也可以完成其他两种关系运算—“投影”和“连接”,SELECT语句还可以完成聚合计算并对数据进行排序。
SELECT语句最简单的语法如下:SELECT columns FROM tables;当我们以这种形式执行一条SELECT语句时,系统返回由所选择的列以及用户选择的表中所有指定的行组成的一个结果表。
这就是实现关系投影运算的一个形式。
让我们看一下使用图1中EMPLOYEES表的一些例子(这个表是我们以后所有SELECT语句实例都要使用的。
而我们在图2和图3中给出了查询的实际结果。
我们将在其他的例子中使用这些结果)。
假设你想查看雇员工作部门的列表。
那下面就是你所需要编写的SQL查询:SELECT BRANCH_OFFICE FROM EMPLOYEES;以上SELECT语句的执行将产生如图2中表2所示的结果。
由于我们在SELECT语句中只指定了一个列,所以我们的结果表中也只有一个列。
注意结果表中具有重复的行,这是因为有多个雇员在同一部门工作(记住SQL从所选的所有行中将值返回)。
要消除结果中的重复行,只要在SELECT语句中加上DISTINCT子句:SELECT DISTINCT BRANCH_OFFICEFROM EMPLOYEES;这次查询的结果如表3所示。
现在已经消除了重复的行,但结果并不是按照顺序排列的。
如果你希望以字母表顺序将结果列出又该怎么做呢?只要使用ORDER BY子句就可以按照升序或降序来排列结果:SELECT DISTINCT BRANCH_OFFICEFROM EMPLOYEESORDER BY BRANCH_OFFICE ASC;这一查询的结果如表4所示。
请注意在ORDER BY之后是如何放置列名BRANCH _OFFICE的,这就是我们想要对其进行排序的列。
为什么即使是结果表中只有一个列时我们也必须指出列名呢?这是因为我们还能够按照表中其他列进行排序,即使它们并不显示出来。
列名BRANCH_ OFFICE之后的关键字ASC表示按照升序排列。
如果你希望以降序排列,那么可以用关键字DESC。
同样我们应该指出ORDER BY子句只将临时表中的结果进行排序;并不影响原来的表。
假设我们希望得到按部门排序并从工资最高的雇员到工资最低的雇员排列的列表。
除了工资括号中的内容,我们还希望看到按照聘用时间从最近聘用的雇员开始列出的列表。
以下是你将要用到的语句:SELECT BRANCH_OFFICE,FIRST_NAME,LAST_NAME,SALARY,HIRE_DA TEFROM EMPLOYEESORDER BY SALARY DESC,HIRE_DATE DESC;这里我们进行了多列的选择和排序。
排序的优先级由语句中的列名顺序所决定。
SQL将先对列出的第一个列进行排序。
如果在第一个列中出现了重复的行时,这些行将被按照第二列进行排序,如果在第二列中又出现了重复的行时,这些行又将被按照第三列进行排序……如此类推。
这次查询的结果如表5所示。
将一个很长的表中的所有列名写出来是一件相当麻烦的事,所以SQL允许在选择表中所有的列时使用*号:SELECT * FROM EMPLOYEES;这次查询返回整个EMPLOYEES表,如表1所示。
下面我们对开始时给出的SELECT语句的语法进行一下更新(竖直线表示一个可选项,允许在其中选择一项。
):SELECT [DISTINCT](column [{, columns}])| *FROM table [ {, table}][ORDER BY column [ASC] | DESC[ {, column [ASC] | DESC }]];定义选择标准在我们目前所介绍的SELECT语句中,我们对结果表中的列作出了选择但返回的是表中所有的行。
让我们看一下如何对SELECT语句进行限制使得它只返回希望得到的行:SELECT columns FROM tables [WHERE predicates];WHERE子句对条件进行了设置,只有满足条件的行才被包括到结果表中。
这些条件由断言(predicate)进行指定(断言指出了关于某件事情的一种可能的事实)。
如果该断言对于某个给定的行成立,该行将被包括到结果表中,否则该行被忽略。
在SQL语句中断言通常通过比较来表示。
例如,假如你需要查询所有姓为Jones的职员,则可以使用以下SELECT 语句:SELECT * FROM EMPLOYEESWHERE LAST_NAME = 'Jones';LAST_NAME = 'Jones'部分就是断言。
在执行该语句时,SQL将每一行的LAST_NAME列与“Jones”进行比较。
如果某一职员的姓为“Jones”,即断言成立,该职员的信息将被包括到结果表中(见表6)。
使用最多的六种比较我们上例中的断言包括一种基于“等值”的比较(LAST_NAME = 'Jones'),但是SQL断言还可以包含其他几种类型的比较。
其中最常用的为:等于=不等于<>小于<大于>小于或等于<=大于或等于>=下面给出了不是基于等值比较的一个例子:SELECT * FROM EMPLOYEESWHERE SALARY > 50000;这一查询将返回年薪高于$50,000.00的职员(参见表7)。
逻辑连接符有时我们需要定义一条不止一种断言的SELECT语句。
举例来说,如果你仅仅想查看Davy Jones的信息的话,表6中的结果将是不正确的。
为了进一步定义一个WHERE子句,用户可以使用逻辑连接符AND,OR和NOT。
为了只得到职员Davy Jones的记录,用户可以输入如下语句:SELECT * FROM EMPLOYEESWHERE LAST_NAME = 'Jones' AND FIRST_NAME = 'Davy';在本例中,我们通过逻辑连接符AND将两个断言连接起来。
只有两个断言都满足时整个表达式才会满足。
如果用户需要定义一个SELECT语句来使得当其中任何一项成立就满足条件时,可以使用OR连接符:SELECT * FROM EMPLOYEESWHERE LAST_NAME = 'Jones' OR LAST_NAME = 'Smith';有时定义一个断言的最好方法是通过相反的描述来说明。
如果你想要查看除了Boston办事处的职员以外的其他所有职员的信息时,你可以进行如下的查询:SELECT * FROM EMPLOYEESWHERE NOT(BRANCH_OFFICE = 'Boston');关键字NOT后面跟着用圆括号括起来的比较表达式。
PGSQL基础语句汇总
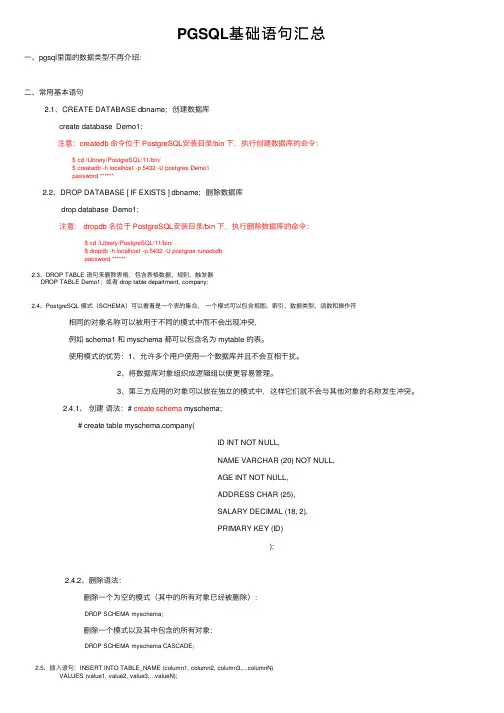
PGSQL基础语句汇总⼀、pgsql⾥⾯的数据类型不再介绍:⼆、常⽤基本语句2.1、CREATE DATABASE dbname; 创建数据库create database Demo1;注意:createdb 命令位于 PostgreSQL安装⽬录/bin 下,执⾏创建数据库的命令: $ cd /Library/PostgreSQL/11/bin/ $ createdb -h localhost -p 5432 -U postgres Demo1 password ******2.2、DROP DATABASE [ IF EXISTS ] dbname; 删除数据库drop database Demo1;注意: dropdb 名位于 PostgreSQL安装⽬录/bin 下,执⾏删除数据库的命令: $ cd /Library/PostgreSQL/11/bin/ $ dropdb -h localhost -p 5432 -U postgres runoobdb password ******2.3、DROP TABLE 语句来删除表格,包含表格数据、规则、触发器DROP TABLE Demo1; 或者 drop table department, company;2.4、PostgreSQL 模式(SCHEMA)可以看着是⼀个表的集合,⼀个模式可以包含视图、索引、数据类型、函数和操作符 相同的对象名称可以被⽤于不同的模式中⽽不会出现冲突, 例如 schema1 和 myschema 都可以包含名为 mytable 的表。
使⽤模式的优势:1、允许多个⽤户使⽤⼀个数据库并且不会互相⼲扰。
2、将数据库对象组织成逻辑组以便更容易管理。
3、第三⽅应⽤的对象可以放在独⽴的模式中,这样它们就不会与其他对象的名称发⽣冲突。
2.4.1、创建语法:# create schema myschema;# create table pany( ID INT NOT NULL, NAME VARCHAR (20) NOT NULL, AGE INT NOT NULL, ADDRESS CHAR (25), SALARY DECIMAL (18, 2), PRIMARY KEY (ID) ); 2.4.2、删除语法: 删除⼀个为空的模式(其中的所有对象已经被删除): DROP SCHEMA myschema; 删除⼀个模式以及其中包含的所有对象: DROP SCHEMA myschema CASCADE;2.5、插⼊语句:INSERT INTO TABLE_NAME (column1, column2, column3,...columnN)VALUES (value1, value2, value3,...valueN);所有字段插⼊值或者 INSERT INTO TABLE_NAMEVALUES (value1,value2,value3,...valueN);案例:# INSERT INTO COMPANY (ID,NAME,AGE,ADDRESS,SALARY,JOIN_DATE) VALUES (1, 'Paul', 32, 'California', 20000.00,'2001-07-13');所有字段插⼊值或者 INSERT INTO COMPANY VALUES (1, 'Paul', 32, 'California', 20000.00,'2001-07-13');2.6、查询语句:SELECT column1, column2,...columnN FROM table_name;案例:SELECT * FROM company;SELECT * FROM COMPANY WHERE SALARY > 50000; =或!=或 >=、IS NOT NULL;案例2: # SELECT (17 + 6) AS ADDITION ;# SELECT COUNT(*) AS "RECORDS" FROM COMPANY;PostgreSQL 还内置了⼀些数学函数,如: 1、avg() :返回⼀个表达式的平均值 2、sum() :返回指定字段的总和 3、count() :返回查询的记录总数2.7、更新数据库表中数据语法:UPDATE table_name SET column1 = value1,column2 = value2...., columnN = valueN WHERE [condition];案例:# UPDATE COMPANY SET SALARY = 15000 WHERE ID = 3;2.8、DELETE 语句来删除 PostgreSQL 表中的数据DELETE FROM table_name WHERE [condition];案例:DELETE FROM table_name WHERE [condition];2.9、查询数据 limit 或 OFFSET案例:=# SELECT * FROM COMPANY LIMIT 4;偏移 offset# SELECT * FROM COMPANY LIMIT 3 OFFSET 2;2.10、DISTINCT 关键字与 SELECT 语句⼀起使⽤,⽤于去除重复记录,只获取唯⼀的记录案例:SELECT DISTINCT name FROM COMPANY;2.11、PostgreSQL 约束⽤于规定表中的数据规则。
SQL语言命令

SQL语言由命令、子句、运算和集合函数等构成。
在SQL中,数据定义语言DDL(用来建立及定义数据表、字段以及索引等数据库结构)包含的命令有CREATE、DROP、ALTER;数据操纵语言DML(用来提供数据的查询、排序以及筛选数据等功能)包含的命令有SELECT、INSERT、UPDATE、DELETE。
一、SQL语句(1)Select 查询语句语法:SELECT [ALL|DISTINCT] <目标列表达式> [AS 列名][,<目标列表达式> [AS 列名] ...] FROM <表名> [,<表名>…][WHERE <条件表达式> [AND|OR <条件表达式>...][GROUP BY 列名[HA VING <条件表达式>]][ORDER BY 列名[ASC | DESC]]解释:[ALL|DISTINCT] ALL:全部;DISTINCT:不包括重复行<目标列表达式> 对字段可使用A VG、COUNT、SUM、MIN、MAX、运算符等<条件表达式>查询条件谓词比较=、>,<,>=,<=,!=,<>,确定范围BETWEEN AND、NOT BETWEEN AND确定集合IN、NOT IN字符匹配LIKE(“%”匹配任何长度,“_”匹配一个字符)、NOT LIKE空值IS NULL、IS NOT NULL子查询ANY、ALL、EXISTS集合查询UNION(并)、INTERSECT(交)、MINUS(差)多重条件AND、OR、NOT<GROUP BY 列名> 对查询结果分组[HA VING <条件表达式>] 分组筛选条件[ORDER BY 列名[ASC | DESC]] 对查询结果排序;ASC:升序DESC:降序例1:select student.sno as 学号, as 姓名, course as 课程名, score as 成绩from score,student where student.sid=score.sid and score.sid=:sid例2:select student.sno as 学号, as 姓名,A VG(score) as 平均分from score,student where student.sid=score.sid and student.class=:class and (term=5 or term=6) group by student.sno, having count(*)>0 order by 平均分DESC例3:select * from score where sid like '9634'例4:select * from student where class in (select class from student where name='陈小小')(2)INSERT插入语句语法:INSERT INTO <表名> [(<字段名1> [,<字段名2>, ...])] V ALUES (<常量1> [,<常量2>, ...])语法:INSERT INTO <表名> [(<字段名1> [,<字段名2>, ...])] 子查询例子:INSERT INTO 借书表(rid,bookidx,bdate)V ALUES (edit1.text,edit2.text,date)例子:INSERT INTO score1(sno,name) SELECT sno,name FROM stud ent WHERE class=‟9634‟(3)UPDATE-SQL语法:UPDATE 〈表名〉SET 列名1 = 常量表达式1[,列名2 = 常量表达式2 ...]WHERE <条件表达式> [AND|OR <条件表达式>...]例子:update score set credithour=4 where course='数据库'(4)DELETE-SQL语法:DELETE FROM〈表名〉[WHERE <条件表达式> [AND|OR <条件表达式>...]] 例子:Delete from student where sid='003101'(5)CREATE TABLECREATE TABLE | DBF TableName1 [NAME LongTableName] [FREE] (FieldName1 FieldType [(nFieldWidth [, nPrecision])][NULL | NOT NULL][CHECK lExpression1 [ERROR cMessageText1]][DEFAULT eExpression1][PRIMARY KEY | UNIQUE][REFERENCES TableName2 [TAG TagName1]][NOCPTRANS][, FieldName2 ...][, PRIMARY KEY eExpression2 TAG TagName2|, UNIQUE eExpression3 TAG TagName3][, FOREIGN KEY eExpression4 TAG TagName4 [NODUP]REFERENCES TableName3 [TAG TagName5]][, CHECK lExpression2 [ERROR cMessageText2]])| FROM ARRAY ArrayName(6)ALTER TABLEALTER TABLE TableName1ADD | ALTER [COLUMN] FieldName1FieldType [(nFieldWidth [, nPrecision])][NULL | NOT NULL][CHECK lExpression1 [ERROR cMessageText1]][DEFAULT eExpression1][PRIMARY KEY | UNIQUE][REFERENCES TableName2 [TAG TagName1]][NOCPTRANS](7)DROP TABLEDROP TABLE [路径名.]表名(8)CREATE INDEXCREATE INDEX index-name ON table-name(column[,column…])例:CREATE INDEX uspa ON 口令表(user,password)(9)DROP INDEXDROP INDEX table-name.index-name|PRIMARY例:DROP INDEX 口令表.uspa二、在程序中使用静态SQL语句在程序设计阶段,将SQL命令文本作为TQuery组件的SQL属性值设置。
oracle常用SQL语句(汇总版)

Oracle数据库常用sql语句ORACLE 常用的SQL语法和数据对象一.数据控制语句(DML) 部分1.INSER T (往数据表里插入记录的语句)INSERT INTO 表名(字段名1, 字段名2, ……) VALUES ( 值1, 值2, ……);INSERT INTO 表名(字段名1, 字段名2, ……) SELECT (字段名1, 字段名2, ……) FROM 另外的表名;字符串类型的字段值必须用单引号括起来, 例如: ’GOOD DAY’如果字段值里包含单引号’ 需要进行字符串转换, 我们把它替换成两个单引号''.字符串类型的字段值超过定义的长度会出错, 最好在插入前进行长度校验.日期字段的字段值可以用当前数据库的系统时间SYSDATE, 精确到秒或者用字符串转换成日期型函数TO_DATE(‘2001-08-01’,’YYYY-MM-DD’)TO_DATE()还有很多种日期格式, 可以参看OR ACLE DOC.年-月-日小时:分钟:秒的格式YYYY-MM-DD HH24:MI:SSINSERT时最大可操作的字符串长度小于等于4000个单字节, 如果要插入更长的字符串, 请考虑字段用CLOB类型,方法借用ORACLE里自带的DBMS_LOB程序包.INSERT时如果要用到从1开始自动增长的序列号, 应该先建立一个序列号CREATE SEQUENCE 序列号的名称(最好是表名+序列号标记) INCREMENT BY 1 START WI TH 1 MAXVALUE 99999 CYCLE NOCACHE;其中最大的值按字段的长度来定, 如果定义的自动增长的序列号NUMBER(6) , 最大值为999999 INSERT 语句插入这个字段值为: 序列号的名称.NEXTVAL2.DELETE (删除数据表里记录的语句)DELETE FROM表名 WHERE 条件;注意:删除记录并不能释放ORACLE里被占用的数据块表空间. 它只把那些被删除的数据块标成unused.如果确实要删除一个大表里的全部记录, 可以用TRUNCATE 命令, 它可以释放占用的数据块表空间TRUNCATE TABLE 表名;此操作不可回退.3.UPDATE (修改数据表里记录的语句)UPDATE表名SET 字段名1=值1, 字段名2=值2, …… WHERE 条件;如果修改的值N没有赋值或定义时, 将把原来的记录内容清为NULL, 最好在修改前进行非空校验;值N超过定义的长度会出错, 最好在插入前进行长度校验..注意事项:A. 以上SQL语句对表都加上了行级锁,确认完成后, 必须加上事物处理结束的命令COMMIT 才能正式生效,否则改变不一定写入数据库里.如果想撤回这些操作, 可以用命令ROLLBACK 复原.B. 在运行INSERT, DELETE 和UPDATE 语句前最好估算一下可能操作的记录范围,应该把它限定在较小(一万条记录) 范围内,. 否则ORACLE处理这个事物用到很大的回退段.程序响应慢甚至失去响应. 如果记录数上十万以上这些操作, 可以把这些SQL语句分段分次完成, 其间加上COMMIT 确认事物处理.二.数据定义(DDL) 部分1.CREATE (创建表, 索引, 视图, 同义词, 过程, 函数, 数据库链接等)ORACLE常用的字段类型有CHAR 固定长度的字符串VARCHAR2 可变长度的字符串NUMBER(M,N) 数字型M是位数总长度, N是小数的长度DATE 日期类型创建表时要把较小的不为空的字段放在前面, 可能为空的字段放在后面创建表时可以用中文的字段名, 但最好还是用英文的字段名创建表时可以给字段加上默认值, 例如DEFAUL T SYSDATE这样每次插入和修改时, 不用程序操作这个字段都能得到动作的时间创建表时可以给字段加上约束条件例如不允许重复UNIQUE, 关键字PRIMAR Y KEY2.AL TER (改变表, 索引, 视图等)改变表的名称AL TER TABLE 表名1 TO 表名2;在表的后面增加一个字段AL TER TABLE表名ADD 字段名字段名描述;修改表里字段的定义描述AL TER TABLE表名MODIFY字段名字段名描述;给表里的字段加上约束条件AL TER TABLE 表名ADD CONSTRAINT 约束名PRIMAR Y KEY (字段名);AL TER TABLE 表名ADD CONSTRAINT 约束名UNIQUE (字段名);把表放在或取出数据库的内存区AL TER TABLE 表名CACHE;AL TER TABLE 表名NOCACHE;3.DROP (删除表, 索引, 视图, 同义词, 过程, 函数, 数据库链接等)删除表和它所有的约束条件DROP TABLE 表名CASCADE CONSTRAINTS;4.TRUNCATE (清空表里的所有记录, 保留表的结构)TRUNCATE 表名;三.查询语句(SELECT) 部分SELECT字段名1, 字段名2, …… FROM 表名1, [表名2, ……] WHERE 条件;字段名可以带入函数例如: COUNT(*), MIN(字段名), MAX(字段名), AVG(字段名), DISTINCT(字段名), TO_CHAR(DATE字段名,'YYYY-MM-DD HH24:MI:SS')NVL(EXPR1, EXPR2)函数解释:IF EXPR1=NULLRETURN EXPR2ELSERETURN EXPR1DECODE(AA﹐V1﹐R1﹐V2﹐R2....)函数解释:IF AA=V1 THEN RETURN R1IF AA=V2 THEN RETURN R2..…ELSERETURN NULLLPAD(char1,n,char2)函数解释:字符char1按制定的位数n显示,不足的位数用char2字符串替换左边的空位字段名之间可以进行算术运算例如: (字段名1*字段名1)/3查询语句可以嵌套例如: SELECT …… FROM(SELECT …… FROM表名1, [表名2, ……] WHERE 条件) WHERE 条件2;两个查询语句的结果可以做集合操作例如: 并集UNION(去掉重复记录), 并集UNION ALL(不去掉重复记录), 差集MINUS, 交集INTERSECT分组查询SELECT字段名1, 字段名2, …… FROM 表名1, [表名2, ……] GROUP BY字段名1[HAVING 条件] ;两个以上表之间的连接查询SELECT字段名1, 字段名2, …… FROM 表名1, [表名2, ……] WHERE表名1.字段名= 表名2. 字段名[ AND ……] ;SELECT字段名1, 字段名2, …… FROM 表名1, [表名2, ……] WHERE表名1.字段名= 表名2. 字段名(+) [ AND ……] ;有(+)号的字段位置自动补空值查询结果集的排序操作, 默认的排序是升序ASC, 降序是DESCSELECT字段名1, 字段名2, …… FROM 表名1, [表名2, ……]ORDER BY字段名1, 字段名2 DESC;字符串模糊比较的方法INSTR(字段名, ‘字符串’)>0字段名LIKE ‘字符串%’[‘%字符串%’]每个表都有一个隐含的字段ROWID, 它标记着记录的唯一性.四.ORACLE里常用的数据对象 (SCHEMA)1.索引(INDEX)CREATE INDEX 索引名ON 表名( 字段1, [字段2, ……] );AL TER INDEX 索引名REBUILD;一个表的索引最好不要超过三个(特殊的大表除外), 最好用单字段索引, 结合SQL语句的分析执行情况, 也可以建立多字段的组合索引和基于函数的索引ORACLE8.1.7字符串可以索引的最大长度为1578 单字节ORACLE8.0.6字符串可以索引的最大长度为758 单字节2.视图(VIEW)CREATE VIEW 视图名AS SELECT …. FROM …..;AL TER VIEW视图名COMPILE;视图仅是一个SQL查询语句, 它可以把表之间复杂的关系简洁化.3.同义词(SYNONMY)CREATE SYNONYM同义词名FOR 表名;CREATE SYNONYM同义词名FOR 表名@数据库链接名;4.数据库链接(DATABASE LINK)CREATE DATABASE LINK数据库链接名CONNECT TO 用户名IDENTIFIED BY 密码USING ‘数据库连接字符串’;数据库连接字符串可以用NET8 EASY CONFIG或者直接修改TNSNAMES.ORA里定义.数据库参数global_name=true时要求数据库链接名称跟远端数据库名称一样数据库全局名称可以用以下命令查出SELECT * FROM GLOBAL_NAME;查询远端数据库里的表SELECT …… FROM 表名@数据库链接名;五.权限管理(DCL) 语句1.GRANT 赋于权限常用的系统权限集合有以下三个:CONNECT(基本的连接), RESOURCE(程序开发), DBA(数据库管理)常用的数据对象权限有以下五个:ALL ON 数据对象名, SELECT ON 数据对象名, UPDATE ON 数据对象名, DELETE ON 数据对象名, INSER T ON 数据对象名, AL TER ON 数据对象名GRANT CONNECT, RESOURCE TO 用户名;GRANT SELECT ON 表名 TO 用户名;GRANT SELECT, INSERT, DELETE ON表名 TO 用户名1, 用户名2;2.REVOKE 回收权限REVOKE CONNECT, RESOURCE FROM 用户名;REVOKE SELECT ON 表名FROM 用户名;REVOKE SELECT, INSERT, DELETE ON表名FROM 用户名1, 用户名2;查询数据库中第63号错误:select orgaddr,destaddr from sm_histable0116 where error_code='63';查询数据库中开户用户最大提交和最大下发数:select MSISDN,TCOS,OCOS from ms_usertable;查询数据库中各种错误代码的总和:select error_code,count(*) from sm_histable0513 group by error_code orderby error_code;查询报表数据库中话单统计种类查询。
sql语句select的功能和使用格式
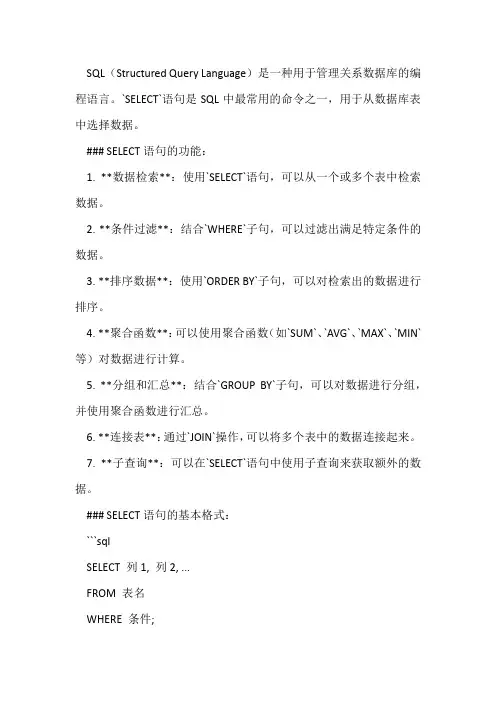
SQL(Structured Query Language)是一种用于管理关系数据库的编程语言。
`SELECT`语句是SQL中最常用的命令之一,用于从数据库表中选择数据。
### SELECT语句的功能:1. **数据检索**:使用`SELECT`语句,可以从一个或多个表中检索数据。
2. **条件过滤**:结合`WHERE`子句,可以过滤出满足特定条件的数据。
3. **排序数据**:使用`ORDER BY`子句,可以对检索出的数据进行排序。
4. **聚合函数**:可以使用聚合函数(如`SUM`、`AVG`、`MAX`、`MIN`等)对数据进行计算。
5. **分组和汇总**:结合`GROUP BY`子句,可以对数据进行分组,并使用聚合函数进行汇总。
6. **连接表**:通过`JOIN`操作,可以将多个表中的数据连接起来。
7. **子查询**:可以在`SELECT`语句中使用子查询来获取额外的数据。
### SELECT语句的基本格式:```sqlSELECT 列1, 列2, ...FROM 表名WHERE 条件;* `SELECT`后面跟着要选择的列名,用逗号分隔。
* `FROM`后面是表名。
* `WHERE`子句用于过滤结果,后面跟着条件表达式。
### 示例:1. **选择所有列**:```sqlSELECT * FROM Employees;```2. **选择特定列**:```sqlSELECT FirstName, LastName FROM Employees;```3. **带有条件的查询**:```sqlSELECT FirstName, LastName FROM Employees WHERE Department = 'IT';```4. **排序结果**:```sqlSELECT FirstName, LastName FROM Employees ORDER BY Salary DESC;5. **聚合函数**:```sqlSELECT Department, AVG(Salary) AS AverageSalary FROM Employees GROUP BY Department;```6. **连接表**(以两个表为例):假设有两个表:`Employees`和`Departments`。
通用的SQL语句
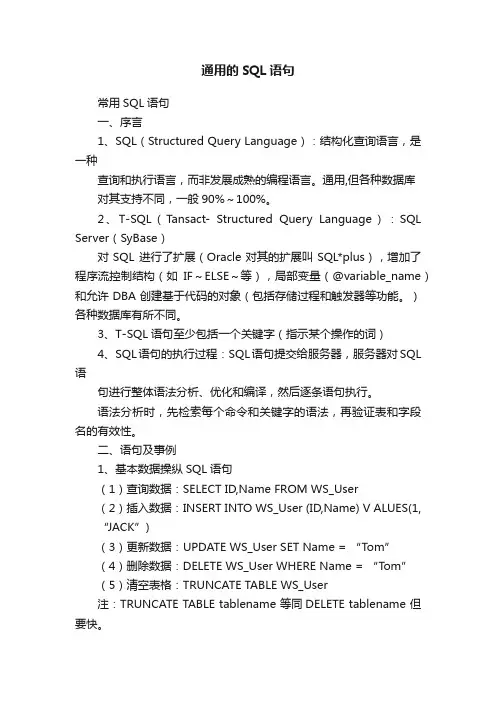
通用的SQL语句常用SQL语句一、序言1、SQL(Structured Query Language):结构化查询语言,是一种查询和执行语言,而非发展成熟的编程语言。
通用,但各种数据库对其支持不同,一般90%~100%。
2、T-SQL(Tansact- Structured Query Language):SQL Server(SyBase)对SQL 进行了扩展(Oracle对其的扩展叫SQL*plus),增加了程序流控制结构(如IF~ELSE~等),局部变量(@variable_name)和允许DBA创建基于代码的对象(包括存储过程和触发器等功能。
)各种数据库有所不同。
3、T-SQL语句至少包括一个关键字(指示某个操作的词)4、SQL语句的执行过程:SQL语句提交给服务器,服务器对SQL 语句进行整体语法分析、优化和编译,然后逐条语句执行。
语法分析时,先检索每个命令和关键字的语法,再验证表和字段名的有效性。
二、语句及事例1、基本数据操纵SQL语句(1)查询数据:SELECT ID,Name FROM WS_User(2)插入数据:INSERT INTO WS_User (ID,Name) V ALUES(1, “JACK”)(3)更新数据:UPDATE WS_User SET Name = “T om”(4)删除数据:DELETE WS_User WHERE Name = “T om”(5)清空表格:TRUNCATE TABLE WS_User注:TRUNCATE TABLE tablename 等同DELETE tablename 但要快。
2、基本语句的扩展1)查询数据(SELECT)SELECT [ ALL | DISTINCT ][ { TOP integer | TOP integer PERCENT } ]< select_list >[ INTO new_table ][ FROM { < table_source > } [ ,...n ] ][ WHERE < search_condition > ][ GROUP BY [ ALL ] group_by_expression [ ,...n ][ HA VING < search_condition > ][ ORDER BY order_expression [ ASC | DESC ] ]例子:1、SELET * FROM WS_UserSELECT UserName,unit FROM WS_User2、SELECT UserName unit FROM WS_User //将unit作为列UserName的列名,相当于SELECT UserName AS unit FROM WS_User3、SELET [ALL]DISTINCT UserName,unit FROM WS_User //ALL是默认的,允许显示重复行,DISTINCT的作用范围是整个选择列表,而非单列。
SQL基本命令(适用初级自学)

when job_level = '1' then e_wage*1.08 <br />
when job_level = '2' then e_wage*1.07 <br />
when job_level = '3' then e_wage*1.06 <br />
select stockname from table1 <br />
union [all] ----- union合并查询结果集,all-保留重复行 <br />
select stockname from table2 <br />
***insert*** <br />
insert into table_name (Stock_name,Stock_number) value ("xxx","xxxx") <br />
alter table table_name drop constraint Stockname_default ---- 删除Stockname的default约束 <br />
***function(/*常用函数*/)*** <br />
----统计函数---- <br />
AVG --求平均值 <br />
--------- 只能在使用like关键字的where子句中使用通配符) <br />
or stockpath = 'stock_path' <br />
db2日常运维常用CLP命令和SQL语句
=============================================================== ===========================================================系统命令=========================================================================================================== ========================也就是直接在db2环境变量下直接敲就可以的,这些命令都可以再产品目录下找到●db2le vel 查看数据库版本●db2ilis t 查看实例●d b2icr t -aSERVE R -sese -p db2c_bnd8inst -ubnd8f enc b nd8in st 创建实例●d b2idr op xx inst删除实例●db2s tart启动数据库实例(数据库跟随实例启动,不能单独关闭和启动数据库)●db2st op 关闭数据库实例●d b2sto p for ce 强制停止●d b2iau to -o n tes tinst系统启动实例自动启动●db2iauto -off test inst系统启动实例不自动启动●db2samp l 创建例库●db2tbst十六进制状态码可以显示表空间状态●db2mo ve db nameexpor t 备份数据●db2move dbna me im port恢复数据●db2ck bkp -h BTA DB.0.btain st.NO DE0000.CAT N0000.20120206132720.001查看数据库备份。
常用经典SQL语句大全完整版-权威人士总结出的-详解+实例
下列语句部分是Mssql语句,不可以在access中使用。
SQL分类:DDL—数据定义语言(CREATE,ALTER,DROP,DECLARE)DML—数据操纵语言(SELECT,DELETE,UPDATE,INSERT)DCL—数据控制语言(GRANT,REVOKE,COMMIT,ROLLBACK)首先,简要介绍基础语句:1、说明:创建数据库CREATE DATABASE database-name2、说明:删除数据库drop database dbname3、说明:备份sql server--- 创建备份数据的deviceUSE masterEXEC sp_addumpdevice ‟disk‟, ‟testBack‟, ‟c:\mssql7backup\MyNwind_1.dat‟--- 开始备份BACKUP DATABASE pubs TO testBack4、说明:创建新表create table tabname(col1 type1 [not null] [primary key],col2 type2 [not null],..)根据已有的表创建新表:A:create table tab_new like tab_old (使用旧表创建新表)B:create table tab_new as select col1,col2… from tab_old definition only5、说明:删除新表:drop table tabname6、说明:增加一个列:Alter table tabname add column col type注:列增加后将不能删除。
DB2中列加上后数据类型也不能改变,唯一能改变的是增加varchar类型的长度。
7、说明:添加主键:Alter table tabname add primary key(col)说明:删除主键:Alter table tabname drop primary key(col)8、说明:创建索引:create [unique] index idxname on tabname(col….)删除索引:drop index idxname注:索引是不可更改的,想更改必须删除重新建。
create table text sql语法
create table text sql语法SQL(Structured Query Language)是一种用于管理和操作关系数据库的编程语言。
在SQL中,CREATE TABLE语句用于创建数据库表。
在本文中,我们将学习如何使用CREATE TABLE语句创建表,并了解其基本语法。
CREATE TABLE是SQL中最常用的命令之一,它允许我们定义表的结构并指定列的名称、数据类型和约束。
下面是CREATE TABLE语句的基本语法:CREATE TABLE 表名 (列名1 数据类型1 约束1,列名2 数据类型2 约束2,列名3 数据类型3 约束3,...);现在让我们详细介绍CREATE TABLE语句的各个部分:1. 表名:指定要创建的表的名称。
表名应该是唯一的,并且应该遵循一些命名规则,如不包含特殊字符、不以数字开头等。
2. 列名:定义表中的列。
每个列名应该是唯一的,并且应该遵循一些命名规则,如不包含特殊字符、不以数字开头等。
3. 数据类型:指定每个列所允许的数据类型。
常见的数据类型包括整数(INT)、字符(CHAR/VARCHAR)、日期(DATE)、布尔值(BOOL)等。
4. 约束:定义对列值的限制。
可以使用约束来保证数据的完整性和一致性,如主键约束(PRIMARY KEY)、唯一性约束(UNIQUE)、非空约束(NOT NULL)等。
下面是一个实际的例子,展示了如何使用CREATE TABLE语句创建一个名为"employees"的表:CREATE TABLE employees (id INT PRIMARY KEY,name VARCHAR(50) NOT NULL,age INT,salary DECIMAL(10,2));在上面的例子中,我们创建了一个名为"employees"的表,其中包含了id、name、age和salary四个列。
数据库SQL语言中的常见操作命令
数据库SQL语言中的常见操作命令数据库SQL语言是关系型数据库中最常用的查询语言,通过SQL语句可以对数据库进行增删改查等常见操作。
下面将介绍数据库SQL语言中的常见操作命令。
一、查询命令数据库中最常见的操作就是查询,查询命令分为两种基本类型:选择查询和聚集查询。
选择查询:通过SELECT语句查询数据库表中的指定列数据。
语法格式如下:SELECT column_name1, column_name2, ... FROM table_name;其中column_name为指定查询的列名,table_name为要查询的数据表名称。
如果要查询所有列,可以使用“*”通配符代替列名,语法格式如下:SELECT * FROM table_name;聚集查询:通过SUM、COUNT、AVG、MAX、MIN等聚集函数统计表中的数据。
语法格式如下:SELECT COUNT(*) FROM table_name; -- 查询表数据总条数SELECT SUM(column_name) FROM table_name; -- 查询指定列数据总和SELECT AVG(column_name) FROM table_name; -- 查询指定列数据平均值SELECT MAX(column_name) FROM table_name; -- 查询指定列数据最大值SELECT MIN(column_name) FROM table_name; -- 查询指定列数据最小值二、插入命令插入命令用于向数据表中添加新记录,使用INSERT语句实现。
语法格式如下:INSERT INTO table_name (column_name1, column_name2, ...) VALUES (value1, value2, ...);其中table_name为要插入数据的表名,column_name为要插入数据的字段名,value为要插入数据的值。