
数据结构第四五六七章作业答案
数据结构第四五六七章作业答案
数据结构第四、五、六、七章作业答案
第四章和第五章
一、填空题
1.不包含任何字符(长度为0)的字符串称为空字符串;由一个或多个空格(仅空格
字符)组成的字符串称为空白字符串。
2.设s=“a;/document/mary.doc”,则strlen(s)=20,“/”的位置为3。
3.子串的定位操作称为串模式匹配;匹配的主字符串称为目标字符串,子字符串称为
模式。
4、串的存储方式有顺序存储、堆分配存储和块链存储
5.有一个二维数组a[0:8,1:5],每个数组元素用四个相邻字节存储,内存用字节寻址。
假设存储阵列元素a[0,1]的地址为100,如果以主行顺序存储,则a[3,5]的地址为176,[5,3]的地址为208。
如果按列存储,[7,1]的地址为128,[2,4]的地址为216。
6、设数组a[1…60,1…70]的基地址为2048,每个元素占2个存储单元,若以列序为
主序顺序存储,则元素a[32,58]的存储地址为8950。
7、三元素组表中的每个结点对应于
稀疏矩阵的一个非零元素,它包含有三个数据项,分别表示该元素的行下标、列下标和元
素值。
8、二维数组a[10][20]采用列序为主方式存储,每个元素占10个存储单元,且
a[0][0]的存储地址是2000,则a[6][12]的地址是3260
9.已知二维数组a[20][10]按行顺序存储,每个元素占2个存储单元,a[10][5]的存
储地址为1000,则a[18][9]的存储地址为116810。
已知二维数组a[10][20]按行顺序存储,每个元素占2个存储单元,a[0][0]的存储地址为1024,则a[6][18]的地址为130011,两个字符串相等。
充要条件是长度相等,相应位置的字符相同。
12、二维数组a[10][20]采用列序为主方式存储,每个元素占一个存储单元,并且
a[0][0]的存储地址是200,则a[6][12]的地址是200+(12*10+6)=326。
二、单选题
1、串是一种特殊的线性表,其特殊性体现在(b)a.可以顺序存储b.数据元素是
一个字符c.可以链式存储d.数据元素可以是多个字符
2.有两个字符串P和Q。
查找P中Q的第一个位置的操作称为(b)A.连接b.模式匹
配C.查找子字符串D.查找字符串长度
3.设串s1=’abcdefg’,s2=’pqrst’,函数con(x,y)返回x和y串的连接串,subs(s,i,j)返回串s的从序号i开始的j个字符组成的子串,len(s)返回串s的长度,则con(subs(s1,2,len(s2)),subs(s1,len(s2),2))的结果串是(d)
a.bcdefb.bcdefgc.bcpqrstd.bcdefef4。
假设包含60行70列的二维数组
a[1…60,1…70]按主顺序存储,其基址为10000,每个元素占2个存储单元,则第32行和第58列中元素a[32,58]的存储地址为(a)。
(第0行和第0列中没有元素)
a.16902b.16904c.14454d.答案a,b,c均不对5、下面关于串的的叙述中,(b)是不正确的。
a、字符串是一个有限的字符序列。
B.空字符串是由空格组成的字符串。
模式匹配是字符串的一项重要操作。
D.字符串可以按顺序或链式存储
6.设矩阵a是一个对称矩阵,为了节省存储,将其下三角部分(如下图所示)按行序存放在一维数组b[1,n(n-1)/2]中,对下三角部分中任一元素ai,j(i≤j),在一维数组b 中下标k的值是(b)
a1,1aa2,12,2?A.安,1安,2?安,n a、 i(i-1)/2+j-1b、i
(i-1)/2+jc、i(i+1)/2+j-1d、i(i+1)/2+j
7.有一个二维数组a,行下标的范围是1到6,列下标的范围是0到7,每个数组元素用相邻的6个字节存储,存储器按字节编址。
那么,这个数组的体积是a个字节。
假设存储数组元素a[1,0]的第一个字节的地址是0,则存储数组a的最后一个元素的第一个字节的地址是b。
若按行存储,则a[2,4]的第一个字节的地址是c。
若按列存储,则a[5,7]的第一个字节的地址是d。
备选答案:a~d:① 12② 66③ 72④ 96⑤ 114⑥ 120⑦ 156⑧ 234⑨ 276⑩ 答案:ABCD=12,10,3,9
8、以下关于广义表的叙述中,正确的是(a)a)广义表是由0个或多个单元素或子表构成的有限序列b)广义表至少有一个元素是子表
c)通用表不能递归定义(d)通用表不能为空
9、设a是n*n的对称矩阵,将a的对角线及对角线上方的元素以列为主的次序存放在一维数组b[1..n(n+1)/2]中,对上述任一元素aij(1≤i,j≤n,且i≤j)在b中的位置为(b)。
a、 i(i-l)/2+jb。
j(j-l)/2+ic。
j(j-l)/2+i-1d。
i(i-l)/2+j-1
10.设a[n,n]是对称矩阵,将其下三角(包括对角线)以行序存储到一维数组t[n (n+1)/2]中,则:任意一个上三角元素a[i][j]所对应t[k]的下标k是(b)。
a、 i(i-1)/2+jb。
j(j-1)/2+ic。
i(j-i)/2+1d。
j(i-1)/2+1
11、常对数组进行的两种基本操作是(c)。
a.建立与删除
b、索引和修改
c.查找和修改
d、搜索和索引
12、就一般情况而言,当(c)时,按行存储的a[i,j]地址与按列存储的a[j,i]地址相等。
a、行和列的上限相同。
B.行和列的下限相同。
C.行和列的上限和下限相同。
D.行和列中的元素数量相同
13、二维数组m的成员是6个字符(每个字符占一个存储单元,即一个字节)组成的串,行下标i的范围从0到8,列下标j的范围从1到10,则存放m至少需要(d①)个字节;m的第8列和第5行共占(②b)个字节。
①a.90
b、 180
c.240
d、 540
②a.108
b、 114
c.54
d、 60
14、数组a中,每个元素a的长度为3个字节,行下标i从1到8,列下标j从1到10,从首地址sa开始连续存放在存储器内,存放该数组至少需要的单元数是(c)。
a.80
b、一百
c.240
d、 270
15、数组a中,每个元素a的长度为3个字节,行下标i从1到8,列下标j从1到10,从首地址sa开始连续存放在存储器内,该数组按行存放时,元素a[8][5]的起始地址为(c)a.sa+141(c)
a、 o(n)
b.o(log2n)
c、 o(1)
d.o(n2)
17、
b.sa+144
c、 sa+222
d.sa+225
16.如果一维数组中有n个数组元素,则读取第i个数组元素的平均时间复杂度为
三、判断题
1. (√) 子字符串是由主字符串中的任何连续字符组成的序列。
2、(√)广义表(((a),b),c)的表头是((a),b),表尾是(c)。
3、(×)数组元素的
下标值越大,存取时间越长
4.数组是线性结构的推广,所以像线性表一样,它可以被插入、删除和其他操作。
(×)
⒋(×)设有两个串p和q,求q在p中首次出现的位置的运算称作求子串。
⒌(√)二维数组是其数据元素为线性表的线性表。
6.(W)如果使用三重压缩技术存储稀疏矩阵,则只要交换每个元素的行下标和列下标,矩阵的转置就完成了。
7、(w)若一个广义表的表头为空表,则此广义表亦为空表。
8、(w)用一维数组存储二
叉树时,总是以前序遍历存储节点。
9.当使用堆分配存储字符串时,字符串仍然存储在一组具有连续地址的存储单元中,
但存储空间是在程序执行期间通过动态分配获得的。
(√)
四、问答题。
数据结构肖启宏课后习题答案第四章
一. 名词解释(1)栈——只允许在一端进行插入或删除操作的线性表称为栈。
其最大的特点是“后进先出”。
(2)顺序栈——采用顺序存储结构的栈称为顺序栈。
(3)链栈——采用链式存储结构的栈称为链栈。
(5)队列——只允许在一端进行插入,另一端进行删除操作的线性表称为队列。
其最大的特点是“先进先出”。
(6)顺序队列——采用顺序存储结构的队列称为顺序队列。
(7)链队列——采用链式存储结构的称队列为链队列。
(8)循环队列——为了解决顺序队列中“假溢出”现象,将队列的存储空间想象为一个首尾相链的环(即把队头元素与对尾元素链结起来),存储在其中的队列称为循环队列。
二.判断题(下列各题,正确的请在前面的括号内打√;错误的打ㄨ)(1)√(2)√(3)ㄨ(4)ㄨ(5)ㄨ(6)ㄨ(7)√(8)√(9)ㄨ(10)√(11)ㄨ(12)ㄨ三. 填空题(1)后进先出(2)栈顶栈底(3)栈空栈满(4)O(1)O(1)(5)必须一致(6)栈(7)栈空(8)p->next=top top=p(9)- - + +(10)LS->next 首(11)先进先出(12)队尾队头(13)队列是否为空队列是否为满(14)可变的(15)-1 NULL(16)O(n) O(1) O(1) O(1)(17)front==rear front==(rear+1)% MAXLEN MAXLEN-front (18)空只含有一个结点(19)front==rear && front <>NULL(20)队尾指针写入四. 选择题(1)C (2)A (3)D (4)B (5)C(6)D (7)B (8)A (9)A (10)D(11)A (12)A (13)C (14)A (15)B (16) A五、简答题答:n个(同类)数据元素的有限序列称为线性表。
线性表的特点是数据元素之间存在“一对一”的关系。
栈和队列都是操作受限制的线性表,它们和线性表一样,数据元素之间都存在“一对一”的关系。
数据结构第七章习题答案

第七章图
1.下面是一个图的邻接表结构,画出此图,并根据此存储结构和深度优先搜索算法写出从C开始的深度优先搜索序列。
1
2
3
4
5
【解答】
A B F
C D E
C开始的深度优先搜索序列:CDEABF(唯一的结果)
2.假定要在某县所辖六个镇(含县城)之间修公路,若镇I和镇J 之间有可能通过道路连接,则Wij表示这条路的长度。
要求每个镇都通公路且所修公路总里程最短,那么应选择哪些线路来修。
(1).画出该图。
(2).用C语言描述该图的数组表示法存储结构,并注明你所使用变量
的实际含义。
(3).图示你所定义的数据结构。
(4).标识出你选择的线路。
【解答】 (1)
(2)
#define MAX 6 typedef struct {
char vexs[MAX]; // 顶点信息 int arcs[MAX][MAX]; // 边的信息
int vexnum, arcnum; // 顶点数,边数 } MGraph; (3)略
(4){(1,3), (3,4), (2,4), (4,5), (5,6)}
3.图G 如下所示。
(1).给出该图的所有强连通分量。
(2).在图中删除弧<2,1>,然后写出从顶点1开始的拓扑有序序列。
5
4
6
1
3
2
4
15 10
2
15
20
30
4
10
10
【解答】
(1) 共4个强连通分量:
(2) 1,3,2,6,5,4。
数据结构课后习题答案第七章
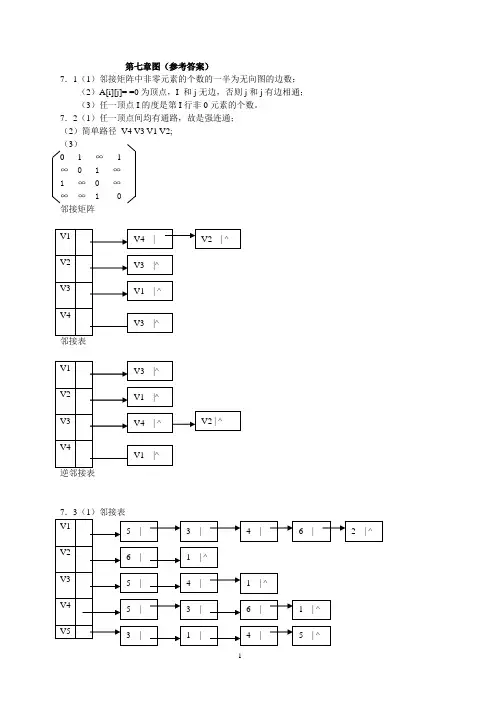
第七章图(参考答案)7.1(1)邻接矩阵中非零元素的个数的一半为无向图的边数;(2)A[i][j]= =0为顶点,I 和j无边,否则j和j有边相通;(3)任一顶点I的度是第I行非0元素的个数。
7.2(1)任一顶点间均有通路,故是强连通;(2)简单路径V4 V3 V1 V2;(3)0 1 ∞ 1∞ 0 1 ∞1 ∞ 0 ∞∞∞ 1 0邻接矩阵邻接表(2)从顶点4开始的DFS序列:V5,V3,V4,V6,V2,V1(3)从顶点4开始的BFS序列:V4,V5,V3,V6,V1,V27.4(1)①adjlisttp g; vtxptr i,j; //全程变量② void dfs(vtxptr x)//从顶点x开始深度优先遍历图g。
在遍历中若发现顶点j,则说明顶点i和j间有路径。
{ visited[x]=1; //置访问标记if (y= =j){ found=1;exit(0);}//有通路,退出else { p=g[x].firstarc;//找x的第一邻接点while (p!=null){ k=p->adjvex;if (!visited[k])dfs(k);p=p->nextarc;//下一邻接点}}③ void connect_DFS (adjlisttp g)//基于图的深度优先遍历策略,本算法判断一邻接表为存储结构的图g种,是否存在顶点i //到顶点j的路径。
设 1<=i ,j<=n,i<>j.{ visited[1..n]=0;found=0;scanf (&i,&j);dfs (i);if (found) printf (” 顶点”,i,”和顶点”,j,”有路径”);else printf (” 顶点”,i,”和顶点”,j,”无路径”);}// void connect_DFS(2)宽度优先遍历全程变量,调用函数与(1)相同,下面仅写宽度优先遍历部分。
《数据结构》各章课后作业答案
《数据结构》各章课后作业答案 第一章 绪论课后作业答案1. 简述线性结构与非线性结构的不同点。
答:线性结构反映结点间的逻辑关系是一对一的,非线性结构反映结点间的逻辑关系是多对多的。
2.分析下面各程序段的时间复杂度(每小题5分,共20分)解:1.第一个for 循环执行n+1次,第二个for 循环执行n(m+1)次,A[i][j]=0;语句执行n*m 次,此程序段总的执行次数为n+1+n*(m+1)+n*m=2nm+2n+1次。
故时间复杂度为O(n*m)。
2.算法的时间复杂度是由嵌套最深层语句的执行次数决定的,本程序段嵌套最深层语句为:s+=B[i][j];它的执行次数为n 2,所以本程序段的时间复杂度是O(n 2)。
3. 该算法的基本操作是语句x++, 其语句频度为:1111n n i i j --==∑∑=10()n i n i -=-∑=(1)2n n - 所以本程序段的时间复杂度是O(n 2)。
4.设语句执行m 次,则有3m≤n ⇒m ≤log 3n所以本程序段的时间复杂度为O(log 3n)。
第二章 线性表课后作业答案1. 填空题。
(1)在顺序表中插入或删除一个元素,需要平均移动表中一半元素,具体移动的元素个数与表长和该元素在表中的位置有关。
(2)线性表中结点的集合是 有限 的,结点间的关系是 一对一的。
(2)s=0;for (i=0; i<n; i++)for(j=0; j<n; j++) s+=B[i][j]; sum=s; 答:O (n 2)(1) for (i=0; i<n; i++) for (j=0; j<m; j++) A[i][j]=0;(3) x=0;for(i=1; i<n; i++)for (j=1; j<=n-i; j++)x++;(4)i=1;while(i<=n)i=i*3;(3)向一个长度为n的向量的第i个元素(1≤i≤n+1)之前插入一个元素时,需向后移动 n-i+1 个元素。
数据结构第四章的习题答案
数据结构第四章的习题答案数据结构第四章的习题答案在学习数据结构的过程中,习题是非常重要的一环。
通过解答习题,我们可以更好地理解和应用所学的知识。
在第四章中,我们学习了树和二叉树的相关概念和操作。
下面我将为大家提供一些第四章习题的答案,希望能帮助大家更好地掌握这一章节的内容。
1. 请给出树和二叉树的定义。
树是由n(n>=0)个结点构成的有限集合,其中有且仅有一个特定的结点称为根结点,其余的结点可以分为若干个互不相交的有限集合,每个集合本身又是一个树,称为根的子树。
二叉树是一种特殊的树结构,其中每个结点最多有两个子结点,分别称为左子结点和右子结点。
二叉树具有递归的定义,即每个结点的左子树和右子树都是二叉树。
2. 请给出树和二叉树的遍历方式。
树的遍历方式包括前序遍历、中序遍历和后序遍历。
前序遍历是先访问根结点,然后依次遍历左子树和右子树。
中序遍历是先遍历左子树,然后访问根结点,最后遍历右子树。
后序遍历是先遍历左子树和右子树,最后访问根结点。
二叉树的遍历方式包括前序遍历、中序遍历和后序遍历。
前序遍历是先访问根结点,然后依次遍历左子树和右子树。
中序遍历是先遍历左子树,然后访问根结点,最后遍历右子树。
后序遍历是先遍历左子树和右子树,最后访问根结点。
3. 给定一个二叉树的前序遍历序列和中序遍历序列,请构建该二叉树。
这个问题可以通过递归的方式解决。
首先,根据前序遍历序列的第一个结点确定根结点。
然后,在中序遍历序列中找到根结点的位置,该位置左边的结点为左子树的中序遍历序列,右边的结点为右子树的中序遍历序列。
接下来,分别对左子树和右子树进行递归构建。
4. 给定一个二叉树的中序遍历序列和后序遍历序列,请构建该二叉树。
和前面的问题类似,这个问题也可以通过递归的方式解决。
首先,根据后序遍历序列的最后一个结点确定根结点。
然后,在中序遍历序列中找到根结点的位置,该位置左边的结点为左子树的中序遍历序列,右边的结点为右子树的中序遍历序列。
数据结构c语言版课后习题答案完整版
第1章绪论5.:CCBDCA6.分析下面各程序段的复度。
1〕O〔1〕2〕O〔m*n〕3〕O〔n2〕4〕O〔log3n〕〔5〕因x++共行了n-1+n-2+⋯⋯+1=n(n-1)/2,所以行O〔n2〕〔6〕O( n)第2章线性表1.babadbcabdcddac2.算法〔6〕一个算法,通一趟遍在表中确定最大的点。
ElemTypeMax(LinkListL){if(L->next==NULL)returnNULL;pmax=L->next;// 假定第一个点中数据具有最大p=L->next->next;while(p!=NULL){// 如果下一个点存在if(p->data>pmax->data)pmax=p;p=p->next;}returnpmax->data;〔7〕一个算法,通遍一趟,将表中所有点的接方向逆,仍利用原表的存空。
voidinverse(LinkList&L){ 逆置点的表Lp=L->next;L->next=NULL;while(p){q=p->next; //q指向*p的后p->next=L->next;L->next=p; //*p插入在点之后p=q;}}〔10〕度n的性表A采用序存构,写一复度O(n)、空复度O(1)的算法,算法除性表中所有item的数据元素。
[目分析] 在序存的性表上除元素,通常要涉及到一系列元素的移〔第个元素,第i+1至第n个元素要依次前移〕。
此题要求删除线性表中所有值为item的数据元素,并未要求元素间的相对位置不变。
因此可以考虑设头尾两个指针〔 i=1,j=n〕,从两端向中间移动,凡遇到值item的数据元素时,直接将右端元素左移至值为item的数据元素位置。
void Delete 〔ElemTypeA[] ,int n〕∥A是有n个元素的一维数组,本算法删除A中所有值为item的元素。
数据结构习题参考答案
数据结构习题参考答案第一章答案一、填空题1.数据元素,数据项2. O(1),O(n),O(log 2n),O(n 2)3.线性结构,非线性结构,顺序结构,链式结构4.无,一,无,一5.前驱,一,无,任意6.任意7. O(n 1/2)8.O(1)<o(2n<="") 第二章答案一、填空题1. n/2,(n-1)/2分析:当在顺序线性表中的第i (1<=i<=n+1)个位置之前插入一个新元素时,从第i 个元素起向后的n+1-i 个元素均要向后移动一个位置。
因此在等概率情况下,插入操作中元素的平均移动次数为∑+==-++=112)1(11)(n i ni n n n f ;当在顺序线性表中删除第i (1<=i<=n )个位置上的元素,从第i+1个元素起向后的n-i 个元素均要向前移动一个位置。
因此在等概率情况下,删除操作中元素的平均移动次数为∑=-=-= n i n i n n n f 121)(1)(。
2.向后3.向前4.指针域5.一定,不一定6. O(n)7. O(n)8.消除空表的特殊性,统一表示和处理空表和非空表的情形,从而简化插入和删除等操作的某些细节。
9.前驱,后继10.O(n)二、填空题1. (1)2. (1)3. (4)4. (2)5. (2)6. (4)7. (4)8. (1)9. (4)10.(1)11.(2)12.(3)第三章参考答案一、填空题1.线性,任何,栈顶,队尾,队头2.先进后出(FILO ),队尾,队头,先进先出(FIFO )3. top==0,top==m4. 235415.前一个位置,所在位置,m-1分析:在顺序循环队列中约定头指针front 和尾指针rear 所指向的位置,是牺牲掉一个存储单元而方便表示队列空和队列满的条件,因此顺序循环队列中实际可用的存储单元只有m-1个。
6. (rear+1)%m==front ,rear==front7. O(1)8.返回地址,返回地址二、选择题1.(3) 2.(3) 3.(3) 4. (2)5. (2)6. (3)7. (1)8. (4)因为:顺序循环队列中的元素个数=??<+-≥-front rear m front rear front rear front rear ,整理合并可写成(rear-front+m)%m 。
数据结构的第4-7习题的答案
4.10 线性表有两种存储结构,即顺序表和单链表。试问: (1)若有N个线性表同时并存,且在处理过程中各表长度会
动态发生变化,线性表的总数也会自动地改变,在此情况下 应选用哪种存储结构?为什么?
应采用链式存储结构,因为采用链式存储时插入删除操作不需 要移动数据元素
(2)若线性表的总数基本稳定,且很少进行插入和删除操作 ,但要以最快的速度存取表中元素,那么应采用哪种存储结 构?为什么?
pq
pq r
rq
head *
A
1
&C
3
$
D
E^
p=NULL r=NULL
Void invert(LinkList &head) { linklist p,q,r;
p=r=NULL; q=head; while(q!=NULL) {r=q->next; q->next=p; p=q; q=r; } head=p; }
3在长度为n的顺序表上进行 插入运算,有几个可插入的 位置?在第i(假设合法)个 位置上插入一个数据元素, 需要向什么方向平移多少个 数据元素?在长度为n的顺 序表上进行删除运算,有几 个可删除的数据元素?删除 第i(假设合法)个位置上的 数据元素,需要向什么方向 平移多少个数据元素?
1
2
第i个位置上插入,需向右移 动n-i+1个数据元素
Status EnQueue(stack &s1,ElemType x) { if(S1.top==n-1) return 0;
else {Push(s1,x); return 1;}} 时间复杂度T(n)=O(1)
Status DeQueue(stack &s1,Stack &s2,ElemType &x) { ElemType y; While(!StackEmpty(S1))
《数据结构》第四章习题参考答案
《数据结构》第四章习题一、判断题(在正确说法的题后括号中打“√”,错误说法的题后括号中打“×”)1、KMP算法的特点是在模式匹配时指示主串的指针不会变小。
( √)2、串是一种数据对象和操作都特殊的线性表。
( √)3、只包含空白字符的串称为空串(空白串)。
( ×)4、稀疏矩阵压缩存储后,必会(不会)失去随机存取功能。
( ×)5、使用三元组表示稀疏矩阵的非零元素能节省存储空间。
( √)6、插入与删除操作是数据结构中最基本的两种操作,因此这两种操作在数组中也经常使用。
(×)7、若采用三元组表存储稀疏矩阵,只要把每个元素的行下标和列下标互换(错的),就完成了对该矩阵的转置运算。
(×)二、单项选择题1.下面关于串的的叙述中,哪一个是不正确的?( B )A.串是字符的有限序列B.空串是由空格构成的串(空串是长度为零的串)C.模式匹配是串的一种重要运算D.串既可以采用顺序存储,也可以采用链式存储2.有串S1=’ABCDEFG’,S2 = ’PQRST’,假设函数con(x,y)返回x和y串的连接串,subs(s,i,j)返回串s的从序号i的字符开始的j个字符组成的子串,len(s)返回中s的长度,则con(subs(s1,2,len(s2)),subs(s1,len(s2),2))的结果串是( D )。
A.BCDEF B.BCDEFG C.BCPQRST D.CDEFGFG3、串的长度是指( B )A.串中所含不同字母的个数B.串中所含字符的个数C.串中所含不同字符的个数D.串中所含非空格字符的个数三、填空题1、串是一种特殊的线性表,其特殊性表现在_数据元素为字符,操作集也不同__;串的两种最基本的存储方式是_顺序存储_、__ 链式存储_;两个串相等的充分必要条件是__两串的长度相等且两串中对应位置的字符也相等__。
2、设正文串长度为n,模式串长度为m,则串匹配的KMP算法的时间复杂度为_O(m+n)__。
数据结构(C语言版清华大学出版社)-章课后部分答案
第八章选择题1. C2.A3.B4.C5.D6.B7.B8.A9.D 10.D 11.C 12.C填空题1.n、n+12. 43.8.25( 折半查找所在块 )4.左子树、右子树5.266.顺序、(n+1)/2、O(log2n)7.m-1、[m/2]-18.直接定址应用题1.进行折半查找时,判定树是唯一的,折半查找过程是走了一条从根节点到末端节点的路径,所以其最大查找长度为判定树深度[log2n]+1.其平均查找长度约为[log2n+1]-1.在二叉排序树上查找时,其最大查找长度也是与二叉树的深度相关,但是含有n个节点的二叉排序树不是唯一的,当对n个元素的有序序列构造一棵二叉排序树时,得到的二叉排序树的深度也为n,在该二叉树上查找就演变成顺序查找,此时的最大查找长度为n;在随机情况下二叉排序树的平均查找长度为1+4log2n。
因此就查找效率而言,二分查找的效率优于二叉排序树查找,但是二叉排序树便于插入和删除,在该方面性能更优。
3. 评价哈希函数优劣的因素有:能否将关键字均匀的映射到哈希表中,有无好的处理冲突的方法,哈希函数的计算是否简单等。
冲突的概念:若两个不同的关键字Ki和Kj,其对应的哈希地址Hash(Ki) =Hash(Kj),则称为地址冲突,称Ki和K,j为同义词。
(1)开放定址法(2)重哈希法(3)链接地址法4.(1)构造的二叉排序树,如图(2)中序遍历结果如下:10 12 15 20 24 28 30 35 46 50 55 68(4)平均查找长度如下:ASLsucc = (1x1+2x2+3x3+4x3+5x3)/12 = 41/128.哈希地址如下:H(35) = 35%11 = 2H(67) = 67%11 = 1H(42) = 42%11 = 9H(21) = 21%11 = 10H(29) = 29%11 = 7H(86) = 86%11 = 9H(95) = 95%11 = 7H(47) = 47%11 = 3H(50) = 50%11 = 6H(36) = 36%11 = 3H(91) = 91%11 = 3第九章选择题1. D2.C3.B4.D5.C6.B7.A8.A9.D 10.D填空题1.插入排序、交换排序、选择排序、归并排序2.移动(或者交换)3.归并排序、快速排序、堆排序4.保存当前要插入的记录,可以省去在查找插入位置时的对是否出界的判断5.O(n)、O(log2n)6.直接插入排序或者改进了的冒泡排序、快速排序7.Log2n、n8.完全二叉树、n/29.1510.{12 38 25 35 50 74 63 90}应用题11.(1)Shell排序(步长为5 3 1)每趟的排序结果初始序列为100 87 52 61 27 170 37 45 61 118 14 88 32步长为5的排序14 37 32 61 27 100 87 45 61 118 170 88 52步长为3的排序结果14 27 32 52 37 61 61 45 88 87 170 100 118步长为1的排序结果14 27 32 37 45 52 61 61 87 88 100 118最后结果14 27 32 37 45 52 61 61 87 88 100 118 170(2)快速排序每趟的排序结果如图初始序列100 87 52 61 27 170 37 45 61 118 14 88 32第一趟排序[32 87 52 61 27 88 37 45 61 14]100[118 170]第二趟排序[14 27]32[61 52 88 37 45 61 87]100 118[170]第三趟排序14[27]32[45 52 37]61[88 61 87]100 118[170]第四趟排序14[27]32[37]45[52]61[87 61]88 100 118[170]第五趟排序14[27]32[37]45[52]61[87 61]88 100 118[170]最后结果14[27]32[37]45[52]61[61]87 88 100 118[170](3)二路归并排序每趟的排序结果初始序列[100][87][52][61][27][170][37][45][61][118][14][88][32]第一趟归并[87 100][52 61][27 170][37 45][61 118][14 88][32]第二趟归并[52 61 87 100][27 37 45 170][14 61 88 118][32]第三趟归并排序[27 37 45 52 61 87 100 170][14 32 61 88 118]第四趟归并排序[14 27 32 37 45 52 61 61 87 88 100 118 170]最后结果14 27 32 37 45 52 61 61 87 88 100 118 17012.采用快速排序时,第一趟排序过程中的数据移动如图:算法设计题1.分析:为讨论方便,待排序记录的定义为(后面各算法都采用此定义):#define MAXSIZE 100 /* 顺序表的最大长度,假定顺序表的长度为100 */ typedef int KeyType; /* 假定关键字类型为整数类型 */typedef struct {KeyType key; /* 关键字项 */OtherType other; /* 其他项 */}DataType; /* 数据元素类型 */typedef struct {DataType R[MAXSIZE+1]; /* R[0]闲置或者充当哨站 */int length; /* 顺序表长度 */}sqList; /* 顺序表类型 */设n个整数存储在R[1..n]中,因为前n-2个元素有序,若采用直接插入算法,共要比较和移动n-2次,如果最后两个元素做一个批处理,那么比较次数和移动次数将大大减小。