
正则表达式_打印版
/g 下 生 效 ; $_=‘abc’;/a/g; 此 时 /\Gb/ 成 功,/\Gc/失败
单词分割符:\b、\B
‘1 23’ =~ m/\b2\B/; 匹配成功
环视:(?=…)、(?!...)、(?<=…)、(?<!...) “a2b3c“ =~ m/[0-9](?=c)/;匹配 3,而不匹配 2
动态表达式:(??{…})
“2a3b1c”
=~
/(\d)(??{if($&
>
1){“a”}else{“c”}})/g 匹配 2 和 1
专属于正则文字的功能
变量插值:$name、@name
@name=(‘a’,’b’); 则 m/@name/; 匹 配 “@name”
大小写转换(对单字符):\l、\u
Unicode 属性 \p{PROP}、\P{PROP} \p{IsASCII} 等效 [\x00-\x7f]
锚点及其它零长度断言(不被捕获)
行/字符串起始位置:^、\A
\A 严格匹配字符串起始位置;^与/m 可多 行匹配
行/字符串结束位置:$、\z、\Z $与\z 区别同上;$与\Z 等同
前一次匹配的结束位置:\G
元字符
\...、…|…、(…)、[…]、^、.、$、{} 特殊字符
[a-z]匹配小写字母、^ab 匹配’ab’开头的字 符串
\0、\a、\e、\f、\n、\r、\t、[\b] \0 匹配空字符、[\b]匹配退格符
各进制及控制字符
\NNN、\xhex、\x{hex}、\cchar
\23 匹配 023、\cA 匹配 ctrl+a
固化分组:(?>…)
‘ab’ =~ m/(?>.*)b/;匹配失败,’ab’被吞后未 释放‘b’
多选结构:|
(a|b)匹配’a’或’b’;(?:a|b)也匹配’a’或’ b’,且不捕获
条件判断:(?if then | else)
‘a1b8a9b2‘=~m/(?(?<=a)([0-5])|([6-9]))/g 匹 配’1’和’8’
m/a\ubcd/;匹配 ‘aBc’
大小写转换范围:\U、\L…\E
m/a\Ubc\Ed/; 匹配 ‘aBCd’
文字文本范围:\Q…\E (与函数 quotemeta 等价)
$insert = ‘$’; m/a\Q$insert\Eb/; 匹配 ‘a$b’
命名的 Unicode 字符:\N{name}
1. 必须先 use charnames ‘:full’;
2. 具体支持的 Unicode 字符列表可
查看文
件
lib/unicore/UnicodeData.txt
\N{GREEK SMALL LETTER ALPHA}匹配α,即 \x03b1
修饰词 /s /m
含义 令 . 匹配换行符,并且忽略不建议使用的 $* 变量 令 ^ 和 $ 匹配下一个嵌入的 \n
字符组及相关结构
[…]、[^…]、POSIX 风格的[:CLASS:] [^ab]匹配非 a 且非 b、[[:lower:]]匹配小写字 符
经典字符类\d、\D、\s、\S、\w、 \d 在 单 字 节 时 等 效 [0-9] 、 utf8 时 等 效
\W
\p{IsDigit}
\C
匹配单个字节(有危险)
贪婪量词:*、+、?、{n}、{n,}、{x,y} ‘abcdc’=~m/a.*c/; 匹配 ‘abcdc’
非贪婪量词:*?、{x,y}?等
‘abcdc’=~m/a.*?c/; 匹配 ‘abc’
内嵌代码:(?{…})
‘a2c3d’=~m/([0-9])(?{print $’,”-”})/g; 打 印 c3d-d-
注释和模式修饰符
模式修饰符:(?xsmi-xsmi) 模式修饰作用范围:(?xsmi:) 注释:(?#...)
m/foo((?x-i) bar )/i; 为 bar 打开/x,关闭/i
m/a (?i:b) c/; 匹配’a b c’和’a B c’
m/Байду номын сангаасge=(?# 紧 跟 一 个 数 字 )\d+/; 匹 配 age=18 等
分组、捕获、条件判断和控制
捕获型括号:(…)、\1、$1、$+、 s/(\d)a/\1/g; 将 1a2a 换成 12
$^N、$`、$&、$’、@-、@+
$`、$&、$’分别为匹配前、中、后的文本
非捕获型括号(用于分组):(?:…) ‘ab’ =~ m/(?:a)(b)/; 则$1 为’b’而非’a’
实验五 正则表达式、AOM、WSH

– a..b:以a开头,b结尾,中间包括2个任意字符的长度为4的字符串
• \W:用于匹配所有与\w不匹配的字符;
《软件测试工具》
SEI of ECNU 版权所有©
1-11
练习1 理解正则表达式
‘q[^u]’可否匹配Qantas或者Iraq? ‘gr[ea]y’,’grey|gray’,’gr(a|e)y’,’gra|ey’ ,’gr[a|e]y’几个表达式中哪些含义是一致的? ‘^good$’,’^$’,’^’的含义是什么 若希望匹配,表达为 ’’正确吗?为什么?
《软件测试工具》
SEI of ECNU 版权所有©
1-9
元字符
常用的元字符
限定符:用于指出在匹配对象出现的频率
• “^”:指定起始字符
– ^[0-9]+[a-z]* 符串 :以至少1个数字开头,后接任意个小写字母的字
• “$”:指定结束字符
– ^[0-9]\-[a-z]+$:以1个数字开头后接连字符“–”,并以至少1个小写 字母结尾的字符串
Set Matches = regEx.Execute(strng) ' 执行搜索。 For Each Match in Matches RetStr = RetStr & "Match found at position " RetStr = RetStr & Match.FirstIndex & ". Match Value is '" RetStr = RetStr & Match.Value & "'." & vbCRLF Next RegExpTest = RetStr End Function MsgBox(RegExpTest("is.", "IS1 is2 IS3 is4"))
正则表达式150种表达方式

正则表达式150种表达方式1、删除所有数字。
只要查找:\d就OK。
为了不留空行:替换处:\d2、删除所有英文字母。
只要查找:\a就OK。
为了不留空行:替换处:\d3、删除除换行符以外的所有。
只要查找:. 为了不留空行:替换处:\d4、既删除英文字母又删除数字。
只要查找:\w。
为了不留空行:替换处:\d5、删除数字加字母加等于(如:3a=或3zz=)只要查找:\d+\a+\=。
为了不留空行:替换处:\d6、删除换行。
只要查找:$。
替换处:\d(还原查找:\a+=\f。
替换:\0\n)。
如在换行后加一空格,查找:(\a)$。
替换:\0 \d。
7、删除空行只要查找:^$。
为了不留空行:替换处:\d8、删除首尾空格。
只要查找:^\s*|\s*$就OK9、删除行前数字及顿号。
只要查找:\d+、替换为空10、删除末尾标点符号。
只要查找:\P+$|\P+\s+$,“|”前面是没有空格的,“|”后面有空格,P后的加是为了……而用的。
11、删除末尾空格。
只要查找:\s+$。
替换为空。
12、删除第一个字如:“的我们”中的“的”只要查找:^\的。
13、删除第几个字。
查找:查找:^().(.+)。
替换:\1\2。
去掉前面的拼音:查找:^\a+替换为空。
第一个括号里可加“.”且可变。
14、删含的。
查:.*的.*替:\d。
的头查:.*=的.*替:\d。
的尾查:\a.*\c.*的$替:\d(留它不匹配)●删非的行查:^[^的]+$替:\d15、删除几码以上的码查:^(...)...替:\1。
删第几位码。
查:^(...).(.+)替:\1\2(变成\1,\2则其位则改成,了)首括号的.可变。
16、删除各类型的几字词,但必须是码前词后或纯词。
三字词:查找:^\~f{}\f{3}$替换:\d。
替换:\d “3”可以改。
17、删除11字词及其以上的词条查找(自定义格式):\a{}\=(\c|\P|\p){11,}。
替换:\d。
11可改。
《正则表达式》课件

06
CATALOGUE
正则表达式的扩展与优化
正则表达式的扩展(如Unicode、命名组等)
Unicode支持
正则表达式内置了对Unicode字符集 的支持,可以使用诸如`uXXXX`的语 法来表示任意Unicode字符。
命名组
通过使用命名组,可以将匹配的子模 式进行有意义的命名,方便后续引用 和处理。
正则表达式在线测试工具是一种方便快捷的工具,用于测试 和验证正则表达式的正确性。通过在线测试工具,用户可以 输入正则表达式和测试字符串,并实时查看匹配结果,从而 快速定位问题并进行调整。
常用的正则表达式在线测试工具包括Regex101、RegExr、 RegexPal等。这些工具通常提供丰富的正则表达式语法高亮 显示、匹配模式选择、可视化匹配过程等功能,帮助用户更 好地理解和使用正则表达式。
字符串分割
总结词
正则表达式还可以用于字符串的分割操 作,将一个字符串按照特定的模式分割 成多个部分。
VS
详细描述
在字符串分割中,正则表达式可以用来将 一个字符串按照特定的模式分割成多个部 分。例如,可以使用正则表达式来将一个 包含逗号分隔的字符串分割成多个独立的 元素,或者将一个包含特定分隔符的字符 串分割成多个段落或行。
《正则表达式》 PPT课件
目录
• 正则表达式概述 • 正则表达式的语法规则 • 正则表达式的应用实例 • 正则表达式的常见问题与解决方案 • 正则表达式的工具与库 • 正则表达式的扩展与优化
01
CATALOGUE
正则表达式概述
什么是正则表达式
总结词
正则表达式是一种用于描述字符串中模式的强大工具。
04
CATALOGUE
正则表达式的常见问题与解决方案
C语言正则表达式

C语⾔正则表达式在很多⼈看来,正则表达式看上去古怪且复杂,因此往往不想去触及或使⽤。
如果我们抛开这种“畏难”⼼理,在经过循序渐进地学习之后,就会发现这些复杂的表达式其实写起来还是相当简单的。
⼀旦它被你所“驯服”,就可利⽤正则表达式把原需数⼩时⾟苦且易错的⽂本处理⼯作压缩在⼏分钟(甚⾄⼏秒钟)内完成。
正则表达式定义正则表达式(regular expression)是Linux系统中⼀种⾮常重要的字符串搜索模式,是⼀组规则字符的集合。
这些规则字符能够组成我们所需要的搜索规则,效率⾼、功能强,可以极⼤地简化处理字符串时的复杂度。
在很多Linux⼯具(sed、grep、find等)和脚本语⾔(awk、perl等)中都有着重要的地位。
当我们在编写字符串相关的应⽤程序时,掌握正则表达式会起到事半功倍的效果。
C中的正则表达式标准C和C++都不⽀持正则表达式,但是千万不要以为正则表达式就只是Perl、Python、Bash等脚本语⾔的专利,作为C语⾔程序员,⽤户同样可以在⾃⼰的程序中运⽤正则表达式,只是需要⼀些函数库辅助C/C++程序员来完成这⼀功能。
许多Linux发⾏版本都带有POSIX函数库,下⾯我将以POSIX函数库中的Regex系列函数来说明在Linux c下如何使⽤正则表达式。
⾸先要⽤Regcomp()函数对它进⾏编译,将其转化为Regex_t结构。
因为⼀个正则表达式需要编译成⼀个特定的数据结构才能被后续的函数使⽤。
Regcomp()函数的原型是:int Regcomp(regex_t *preg, const char *regex, int cflags)参数preg指向⼀个声明为regex_t的数据结构,⽤来保存编译结果。
参数regex为要编译的正则表达式字符串。
参数cflags是编译开关,编译开关可以控制规则⽣成的特性,如REG_EXTEND代表使⽤扩展正则表达式模式;REG_ICASE表⽰对规则中字符串不区分⼤⼩写;REG_NOSUB只检查是否有符合规则的⼦串。
正则表达式-语法大全
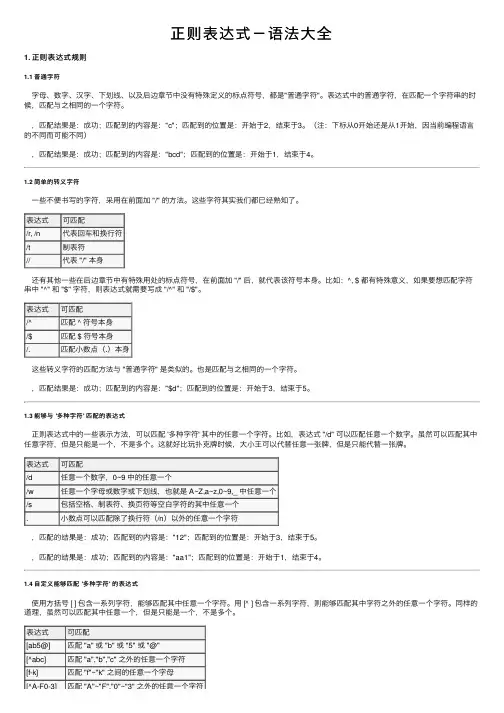
正则表达式-语法⼤全1. 正则表达式规则1.1 普通字符字母、数字、汉字、下划线、以及后边章节中没有特殊定义的标点符号,都是"普通字符"。
表达式中的普通字符,在匹配⼀个字符串的时候,匹配与之相同的⼀个字符。
,匹配结果是:成功;匹配到的内容是:"c";匹配到的位置是:开始于2,结束于3。
(注:下标从0开始还是从1开始,因当前编程语⾔的不同⽽可能不同),匹配结果是:成功;匹配到的内容是:"bcd";匹配到的位置是:开始于1,结束于4。
1.2 简单的转义字符⼀些不便书写的字符,采⽤在前⾯加 "/" 的⽅法。
这些字符其实我们都已经熟知了。
表达式可匹配/r, /n代表回车和换⾏符/t制表符//代表 "/" 本⾝还有其他⼀些在后边章节中有特殊⽤处的标点符号,在前⾯加 "/" 后,就代表该符号本⾝。
⽐如:^, $ 都有特殊意义,如果要想匹配字符串中 "^" 和 "$" 字符,则表达式就需要写成 "/^" 和 "/$"。
表达式可匹配/^匹配 ^ 符号本⾝/$匹配 $ 符号本⾝/.匹配⼩数点(.)本⾝这些转义字符的匹配⽅法与 "普通字符" 是类似的。
也是匹配与之相同的⼀个字符。
,匹配结果是:成功;匹配到的内容是:"$d";匹配到的位置是:开始于3,结束于5。
1.3 能够与 '多种字符' 匹配的表达式正则表达式中的⼀些表⽰⽅法,可以匹配 '多种字符' 其中的任意⼀个字符。
⽐如,表达式 "/d" 可以匹配任意⼀个数字。
虽然可以匹配其中任意字符,但是只能是⼀个,不是多个。
这就好⽐玩扑克牌时候,⼤⼩王可以代替任意⼀张牌,但是只能代替⼀张牌。
正则表达式

假设有一个CSV(comma separated value)文件,里面有一些我们需要的信息,但是格式却有问题,目前数据的列顺序是:姓名,公司名,州名缩写,邮政编码,现在我们希望讲这些数据重新组织,以便在我们的某个软件中使用,需要的格式为:姓名,州名缩写-邮政编码,公司名。也就是说,我们要调整列顺序,还要合并两个列来构成一个新列。另外,我们的软件不能接受逗号前后面有任何空格(包括空格和制表符)所以我们还必须要去掉逗号前后的所有空格。
现在让我们把它打散来加以分析。写出这个表达式的基本思路是找出foo()和它的括号中的三个参数的位置。第一个参数是用这个表达式来识别的::\([^,]*\),我们可以从里向外来分析它:
[^,] 除了逗号之外的任何字符
[^,]* 0或者多个非逗号字符
\([^,]*\) 将这些非逗号字符标记为,这样可以在之后的替换模式表达式中引用它
|
将两个匹配条件进行逻辑“或”(Or)运算。例如正则表达式(him|her) 匹配"it belongs to him"和"it belongs to her",但是不能匹配"it belongs to them."。注意:这个元字符不是所有的软件都支持的。
+
匹配1或多个正好在它之前的那个字符。例如正则表达式9+匹配9、99、999等。注意:这个元字符不是所有的软件都支持的。
\([^,]*\), 我们必须找到0或者多个非逗号字符后面跟着一个逗号,并且非逗号字符那部分要标记出来以备后用。
现在正是指出一个使用正则表达式常见错误的最佳时机。为什么我们要使用[^,]*这样的一个表达式,而不是更加简单直接的写法,例如:.*,来匹配第一个参数呢?设想我们使用模式.*来匹配字符串"10,7,2",它应该匹配"10,"还是"10,7,"?为了解决这个两义性(ambiguity),正则表达式规定一律按照最长的串来,在上面的例子中就是"10,7,",显然这样就找出了两个参数而不是我们期望的一个。所以,我们要使用[^,]*来强制取出第一个逗号之前的部分。
正则表达式
正则表达式(I)正则表达式是由英文词语regular expression翻译过来的,就是符合某种规则的表达式。
正则表达式在软件开发中应用非常广泛,例如,找出网页中的超链接,找出网页中的email 地址,找出网页中的手机号码,判断输入的内容是否全部是数字,是否满足某种日期格式等等。
可以将正则表达式理解为一种对文字进行模糊匹配的语言,它用一些特殊的符号(称为元字符)来代表具有某种特征的一组字符以及该组字符重复出现的次数。
例如,对于正则表达式“\d{5}(-\d{4})?”,\d就是一个元字符,它表示一个数字字,{5}表示紧靠它前面的元素项连续重复5次,\d和{5}的组合\d{5}就表示匹配任意连续的5个数字字符;-\d{4}匹配的是一个连字号(-)后加上4个任意的数字,(-\d{4})?表示连字号(-)和后面的4个数字可有可无。
对于整个正则表达式“\d{5}(-\d{4})?”,表示要么是5个连续的数字字符,要么是5个连续的数字后加上一个连字号(-)、再加上4个连续的数字组成的10个字符。
正则表达式中的圆括号除了能将多个元素组合成一个可统一操作的组合项外,它所括起来的表达式部分还成为了一个子匹配(也叫子表达式),也就是说,我们可以用圆括号在一个长的正则表达式中划分出子表达式。
这样,除了可以得到整个正则表达式的匹配结果外,还可以单独得到每个子表达式部分所匹配的结果。
要灵活运用正则表达式,必须了解其中各种元字符的功能。
元字符从功能上大致分为:限定符、选择匹配符、分组组合和反向引用符、特殊字符、字符匹配符、定位符。
限定符用于指定其前面的字符或组合项连续出现多少次,下面是各种限定符及其含义:●{n} 规定前面的元素或组合项的连续出现n 次●{n,} 规定前面的元素或组合项至少连续出现n 次●{n,m } 规定前面的元素或组合项至少连续出现n 次,至多连续出现m 次●+ 规定前面的元素或组合项必须出现一次或连续多次,等效于{1,}●* 规定前面的元素或组合项可以出现零次或连续多次,等效于{0,}●? 规定前面的元素或组合项出现零次或一次,等效于{0,1}默认情况下,正则表达式使用最长(也叫贪婪)匹配原则。
模式匹配(正则表达式)
替换操作符的选项如下表: 选项 g i e m o s x 描述 改变模式中的所有匹配 忽略模式中的大小写 替换字符串作为表达式 将待匹配串视为多行 仅赋值一次 将待匹配串视为单行 忽略模式中的空白
注:e选项把替换部分的字符串看作表达式,在替换之前先计算其值,如: $string = "0abc1"; $string =~ s/[a-zA-Z]+/$& x 2/e; # now $string = "0abcabc1"
=~:检验匹配是否成功:$result = $var =~ /abc/;若在该字符串中找到了该 模式,则返回非零值,即true,不匹配 则返回0,即false。 !~:则相反。
这两个操作符适于条件控制中,如: if ($question =~ /please/) { print ("Thank you for being polite!\n"); } else { print ("That was not very polite!\n"); }
注:split函数每次遇到分割模式,总是开始 一个新单词。 (1)若$line以空格打头,则@array的第 一个元素即为空元素。但其可以区分是否真 有单词。 (2)若$line中只有空格,则@array则为 空数组。且上例中TAB字符被当作一个单词。 注意修正。
2、字符 [ ]和[^] [ ]:意味着匹配一组字符中的一个,如 /a[0123456789]c/将匹配a加数字加c的字符 串。与+联合使用例:/d[eE]+f/匹配def、dEf、 deef、dEf、dEEEeeeEef等。 ^:表示除其之外的所有字符,如: /d[^eE]f/匹配d加非e字符加f的字符串。 3、字符 *和? 它们与+类似,区别在于 *:匹配0个、1 个或多个相同字符,?:匹配0个或1个该字 符。如/de*f/匹配df、def、deeeef等; /de?f/匹配df或def。
正则表达式(正则表达式括号的作用)
正则表达式(正则表达式括号的作⽤)正则表达式之前学习的时候,因为很久没怎么⽤,或者⽤的时候直接找⽹上现成的,所以都基本忘的差不多了。
所以这篇⽂章即是笔记,也让⾃⼰再重新学习⼀遍正则表达式。
其实平时在操作⼀些字符串的时候,⽤正则的机会还是挺多的,之前没怎么重视正则,这是⼀个错误。
写完这篇⽂章后,发觉⼯作中很多地⽅都可以⽤到正则,⽽且⽤起来其实还是挺爽的。
正则表达式作⽤ 正则表达式,⼜称规则表达式,它可以通过⼀些设定的规则来匹配⼀些字符串,是⼀个强⼤的字符串匹配⼯具。
正则表达式⽅法基本语法,正则声明js中,正则的声明有两种⽅式1. 直接量语法:1var reg = /d+/g/2. 创建RegExp对象的语法1var reg = new RegExp("\\d+", "g");这两种声明⽅式其实还是有区别的,平时的话我⽐较喜欢第⼀种,⽅便⼀点,如果需要给正则表达式传递参数的话,那么只能⽤第⼆种创建RegExp的形式格式:var pattern = new RegExp('regexp','modifier');regexp:匹配的模式,也就是上⽂指的正则规则。
modifier: 正则实例的修饰符,可选值有:i : 表⽰区分⼤⼩写字母匹配。
m :表⽰多⾏匹配。
g : 表⽰全局匹配。
传参的形式如下:我们⽤构造函数来⽣成正则表达式1var re = new RegExp("^\\d+$","gim");这⾥需要注意,反斜杠需要转义,所以,直接声明量中的语法为\d,这⾥需要为\\d那么,给它加变量,就和我们前⾯写的给字符串加变量⼀样了。
1 2var v = "bl";var re =new RegExp("^\\d+" + v + "$","gim"); // re为/^\d+bl$/gim⽀持正则的STRING对象⽅法1. search ⽅法作⽤:该⽅法⽤于检索字符串中指定的⼦字符串,或检索与正则表达式相匹配的字符串基本语法:stringObject.search(regexp);返回值:该字符串中第⼀个与regexp对象相匹配的⼦串的起始位置。
20个常用的正则表达式 单字母
正则表达式(Regular Expression)是一种用于匹配字符串的强大工具。
它通过使用特定的符号和字符来描述和匹配一系列字符串,能够满足我们在处理文本时的各种需求。
在这篇文章中,我们将深入探讨20个常用的单字母正则表达式,并通过实例来展示它们的使用方法。
1. \b在正则表达式中,\b表示单词的边界。
它可以用来匹配单词的开头或结尾,用于查找特定单词而不是单词的一部分。
2. \d\d表示任意一个数字字符。
它可以用来匹配任何数字,例如\d+可以匹配一个或多个数字字符。
3. \w\w表示任意一个字母、数字或下划线字符。
它可以用来匹配单词字符,例如\w+可以匹配一个或多个单词字符。
4. \s\s表示任意一个空白字符,包括空格、制表符、换行符等。
它可以用来匹配空白字符,例如\s+可以匹配一个或多个空白字符。
5. \.\.表示匹配任意一个字符,包括标点符号和空格等。
它可以用来匹配任意字符,例如\.可以匹配任意一个字符。
6. \A\A表示匹配字符串的开始。
它可以用来确保匹配发生在字符串的开头。
7. \Z\Z表示匹配字符串的结束。
它可以用来确保匹配发生在字符串的结尾。
8. \b\b表示单词的边界。
它可以用来匹配单词的开头或结尾,用于查找特定单词而不是单词的一部分。
9. \D\D表示任意一个非数字字符。
它可以用来匹配任何非数字字符。
10. \W\W表示任意一个非单词字符。
它可以用来匹配任何非单词字符。
11. \S\S表示任意一个非空白字符。
它可以用来匹配任何非空白字符。
12. \[\[表示匹配方括号。
它可以用来匹配包含在方括号内的字符。
13. \]\]表示匹配方括号。
它可以用来匹配包含在方括号内的字符。
14. \(\(表示匹配左括号。
它可以用来匹配包含在左括号内的字符。
15. \)\)表示匹配右括号。
它可以用来匹配包含在右括号内的字符。
16. \{\{表示匹配左花括号。
它可以用来匹配包含在左花括号内的字符。
17. \}\}表示匹配右花括号。