
SQL中distinct的用法
在使用mysql时,有时需要查询出某个字段不重复的记录,虽然mysql提供有distinct这个关键字来过滤掉多余的重复记录只保留一条,但往往只用它来返回不重复记录的条数,而不是用它来返回不重记录的所有值。
其原因是distinct只能返回它的目标字段,而无法返回其它字段,这个问题让我困扰了很久,用distinct不能解决的话,我只有用二重循环查询来解决,而这样对于一个数据量非常大的站来说,无疑是会直接影响到效率的。
所以我花了很多时间来研究这个问题,网上也查不到解决方案,期间把容容拉来帮忙,结果是我们两人都郁闷了。
下面先来看看例子:
table
id name
1 a
2 b
3 c
4 c
5 b
库结构大概这样,这只是一个简单的例子,实际情况会复杂得多。
比如我想用一条语句查询得到name不重复的所有数据,那就必须使用distinct去掉多余的重复记录。
select distinct name from table
得到的结果是:
name
a
b
c
好像达到效果了,可是,我想要得到的是id值呢?改一下查询语句吧:
select distinct name, id from table
结果会是:
id name
1 a
2 b
3 c
4 c
5 b
distinct怎么没起作用?作用是起了的,不过他同时作用了两个字段,也就是必须得id与name 都相同的才会被排除。
我们再改改查询语句:
select id, distinct name from table
很遗憾,除了错误信息你什么也得不到,distinct必须放在开头。
难到不能把distinct放到where条件里?能,照样报错。
很麻烦吧?确实,费尽心思都没能解决这个问题。
没办法,继续找人问。
拉住公司里一JAVA程序员,他给我演示了oracle里使用distinct之后,也没找到mysql里的解决方案,最后下班之前他建议我试试group by。
试了半天,也不行,最后在mysql手册里找到一个用法,用group_concat(distinct name)配合group by name实现了我所需要的功能,兴奋,天佑我也,赶快试试。
报错。
郁闷。
连mysql手册也跟我过不去,先给了我希望,然后又把我推向失望,好狠哪。
再仔细一查,group_concat函数是4.1支持,晕,我4.0的。
没办法,升级,升完级一试,成功。
终于搞定了,不过这样一来,又必须要求客户也升级了。
突然灵机一闪,既然可以使用group_concat函数,那其它函数能行吗?
赶紧用count函数一试,成功,我。
想哭啊,费了这么多工夫。
原来就这么简单。
现在将完整语句放出:
select *, count(distinct name) from table group by name
结果:
id name count(distinct name)
1 a 1
2 b 1
3 c 1
最后一项是多余的,不用管就行了,目的达到。
唉,原来mysql这么笨,轻轻一下就把他骗过去了,郁闷也就我吧,现在拿出来希望大家不要被这问题折腾。
哦,对,再顺便说一句,group by 必须放在order by 和limit之前,不然会报错,差不多了,我继续忙碌。
SQL查询去除重复记录
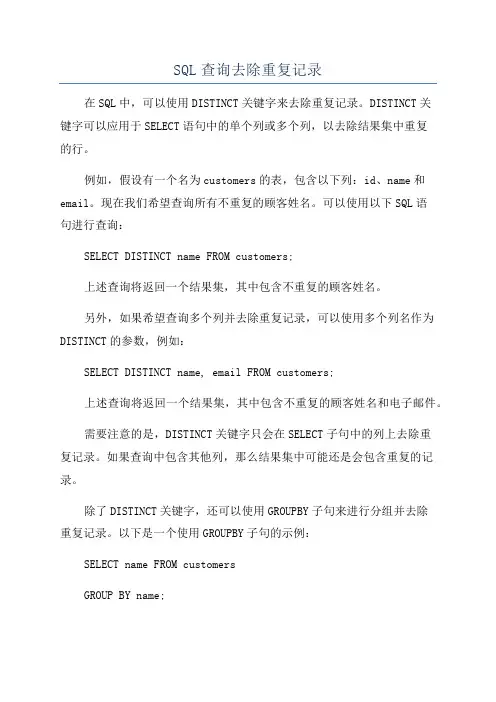
SQL查询去除重复记录在SQL中,可以使用DISTINCT关键字来去除重复记录。
DISTINCT关键字可以应用于SELECT语句中的单个列或多个列,以去除结果集中重复的行。
例如,假设有一个名为customers的表,包含以下列:id、name和email。
现在我们希望查询所有不重复的顾客姓名。
可以使用以下SQL语句进行查询:SELECT DISTINCT name FROM customers;上述查询将返回一个结果集,其中包含不重复的顾客姓名。
另外,如果希望查询多个列并去除重复记录,可以使用多个列名作为DISTINCT的参数,例如:SELECT DISTINCT name, email FROM customers;上述查询将返回一个结果集,其中包含不重复的顾客姓名和电子邮件。
需要注意的是,DISTINCT关键字只会在SELECT子句中的列上去除重复记录。
如果查询中包含其他列,那么结果集中可能还是会包含重复的记录。
除了DISTINCT关键字,还可以使用GROUPBY子句来进行分组并去除重复记录。
以下是一个使用GROUPBY子句的示例:SELECT name FROM customersGROUP BY name;上述查询将按照姓名对结果集进行分组,并且只返回每个分组的第一条记录。
需要注意的是,使用GROUPBY子句时,还可以使用聚合函数(如SUM、AVG、COUNT等)来对分组后的结果进行计算或统计。
最后,如果希望在查询过程中去除重复记录,可以使用嵌套查询或者临时表来实现。
嵌套查询是嵌入在主查询内部的子查询,可以在子查询中使用DISTINCT关键字来去除重复记录。
以下是一个使用嵌套查询的示例:SELECT name FROM (SELECT DISTINCT name FROM customers) AS subquery;上述查询先执行嵌套子查询,去除重复的顾客姓名,然后将结果作为一个临时表,供主查询使用。
sql的distinct用法
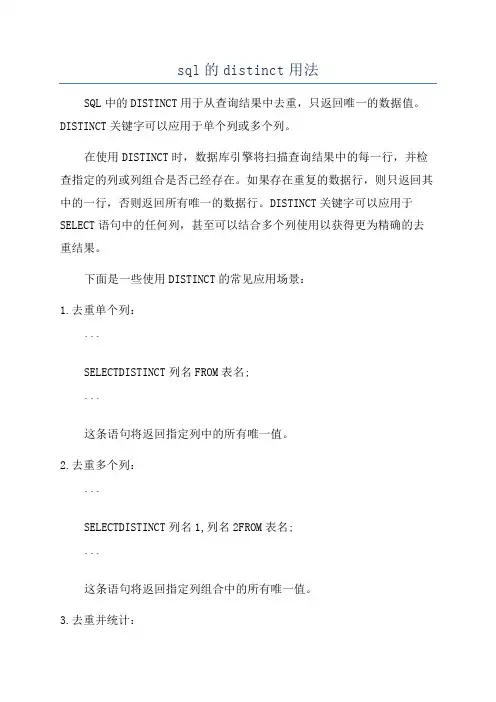
sql的distinct用法SQL中的DISTINCT用于从查询结果中去重,只返回唯一的数据值。
DISTINCT关键字可以应用于单个列或多个列。
在使用DISTINCT时,数据库引擎将扫描查询结果中的每一行,并检查指定的列或列组合是否已经存在。
如果存在重复的数据行,则只返回其中的一行,否则返回所有唯一的数据行。
DISTINCT关键字可以应用于SELECT语句中的任何列,甚至可以结合多个列使用以获得更为精确的去重结果。
下面是一些使用DISTINCT的常见应用场景:1.去重单个列:```SELECTDISTINCT列名FROM表名;```这条语句将返回指定列中的所有唯一值。
2.去重多个列:```SELECTDISTINCT列名1,列名2FROM表名;```这条语句将返回指定列组合中的所有唯一值。
3.去重并统计:```SELECT列名,COUNT(DISTINCT列名)FROM表名GROUPBY列名;```这条语句将返回每个唯一值以及它们出现的次数。
4.去重并排序:```SELECTDISTINCT列名FROM表名ORDERBY列名ASC/DESC;```这条语句将返回指定列中的所有唯一值,并按照升序/降序进行排序。
5.去重并分页:```SELECTDISTINCT列名FROM表名LIMIT起始行数,每页行数;```这条语句将返回指定列中的所有唯一值,并根据指定的起始行数和每页行数进行分页。
6.在子查询中使用DISTINCT:```SELECTDISTINCT列名FROM(SELECT列名FROM表名)AS子查询表名;```这条语句将返回子查询中指定列的所有唯一值。
需要注意的是,使用DISTINCT可能会影响查询的性能,特别是当处理大量数据时。
因为DISTINCT需要比较每一行的值以确定其唯一性,所以执行时间可能较长。
在一些情况下,可以通过其他方式来实现相同的效果,例如使用GROUPBY和HAVING子句来分组并筛选唯一值。
distinct用法
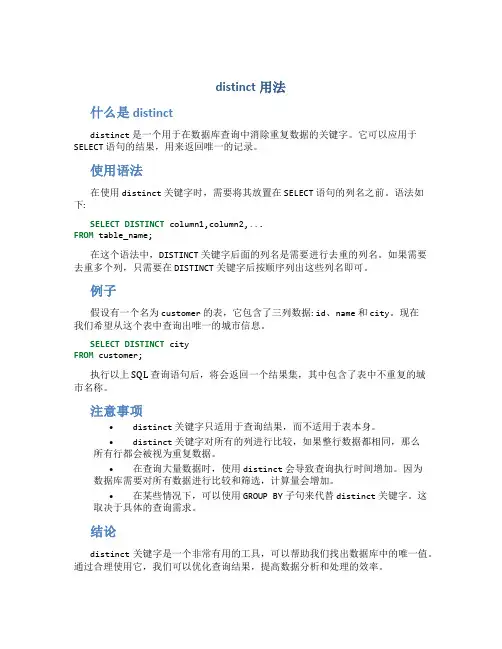
distinct用法什么是distinctdistinct是一个用于在数据库查询中消除重复数据的关键字。
它可以应用于SELECT语句的结果,用来返回唯一的记录。
使用语法在使用distinct关键字时,需要将其放置在SELECT语句的列名之前。
语法如下:SELECT DISTINCT column1,column2,...FROM table_name;在这个语法中,DISTINCT关键字后面的列名是需要进行去重的列名。
如果需要去重多个列,只需要在DISTINCT关键字后按顺序列出这些列名即可。
例子假设有一个名为customer的表,它包含了三列数据: id、name和city。
现在我们希望从这个表中查询出唯一的城市信息。
SELECT DISTINCT cityFROM customer;执行以上 SQL 查询语句后,将会返回一个结果集,其中包含了表中不重复的城市名称。
注意事项•distinct关键字只适用于查询结果,而不适用于表本身。
•distinct关键字对所有的列进行比较,如果整行数据都相同,那么所有行都会被视为重复数据。
•在查询大量数据时,使用distinct会导致查询执行时间增加。
因为数据库需要对所有数据进行比较和筛选,计算量会增加。
•在某些情况下,可以使用GROUP BY子句来代替distinct关键字。
这取决于具体的查询需求。
结论distinct关键字是一个非常有用的工具,可以帮助我们找出数据库中的唯一值。
通过合理使用它,我们可以优化查询结果,提高数据分析和处理的效率。
希望本文对你理解distinct关键字的用法有所帮助。
如有疑问,请在下方留言,我会尽快回复。
distinct用法

distinct用法distinct一个SQL句中的关键字,用于返回唯一不同的值,使查询的结果更准确。
distinct键字允许从一个列中选择不重复的值。
让我们深入来探讨一下 distinct用法和它的好处。
distinct键字是数据库中的一个重要部分,它帮助我们在检索数据时避免重复的值。
这样,我们就可以从数据库中返回我们需要的正确结果。
distinct许我们从表或查询中过滤掉重复的行,只保留不同的值。
distinct键字可以用在任何单个列上。
它将从指定列中返回不同的值,并且可以在 WHERE句、GROUP BY句或 ORDER BY句中使用。
在 WHERE句中使用 distinct键字,可以查询出包含唯一值的行。
distinct 会排除与查询中的其他条件相冲突的重复行,使查询的结果更加准确。
在 GROUP BY句中使用 distinct,可以在查询聚合函数的结果中过滤重复的值。
它还会排除与查询中的其他条件相冲突的重复行,使得查询的结果更加准确。
很多时候,distinct也可以与 LIMIT ORDER BY 一起使用,以按指定的顺序或限制返回值的数量,并且防止重复。
使用 distinct以节省电脑的 CPU,节省系统的资源,从而使查询的运行速度更快。
此外,它还可以提高查询的可读性,使得查询的结果更加容易理解。
总之,distinct键字是一种强大的查询工具,它可以帮助我们从数据库中获得更准确的结果,并可以节省我们的时间和资源。
使用distinct以让我们更容易获取我们需要的正确数据,使得后续的查询更加准确。
sqldistinct用法

sqldistinct用法SQL的Distinct关键字是用于查询结果集中去除重复的值,仅返回不同的值。
Distinct可以应用于单个列或多个列,并且可以与其他关键字如SELECT,FROM,WHERE,ORDER BY等结合使用。
Distinct的基本语法是:```sqlSELECTDISTINCT列名FROM表名```Distinct用法的说明如下:1. 单个列应用DistinctDistinct可以应用于一个或多个列,如果只需要在结果集中去重其中一列的重复值,可以使用Distinct来操作。
举个例子,假设我们有一个学生表,包含学生ID和姓名两个列,现在我们想要找出学生表中不重复的姓名。
我们可以使用以下SQL语句:```sqlSELECTDISTINCT姓名FROM学生表```这将返回一个结果集,其中包含学生表中去重后的姓名列表。
2. 多个列应用DistinctDistinct也可以应用于多个列。
当需要对多个列进行去重操作时,需要在SELECT DISTINCT子句中指定这些列。
如下面的例子,我们有一个订单表,其中包含订单ID,客户ID和产品ID三个列。
我们想要找出订单表中不重复的客户ID和产品ID的组合。
我们可以使用以下SQL语句:```sqlSELECTDISTINCT客户ID,产品IDFROM订单表```这将返回一个结果集,其中包含订单表中去重后的客户ID和产品ID的组合。
3. Distinct与其他关键字结合使用Distinct可以与其他SQL关键字如SELECT,FROM,WHERE,ORDER BY等结合使用,以满足更复杂的查询要求。
例如,我们可以使用Distinct来与WHERE子句一起使用,来获取符合特定条件的不重复值。
举个例子,我们有一个员工表,其中包含员工ID,姓名和薪水三个列。
我们希望找出薪水大于2000的员工姓名,但要确保结果集中没有重复的姓名。
我们可以使用以下SQL语句:```sqlSELECTDISTINCT姓名FROM员工表WHERE薪水>2000```这将返回一个结果集,其中包含薪水大于2000的员工表中去重后的姓名列表。
sql中count与distinct用法

sql中count与distinct用法SQL是用于管理关系数据库的系统级语言,它提供了许多用于数据查询、插入、更新和删除的命令。
COUNT和DISTINCT是SQL中的两个常用函数,它们在数据统计和去重处理中发挥着重要作用。
本篇文章将详细介绍COUNT和DISTINCT在SQL中的用法。
一、COUNT函数COUNT函数用于统计指定列中的行数。
它返回指定列中非空值的数量。
使用COUNT函数可以轻松地获取数据集中的记录数。
语法:COUNT(column_name)示例:假设我们有一个名为"customers"的表,其中包含"id"和"status"两列。
要统计所有客户的数量,可以使用以下查询:```sqlSELECT COUNT(id) FROM customers;```结果将返回一个整数,表示表中客户数量的总和。
注意事项:1. COUNT函数可以与其他条件组合使用,以便计算符合特定条件的行数。
2. COUNT函数不仅适用于数字列,也适用于文本列。
对于文本列,COUNT将返回行数(即非空值的数量)。
二、DISTINCT用法DISTINCT关键字用于返回唯一不同的值。
在SQL中,DISTINCT 关键字用于去重,确保查询结果集中只包含不重复的数据。
语法:SELECT DISTINCT column_name FROM table_name示例:假设我们有一个名为"products"的表,其中包含"category"和"color"两列。
要获取每种颜色唯一对应的类别,可以使用以下查询:```sqlSELECT DISTINCT color, category FROM products;```结果将返回一个包含唯一颜色和对应类别的结果集,确保颜色和类别之间没有重复。
注意事项:1. DISTINCT关键字对整个表达式进行去重,包括列名、表名和连接条件。
SQL中的distinct关键词
SQL中的distinct关键词
⾄少SQL Server,HQL,Oracle都有效
通常SQL中对表中数据去重,会⾸先想到distinct关键字,
能实现的需求
1. distinct可以对单个字段去重
select distinct name from A
2. 对多个字段去重时,此时所列的字段需要同时满⾜才会起到去重效果,否则不会去重
select distinct name, id from A --name和id同时重复才能去重,有⼀个不⼀样都不会去重
--上⾯的写法是对name和id列都去重,⽽不是仅对name去重,id不去重
select distinct * from A --*所代表的所有字段都重复时,才能去重
不能实现的需求
3. 不能实现指定字段去重,其他字段不去重的效果
select name, distinct id from A --仅希望对id列进⾏去重,name列不去重,xxx这样是不⾏的,⽆法实现,⽽且会提⽰错误,因为distinct必须放在开头
问题:
如果想实现针对某⼀字段去重,其他字段是否重复不关⼼的效果怎么处理?
答:
可以采⽤row_number()的窗⼝函数
转换问题,可以转换为对重复的⾏取top1,这样使⽤over()函数,对指定列分组,排序,然后结合row_number()给每⼀组的数据⼀列序列,再对集合取序列为1的⾏
结合⼀些⽤例更容易懂⼀些。
distinct用法
distinct用法distinct是一个十分有用的语句,可以帮助用户轻松处理一些复杂的查询功能。
它的目的是选择不同的值,并且大多数数据库也支持这个语句。
在本文中,我们将详细介绍distinct的用法,以及它在解决复杂查询问题时的主要作用。
首先,让我们来认识distinct的定义。
distinct是一种SQL语句,它用来指定结果中不能出现重复值的列。
它的一般格式如下:SELECT DISTINCT名 FROM名。
这里的DISTINCT关键字是用来指示结果中不允许有重复值的,而表名则是你要从中查询的表的名字,而列名就是要查询的列的名字。
我们来看一个例子,例如,有一个学生表,表中有四个列,分别为姓名,性别,年龄和地址。
现在,当我们想要查询出不同年龄的学生时,我们可以使用distinct来查询,代码如下:SELECT DISTINCT 龄 FROM生表。
这样,我们可以获得表中所有不同的年龄,而不会出现重复的年龄。
distinct还可以用来解决复杂的查询问题。
例如,有一个员工表,表中有五个列,分别为员工号,姓名,性别,职务和部门。
假设,我们想要查询每个部门中不同职务的员工人数,这时,我们可以使用distinct来查询,代码如下:SELECT门,COUNT(DISTINCT务) FROM 工表 GROUP BY门。
这样,我们可以得到每个部门中不同职务的员工人数。
此外,distinct还可以用来解决一些复杂的联合查询问题。
比如,假设有一个商品表和一个客户表,它们有一个共同的外键,我们想要查询每个客户购买的不同商品的数量,这时,我们可以使用distinct来解决,代码如下:SELECT户ID,COUNT(DISTINCT品ID) FROM品表,客户表 WHERE品表.客户ID=客户表.客户ID GROUP BY户ID。
以上就是本文所介绍的distinct用法,它可以帮助用户轻松处理一些复杂的查询问题,具体来说,它可以用来选择不同的值,也可以用来处理复杂的联合查询问题。
distinct高级用法
distinct高级用法一、DISTINCT基本用法1. 在SQL数据库查询中,“DISTINCT”关键字用于从结果集中去除重复的行。
比如说,我有一个包含学生姓名的表,其中有些姓名重复出现了。
如果我执行“SELECT DISTINCT name FROM students;”,就只会得到每个不同姓名的一次记录。
这就像是从一堆相同的糖果中,只挑选出每种口味的一颗,哇塞,多酷啊!2. 当处理数据集合时,DISTINCT就像一个筛选器。
假设你在一家鞋店工作,有一个销售记录的表格,里面有很多顾客多次购买的记录。
如果想知道有多少不同的顾客买过鞋,就可以使用“SELECT DISTINCT customer_id FROM sal es;”。
这就好比从一群每天来店里逛的熟面孔中,找出到底有多少个独特的客人,嘿!3. 在查询数据库中的颜色列表时,如果有多种产品可能使用相同的颜色,用“SELECT DISTINCT color FROM products;”。
这就如同在一堆五颜六色的气球中,只挑出每种颜色的一个气球来看看都有哪些颜色,是不是很有趣呢?4. 假如有一个记录员工参加培训课程的表,有些员工可能参加了多个相同的课程。
若想知道有多少不同的课程被员工参加过,可执行“SELECT DISTINCT course_name FROM employee_training;”。
这简直就是在员工培训的大杂烩里,找出那些独一无二的课程,棒极了!5. 对于一个存储歌曲播放记录的数据库,其中一首歌曲可能被多次播放。
若要找出有多少首不同的歌曲被播放过,就用“SELECT DISTINCT song_name FROM play_records;”。
这就像是从你杂乱无章的播放列表里,把那些重复的歌曲清理掉,只留下不同的曲目,哇哦!二、DISTINCT高级用法1. 有时候,我们可能需要在多个列上使用DISTINCT。
例如,在一个存储订单信息的数据库中,订单包含顾客ID、产品ID和订单日期。
distinct用法
distinct用法DistinctSQL一种关键字,它指定结果集应包含所有不重复记录。
使用 Distinct键字,可以从结果集中筛选出不重复的行,这有助于保持数据的完整性。
Distinct键字可以用于以下两个主要的用途:一是用于删除重复的记录;二是用于提出一组不重复的记录。
Distinct键字可以在一个查询中使用多次,允许您指定多个不重复的属性而不是仅仅一个。
在实践中,Distinct键字的使用是一种有效的方法,可以帮助我们从表中获取不重复的行,以达到我们想要的查询结果。
要从表中获取不重复的行,只需在表达式中指定 Distinct键字即可。
Distinct键字可以用于查询表中特定列或所有列,以及在一组条件中对多个维度进行过滤。
在使用 Distinct键字之前,可以先对查询进行筛选,以按照指定的行减少结果集的大小,以达到运行Distinct键字的效率最高。
在使用 Distinct键字时,可以传递多个参数,用以控制哪些行会从结果集中过滤。
例如,你可以使用 Distinct键字来过滤表中未指定某一列值的重复行,例如如果你有一个表,其中有两列,第一列是“城市”,第二列是“国家”,通过使用 Distinct键字可以查询出不同的城市名称,而不论其后的国家名称是什么。
此外,Distinct键字还可以用于查询表中重复列值的所有行,它可以被用来查询指定列的所有不重复值,而不是整行的不重复值,这将有助于更有效地提取数据,以满足你的业务需求。
总之,Distinct键字可以在多种用途中使用,它能够有效地提取数据,以满足你的业务需求。
不过,在使用 Distinct键字时要特别小心,这样可以避免导致意外的结果,又或者导致查询速度缓慢。