
GPU工作原理简介
GPU工作原理简介计算机0601 沈凯杰【引言】在GPU出现以前,显卡和CPU的关系有点像“主仆”,简单地说这时的显卡就是画笔,根据各种有CPU发出的指令和数据进行着色,材质的填充、渲染、输出等。
较早的娱乐用的3D显卡又称“3D加速卡”,由于大部分坐标处理的工作及光影特效需要由CPU亲自处理,占用了CPU太多的运算时间,从而造成整体画面不能非常流畅地表现出来。
例如,渲染一个复杂的三维场景,需要在一秒内处理几千万个三角形顶点和光栅化几十亿的像素。
早期的3D游戏,显卡只是为屏幕上显示像素提供一个缓存,所有的图形处理都是由CPU单独完成。
图形渲染适合并行处理,擅长于执行串行工作的CPU实际上难以胜任这项任务。
所以,那时在PC上实时生成的三维图像都很粗糙。
不过在某种意义上,当时的图形绘制倒是完全可编程的,只是由CPU来担纲此项重任,速度上实在是达不到要求。
随着时间的推移,CPU进行各种光影运算的速度变得越来越无法满足游戏开发商的要求,更多多边形以及特效的应用榨干了几乎所有的CPU性能,矛盾产生了······【目录】第一章.GPU的诞生3.1 GPU中数据的处理流程3.2 CPU与GPU的数据处理关系3.3 传统GPU指令的执行3.4 GPU的多线程及并行计算3.4.1 多线程机制3.4.2 并行计算第二章.GPU的结构第三章.GPU的工作原理第四章.GPU未来的展望4.1 GPU能否包办一切4.2 GPU时代即将到来【正文】第一章.GPU的诞生NVIDIA公司在1999年8月31日发布GeForce 256图形处理芯片时首先提出GPU的概念。
GPU之所以被称为图形处理器,最主要的原因是因为它可以进行几乎全部与计算机图形有关的数据运算,而这些在过去是CPU的专利。
目前,计算机图形学正处于前所未有的发展时期。
近年来,GPU技术以令人惊异的速度在发展。
渲染速率每6个月就翻一番。
性能自99年,5年来翻番了10次,也就是(2的10次方比2)提高了上千倍!与此同时,不仅性能得到了提高,计算质量和图形编程的灵活性也逐渐得以改善。
以前,PC和计算机工作站只有图形加速器,没有图形处理器(GPU),而图形加速器只能简单的加速图形渲染。
而GPU取代了图形加速器之后,我们就应该摒弃图形加速器的旧观念。
第二章.GPU的结构GPU全称是GraphicProcessing Unit--图形处理器,其最大的作用就是进行各种绘制计算机图形所需的运算,包括顶点设置、光影、像素操作等。
GPU实际上是一组图形函数的集合,而这些函数有硬件实现,只要用于3D游戏中物体移动时的坐标转换及光源处理。
以前,这些工作都是有CPU配合特定软件进行的,GPU从某种意义上讲就是为了在图形处理过程中充当主角而出现的。
下图就是一个简单的GPU结构示意图,一块标准的GPU主要包括2D Engine、3D Engine、Video Processing Engine、FSAA Engine、显存管理单元等。
其中,3D运算中起决定作用的是3DEngine,这是现代3D显卡的灵魂,也是区别GPU等级的重要标志。
3DEnglne在各公司的产品中都是宣传攻势的重点照顾对象,名字一个比一个响,像NVIDIA的nFjnjtFX系列、CineFX系列,ATI的SmoothVision系列。
一个3DEngine通常包含着T&L单元、VertexProeessingEngine、SetupEngine、PiexlShader等部分。
第三章.GPU的工作原理3.1 GPU中数据的处理流程现在让我们来看看第二代GPU是如何完整处理一个画面的吧!首先,来自CPU的各种物理参数进入GPU,Vertex shader将对顶点数据进行基本的判断。
如果没有需要处理的Vertex 效果,则顶点数据直接进入T&L Unit 进行传统的T&L操作以节约时间提高效率。
如果需要处理各种Vertex 效果,则Vertex shader 将先对各种Vertex Programs的指令进行运算,一般的Vertex Programs中往往包含了过去转换、剪切、光照运算等所需要实现的效果,故经由Vertex shader处理的效果一般不需要再进行T&L操作。
另外,当遇到涉及到曲面镶嵌(把曲面,比如弓形转换成为多边形或三角形)的场合时。
CPU可以直接将数据交给Vertex shader进行处理。
另外,在DireetX8.0的Transform过程中,Vertex shader可以完成Z值的剔除,也就是Back Face Culling――阴面隐去。
这就意味粉除了视野以外的顶点,视野内坡前面项点遮住的顶点也会被一并剪除,这大大减轻了需要进行操作的顶点数目。
接下来,经由VertexShader处理完成的各种数据将流入SetupEngine,在这里,运算单元将进行三角形的设置工作,这是整个绘图过程中最重要的一个步骤,Setup Engine甚至直接影响着一块GPU的执行效能。
三角形的设置过程是由一个个多边形组成的,或者是用更好的三角形代替原来的三角形。
在三维图象中可能会有些三角形被它前面的三角形挡住,但是在这个阶段3D芯片还不知道哪些三角形会被挡住,所以三角形建立单元接收到是一个个由3个顶点组成的完整三角形。
三角形的每个角(或顶点)都有对应的X轴、Y 轴、Z轴坐标值,这些坐标值确定了它们在3D景物中的位置。
同时,三角形的设置也确定了像素填充的范围。
,至此,VertexShader的工作就完成了。
过去[第一代],设置好的三角形本来应该带着各自所有的参数进入像素流水线内进行纹理填充和演染,但现在则不同,在填充之前我们还播要进行PiexlShader的操作。
其实,PieXIShader并非独立存在的,它位于纹理填充单元之后,数据流入像紊流水线后先进入纹理填充单元进行纹理填充,然后便是Piex!Shader单元,经由PiexlShader单元进行各种处理运算之后再进入像素填充单元进行具体的粉色,再经由雾化等操作后,一个完整的画面就算完成了。
值得注意的是,第二代GPU中普遮引入了独立的显示数据管理机制,它们位于VertexShader、SetuPEngine以及像素流水线之间,负资数据更有效率地传输和组合、各种无效值的剔除、数据的压缩以及寄存器的管理等工作,这个单元的出现对整个GPU工作效率的保证起到了至关重要的作用。
简而言之,GPU的图形(处理)流水线完成如下的工作:(并不一定是按照如下顺序)顶点处理:这阶段GPU读取描述3D图形外观的顶点数据并根据顶点数据确定3D图形的形状及位置关系,建立起3D图形的骨架。
在支持DX8和DX9规格的GPU中,这些工作由硬件实现的Vertex Shader(定点着色器)完成。
光栅化计算:显示器实际显示的图像是由像素组成的,我们需要将上面生成的图形上的点和线通过一定的算法转换到相应的像素点。
把一个矢量图形转换为一系列像素点的过程就称为光栅化。
例如,一条数学表示的斜线段,最终被转化成阶梯状的连续像素点。
纹理帖图:顶点单元生成的多边形只构成了3D物体的轮廓,而纹理映射(texture mapping)工作完成对多变形表面的帖图,通俗的说,就是将多边形的表面贴上相应的图片,从而生成“真实”的图形。
TMU (Texture mapping unit)即是用来完成此项工作。
像素处理:这阶段(在对每个像素进行光栅化处理期间)GPU完成对像素的计算和处理,从而确定每个像素的最终属性。
在支持DX8和DX9规格的GPU中,这些工作由硬件实现的Pixel Shader(像素着色器)完成。
最终输出:由ROP(光栅化引擎)最终完成像素的输出,1帧渲染完毕后,被送到显存帧缓冲区。
总结:GPU的工作通俗的来说就是完成3D图形的生成,将图形映射到相应的像素点上,对每个像素进行计算确定最终颜色并完成输出。
-――GPU流程示意图3.2 CPU与GPU的数据处理关系如今的游戏,单单从图象的生成来说大概需要下面四个步骤:1、Homogeneous coordinates(齐次坐标)2、Shading models(阴影建模)3、Z-Buffering(Z-缓冲)4、Texture-Mapping(材质贴图)在这些步骤中,显示部分(GPU)只负责完成第三、四步,而前两个步骤主要是依靠 CPU 来完成。
而且,这还仅仅只是3D图象的生成,还没有包括游戏中复杂的AI运算。
场景切换运算等等……无疑,这些元素还需要CPU去完成,这就是为什么在运行《魔兽世界》的时候,当场景切换时再强劲的显卡都会出现停顿的现象。
接下来,让我们简单的看一下CPU和GPU之间的数据是如何交互的。
首先从硬盘中读取模型, CPU分类后将多边形信息交给GPU,GPU再时时处理成屏幕上可见的多边形,但是没有纹理只有线框。
模型出来后,GPU将模型数据放进显存,显卡同时也为模型贴材质,给模型上颜色。
CPU相应从显存中获取多边形的信息。
然后CPU计算光照后产生的影子的轮廓。
等CPU计算出后,显卡的工作又有了,那就是为影子中填充深的颜色这一点要注意的是,无论多牛的游戏家用显卡,光影都是CPU计算的,GPU只有2个工作,1多边形生成。
2为多边形上颜色。
3.3 传统GPU指令的执行传统的GPU基于SIMD的架构。
SIMD即Single Instruction Multiple Data,单指令多数据。
其实这很好理解,传统的VS和PS中的ALU(算术逻辑单元,通常每个VS或PS中都会有一个ALU,但这不是一定的,例如G70和R5XX有两个)都能够在一个周期内(即同时)完成对矢量4个通道的运算。
比如执行一条4D指令,PS或VS中的ALU对指令对应定点和像素的4个属性数据都进行了相应的计算。
这便是SIMD的由来。
这种ALU我们暂且称它为4D ALU。
需要注意的是,4D SIMD架构虽然很适合处理4D指令,但遇到1D指令的时候效率便会降为原来的1/4。
此时ALU 3/4的资源都被闲置。
为了提高PS VS执行1D 2D 3D指令时的资源利用率,DirectX9时代的GPU通常采用1D+3D或2D+2D ALU。
这便是Co-issue技术。
这种ALU对4D指令的计算时仍然效能与传统的ALU相同,但当遇到1D 2D 3D指令时效率则会高不少,例如如下指令:ADD R0.xyz , R0,R1 //此指令是将R0,R1矢量的x,y,z值相加结果赋值给R0ADD R3.x , R2,R3 //此指令是将R2 R3矢量的w值相加结果赋值给R3对于传统的4D ALU,显然需要两个周期才能完成,第一个周期ALU利用率75% ,第二个周期利用率25%。
GPU工作原理简介.
GPU工作原理简介计算机0601 沈凯杰【引言】在GPU出现以前,显卡和CPU的关系有点像“主仆”,简单地说这时的显卡就是画笔,根据各种有CPU发出的指令和数据进行着色,材质的填充、渲染、输出等。
较早的娱乐用的3D显卡又称“3D加速卡”,由于大部分坐标处理的工作及光影特效需要由CPU亲自处理,占用了CPU太多的运算时间,从而造成整体画面不能非常流畅地表现出来。
例如,渲染一个复杂的三维场景,需要在一秒内处理几千万个三角形顶点和光栅化几十亿的像素。
早期的3D游戏,显卡只是为屏幕上显示像素提供一个缓存,所有的图形处理都是由CPU单独完成。
图形渲染适合并行处理,擅长于执行串行工作的CPU实际上难以胜任这项任务。
所以,那时在PC上实时生成的三维图像都很粗糙。
不过在某种意义上,当时的图形绘制倒是完全可编程的,只是由CPU来担纲此项重任,速度上实在是达不到要求。
随着时间的推移,CPU进行各种光影运算的速度变得越来越无法满足游戏开发商的要求,更多多边形以及特效的应用榨干了几乎所有的CPU性能,矛盾产生了······【目录】第一章.GPU的诞生3.1 GPU中数据的处理流程3.2 CPU与GPU的数据处理关系3.3 传统GPU指令的执行3.4 GPU的多线程及并行计算3.4.1 多线程机制3.4.2 并行计算第二章.GPU的结构第三章.GPU的工作原理第四章.GPU未来的展望4.1 GPU能否包办一切4.2 GPU时代即将到来【正文】第一章.GPU的诞生NVIDIA公司在1999年8月31日发布GeForce 256图形处理芯片时首先提出GPU的概念。
GPU之所以被称为图形处理器,最主要的原因是因为它可以进行几乎全部与计算机图形有关的数据运算,而这些在过去是CPU的专利。
目前,计算机图形学正处于前所未有的发展时期。
近年来,GPU技术以令人惊异的速度在发展。
GPU简介

一、GPGPU的定义与原理GPU英文全称Graphic Processing Unit,中文翻译为“图形处理器”。
GPU计算或GPGPU 就是利用图形处理器(GPU)来进行通用科学与工程计算。
GPU专用于解决可表示为数据并行计算的问题——在许多数据元素上并行执行的程序,具有极高的计算密度(数学运算与存储器运算的比率)。
GPU计算的模式是,在异构协同处理计算模型中将CPU与GPU结合起来加以利用。
应用程序的串行部分在CPU上运行,而计算任务繁重的部分则由GPU来加速。
从用户的角度来看,应用程序只是运行得更快了。
因为应用程序利用了GPU的高性能来提升性能。
在过去几年里,GPU的浮点性能已经上升到Teraflop级的水平。
GPGPU的成功使CUDA 并行编程模型相关的编程工作变得十分轻松。
在这种编程模型中,应用程序开发者可修改他们的应用程序以找出计算量繁重的程序内核,将其映射到GPU上,让GPU来处理它们。
应用程序的剩余部分仍然交由CPU处理。
想要将某些功能映射到GPU上,需要开发者重新编写该功能,在编程中采用并行机制,加入“C”语言关键字以便与GPU之间交换数据。
开发者的任务是同时启动数以万计的线程。
GPU硬件可以管理线程和进行线程调度。
英伟达™ Tesla(NVIDIA® Tesla)20系列GPU基于“Fermi”架构,这是最新的英伟达™ CUDA(NVIDIA® CUDA)架构。
Fermi专为科学应用程序而进行了优化、具备诸多重要特性,其中包括:支持500 gigaflop以上的IEEE标准双精度浮点硬件、一级和二级高速缓存、ECC存储器错误保护、本地用户管理的数据高速缓存(其形式为分布于整个GPU中的共享存储器)以及合并存储器访问等等。
"GPU(图形处理器)已经发展到了颇为成熟的阶段,可轻松执行实际应用程序并且其运行速度已远远超过了使用多核系统时的速度。
未来计算架构将是并行核心GPU与多核CPU串联运行的混合型系统。
一文详解GPU结构及工作原理
一文详解GPU结构及工作原理
GPU全称是GraphicProcessing Unit--图形处理器,其最大的作用就是进行各种绘制计算机图形所需的运算,包括顶点设置、光影、像素操作等。
GPU实际上是一组图形函数的集合,而这些函数有硬件实现,只要用于3D 游戏中物体移动时的坐标转换及光源处理。
在很久以前,这些工作都是由CPU配合特定软件进行的,后来随着图像的复杂程度越来越高,单纯由CPU 进行这项工作对于CPU的负荷远远超出了CPU的正常性能范围,这个时候就需要一个在图形处理过程中担当重任的角色,GPU也就是从那时起正式诞生了。
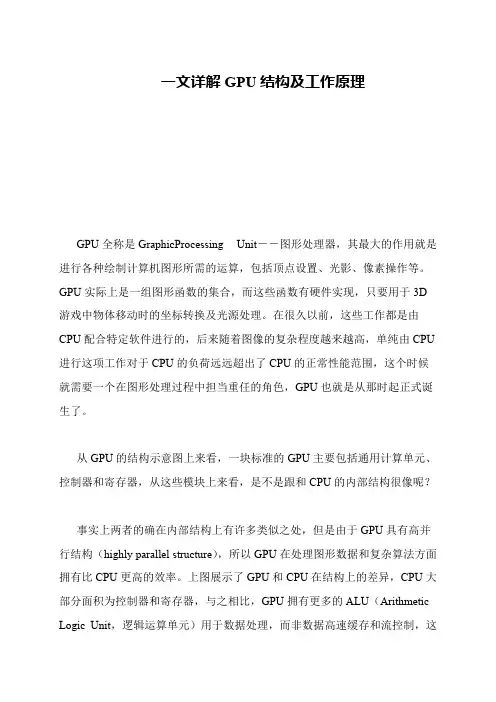
从GPU的结构示意图上来看,一块标准的GPU主要包括通用计算单元、控制器和寄存器,从这些模块上来看,是不是跟和CPU的内部结构很像呢?
事实上两者的确在内部结构上有许多类似之处,但是由于GPU具有高并行结构(highly parallel structure),所以GPU在处理图形数据和复杂算法方面拥有比CPU更高的效率。
上图展示了GPU和CPU在结构上的差异,CPU大部分面积为控制器和寄存器,与之相比,GPU拥有更多的ALU(Arithmetic Logic Unit,逻辑运算单元)用于数据处理,而非数据高速缓存和流控制,这。
电脑显卡的形处理单元(GPU)解析
电脑显卡的形处理单元(GPU)解析电脑显卡作为计算机硬件的重要组成部分,其性能的关键指标之一就是形处理单元(GPU)。
GPU是指显卡上的处理核心,它主要负责图形处理和计算任务。
本文将从GPU的基本原理、应用领域和未来发展趋势三个方面进行解析。
一、GPU的基本原理GPU的基本原理是基于并行计算的。
与传统的中央处理单元(CPU)相比,GPU具有更多的并行计算单元和更高的内存带宽,这使得它能够更快地处理大规模的图形和计算任务。
在GPU中,形处理单元是最关键的部件之一。
它由大量的处理核心组成,每个处理核心都具有自己的浮点运算单元和缓存。
这些处理核心可以同时执行多个计算任务,因此能够以极高的并发性完成复杂的图形计算。
此外,GPU还具有专门的图形专用内存和图形处理器。
图形专用内存具有更高的带宽和更低的延迟,能够提供给GPU所需的大量数据。
而图形处理器则用于执行图形渲染和图像处理等任务,能够实现细致的光照效果和逼真的图像呈现。
二、GPU的应用领域由于其出色的图形处理能力和计算性能,GPU在许多领域都得到了广泛的应用。
首先,游戏行业是GPU的主要应用领域之一。
随着游戏画面和特效的不断提升,GPU能够为游戏提供更加逼真的图像效果,使得游戏画面更加细腻、流畅。
同时,GPU还可以提供更高的帧率,使得游戏玩家能够享受到更为流畅的游戏体验。
其次,GPU在人工智能和深度学习领域也有着广泛的应用。
由于深度学习的计算量极大,GPU的并行计算能力可以大大加速深度学习模型的训练过程。
因此,许多研究机构和大公司都借助GPU来进行深度学习相关的研究和开发工作。
此外,GPU还在科学计算、医学影像处理、虚拟现实等领域得到了应用。
科学计算中需要进行大规模的数值计算,而GPU可以提供更高的计算性能;医学影像处理中需要处理大量的医学图像数据,而GPU 能够快速进行图像处理和分析;虚拟现实中需要实时渲染大量的图像和场景,而GPU能够满足实时渲染的需求。
显卡的工作原理

显卡的工作原理
显卡的工作原理:
显卡是计算机中的重要硬件设备,主要用于处理和输出图像信号。
它的工作原理主要包括以下几个方面:
1. 图像处理单元(GPU):显卡的核心部分是图像处理单元,也称为GPU。
GPU的作用是执行图形计算和图像处理任务,
它包含大量的计算核心和专用的内存,可以高效地处理复杂的图形计算和图像处理任务。
2. 内存:显卡上一般配有独立的显存,用于存储图像数据和计算所需的中间结果。
显存的容量和带宽对于显卡的性能至关重要,较大的容量和较高的带宽可以提供更好的图像处理能力。
3. 输入/输出接口:显卡通常会配备多种输入和输出接口,用
于连接显示器、电视、投影仪等输出设备,以及键盘、鼠标、游戏手柄等输入设备。
常见的接口有HDMI、DisplayPort、DVI、VGA等。
4. 显示信号处理:显卡会接收计算机主板传输过来的图像数据,并对其进行处理和转换,生成适合输出设备显示的图像信号。
这个过程包括色彩校正、图像缩放、去噪等。
5. 显示输出:处理后的图像信号由显卡通过输出接口发送给外部显示设备,例如显示器。
显卡可以通过多个输出接口同时连接多个显示设备,实现多屏显示。
总体来说,显卡的工作原理就是通过GPU进行图形计算和图像处理,将处理后的图像信号发送给外部显示设备进行显示。
显卡的性能主要受到GPU的算力、显存的容量和带宽以及输入/输出接口的性能等因素的影响。
不同的显卡在处理速度、图像质量和兼容性等方面会有差异。
gpu 运行原理
gpu 运行原理GPU( 图形处理单元)是一种专门设计用于处理图形和并行计算的硬件设备。
它的运行原理涉及到并行处理和数据流的概念。
GPU的核心功能是执行大规模并行计算。
与传统的中央处理单元(CPU)相比,GPU具有更多的处理单元 称为流处理器或CUDA核心),每个处理单元都可以执行相同的指令。
这使得GPU能够同时处理多个任务,实现高效的并行计算。
GPU的运行原理可以分为以下几个关键步骤:1. 数据传输:首先,计算任务的数据从主内存(RAM)中传输到GPU的显存(VRAM)中。
显存是GPU专用的高速内存,可以提供快速的数据访问。
2. 数据准备:一旦数据被传输到显存中,GPU将根据指令对数据进行准备,例如重排、复制或格式转换等。
这个过程通常由CPU发出指令,而GPU执行。
3. 并行计算:准备好的数据将被分配给GPU上的多个流处理器进行并行计算。
每个流处理器都可以同时执行多个线程,这些线程可以访问和操作数据。
4. 线程调度:GPU通过调度和管理线程来实现并行计算。
线程是计算任务的最小执行单元,它可以是像素、顶点、像素片段等。
GPU将这些线程分组为线程块(thread block),并组织成网格 grid),以便有效地执行计算。
5. SIMD执行:在每个流处理器内部,GPU使用SIMD 单指令多数据)架构执行并行计算。
它意味着每个流处理器可以同时执行相同的指令,但操作的数据可以不同。
这种架构使得GPU能够高效地处理大规模数据集。
6. 结果返回:计算完成后,GPU将结果数据传输回显存,并最终返回到主内存。
CPU 可以从主内存中获取结果,并进一步处理或显示。
总的来说,GPU的运行原理基于并行计算和数据流的概念。
它利用大量的处理单元和SIMD架构,可以同时执行多个计算任务,从而实现高效的图形处理和并行计算能力。
这使得GPU成为许多需要高性能计算的应用程序( 如游戏、科学计算和深度学习)的理想选择。
gpu渲染原理范文
gpu渲染原理范文GPU渲染原理GPU(图形处理单元)是一种专门用于处理图形和图像运算的硬件,它在计算机图形渲染中扮演着重要角色。
GPU渲染是指通过GPU执行图形计算和图形渲染,将3D场景、游戏、动画等图形数据转换成2D图像的过程。
GPU渲染的原理可以简要概括为以下几个步骤:1.几何处理:在渲染开始之前,GPU会对场景的几何信息进行处理。
这包括将3D模型转换为三角形网格的形式,并进行顶点变换、裁剪等操作。
2.顶点着色:顶点着色是计算3D场景中每个顶点的颜色、光照和纹理信息的过程。
GPU会对每个顶点进行坐标变换、法线计算、纹理坐标变换等操作,然后应用材质和光照模型计算出最终的顶点颜色。
3.图元组装:GPU将顶点数据组装成基本图元(例如线段、三角形等),以便后续的光栅化处理。
4.光栅化:光栅化是将基本图元转换为屏幕上的像素的过程。
GPU会根据图元的位置、大小等信息,将其转换为一系列的像素片段,并将其传递给下一阶段的像素处理。
5.像素处理:像素处理是对每个像素片段进行处理的过程,包括纹理采样、光照计算、深度测试、像素着色等。
GPU会通过对每个像素片段进行一系列操作,计算出像素的最终颜色。
6. 像素输出:最后,GPU会将计算得到的像素颜色输出到帧缓冲区(Frame Buffer),并将其显示在屏幕上。
在以上过程中,GPU通过高度并行的计算架构以及专门的图形渲染硬件来实现快速的图形计算和渲染。
它使用着色器单元来计算顶点着色和像素着色,并利用多个流处理器和纹理单元来并行处理多个像素。
此外,GPU还充分利用了图形数据的并行性和局部性,通过缓存技术、计算优化等手段提高计算效率。
总结起来,GPU渲染的原理是通过几何处理、顶点着色、图元组装、光栅化、像素处理和像素输出等多个步骤,将3D场景数据转换为2D图像。
GPU利用其高度并行的计算架构和专门的图形渲染硬件,以及缓存技术和计算优化等手段,实现快速高效的图形计算和渲染。
gpu instance原理
gpu instance原理GPU实例是一种在云计算环境中提供GPU资源的服务。
GPU(图形处理单元)是一种专门设计用于并行计算和图形渲染的处理器。
它比CPU更适合处理大量并行计算任务,例如机器学习、科学计算和渲染等。
GPU实例的工作原理如下:1. 硬件层面GPU实例底层依赖于云服务提供商的基础设施。
云服务提供商会在物理服务器中安装具有高性能GPU的硬件,并将其与CPU、内存等资源集成。
每台物理服务器可以虚拟化为多个GPU实例。
2. 虚拟化技术通过虚拟化技术,物理GPU资源可以被分割并分配给多个虚拟机实例。
这种技术称为GPU直通(GPU Pass-through)或GPU虚拟化。
它允许虚拟机直接访问和使用专用GPU资源,从而获得接近裸机的GPU性能。
3. 资源调度云服务提供商会根据用户需求动态分配GPU实例资源。
当用户请求GPU实例时,云平台会在有空闲GPU资源的物理服务器上创建一个新的虚拟机实例,并将GPU资源直通给该实例。
4. 软件支持GPU实例通常预装有支持GPU加速的软件环境,如CUDA、cuDNN 等。
这些软件可以充分利用GPU的并行计算能力,加速各种计算密集型应用程序。
5. API和管理云服务提供商通常会提供API和控制台界面,允许用户方便地创建、管理和监控GPU实例。
用户可以根据需求选择不同的GPU类型、数量以及其他配置选项。
总的来说,GPU实例通过虚拟化技术将物理GPU资源分割并提供给多个虚拟机实例,从而实现GPU资源的按需分配和高效利用。
这种服务模式非常适合需要大量并行计算能力的应用场景,如机器学习训练、科学计算和图形渲染等。
gpu 工作原理
gpu 工作原理
GPU(图形处理器)是一种专门设计用于处理图形和图像数
据的硬件设备。
它在计算机系统中扮演着重要的角色,不仅用于游戏和图形渲染,还广泛应用于科学计算、数据处理和人工智能等领域。
GPU的工作原理可以概述为以下几个步骤:
1. 并行处理:GPU内部包含大量的处理单元(Shader Core),每个处理单元都能执行指令和计算操作。
这些处理单元可以同时处理多个数据,具有高度的并行计算能力。
2. 数据并行:GPU的处理单元能够同时处理多个像素或顶点
数据。
这是因为GPU将所有需要计算的数据分成小块,然后
对每个小块进行并行计算。
这种数据并行的方式可以大大提高图形渲染和计算的效率。
3. 图形渲染管线:GPU包含一个图形渲染管线,它是一个由
多个阶段组成的流水线。
每个阶段负责不同的计算或处理任务,例如顶点处理、几何处理、光栅化等。
通过流水线的方式,GPU能够并行执行不同阶段的计算,从而加速图形渲染的过程。
4. 内存管理:GPU拥有自己的专用内存,用于存储和处理图
形和图像数据。
与传统的中央处理器(CPU)相比,GPU的
内存带宽更高,能够更快地读写数据。
这对于处理和渲染大量的图形数据非常重要。
总的来说,GPU的工作原理是通过并行处理、数据并行和图形渲染管线等方式,高效地处理和渲染图形和图像数据。
它的设计和优化使得它能够在图形和计算密集型任务上表现出色。
gpu的工作原理
gpu的工作原理GPU是图形处理单元的缩写,是一种专门用于图形处理和计算的硬件设备。
与中央处理单元(CPU)不同,GPU具有更多处理核心和更高的并行计算能力,适合用于大规模的并行计算任务,例如图形渲染、机器学习、深度学习等。
GPU的工作原理可以从以下几个方面来解释:1. 并行计算结构:GPU内部采用了多个计算核心,也称为流处理器(Stream Processor)。
这些计算核心可以同时处理多个任务,使得GPU能够实现高度的并行计算。
2. 数据内存分配:GPU内部包含全局内存和共享内存。
全局内存用于存储输入输出数据、中间计算结果等,共享内存用于不同计算核心之间的数据传递。
通过合理利用内存结构,可以提高内存读写速度和计算效率。
3. 并行计算流程:GPU的计算流程一般分为三个步骤:数据传输、并行计算和结果输出。
首先,将需要计算的数据从主机(CPU)内存传输到GPU的全局内存中;然后,GPU的计算核心并行地对数据进行处理和计算;最后,将计算结果从GPU的全局内存传输回主机内存,或者直接输出到显示器上。
4. 着色器和图形渲染:GPU内部包含多个着色器单元,用于处理图形渲染的各个环节,例如顶点处理、纹理采样、像素着色等。
它们可以并行地处理不同的图元或像素,最终产生渲染结果。
5. 程序开发:为了充分发挥GPU的计算能力,开发者需要使用专门的编程语言和框架,例如CUDA、OpenCL等。
这些编程语言和框架可以利用GPU的并行计算结构,以及提供丰富的库函数和工具,方便开发者进行并行计算任务的编写和优化。
综上所述,GPU的工作原理主要包括并行计算结构、数据内存分配、并行计算流程、着色器和图形渲染以及程序开发等方面。
通过充分发挥GPU的并行计算能力,可以加速各种计算密集型任务的处理,提高计算效率和图形渲染质量。