
第二十一讲 过滤器与正则表达式
第 二十一讲 过滤器与正则表达式
2018/12/4
过滤器
过滤器是一些读取数据流的命令,并对读取的 数据流执行适当的操作,然后把操作的结果送 到标准输出 输入至过滤器的数据流可以是一系列的输入数 据,包括从文件、设备及命令或其它过滤器命 令的输出等。 过滤器仅仅对输入的数据流进行操作,并不修 改原数据。如果过滤器从文件中接收数据,其 原文件是不会被修改的,因为过滤器只是从文 件中读取数据
2018/12/4
正则表达式(Regular Expression)
正则表达式中的特殊字符有如下几个: “^”、“$”、“*”、“?” 与行尾及行首匹配的特殊字符: “^” 、 “$ ”
grep “^anon” /etc/vsftpd/vsftpd.conf grep “you$” 1.txt
2018/12/4
正则表达式(Regular Expression)
许多实用程序与过滤器使用模式( pattern )来 在文件中定位、选择指定的文本。一般在模式 中使用一组特殊的字符(通配符)来完成更灵 活,功能更强大的搜索。如果一个模式中包含 一些特殊的字符,并称该模式为正则表达式 简言之,正则表达式是从左向右去匹配目标字 符串的一组模式。
行编辑操作参数 文件列表参数
sed „3 d‟ 1.txt sed „s/how/who/‟ 3.txt cat 3.txt | sed „3 d‟
2018/12/4
过滤器编辑程序
文件差别命令:diff命令
过滤器命令 diff 用来比较两个文件,并输出 那些内容不同的文本行。 diff 1.txt 2.txt
第一个参数指定要搜索的模式 第二个参数是要搜索的文件列表
grep who 1.txt grep „who are‟ 1.txt grep who 1.txt 2.txt grep who *
2018/12/4
过滤器编辑程序
流式编辑器:sed(stream editor)
过滤器命令sed对其输入的数据执行行编辑操作。其 中,输入的数据可以从文件中读取,也可以接收来 自于标准输入的数据 sed命令有两个参数
sort 1.txt cat 1.txt 2.txt | sort > 3.txt
2索文件命令:grep命令
过滤器 grep 命令用来搜索与文件中的字符串相匹配 的模式,然后它通知用户在什么文件中搜索到与指 定的模式匹配的字符串,并打印出所有包含该字符 串的文本行。 过滤器命令grep有两个参数:
2018/12/4
常见文件过滤器
输出类过滤器:wc、spell、sort
拼写检查命令- spell 命令:过滤器命令 spell 将检查 输入数据中的拼写错误,并同时输出这些拼写错误 的单词
spell 1.txt Spell 1.txt | wc -w
文件排序命令- sort 命令:对文件中的各行进行排 序
常见文件过滤器
输出类过滤器:wc、spell、sort
计数命令-wc命令:过滤器命令wc对它的输入(通 常来自于文件)进行处理:统计文件中的行数、单 词数及字符数(包括结尾的换行字符),并把统计 的结果输出
wc 1.txt -c:仅统计文件中的字符数 -l:仅统计文件中的行数 -w:仅统计文件中的单词数
与任何单个字符都匹配的特殊字符: “?”
ls ?.txt
2018/12/4
正则表达式(Regular Expression)
匹配任意字符:“*”
ls *.txt
2018/12/4
grep实用程序与正则表达式
Shell下的特殊字符可以让你搜索、匹配文件名, 而正则表达式允许搜索、匹配文件中的文本 在 grep 命令中使用正则表达式,可以用指定的 模式来搜索文件或匹配、定位文件中的文本行
head、tail命令 在过滤器中使用管道和重定向
cat 1.txt | lpr cat > 1.txt cat 1.txt 2.txt | more cat 1.txt 2.txt > 3.txt cat 1.txt 2.txt | tee 3.txt | lpr
2018/12/4
2018/12/4
过滤器
过滤器的输出经常被输出到标准输出,也可以 被中定向到另外一个文件中或设备上,或者用 管道输入给另外一个实用程序或过滤器 一般把过滤器分为常见的三类 文本过滤器 编辑过滤器 数据过滤器
2018/12/4
常见文件过滤器
cat、tee命令
过滤器cat命令接收来自文件的输入,并把接收的数据拷贝到 标准输出 过滤器tee命令接收输入的数据,并把它们同时输出到标准输 出及指定的文件
ls –l | grep „^d‟ ls –l | grep „.txt$‟ rpm –qa |grep vsftpd
2018/12/4
正则表达式文本过滤
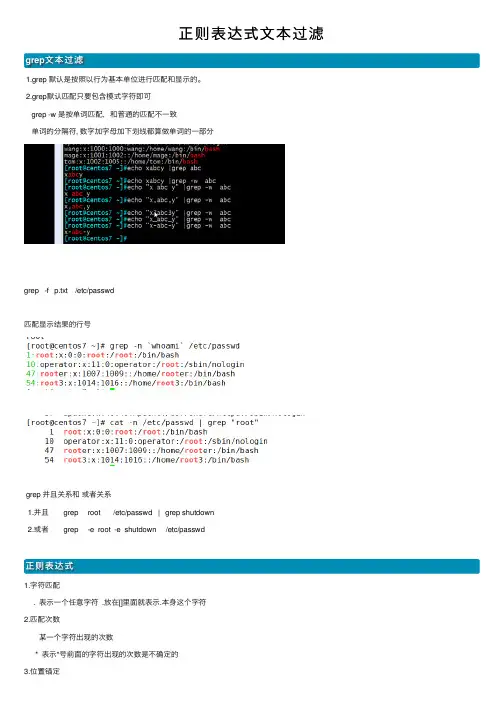
正则表达式⽂本过滤grep⽂本过滤1.grep 默认是按照以⾏为基本单位进⾏匹配和显⽰的。
2.grep默认匹配只要包含模式字符即可grep -w 是按单词匹配,和普通的匹配不⼀致单词的分隔符, 数字加字母加下划线都算做单词的⼀部分grep -f p.txt /etc/passwd匹配显⽰结果的⾏号grep 并且关系和或者关系1.并且 grep root /etc/passwd | grep shutdown2.或者 grep -e root -e shutdown /etc/passwd正则表达式1.字符匹配. 表⽰⼀个任意字符 .放在[]⾥⾯就表⽰.本⾝这个字符2.匹配次数某⼀个字符出现的次数* 表⽰*号前⾯的字符出现的次数是不确定的3.位置锚定⾏⾸ ^ 不能匹配中间某段字符串的开始⾏尾 $ 不能匹配中间某⼀段字符串的结尾单词词⾸ \<root root处于单词的最左侧单词词尾 root\> root处于单词的最右侧4.分组1. echo wangwangwangggww | grep "\(wang\)\{3\}"2.后向引⽤正则表达式和通配符的区别正则表达式匹配的是⽂件的内容或者标准输出的字符串,通配符匹配的是⽂件的名称.两者操作的对象不⼀致.匹配字符串问题shell执⾏命令的时候,正则表达式是以整个输出作为字符串内容,包括看不到的空格符号。
有些命令结果会输出⼀个或者多个空格,有些命令不会输出空格.1.在表达式中()符号前⾯和{}括号前⾯都必须要加上\(\) 和 \{\}.grep "^\(.*\):.*\1$" /etc/passwd2.正则表达式默认从字符串的最前⾯开始查找,但是如果锚定的是⾏尾,那么正则会从尾部开始查找1.从尾部开始查找2.从头部开始查找3.分组实例第⼀分组匹配到的字符串是7,最后⾯的[0-9]*\1 表⽰匹配到以7结尾⽽且7前⾯可以包含任意个数字的数字基本正则和扩展正则的区别1.基本正则语法⼩括号和⼤括号前⾯需要加上\符号做转义grep -w "[0-9]\{2,3\}" /etc/passwd2.扩展正则⼩括号和⼤括号前⾯不要加上转义字符grep -Ew "[0-9]{2,3}" /etc/passwdegrep -w "[0-9]{2,3}" /etc/passwd。
《正则表达式》课件

06
CATALOGUE
正则表达式的扩展与优化
正则表达式的扩展(如Unicode、命名组等)
Unicode支持
正则表达式内置了对Unicode字符集 的支持,可以使用诸如`uXXXX`的语 法来表示任意Unicode字符。
命名组
通过使用命名组,可以将匹配的子模 式进行有意义的命名,方便后续引用 和处理。
正则表达式在线测试工具是一种方便快捷的工具,用于测试 和验证正则表达式的正确性。通过在线测试工具,用户可以 输入正则表达式和测试字符串,并实时查看匹配结果,从而 快速定位问题并进行调整。
常用的正则表达式在线测试工具包括Regex101、RegExr、 RegexPal等。这些工具通常提供丰富的正则表达式语法高亮 显示、匹配模式选择、可视化匹配过程等功能,帮助用户更 好地理解和使用正则表达式。
字符串分割
总结词
正则表达式还可以用于字符串的分割操 作,将一个字符串按照特定的模式分割 成多个部分。
VS
详细描述
在字符串分割中,正则表达式可以用来将 一个字符串按照特定的模式分割成多个部 分。例如,可以使用正则表达式来将一个 包含逗号分隔的字符串分割成多个独立的 元素,或者将一个包含特定分隔符的字符 串分割成多个段落或行。
《正则表达式》 PPT课件
目录
• 正则表达式概述 • 正则表达式的语法规则 • 正则表达式的应用实例 • 正则表达式的常见问题与解决方案 • 正则表达式的工具与库 • 正则表达式的扩展与优化
01
CATALOGUE
正则表达式概述
什么是正则表达式
总结词
正则表达式是一种用于描述字符串中模式的强大工具。
04
CATALOGUE
正则表达式的常见问题与解决方案
正则表达式(正则表达式括号的作用)

正则表达式(正则表达式括号的作⽤)正则表达式之前学习的时候,因为很久没怎么⽤,或者⽤的时候直接找⽹上现成的,所以都基本忘的差不多了。
所以这篇⽂章即是笔记,也让⾃⼰再重新学习⼀遍正则表达式。
其实平时在操作⼀些字符串的时候,⽤正则的机会还是挺多的,之前没怎么重视正则,这是⼀个错误。
写完这篇⽂章后,发觉⼯作中很多地⽅都可以⽤到正则,⽽且⽤起来其实还是挺爽的。
正则表达式作⽤ 正则表达式,⼜称规则表达式,它可以通过⼀些设定的规则来匹配⼀些字符串,是⼀个强⼤的字符串匹配⼯具。
正则表达式⽅法基本语法,正则声明js中,正则的声明有两种⽅式1. 直接量语法:1var reg = /d+/g/2. 创建RegExp对象的语法1var reg = new RegExp("\\d+", "g");这两种声明⽅式其实还是有区别的,平时的话我⽐较喜欢第⼀种,⽅便⼀点,如果需要给正则表达式传递参数的话,那么只能⽤第⼆种创建RegExp的形式格式:var pattern = new RegExp('regexp','modifier');regexp:匹配的模式,也就是上⽂指的正则规则。
modifier: 正则实例的修饰符,可选值有:i : 表⽰区分⼤⼩写字母匹配。
m :表⽰多⾏匹配。
g : 表⽰全局匹配。
传参的形式如下:我们⽤构造函数来⽣成正则表达式1var re = new RegExp("^\\d+$","gim");这⾥需要注意,反斜杠需要转义,所以,直接声明量中的语法为\d,这⾥需要为\\d那么,给它加变量,就和我们前⾯写的给字符串加变量⼀样了。
1 2var v = "bl";var re =new RegExp("^\\d+" + v + "$","gim"); // re为/^\d+bl$/gim⽀持正则的STRING对象⽅法1. search ⽅法作⽤:该⽅法⽤于检索字符串中指定的⼦字符串,或检索与正则表达式相匹配的字符串基本语法:stringObject.search(regexp);返回值:该字符串中第⼀个与regexp对象相匹配的⼦串的起始位置。
正则表达式入门教程

正则表达式入门教程以下内容经正则表达式学习网授权≈正则表达式是什么?≈在使用电脑进行各种文字处理的时候,我们有时需要查找和匹配一些特殊的字符串,如邮箱地址、验证用户输入的密码是否包含了大小写字母和数字,查找HTML源文档中的所有web地址等等,这时我们就可以使用到正则表达式。
正则表达式本身是一个“字符串”,通过这个“字符串”去描述字符组成规则。
如abbb、abbbb、abbbbb这三个字符串包都是以a字母开头a后面有一个b字母,而且b字母重复了3到5次。
用正则表达式来描述就是ab{3,5},b{3,5}表示b字符重复3到5次。
如果我们想匹配ababab这样的字符串,ab重复了3次,用正则表达式表示就是(ab){3},圆括号()是正则表达式中的分组。
大家如果想亲自感受正则表达式的使用效果,可以打开正则表达式测试系统。
如以上实例所展示的,正则表达式为人们提供了一种简单易用的字符处理工具。
它在目前主流的文字处理软件中都提供了良好的支持(不仅是编程软件,还有文字处理软件Uedit32、EditPlus,网页采集软件火车头等等),它具有很强的通用性,学好它,我们可以达一变应万变的效果。
≈正则表达式详解≈像{},()这种在正则表达式中,具有特殊含义的字符称为元字符(metacharacter)。
元字符是组成正则表达式的基本元素,在正则表达式经常使用的元字符不是很多,概念容易理解。
大家只要花30来分钟学完我们的教程基本上就可以完全掌握。
为了您能更快速的掌握正则表达式,我们为您推荐一款方便的正则表达式在线测试工具“RegExr”,(RegExr由免费提供)。
保留字符匹配字符本身匹配字符数量匹配字符位置分组匹配表达式选项保留字符(返回目录)在正则表达式中,有一些字符在正则表达式中具有特殊含义被称保留字符,如*表示前一个元素可以重复零次或多次,要匹配“*”字符本身使用\*,半角句号.匹配除了换行符外的所有字符,要匹配“.”使用\.。
正则表达式详解

正则表达式详解正则表达式1.什么是正则表达式简单的说,正则表达式是一种可以用于文字模式匹配和替换的强有力的工具。
是由一系列普通字符和特殊字符组成的能明确描述文本字符串的文字匹配模式。
正则表达式并非一门专用语言,但也可以看作是一种语言,它可以让用户通过使用一系列普通字符和特殊字符构建能明确描述文本字符串的匹配模式。
除了简单描述这些模式之外,正则表达式解释引擎通常可用于遍历匹配,并使用模式作为分隔符来将字符串解析为子字符串,或以智能方式替换文本或重新设置文本格式。
正则表达式为解决与文本处理有关的许多常见任务提供了有效而简捷的方式。
正则表达式具有两种标准:·基本的正则表达式(BRE –Basic Regular Expressions)·扩展的正则表达式(ERE – Extended Regular Expressions)。
ERE包括BRE功能和另外其它的概念。
正则表达式目前有两种解释引擎:·基于字符驱动(text-directed engine)·基于正则表达式驱动(regex-directed engine)Jeffery Friedl把它们称作DFA和NFA解释引擎。
约定:为了描述起来方便,在本文中做一些约定:1.本文所举例的所有表达时都是基于NFA解释引擎的。
2.正则表达式,也就是匹配模式,会简写为Regex。
3. Regex的匹配目标,也就是目标字符串,会简写为String。
4.匹配结果用会用黄色底色标识。
5.用1\+1=2 括起来的表示这是一个regex。
6.举例会用以下格式:testThis is a test会匹配test,testcase等2.正则表达式的起源正则表达式的”祖先”可以一直上溯至对人类神经系统如何工作的早期研究。
Warren McCulloch 和 Walter Pitts 这两位神经生理学家研究出一种数学方式来描述这些神经网络。
正则表达式及应用
正则表达式及应⽤正则表达式及应⽤⼀、正则表达式(⼀)、概念:正则表达式(regular expression)就是由普通字符(例如a 到z)以及特殊字符(称为元字符)组成的⼀种字符串匹配的模式,可以⽤来检查⼀个串是否含有某种⼦串、将匹配的⼦串做替换或者从某个串中取出符合某个条件的⼦串等。
(⼆)、正则表达式中主要元字符:【其中常⽤的元字符⽤红⾊标出,红⾊的元字符必须掌握。
难点⽤蓝⾊标出,难点在⼀般的应⽤中并不常⽤】1.\将下⼀个字符标记为⼀个特殊字符、或⼀个原义字符、或⼀个向后引⽤、或⼀个⼋进制转义符。
例如,'n' 匹配字符"n"。
'\n' (newline)匹配⼀个换⾏符。
序列 '\\' 匹配 "\" ⽽"\(" 则匹配 "("。
…\r? (return)2.^匹配输⼊字符串的开始位置。
如果设置了 RegExp 对象的Multiline 属性,^ 也匹配 '\n' 或 '\r' 之后的位置。
3.$匹配输⼊字符串的结束位置。
如果设置了RegExp 对象的Multiline 属性,$ 也匹配 '\n' 或 '\r' 之前的位置。
4.*匹配前⾯的⼦表达式零次或多次。
例如,zo* 能匹配 "z" 以及 "zoo"。
* 等价于{0,}。
5.+匹配前⾯的⼦表达式⼀次或多次。
例如,'zo+' 能匹配 "zo"以及 "zoo",但不能匹配 "z"。
+ 等价于 {1,}。
6.?匹配前⾯的⼦表达式零次或⼀次。
例如,"do(es)?" 可以匹配 "do" 或 "does" 中的"do" 。
正则表达式知识详解
正则表达式知识详解⼀、什么是正则表达式?1.定义:正则表达式(regular expression)描述了⼀种字符串匹配的模式,可以⽤来检查⼀个串是否含有某种⼦串、将匹配的⼦串做替换或者从某个串中取出符合某个条件的⼦串等。
构造正则表达式的⽅法和创建数学表达式的⽅法⼀样。
也就是⽤多种元字符与运算符可以将⼩的表达式结合在⼀起来创建更⼤的表达式。
正则表达式的组件可以是单个的字符、字符集合、字符范围、字符间的选择或者所有这些组件的任意组合。
2.组成:正则表达式是由普通字符(例如字符 a 到 z)以及特殊字符(称为"元字符")组成的⽂字模式。
模式描述在搜索⽂本时要匹配的⼀个或多个字符串。
正则表达式作为⼀个模板,将某个字符模式与所搜索的字符串进⾏匹配。
3.何时使⽤:验证——从头到尾完整匹配!查找——只要部分匹配即可!⼆、正则表达式的基本语法和规则1.备选字符集:规定某*⼀位字符*可⽤的备选字符的集合语法:[可选字符列表]强调:1. ⽆论备选字符集包含多少字符,只能选1个2. 必须选1个!⽐如:6位数字的密码[0123456789][0123456789][0123456789][0123456789][0123456789][0123456789]简化:1. 当备选字符连续时,可⽤-表⽰范围的区间⽐如:[0123456789]-->[0-9][0-9][0-9][0-9][0-9][0-9][0-9][a-z]-->1位⼩写字母[A-Z]-->1位⼤写字母[A-Za-z]-->1位字母,⼤⼩写都⾏[0-9a-zA-Z]-->1位字母或数字都⾏反选:[^不能选的字符列表]⽐如:[^47] 强调:^作“除了”使⽤时,只能放在开头2. 预定义字符集:为常⽤的字符集专门提供的简化写法!“\d”-->[0-9]-->1位数字“\w”-->[0-9a-zA-Z_]-->1位字母,数字或_“\s”-->1位空字符:匹配任何空⽩字符,包括空格、制表符、换页符等等。
高级Shell脚本技巧使用正则表达式进行文本匹配过滤和格式化的实用案例
高级Shell脚本技巧使用正则表达式进行文本匹配过滤和格式化的实用案例高级Shell脚本技巧:使用正则表达式进行文本匹配、过滤和格式化的实用案例在Shell脚本编程中,正则表达式是一种强大的工具,可以用于文本的匹配、过滤和格式化。
本文将介绍一些高级Shell脚本技巧,帮助你了解如何使用正则表达式来处理文本数据。
1. 使用grep命令进行文本匹配过滤在Shell脚本中,grep命令可以根据正则表达式来搜索匹配的文本行。
例如,我们有一个文本文件example.txt,内容如下:```This is line 1This is line 2This is line 3```要匹配并输出所有包含"line"的行,可以使用以下命令:```shellgrep "line" example.txt```这将输出:```This is line 1This is line 2This is line 3```2. 使用sed命令进行文本替换sed是一个流编辑器,可以根据正则表达式对文本进行替换操作。
例如,我们有一个文件example.txt,内容如下:```This is line 1This is line 2This is line 3```要将所有的"line"替换为"row",可以使用以下命令:```shellsed 's/line/row/g' example.txt```这将输出:```This is row 1This is row 2This is row 3```3. 使用awk命令进行文本格式化awk是一种强大的文本处理工具,可以根据正则表达式对文本进行格式化和处理。
例如,我们有一个文件example.txt,内容如下:```John Doe 25Jane Smith 30```要提取所有行的第一个单词,并输出为逗号分隔的格式,可以使用以下命令:```shellawk '{print $1","}' example.txt```这将输出:```Jane,```4. 使用变量和循环结构处理匹配的文本在Shell脚本中,我们可以使用变量和循环结构来处理匹配的文本。
正则表达式 分章
正则表达式分章
正则表达式是一种用来描述文本模式的工具。
通过正则表达式,我们可以快速有效地搜索、匹配以及替换字符串中的特定内容。
在编程和数据处理中,正则表达式的应用非常广泛,并且是优化和自动化处理的重要工具之一。
正则表达式可以分为两部分,即模式和匹配。
模式是由特定的字符、符号和特殊字符组成的,用来描述需匹配的特定内容;匹配则是将模式与待处理的文本进行匹配,从而得出匹配结果。
正则表达式的模式主要包括以下内容:
- 普通字符:表示特定的字母、数字以及标点符号。
- 括号:用来定义匹配的范围和组合。
- 方括号:用来匹配固定的一组字符。
- 量词符:表示字符或字符组的重复出现次数。
- 转义字符:用来表示特殊的字符,如正则表达式的特殊字符。
正则表达式的语法较为严格,需要掌握基本的语法规则和特殊字符的用法。
在实际应用中,我们可以通过已有的正则表达式库或在线正则表达式测试工具来快速学习和调试。
在实际应用中,正则表达式可以用来快速匹配和提取特定的数据信息、对数据进行过滤和清洗,以及对文本进行格式化和排版等。
在各种编程语言、数据库和文本编辑器中,正则表达式都有相应的支持和实现,是非常实用和必不可少的工具。
总之,正则表达式是编程和数据处理中非常重要的工具之一,能够快速有效地匹配处理特定的文本模式,为我们的工作带来了很大的便利和效率提升。
正则表达式过滤数字语法
正则表达式过滤数字语法
正则表达式可以用于过滤数字的语法如下:
1.匹配整数:\d+
这个正则表达式可以匹配一个或多个连续的数字字符,即整数。
2.匹配浮点数:\d+\.\d+
这个正则表达式可以匹配一个整数部分和小数部分组成的浮点数。
例如,"3.14"可以被匹配。
3.匹配正负整数:-?\d+
这个正则表达式可以匹配一个可选的负号后跟一个或多个数字字符的整数,即正负整数。
4.匹配正负浮点数:-?\d+\.\d+
这个正则表达式可以匹配一个可选的负号后跟一个整数部分和小数部分组成的浮点数,即正负浮点数。
5.匹配科学计数法表示的数值:-?\d+(\.\d+)?[eE]-?\d+
这个正则表达式可以匹配科学计数法表示的数值,包括整数部分、小数部分、指数部分和可选的负号。
这些正则表达式可以根据具体的需求进行使用和调整。
可以通过编程语言中的正则表达式相关函数或工具进行匹配和过滤数字。