
块坐标下降法详解
块坐标下降法详解
块坐标下降法是一种常见的数值优化算法。
其基本思路是将多变
量函数的优化问题转化为多个单变量函数的优化问题,从而对每个变
量单独进行最优化求解,反复迭代,直到收敛到函数的最优解。
具体来说,块坐标下降法首先要确定优化问题的目标函数和变量
范围,以及每个变量的初始值。
然后,定义一个“块”,包含一组需
要同时优化的变量(可以是所有变量)。
在每次优化过程中,选择一
个块内的某个变量作为独立变量,其他变量作为常数,将目标函数转
化为关于该变量的单变量函数。
利用单变量函数的最优解求解该变量
的最优值,并反复迭代直至收敛。
然后,选择下一个块内的变量,继
续上述过程,直到所有块内的变量都求解完毕。
块坐标下降法在每一个块中,只更新其中一个变量的值,这种局
部更新方式极大地降低了计算和存储的开销,且块的大小和选择顺序
可以灵活调整,适用于很多大规模的非线性多目标函数优化问题,尤
其是在机器学习和人工智能领域中的应用比较广泛。
尽管块坐标下降法有很好的优化效果,但其收敛速度可能受到选
择块的大小和顺序随机性的影响,因此需要谨慎选择块的大小和顺序。
同时,如果函数非凸或存在多个局部最小值,则可以通过多次随机初
始化和运行来增加找到全局最小值的几率。
稀疏学习优化算法

实验结果 (1)
实验结果 (2)
实验结果 (3)
内容提纲
背景介绍 快速信赖域牛顿法 鲁棒多任务特征学习 多阶段多任务特征学习 迭代收缩阈值法快速求解非凸优化问题 总结和展望
非凸稀疏学习问题
与 可能是非凸的
2.5
2
1.5
1
L1
CapL1
LSP
0.5
MCP
SCAD
0
-10 -8 -6 -4 -2
直观解释二:分块坐标下降
共轭函数: 共轭的共轭:
g 是凹的且是闭函数
原优化问题:
等价形式:
分块坐标下降
直观解释二:分块坐标下降
分块坐标下降
加权系数
加权Lasso问题
收敛性分析
极限点存在吗?
有界,所以存在极限点
收敛定理
可再生性分析
加权Lasso 问题:
参数估计误差的界
多任务学习 (MTL)
共享信息
神经网络的隐层单元 贝叶斯模型的先验 分类权重向量 相似度量矩阵 低秩的子空间 一组特征 ……
多任务学习 (MTL)
Hale Waihona Puke 联合特征多任务学习示意图鲁棒多任务特征学习模型
学习共享特征+发现异常任务
P: 学习共享特征 Q: 发现异常任务 W: 权重矩阵
实验
逻辑回归中的信赖域步长问题:
其中
比较算法
多阶段共轭梯度 (MSCG) 梯度投影 (PG) 加速梯度投影 (APG)
所有的算法均是用 Matlab 来实现,实验是 在英特尔四核的处理器 (Intel(R) Core(TM)2 Quad CPU [Q6600 2.4GHz]),8G~内存的 个人 PC 机上运行。
对数几率回归的求解方法
对数几率回归的求解方法1. 标准求解:对数几率回归的求解方法主要是通过最大似然估计来实现。
最大似然估计的目标是找到一组参数,使得给定数据的观察概率最大化。
2. 梯度下降法:梯度下降法是一种迭代的优化算法,通过迭代更新参数来逐渐逼近最优解。
在对数几率回归中,可以利用梯度下降法来最大化似然函数。
3. 牛顿法:牛顿法是一种迭代的优化算法,通过逐步逼近最优解来最大化似然函数。
与梯度下降法不同,牛顿法利用目标函数的二阶导数来指导参数更新。
4. 拟牛顿法:拟牛顿法是一组近似牛顿法的优化算法。
它通过估计目标函数的海森矩阵或其逆矩阵来更新参数,从而实现对数几率回归的求解。
5. 共轭梯度法:共轭梯度法是一种用于求解线性方程组的优化算法,也可以用于求解对数几率回归。
它利用方向共轭性质来加速参数更新过程。
6. 正则化方法:正则化是一种用来控制模型复杂度的方法。
在对数几率回归中,可以引入L1正则化或L2正则化来降低过拟合的风险,并简化参数的求解过程。
7. 坐标下降法:坐标下降法是一种迭代的优化算法,它通过固定一部分参数而优化其他参数,以此来逐渐逼近最优解。
在对数几率回归中,可以使用坐标下降法来更新模型参数。
8. RANSAC算法:RANSAC(Random Sample Consensus)算法是一种鲁棒性较强的拟合算法。
在对数几率回归中,可以使用RANSAC算法来估计参数,并排除异常值的影响。
9. 改进的牛顿法:改进的牛顿法是对标准牛顿法的改进,通过引入阻尼因子来提高算法的稳定性。
在对数几率回归中,改进的牛顿法可以用来优化参数的求解。
10. 随机梯度下降法:随机梯度下降法是梯度下降法的一种变体。
它通过随机抽样小批量数据来更新参数,从而加快算法的收敛速度。
11. L-BFGS算法:L-BFGS(Limited-memory Broyden-Fletcher-Goldfarb-Shanno)算法是一种省内存版本的拟牛顿法。
三维空间 最优点 优化算法

三维空间最优点优化算法三维空间最优点优化算法是指在三维空间中寻找最优解的一种数学算法。
在许多实际问题中,需要在三维空间中找到最优点,以便优化某个目标函数的数值。
这种算法在许多领域具有广泛的应用,如机器学习、图像处理、物流优化等。
在三维空间中,最优点指的是使得目标函数取得最大或最小值的点。
这个点可能是一个局部最优点,也可能是全局最优点。
为了找到最优点,我们需要定义一个目标函数,然后通过优化算法来搜索最优点。
常见的三维空间最优点优化算法包括梯度下降法、牛顿法、遗传算法等。
这些算法都有各自的优缺点,适用于不同类型的问题。
下面将介绍其中几种常见的算法。
梯度下降法是一种迭代算法,通过计算目标函数在当前点的梯度信息,不断更新当前点的位置,直到找到最优点。
梯度下降法的优点是简单易实现,但其可能陷入局部最优点,无法找到全局最优点。
牛顿法是一种迭代算法,通过计算目标函数在当前点的一阶导数和二阶导数信息,来更新当前点的位置。
牛顿法的优点是收敛速度快,但其计算复杂度较高,且可能出现不收敛的情况。
遗传算法是一种模拟生物进化的优化算法,通过对种群中个体的遗传操作,不断迭代生成新的个体,直到找到最优点。
遗传算法的优点是能够全局搜索最优点,但其计算复杂度较高,且可能陷入局部最优点。
除了上述算法外,还有许多其他的三维空间最优点优化算法,如模拟退火算法、粒子群优化算法等。
这些算法根据问题的特点和要求,选择合适的算法进行优化。
在实际应用中,三维空间最优点优化算法可以用于解决各种问题。
例如,在机器学习中,可以使用这些算法来优化模型的参数,以提高模型的预测准确性。
在图像处理中,可以使用这些算法来寻找图像中的最优特征点,以实现图像识别和目标跟踪等功能。
在物流优化中,可以使用这些算法来优化路径规划和货物配送,以提高物流效率。
三维空间最优点优化算法是一种重要的数学算法,用于在三维空间中寻找最优解。
通过选择合适的算法和优化方法,可以有效地解决各种实际问题,提高问题的解决效率和准确性。
最速下降法原理及例题实例
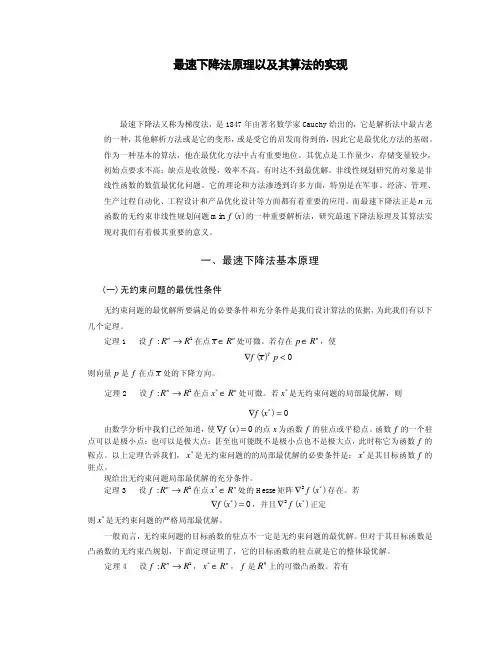
求单变量极小化问题:
min f ( x 0 + tp 0 ) = min f (44t , 3 − 24t )
t ≥0 t ≥0
= min(44t − 2)4 + (92t − ቤተ መጻሕፍቲ ባይዱ)2
t ≥0
的最优解 t 0 ,由 0.618 法可得 t 0 = 0.06 ,于是
X 1 = x 0 + t 0 p 0 = (2.70,1.51)T ∇f ( X 1 ) = (0.73,1.28)T ∇f ( X 1 ) = 1.47 > ε
T T
解:计算目标函数的梯度和 Hesse 阵
设d
(k )
= [ d1 , d 2 ] , ∇f ( X ( k ) ) = [ g1 , g 2 ] 得到精确一维搜索步长 αk = g1d1 + g 2 d 2 3d + d 2 2 − 2d1d 2
2 1
取X
(1)
= (0, 0)T ,则 ∇f ( X (1) ) = [ −2, 0] ,所以 d (1) = −∇f ( X (1) ) = [ 2, 0 ] ,
故
f ( x) = f ( X ( 2) + λ d (2) ) = (λ − 1) − (λ + 1) + 2(λ − 1)2 + 2(λ − 1)(λ + 1) + (λ + 1) 2 = 5λ 2 − 2λ − 1 = ϕ 2 (λ )
' 令 ϕ2 (λ ) = 10λ − 2 = 0 可得 λ2 =
一、最速下降法基本原理
(一) 无约束问题的最优性条件
无约束问题的最优解所要满足的必要条件和充分条件是我们设计算法的依据, 为此我们有以下 几个定理。 定理 1 设 f : R → R 在点 x ∈ R 处可微。若存在 p ∈ R ,使
《最优化方法》课程教学大纲

《最优化方法》课程教学大纲一、课程基本信息课程代码:102193课程名称:最优化方法英文名称:Optimization Methods课程类别:专业选修课学时:48学分:3适用对象:大三学生考核方式:考试先修课程:高等代数,数学分析二、课程简介本课程介绍线性规划,非线性规划的优化算法,主要包括:单纯形法,最速下降法,牛顿法,共轭梯度法,拟牛顿法等。
This course will introduce optimization methods in linear programming, and nonlinear programming, including: simplex method, steepest descent method, Newton's method, Conjugate gradient method and quasi Newton method et al.三、课程性质与教学目的本课程是面向大三数学与应用数学,信息与计算科学专业学生开设的专业选修课。
课程目的是介绍最优化的一些方法,作为人工智能的重要辅助课程,培养和增强学生解决实际数据分析问题中优化算法设计的能力。
四、教学内容及要求第一章最优化简介(一)目的与要求介绍最优化的研究内容和框架(二)教学内容最优化的研究范畴1.主要内容最优化方法的发展历程,分类2.基本概念和知识点最优化方法方法的简史.3.问题与应用(能力要求)了解最优化方法的发展历程.(三)思考与实践思考最优化方法所涉及的基础预备知识。
(四)教学方法与手段课堂讲授第二章凸优化(一)目的与要求介绍凸优化的基本概念和研究内容(二)教学内容1.主要内容凸集,凸包,凸函数,方向导数,上图2.基本概念和知识点凸集,凸函数3.问题与应用(能力要求)凸函数的判别(三)思考与实践上图的应用(四)教学方法与手段课堂讲授第三章一维优化(一)目的与要求掌握一维优化问题的可微性,凸性判别条件。
坐标下降方法的有效性优化问题

目
录
CONTENTS
03
解决办法
Lorem ipsum dolor sit amet Lorem ipsum dolor sit amet
无约束最小化的函数 :
• 现在让我们估计RCDM在强凸 函数上的表现。 回想一下,f 被称为强凸在具有凸度参数的 RN上
• •在置信水平β的复杂性界限(3.7), (3.11)的依赖性很温和因此,即使是很高 的置信水平也很容易实现。 • •标准梯度法具有复杂性界限全维梯度迭代。 请注意,在最坏的情况下情况L(f)可以达 到S1(f)。因此,对于所处理的目标函数 的类在定理4中,RCDM(1,x0)的最差情 况复杂性界限标准梯度法基本相同。请注 意,RCDM需要一定数量的满周期。但是这 个数字按比例增长准确度和置信水平的对 数。请注意,RCDM的单次迭代的计算成本 通常比这更小的标准梯度法。 •
可以看出:
• (1)坐标下降法在每次迭代 中在当前点处沿一个坐标方向 进行一维搜索 ,固定其他的坐 标方向,找到一个函数的局部 极小值。 • (2)坐标下降优化方法是一 种非梯度优化算法。在整个过 程中依次循环使用不同的坐标 方向进行迭代,一个周期的一 维搜索迭代过程相当于一个梯 度迭代。 • (3)gradient descent 方法是 利用目标函数的导数(梯度) 来确定搜索方向的,该梯度方 向可能不与任何坐标轴平行。 而coordinate descent方法是利 用当前坐标方向进行搜索,不 需要求目标函数的导数,只按 照某一坐标方向进行搜索最小 值。
坐标下降方法的有效性优化问题
概要
• 在本文中,提出了解决大规模 优化问题的新方法。对于这种 尺寸的问题,即使最简单的全 维向量操作也是非常昂贵的。 因此,我们提出应用基于随机 部分更新决策的优化技术变 量。 • 对于这些方法, 证明了收敛速 度的全局估计。 对于某些类别 的客观函数,我们的结果比标 准的最坏情况更好用于确定性 算法。 我们提供方法的约束和 无约束版本其加速变体。 我们 的数值测试证实了这种技术在 问题上的高效率非常大的尺寸.
LASSO的解法
LASSO 的解法LASSO ⾮常实⽤,但由于它的惩罚项不可以常规地进⾏求导,使得很多⼈以为它⽆法显式地求出解析解。
但其实并不是这样的。
1 单变量情形:软阈值法1.1 软阈值的分类讨论将N 个样本的真实值记为N 维向量y ,将N 个样本的⾃变量记为z ,假设我们已经将⾃变量做过标准化,即z ′ℓn =0,z ′z /N =1,这也意味着在LASSO 模型中截距项为0。
系数β是要优化的参数,惩罚项参数为λ>0。
LASSO 就是要求解\argmin β12N (y −z β)′(y −z β)+λ|β|忽略常数项后,上式等价于\argmin β12β2−y ′zN β+λ|β|将损失函数写成分段函数形式:f (β)=f 1(β)=12β2−y ′z N +λβ,β<0f 2(β)=12β2−y ′z N −λβ,β≥0分类讨论:若y ′z N >λ,则f 1(β)>0,f 2(β)在ˆβ=y ′z N −λ处取到最⼩值f 2(ˆβ)<0,因此解为ˆβ=y ′z N −λ;若y ′zN≤λ,则f 1(β)≥0,f 2(β)≥0,且在ˆβ=0处有f 1(ˆβ)=f 2(ˆβ)=0,因此解为ˆβ=0;若y ′z N <−λ,则f 2(β)>0,f 1(β)在ˆβ=y ′z N +λ处取到最⼩值f 1(ˆβ)<0,因此解为ˆβ=y ′z N +λ。
利⽤软阈值算⼦(soft-thresholding operator )S λ(x )=sign(x )(|x |−λ)+,可将以上三种解统⼀为ˆβ=S λ(y ′z /N )其实在我们的设定下,OLS 估计量为˜β=y ′z /N ,因此,将OLS 估计量通过⼀个软阈值算⼦的操作,就变成了LASSO 估计量。
1.2 次梯度如果引⼊次梯度(subgradient )的概念,可以更直接地求解(1)式。
设|β|的次梯度为s ∈sign(β),它的形式是,当β≠0时有s =sign(β),当β=0时有s ∈[−1,1]。
最速下降法原理及其算法实现
最速下降法原理及其算法实现最速下降法(Gradient Descent)是一种常用的优化算法,用于寻找函数的最小值。
它是一种迭代的方法,每次迭代都沿着负梯度方向更新参数,以减小目标函数的值。
在本文中,我们将介绍最速下降法的原理和算法实现。
1.最速下降法原理假设有一个目标函数f(x),其中x是一个向量。
我们的目标是找到使得f(x)最小的x。
最速下降法的思想是从任意初始点x0开始迭代,按照梯度方向更新参数,直到达到最优解。
具体地,设f(x)的梯度为g(x),即g(x)=∇f(x)。
最速下降法的迭代公式为:x(n+1)=x(n)-α*g(x(n))其中,x(n)表示第n次迭代的参数向量,α是迭代步长,也称为学习率。
每次迭代时,我们沿着梯度方向更新参数,α控制更新的步长。
我们期望通过不断迭代,逐渐逼近最优解。
2.最速下降法算法实现步骤1:初始化参数。
选择初始点x(0),设定学习率α,设定最大迭代次数。
步骤2:迭代过程。
重复以下步骤,直到达到最大迭代次数或满足收敛条件:a)计算梯度g(x(n))=∇f(x(n))。
b)更新参数。
根据迭代公式进行更新,x(n+1)=x(n)-α*g(x(n))。
c)判断终止条件。
比较f(x(n+1))和f(x(n))的差异,如果差异小于一定阈值,停止迭代。
步骤3:输出结果。
输出最优参数x*,即使得f(x)最小的参数。
需要注意的是,在实际应用中,我们可能需要进行一些改进来提高最速下降法的性能。
例如,可以使用线来自适应地选择学习率以保证每次更新获得合理的进展。
此外,为了加快收敛速度,可以使用加速算法,如动量法、Nesterov 加速梯度法等。
3.总结。
稀疏编码的权重更新方法详解
稀疏编码的权重更新方法详解稀疏编码是一种重要的机器学习技术,用于处理高维数据的降维和特征选择问题。
在稀疏编码中,我们希望通过学习一组稀疏的权重来表示输入数据。
本文将详细介绍稀疏编码的权重更新方法。
稀疏编码的核心思想是将输入数据表示为一组稀疏的线性组合。
假设我们有一个输入向量x,我们希望用一组权重向量w来表示它。
我们可以将这个问题看作是一个优化问题,即最小化重构误差。
稀疏编码中最常用的优化方法是通过最小化重构误差和加上一个稀疏性约束来求解权重向量w。
其中,重构误差可以通过计算输入向量x与重构向量y之间的欧氏距离来衡量。
稀疏性约束可以通过L1正则化来实现,即最小化权重向量w的L1范数。
在更新权重向量w时,我们可以使用梯度下降法来求解。
梯度下降法的基本思想是通过迭代地更新权重向量w来逐步降低重构误差。
具体而言,我们首先计算重构向量y与输入向量x之间的误差,然后根据误差的梯度来更新权重向量w。
在稀疏编码中,还存在一种重要的权重更新方法,即坐标下降法。
坐标下降法的思想是将权重向量w分解为多个子向量,然后逐个更新每个子向量的值。
这种方法可以大大降低计算复杂度,并且在某些情况下可以获得更好的结果。
除了梯度下降法和坐标下降法,还有一种常用的权重更新方法是交替最小二乘法。
交替最小二乘法的思想是固定一个变量,然后通过最小化一个二次误差函数来求解另一个变量。
通过交替地更新两个变量,可以逐步降低重构误差。
除了上述的常用方法,还有一些其他的权重更新方法可以用于稀疏编码。
例如,一些研究者提出了一种基于贪婪算法的权重更新方法,该方法通过迭代地选择最大的权重来更新权重向量w。
这种方法可以在一定程度上提高稀疏性,并且具有较好的计算效率。
总结起来,稀疏编码的权重更新方法包括梯度下降法、坐标下降法、交替最小二乘法和基于贪婪算法的方法。
这些方法在不同的场景下有不同的优势和适用性。
在实际应用中,我们可以根据具体的问题选择合适的方法来求解权重向量w,从而实现高效的稀疏编码。
最速下降法的基本原理解析
最速下降法的基本原理解析标题:最速下降法的基本原理解析摘要:本文将详细解析最速下降法(steepest descent method)的基本原理。
最速下降法是一种经典的优化算法,广泛应用于数学、物理、工程等领域。
文章将从简单的示例开始,逐步深入探讨最速下降法的数学原理和迭代过程,并讨论其优缺点及适用范围。
最后,本文将分享对最速下降法的观点和理解。
1. 引言在优化问题中,最速下降法是一种常见且有效的方法。
它通过不断朝着损失函数梯度的反方向进行迭代,以寻求损失函数的最小值点。
最速下降法的基本原理是尽可能减小目标函数的变化率,从而逐步接近最优解。
2. 数学原理最速下降法的核心思想是在每次迭代中,沿着梯度的方向下降,以逐步接近最优解。
对于多元函数,最速下降法可以表示为以下迭代公式:其中,x是待求解的变量,α是学习率或步长,∇f(x)是目标函数f(x)的梯度。
该迭代过程将反复执行,直到满足停止条件。
3. 迭代过程及示例为了更好地理解最速下降法的迭代过程,我们以一个简单的二次函数为例进行说明。
假设目标函数f(x) = x^2,我们的目标是找到使f(x)最小的x。
根据最速下降法的迭代公式,我们有:x(n+1) = x(n) - α * 2x(n)其中,x(n)表示第n次迭代的x值。
通过不断迭代,我们可以逐步接近最优解x=0,即f(x)的最小值。
4. 优缺点及适用范围最速下降法具有以下优点:- 简单易实现:最速下降法的数学原理简单,迭代公式易于实现。
- 可用于非线性问题:最速下降法适用于求解非线性问题,并能得到较好的结果。
然而,最速下降法也存在一些缺点:- 收敛速度慢:最速下降法收敛速度较慢,在某些情况下可能需要较多的迭代次数。
- 受初始点选择影响:最速下降法的收敛性和结果受初始点的选择影响,有时可能收敛到局部最优解而非全局最优解。
最速下降法适用于大多数连续可导的优化问题,特别是在解空间较小且问题表达简单的情况下。