
五大免费开源的数据挖掘软件
Orange
Orange 是一个基于组件的数据挖掘和机器学习软件套装,它的功能即友好,又很强大,快速而又多功能的可视化编程前端,以便浏览数据分析和可视化,基绑定了Python以进行脚本开发。
它包含了完整的一系列的组件以进行数据预处理,并提供了数据帐目,过渡,建模,模式评估和勘探的功能。
其由C++和Python开发,它的图形库是由跨平台的Qt框架开发。
RapidMiner
RapidMiner,以前叫YALE (Yet Another Learning Environment),其是一个给机器学习和数据挖掘和分析的试验环境,同时用于研究了真实世界数据挖掘。
它提供的实验由大量的算子组成,而这些算子由详细的XML 文件记录,并被RapidMiner图形化的用户接口表现出来。
RapidMiner为主要的机器学习过程提供了超过500算子,并且,其结合了学习方案和Weka 学习环境的属性评估器。
它是一个独立的工具可以用来做数据分析,同样也是一个数据挖掘引擎可以用来集成到你的产品中。
Weka
由Java开发的Weka (Waikato Environment for Knowledge Analysis)是一个知名机器学机软件,其支持几种经典的数据挖掘任务,显著的数据预处理,集群,分类,回归,虚拟化,以及功能选择。
其技术基于假设数据是以一种单个文件或关联的,在那里,每个数据点都被许多属性标注。
Weka 使用Java的数据库链接能力可以访问SQL数据库,并可以处理一个数据库的查询结果。
它主要的用户接品是Explorer,也同样支持相同功能的命令行,或是一种基于组件的知识流接口。
JHepWork
为科学家,工程师和学生所设计的jHepWork 是一个免费的开源数据分析框架,其主要是用开源库来创建一个数据分析环境,并提供了丰富的用户接口,以此来和那些收费的的软件竞争。
它主要是为了科学计算用的二维和三维的制图,并包含了用Java实现的数学科学库,随机数,和其它的数据挖掘算法。
jHepWork 是基于一个高级的编程语言Jython,当然,Java代码同样可以用来调用jHepWork 的数学和图形库。
KNIME
KNIME (Konstanz Information Miner)是一个用户友好,智能的,并有丰演的开源的数据集成,数据处理,数据分析和数据勘探平台。
它给了用户有能力以可视化的方式创建数据流或数据通道,可选择性地运行一些或全部的分析步骤,并以后面研究结果,模型以及可交互的视图。
KNIME 由Java写成,其基于Eclipse 并通过插件的方式来提供更多的功能。
通过以插件的文件,用户可以为文件,图片,和时间序列加入处理模块,并可以集成到其它各种各样的开源项目中,比如:R语言,Weka,Chemistry Development Kit,和LibSVM.。
开源数据库管理工具

开源数据库管理工具开源数据库管理工具是指那些可以免费获取、使用和修改的数据库管理软件。
这些工具提供了一种方便、高效的方法来管理和操作数据库。
本文将介绍一些常见的开源数据库管理工具以及它们的功能和应用场景。
一、MySQL WorkbenchMySQL Workbench是一个功能强大的数据库设计和管理工具,适用于MySQL数据库。
它提供了直观的图形界面,方便用户进行数据库的设计、管理和查询。
MySQL Workbench支持多种操作系统,并且可以连接远程数据库,使得团队协作更加便捷。
此外,MySQL Workbench还提供了性能优化和调试工具,帮助用户提升数据库的运行效率。
二、pgAdminpgAdmin是一个开源的PostgreSQL数据库管理工具,支持Windows、Linux和macOS等操作系统。
它提供了类似于MySQL Workbench的功能,可以进行数据库设计、管理和查询。
pgAdmin还具备备份恢复、性能优化和监控等功能,帮助用户更好地管理PostgreSQL数据库。
三、phpMyAdminphpMyAdmin是一个基于Web的MySQL数据库管理工具,它允许用户通过浏览器来管理MySQL数据库。
phpMyAdmin提供了图形界面,使得用户可以方便地进行数据库的创建、编辑和删除。
此外,phpMyAdmin还支持SQL查询、导入导出数据和用户权限管理等功能,使得数据库管理更加便捷。
四、AdminerAdminer是一个功能齐全的数据库管理工具,支持MySQL、PostgreSQL、SQLite和Oracle等多种数据库。
与其他数据库管理工具相比,Adminer的特点之一是体积小巧,仅有一个PHP文件,便于快速部署和使用。
它提供了图形化界面和SQL编辑器,满足用户进行数据库操作的需要。
五、Sequel ProSequel Pro是一款专为Mac开发者设计的MySQL数据库管理工具。
它提供了直观的用户界面和强大的功能,适用于数据库的设计、管理和查询。
实验室科研数据的开源分析工具与平台
实验室科研数据的开源分析工具与平台引言在科研实验室中,数据分析是一个不可或缺的环节。
传统上,科研数据分析常常面临数据量庞大、计算复杂、工具使用门槛高的问题。
然而,随着开源技术的发展,越来越多的开源工具和平台正在改变科研数据分析的形态。
本文将介绍一些常用的开源科研数据分析工具与平台,帮助科研人员更高效地进行数据分析。
1. Jupyter Notebook1.1 简介Jupyter Notebook是一个基于Web的交互式笔记本,支持多种编程语言,包括Python、R、Julia等。
它允许用户以交互的方式编写和分享代码、文本和图形,并直接在笔记本中进行数据分析。
1.2 功能及优势•支持多种编程语言,适合不同科研领域的数据分析需求。
•可以编写文档、公式、代码和图形等多种元素,方便展示和共享实验结果。
•支持实时运行代码,方便调试和交互式数据分析。
•支持插件扩展,可以自定义功能和界面。
2. Pandas2.1 简介Pandas是一个Python库,提供高性能、易用的数据结构和数据分析工具。
它是基于NumPy构建的,可以处理各种类型的数据,包括数值、时间序列、表格等。
2.2 功能及优势•提供DataFrame和Series等数据结构,方便处理和操作数据。
•支持数据的读取、过滤、清洗、分组、聚合等常用操作。
•提供丰富的数据统计和可视化功能,方便进行数据探索和展示。
•支持与其他库(如Matplotlib、Seaborn)的无缝集成。
3. Scikit-learn3.1 简介Scikit-learn是一个Python机器学习库,提供一系列常用的机器学习算法和工具。
它建立在NumPy、SciPy和Matplotlib之上,可以与Pandas等库无缝集成。
3.2 功能及优势•提供广泛的机器学习算法,包括分类、回归、聚类、降维等。
•支持模型评估、参数调优、交叉验证等常用机器学习任务。
•提供易用的API和丰富的文档,适合机器学习初学者和专业人士使用。
科学研究中的数据分析软件推荐
科学研究中的数据分析软件推荐在科学研究中,数据分析扮演着至关重要的角色。
无论是进行实验室研究、野外调查还是大规模数据挖掘,数据分析软件都是必不可少的工具。
本文将为您推荐几款在科学研究中常用的数据分析软件,并简要介绍它们的特点和适用领域。
一、MATLABMATLAB是一种功能强大的数值计算和编程环境,既适用于数据分析和可视化,也适用于算法开发和模型建立。
它提供了丰富的数据处理函数和工具箱,可用于统计分析、信号处理、图像处理等多个领域。
MATLAB还具有友好的用户界面和灵活的编程语言,使得科学研究者可以轻松地进行数据处理和算法实现。
二、R语言R语言是一种开源的统计分析软件,免费且可扩展。
它提供了丰富的统计分析函数和图形绘制功能,适合各种数据处理和建模任务。
R 语言拥有一个庞大的用户社区,可以方便地获取各种扩展包和代码示例,解决实际问题。
尤其在生物信息学、社会科学和金融领域,R语言已经成为主流的数据分析工具。
三、PythonPython是一种通用的编程语言,也被广泛应用于科学研究中的数据分析。
Python拥有丰富的开源库,例如NumPy、SciPy和Pandas,提供了强大的数据处理和分析功能。
Python还可以配合Jupyter Notebook等交互式环境使用,方便研究者进行实时数据可视化和代码调试。
由于Python易学易用,成为越来越多科学家的首选数据分析工具。
四、SPSSSPSS(Statistical Package for the Social Sciences)是一种广泛应用于社会科学研究的统计分析软件。
它提供了直观且易于操作的用户界面,适合不同水平的数据分析师使用。
SPSS支持各种统计分析方法和模型,例如描述统计、假设检验、回归分析等。
此外,SPSS还能进行数据清洗、数据转换和报告生成,方便用户进行全流程的数据分析工作。
五、SASSAS(Statistical Analysis System)是一种专业的统计分析软件,主要应用于商业和医疗领域的数据分析。
款常用的数据挖掘工具推荐
12款常用的数据挖掘工具推荐数据挖掘工具是使用数据挖掘技术从大型数据集中发现并识别模式的计算机软件。
数据在当今世界中就意味着金钱,但是因为大多数数据都是非结构化的。
因此,拥有数据挖掘工具将成为帮助您获得正确数据的一种方法。
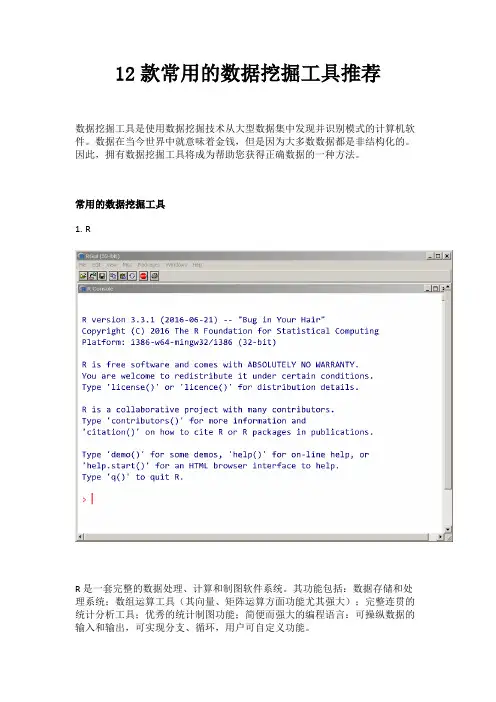
常用的数据挖掘工具1.RR是一套完整的数据处理、计算和制图软件系统。
其功能包括:数据存储和处理系统;数组运算工具(其向量、矩阵运算方面功能尤其强大);完整连贯的统计分析工具;优秀的统计制图功能;简便而强大的编程语言:可操纵数据的输入和输出,可实现分支、循环,用户可自定义功能。
2.Oracle数据挖掘(ODM)Oracle Data Mining是Oracle的一个数据挖掘软件。
Oracle数据挖掘是在Oracle 数据库内核中实现的,挖掘模型是第一类数据库对象。
Oracle数据挖掘流程使用Oracle 数据库的内置功能来最大限度地提高可伸缩性并有效利用系统资源。
3.TableauTableau提供了一系列专注于商业智能的交互式数据可视化产品。
Tableau允许通过将数据转化为视觉上吸引人的交互式可视化(称为仪表板)来实现数据的洞察与分析。
这个过程只需要几秒或几分钟,并且通过使用易于使用的拖放界面来实现。
5. ScrapyScrapy,Python开发的一个快速、高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据。
Scrapy用途广泛,可以用于数据挖掘、监测和自动化测试。
6、WekaWeka作为一个公开的数据挖掘工作平台,集合了大量能承担数据挖掘任务的机器学习算法,包括对数据进行预处理,分类,回归、聚类、关联规则以及在新的交互式界面上的可视化。
Weka高级用户可以通过Java编程和命令行来调用其分析组件。
同时,Weka也为普通用户提供了图形化界面,称为Weka KnowledgeFlow Environment和Weka Explorer。
和R相比,Weka在统计分析方面较弱,但在机器学习方面要强得多。
大数据查询免费的软件

大数据查询免费的软件随着信息技术的发展和互联网的普及,大数据的应用已经渗透到各个领域。
大数据查询软件是其中的重要组成部分,它可以帮助用户快速高效地查询和分析庞大的数据集。
在市场上,有许多商业化的大数据查询软件,但是它们往往价格昂贵,不适合个人用户或者小型企业使用。
为了满足广大用户的需求,一些开源的大数据查询软件应运而生,它们不仅功能强大,而且免费使用。
本文将介绍几款免费且优秀的大数据查询软件。
1. Apache HadoopApache Hadoop 是一个开源的大数据框架,提供了分布式存储和分布式计算的能力。
它可以处理大规模的数据集,并且具有良好的容错性和可扩展性。
Hadoop 的核心模块包括 Hadoop Distributed File System(HDFS)和 Hadoop MapReduce。
HDFS 提供了大规模数据的存储能力,而 MapReduce 则负责数据的分布式处理和计算。
Hadoop 还支持其他生态系统组件,如Hive、Pig、HBase等,可以满足不同场景下的多样化需求。
Hadoop 的优点在于其强大的处理能力和开放的生态系统,可以支持各种类型和规模的数据处理任务。
但是,对于初学者来说,Hadoop 的学习门槛较高,需要掌握一定的编程知识和基础概念。
同时,部署和配置一个完整的 Hadoop 集群也需要相当的工作量。
2. Apache SparkApache Spark 是另一个开源的大数据处理框架,与 Hadoop 类似,它也提供了分布式存储和分布式计算的能力。
但是相比于 Hadoop,Spark 具有更快的计算速度和更友好的编程接口,可以更方便地进行大规模数据处理和查询。
Spark 提供了丰富的 API,支持多种编程语言,包括 Scala、Java、Python和R 等。
用户可以根据自己的需求选择合适的编程语言进行开发。
此外,Spark 还提供了一些高层次的组件,如Spark SQL、Spark Streaming和MLlib,使得用户能够更方便地进行数据查询、实时数据处理和机器学习任务。
weka总结

Weka总结引言Weka是一个免费、开源的数据挖掘和机器学习软件,于1997年首次发布。
它由新西兰怀卡托大学的机器学习小组开发,提供了一系列数据预处理、分类、回归、聚类和关联规则挖掘等功能。
本文将对Weka进行总结,并讨论其主要功能和优点。
主要功能1. 数据预处理Weka提供了各种数据预处理技术,用于数据的清洗、转换和集成。
最常用的预处理技术包括缺失值处理、离散化、属性选择和特征缩放等。
通过这些预处理技术,用户可以减少数据中的噪声和冗余信息,提高机器学习模型的性能。
2. 分类Weka支持多种分类算法,包括决策树、贝叶斯分类器、神经网络和支持向量机等。
用户可以根据自己的需求选择适当的算法进行分类任务。
Weka还提供了交叉验证和自动参数调整等功能,帮助用户评估和优化分类器的性能。
3. 回归除了分类,Weka还支持回归问题的解决。
用户可以使用线性回归、多项式回归和局部回归等算法,对给定的数据集进行回归分析。
Weka提供了模型评估和可视化工具,帮助用户理解回归模型和评估其预测性能。
4. 聚类Weka的聚类算法可用于将数据集中相似的样本归类到一起。
Weka支持K-means、DBSCAN、谱聚类和层次聚类等常用的聚类算法。
用户可以根据数据的特点选择适当的算法并解释聚类结果。
5. 关联规则挖掘关联规则挖掘是一种常见的数据挖掘任务,用于发现数据集中的频繁项集和关联规则。
通过Weka,用户可以使用Apriori和FP-growth等算法来挖掘数据中的关联规则。
Weka还提供了支持多种评估指标的工具,用于评估关联规则的质量和可信度。
优点1. 易于使用Weka的用户界面友好且易于使用。
它提供了直观的图形界面,使用户可以快速上手并进行各种数据挖掘任务。
此外,Weka还支持命令行操作,方便用户在脚本中使用和集成Weka的功能。
2. 强大的功能Weka提供了丰富的数据挖掘和机器学习功能,涵盖了数据预处理、分类、回归、聚类和关联规则挖掘等领域。
研究生科研数据分析软件
研究生科研数据分析软件随着科学技术的进步,数据分析在研究生科研中的重要性也日益凸显。
为了更高效地处理和分析大量的科研数据,许多研究生借助科研数据分析软件来完成各种统计和数据挖掘工作。
本文将介绍几种常用的研究生科研数据分析软件。
1. SPSS(Statistical Package for the Social Sciences)SPSS是一种广泛使用的统计分析软件,特别适用于社会科学领域的数据分析。
它提供了丰富的分析工具和统计方法,包括描述性统计、回归分析、方差分析等。
SPSS具有友好的用户界面,操作简单易学,适合初学者使用。
2. MATLABMATLAB是一种强大的科学计算和数据可视化软件,广泛应用于各个学科的科研工作中。
它提供了丰富的数学函数和工具箱,可用于数据分析、模拟和优化等。
MATLAB还支持自定义算法和编程,因此对于需要灵活性和个性化定制的研究项目来说,是一个理想的选择。
3. R语言R语言是一种免费的开源编程语言和环境,主要用于统计计算和图形绘制。
它拥有强大的数据分析和统计建模功能,并具有丰富的数据处理和可视化函数库。
由于R语言开放源代码,研究生们可以方便地自行编写和共享自己的数据分析程序,并与其他研究人员进行交流和合作。
4. PythonPython是一种通用的编程语言,也被广泛应用于科学计算和数据分析领域。
Python具有丰富的科学计算库(如NumPy、Pandas和Matplotlib),可以进行数据处理、统计分析和可视化。
Python还具有简单易用的语法和良好的可读性,方便研究生们进行快速原型开发和实验。
5. SAS(Statistical Analysis System)SAS是一个完整的统计分析系统,适用于各个领域的数据分析和决策支持。
SAS提供了丰富的数据处理和分析功能,包括描述性统计、数据挖掘、机器学习等。
它也具备高效的图形绘制和报表生成能力。
尽管SAS是商业软件,但在一些特定的科研领域中仍然得到广泛使用。
大数据查询免费查询
大数据查询免费查询概述随着互联网的快速发展和智能设备的普及,大数据技术正成为越来越多企业和个人处理海量数据的首选方案。
然而,大数据查询往往需要庞大的计算资源和昂贵的软件许可费用。
在这样的背景下,免费的大数据查询解决方案对于那些资源有限的用户来说显得尤为重要。
本文将介绍一些免费的大数据查询工具和平台,帮助用户快速、高效地进行大数据查询和分析。
1. HadoopHadoop是一个开源的分布式计算系统,由Apache开发和维护。
它能够高效地存储和处理大规模数据,并支持并行计算。
使用Hadoop,用户可以轻松地在集群上进行数据查询和分析操作。
而且,Hadoop的生态系统非常丰富,拥有大量的工具和库可以帮助用户更好地处理大数据。
2. Apache SparkApache Spark是一个快速的大数据处理引擎,也是由Apache开发和维护的开源项目。
它提供了丰富的查询和分析功能,并具有优秀的性能。
Spark支持多种编程语言,如Scala、Java和Python,用户可以根据自己的喜好选择适合的语言进行开发。
此外,Spark还提供了图形化界面和交互式查询工具,帮助用户更加方便地进行数据查询和分析。
3. ElasticSearchElasticSearch是基于Apache Lucene的实时分布式搜索和分析引擎。
它被广泛应用于大数据领域,能够快速地存储、搜索和查询大规模数据。
ElasticSearch具有高度的可扩展性和灵活性,用户可以轻松地通过其丰富的API进行数据查询和分析操作。
此外,ElasticSearch还支持复杂的查询和聚合操作,用户可以根据自己的需求定制查询语句。
4. HiveHive是基于Hadoop的数据仓库和查询工具,由Facebook开发并贡献给Apache基金会。
它使用类似于SQL的查询语言HQL进行数据查询和分析操作。
Hive可以将结构化数据映射到Hadoop文件系统中,通过SQL-like查询语言提供高性能的查询和分析能力。
数据采集平台软件介绍
数据采集平台软件介绍1. Webhose.io:Webhose.io 是一个提供全球范围内全面的互联网数据收集和分析解决方案的数据提供商。
它使用自动化的网络爬虫技术,从互联网上收集大量的结构化、半结构化和非结构化数据。
Webhose.io 的特点包括高质量的数据源、实时数据获取、自定义数据筛选和分析工具。
它的应用场景包括市场调研、竞争情报、舆情分析等。
2. Import.io:Import.io 是一款强大的 Web 数据提取工具。
它可以将网页上的信息提取为结构化的数据,并可将其导出到 Excel、CSV 或数据库等格式。
Import.io 可以通过简单的点击和拖放来配置网页数据提取任务,而无需编写代码。
它的应用场景包括数据抓取、价格监测、市场分析等。
3. ParseHub:ParseHub 是一款易于使用且功能强大的网络爬虫工具。
它可以从各种网站提取数据,并将其转换为结构化的格式。
ParseHub 的特点包括可视化的配置界面、高度定制的数据选择和转换、自动化和调度功能等。
它适用于市场研究、数据分析、内容聚合等领域。
4. Octoparse:Octoparse 是一款智能的网页数据提取工具,它可以从各种网站抓取数据,并将其转换为结构化的格式。
Octoparse 的特点包括强大的抓取能力、智能的数据识别和处理、可视化的任务配置界面等。
Octoparse 的应用场景包括电子商务竞争情报、新闻聚合、舆情监测等。
5. Scrapy:Scrapy 是一款开源的 Python 框架,用于构建和部署定制化的网络爬虫软件。
它具有高度的可定制性和灵活性,并支持多种数据导出格式。
Scrapy 提供了强大的网络爬取和数据处理功能,适用于各种科研、商业和工程领域。
6. PhantomJS:PhantomJS 是一个基于 WebKit 的"无头"浏览器,它可以模拟浏览器行为,并将网页呈现为图像或 PDF。
weka使用教程
weka使用教程Weka是一个强大的开源机器学习软件,它提供了各种功能和算法来进行数据挖掘和预测分析。
以下是一个简单的Wea使用教程,帮助您了解如何使用它来进行数据分析和建模。
1. 安装Weka:首先,您需要下载并安装Weka软件。
您可以从官方网站上下载Weka的最新版本,并按照安装说明进行安装。
2. 打开Weka:安装完成后,打开Weka软件。
您将看到一个欢迎界面,上面列出了各种不同的选项和功能。
选择“Explorer”选项卡,这将帮助您导航和执行不同的任务。
3. 导入数据:在Explorer选项卡上,点击“Open file”按钮以导入您的数据集。
选择您要导入的数据文件,并确认数据文件的格式和结构。
4. 数据预处理:在导入数据之后,您可能需要对数据进行预处理,以清除噪声和处理缺失值。
在Weka中,您可以使用各种过滤器和转换器来处理数据。
点击“Preprocess”选项卡,然后选择适当的过滤器和转换器来定义您的预处理流程。
5. 数据探索:在数据预处理之后,您可以使用Weka的可视化工具来探索您的数据。
点击“Classify”选项卡,然后选择“Visualize”选项。
这将显示您的数据集的可视化图表和统计信息。
6. 建立模型:一旦您对数据进行了足够的探索,您可以使用Weka的各种机器学习算法建立模型。
在“Classify”选项卡上选择“Choose”按钮,并从下拉菜单中选择一个适当的分类算法。
然后,使用“Start”按钮训练模型并评估模型的性能。
7. 模型评估:一旦您建立了模型,您可以使用Weka提供的评估指标来评估模型的性能。
在“Classify”选项卡上,选择“Evaluate”选项,Weka将自动计算模型的准确性、精确度、召回率等指标。
8. 导出模型:最后,一旦您满意您的模型性能,您可以将模型导出到其他应用程序或格式中。
在Weka中,点击“Classify”选项卡,选择“Save model”选项,并指定模型的保存位置和格式。