
ncbi中查找基因序列的方法和三个登录号
ncbi中查找基因序列的方法和三个号码
一.例子:查找酿酒酵母(Saccharomyces cerevisiae)里的海藻糖合成酶基因(tps1)
即可出现很多条目,找到Saccharomyces cerevisiae的就是NC_001134了,点击后就进入该基因所在染色体的界面了,再在“编辑”中“查找”tps1就可以看该基因所在的位置,再点击CDS或者GeneID:852423都可以出现相关链接!
当然,如果你在文献查到目的蛋白的序列号如NP_009684.1或者GeneID:852423,那分别在Search后选择Protein或者Gene也可以出现相关链接!
二.基因CDS区界面的3个号码
/entrez/viewer.fcgi?val=50593115&from=488899&to=490386& view=gbwithparts
找到后,我发现该界面有3个标记,一个是NC_001134 ,其次是gi:50593115,最后是FEATURES中的gene中的/db_xref= “GeneID:852423”,他们分别是什么号码,用在什么地方呢?尝试中,终于发现,
在Search“Nucleotide”或者“Core Nucleotide”时,for后面是NC_001134,最终go 到该基因所在染色体全长序列的信息,所以NC_001134应该是该染色体的登录号吧?
在Search“Nucleotide”或者“Core Nucleotide”时,for后面是50593115,最终go到该基因所在染色体全长序列的信息,所以50593115应该是该染色体的号吧?
在Search“Gene”时,for后面是852423,最终go到该基因的信息,所以852423应该是该基因的登录号吧?所以我们如果要记住目的基因在ncbi中的位置就记住这个GeneID!
其他像NP_009684当然是基因编码的蛋白质的登录号啦,不说了。
我们在文献中查到的基因往往给的是Gene ID
三.引物设计第一步--找编码序列的方法
在Search“Gene”时,for后面是852423,最终go到目的基因的信息
点击中的FASTA,获得的就是mRNA的非模
板链(其实就是mRNA里的U换成了T),也可以说是CDNA的互补片段,因为与编码的蛋白质一一对应,所以也就是引物设计真正的模板!引物设计后面的PCR要克隆的就是这段序列!所以千万不要搞错了!点击GENBANK,获得的是CDS区的序列和相关信息,这个CDS区包括CDNA,也包括其他不编码的序列,所以PCR没必要把CDS区全部克隆出来!其实在CDS界面(或者说点击GENBANK后出现的界面里),把Display里的GENBANK (full)改成FASTA也可以!
其实在该界面中我们还可以了解到其他信息
1.点击reference sequence details,可以看到NP_009684.1,点击他,可以看到目的蛋白质
的信息
2.点击获得的是目的基因的图谱,然后点击
TPS1后面的sv,也可以看到编码序列了,当然这里的DNA序列和蛋白质一一对应,更说明是设计引物的模板(这个图谱界面也可以在2的点击GENBANK后获得的CDS区中点击852423链接获得,或者说条条链接通罗马!)
四.关于CDS和CDNA的关系
ncbi中的CDS就是编码序列,包括CDNA全部,也含有其他序列,毕竟CDNA是人为根据mRNA反转录得到的,而CDS区生物本身的,有些不编码的序列,好像CDNA是纯净物,CDS有点渣子,呵呵。
CDNA的互补序列既然是与编码的蛋白质一一对应的,当然是ATG起始的,TAA TAG TGA终止的。
ncbi使用指导
ncbi使用指导导言:NCBI(National Center for Biotechnology Information)是美国国家生物技术信息中心,是全球最大的生物信息学数据库。
NCBI提供了丰富的生物学资源,包括基因序列、蛋白质序列、科学文献等。
本文将为您介绍如何使用NCBI来获取和利用生物学信息。
一、注册NCBI账号在使用NCBI之前,首先需要注册一个账号。
在NCBI官方网站()的主页上,点击右上角的“Sign In”按钮,并选择“Register for an NCBI account”。
根据提示提供相关信息,完成注册流程。
二、搜索和获取基因序列1. 打开NCBI网站后,点击主页上的“Search”按钮,进入搜索页面。
2. 在搜索框中输入您感兴趣的基因名称或者序列标识符,如“BRCA1”。
3. 点击“Search”按钮进行搜索。
4. 在搜索结果中,选择您需要的基因序列,点击链接进入该基因的详细信息页面。
5. 在详细信息页面中,您可以获取该基因的序列信息,可以下载或拷贝该序列以供后续分析使用。
三、检索科学文献1. 在NCBI主页上方的搜索框中,选择“PubMed”为搜索目标。
2. 输入您感兴趣的科学文献关键词,如“cancer treatment”。
3. 点击搜索按钮进行检索。
4. 在搜索结果中,选择您需要的文献,点击链接进入该文献的详细页面。
5. 在详细页面中,您可以阅读文章摘要,并根据需要下载全文或进行其他操作。
四、利用NCBI工具进行序列分析1. 在NCBI主页上方的菜单栏中,选择“Tools”进行工具选择。
2. 根据您的需求选择相应的工具,如“BLAST”进行序列比对分析。
3. 进入选择的工具页面后,按照提示上传或输入您的序列数据。
4. 设定参数并运行分析。
5. 分析完成后,您可以查看比对结果、序列保守性等信息,并进行进一步的分析和解释。
五、订阅NCBI数据库更新信息1. 在NCBI主页上方菜单栏中选择“NCBI Account”。
NCBI良心教程寻找基因转录本序列及相关编码蛋白

NCBI良心教程寻找基因转录本序列及相关编码蛋白NCBI (National Center for Biotechnology Information) 是一个全球顶级的生物医学数据库,提供了大量的基因序列和相关的生物信息。
在这个教程里,我们将介绍如何在NCBI中基因转录本序列以及相关编码蛋白。
第一步:访问NCBI网站首先,打开你的浏览器,并输入 "NCBI",然后点击按钮。
在结果中,选择并点击进入 "NCBI - National Center for Biotechnology Information" 的官方网站。
第二步:选择数据库在NCBI的官方网站中,你可以看到很多不同的数据库。
对于本教程,我们将使用 "GenBank" 数据库来基因转录本序列以及相关编码蛋白。
点击页面左上角的 "Databases" 菜单,然后选择 "Nucleotide" 数据库,它是用于基因序列的数据库。
第三步:基因转录本序列在 "Nucleotide" 页面中,你会看到一个框,可以输入你感兴趣的基因的名称或相关关键词。
在框中输入基因的名称或相关关键词,然后点击按钮。
此时,你将看到与该基因相关的转录本序列的结果列表。
除了查找基因转录本序列,你还可以使用NCBI相关的编码蛋白质序列。
在 "Nucleotide" 页面中,选择 "Protein" 或 "Protein database" 选项卡。
在框中输入与你感兴趣的蛋白质相关的关键词,并点击按钮。
此时,你将看到与该蛋白质相关的转录本或基因的结果列表。
点击结果列表中感兴趣的蛋白质,你将进入蛋白质的详细页面。
在这个页面上,你可以找到该蛋白质的序列以及其他相关信息。
总结:在NCBI中基因转录本序列及相关编码蛋白可以通过以下步骤完成:1.访问NCBI官方网站;2.选择 "GenBank" 数据库;3.你感兴趣的基因的名称或相关关键词;4.点击结果中的转录本,查看序列和其他详细信息;5.如果你想相关编码蛋白质,选择 "Protein" 选项卡,并输入相关关键词;6.点击结果中的蛋白质,查看蛋白质序列和其他相关信息。
NCBI如何查找序列
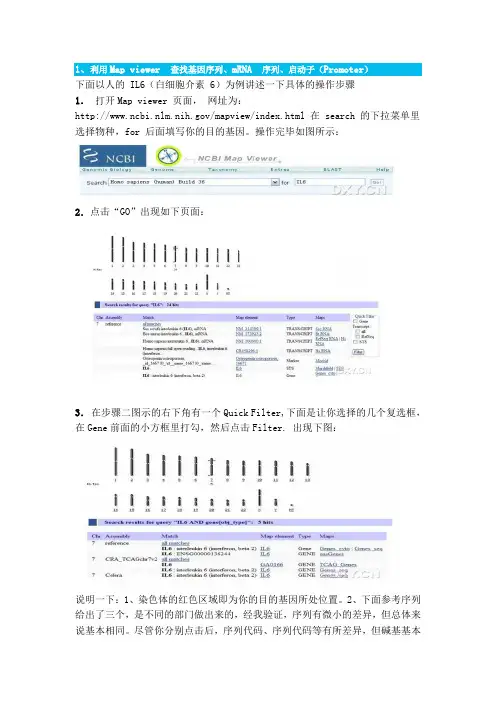
1下面以人的 IL6(白细胞介素 6)为例讲述一下具体的操作步骤1.打开Map viewer 页面,网址为:/mapview/index.html 在 search 的下拉菜单里选择物种,for 后面填写你的目的基因。
操作完毕如图所示:2.点击“GO”出现如下页面:3.在步骤二图示的右下角有一个Quick Filter,下面是让你选择的几个复选框,在Gene前面的小方框里打勾,然后点击Filter. 出现下图:说明一下:1、染色体的红色区域即为你的目的基因所处位置。
2、下面参考序列给出了三个,是不同的部门做出来的,经我验证,序列有微小的差异,但总体来说基本相同。
尽管你分别点击后,序列代码、序列代码等有所差异,但碱基基本一致,不影响大家研究分析序列。
现在普遍采用的是最上面的那个序列,这一条是世界范围的生物科学家用计算机合成的一个序列。
我也推荐大家使用这个序列。
4.点击上述三条序列第一条序列(即 reference)对应的"Genes seq",出现新的页面,页面下方为:5.点击上图出现的“Download/View Sequence/Evidence ”,即下载查看序列等功能,结果如图所示:先对上面这张图做点简要的说明,在 Sequence Format(序列输出格式)后面是一个下拉式选择菜单,默认的为 FASTA 格式,还有一个是 GenBank 格式。
我推荐大家选择 GenBnak格式,因为这个格式提供了很多该基因的信息,而 FASTA格式只有基因序列。
6.在 Sequence Format 后选择 GenBank,然后点击下面的 Display,目的基因的相关信息和序列就出现在眼前了。
点击后如图所示(网页较大,只抓取一小部分以作示范):在上述打开的网页中,你可以看到基因长度,基因序列,以及这个基因是如何被报道出来的等各种信息。
你会看到: mRNAjoin(3598..3678,3841..4031,5090..5203,5911..6057, 7803..8394) 这代表了从基因的 3598位开始就是转录区了,即我们常说的 mRNA 片断,由于内含子的存在,所以 mRNA 在DNA 序列上分成了几段。
一步一步教你使用 NCBI 查找DNA

一步一步教你使用 NCBI 查找DNA 一步一步教你使用 NCBI 查找DNA、mRNA、cDNA、Protein、promoter、引物设计、BLAST序列比对等最近看到很多战友在论坛上询问如何查询基因序列、如何进行引物设计、如何使用 BLAST 进行序列比对……,这些问题在 NCBI 上都可以方便的找到答案。
现在我就结合我自己使用 NCBI的一些经历(经验)跟大家交流一下 BCBI 的使用。
希望大家都能发表自己的使用心得,让我们共同进步~我分以下几个部分说一下 NCBI 的使用:Part one 如何查找基因序列、mRNA、PromoterPart two 如何查找连续的 mRNA、cDNA、蛋白序列Part three 运用 STS 查找已经公布的引物序列Part four 如何运用 BLAST 进行序列比对、检验引物特异性特别感谢本版版主,将这个帖子置顶~从发帖到现在,很多战友对该帖给与了积极的关注,在此向给我投票的(以及想给我投票却暂时不能投票的)各位战友表示真诚的感谢,谢谢各位战友~请大家对以下我发表的内容提出自己的意见。
关于NCBI 其他方面的使用也请水平较高的战友给予补充First of all,还是让我们从查找基因序列开始。
第一部分利用Map viewer 查找基因序列、mRNA 序列、启动子(Promoter)下面以人的 IL6(白细胞介素 6)为例讲述一下具体的操作步骤1( 打开Map viewer 页面,网址为: 在 search 的下拉菜单里选择物种,for 后面填写你的目的基因。
操作完毕如图所示:2(点击“GO”出现如下页面:3( 在步骤二图示的右下角有一个Quick Filter,下面是让你选择的几个复选框,在Gene前面的小方框里打勾,然后点击Filter. 出现下图:说明一下:1、染色体的红色区域即为你的目的基因所处位置。
2、下面参考序列给出了三个,是不同的部门做出来的,经我验证,序列有微小的差异,但总体来说基本相同。
NCBI如何查找序列
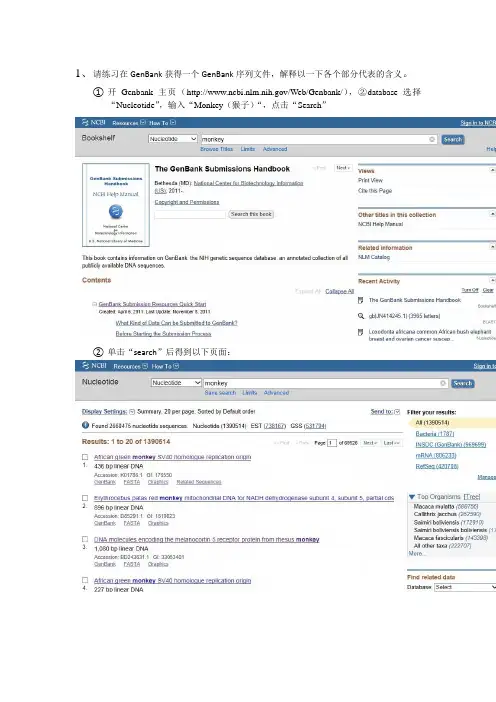
1、请练习在GenBank获得一个GenBank序列文件,解释以一下各个部分代表的含义。
①开Genbank主页(/Web/Genbank/),②database选择“Nucleotide”,输入“Monkey(猴子)“,点击“Search”②单击“search”后得到以下页面:③然后选择第一个序列文献打开;找到如下图的位置,选择“file“,保存到电脑。
序列内容如下:序列内容各部分意思如下:Go to:LOCUS AGMSV40RP 436 bp DNA linear PRI (名称)(碱基数)(分子类型)(分子类型)(灵长类)27-APR-1993(修正日期)DEFINITION African green monkey SV40 homologue replication origin. (定义行,精要描述序列特征)ACCESSION K01786(检索号)VERSION K01786.1 GI:176550(版本信息)KEYWORDS origin of replication.(关键词)SOURCE Chlorocebus aethiops (Cercopithecus aethiops)(物种来源及常用名)ORGANISM Chlorocebus aethiops(科学命名及该物种的分类地位)Eukaryota; Metazoa; Chordata; Craniata; Vertebrata;Euteleostomi;Mammalia; Eutheria; Euarchontoglires; Primates;Haplorrhini;Catarrhini; Cercopithecidae; Cercopithecinae; Chlorocebus. REFERENCE 1 (bases 1 to 436)(参考文献)AUTHORS Queen,C., Lord,S.T., McCutchan,T.F. and Singer,M.F.(作者)TITLE Three segments from the monkey genome that hybridize to simian (题目) virus 40 have common structural elementsJOURNAL Mol. Cell. Biol. 1 (12), 1061-1068 (1981)(期刊来源)PUBMED 6287216(数据库编号)REFERENCE 2 (sites)(参考文献)AUTHORS Dynan,W.S., Saffer,J.D., Lee,W.S. and Tjian,R.(作者)TITLE(题目) Transcription factor Sp1 recognizes promoter sequences from the monkey genome that are simian virus 40 promoterJOURNAL Proc. Natl. Acad. Sci. U.S.A. 82 (15), 4915-4919 (1985)(期刊来源)PUBMED 2991898(数据库编号)COMMENT(注释)Original source text: African green monkey liver DNA, clonepCaOri7.01 [1].[2] sites; Sp1 binding sites.Draft entry and clean copy sequences for [2] kindly provided byW.Dynan, 31-OCT-1985.Two segments of monkey DNA were hybridized and compared to SV40DNA. Each contained multiple copies of the sequence 'gggcggrr'which also appears six times near the origin of SV40 [1]. Bothcontained a long internal degenerate repeat [1]. The SV40 origin ofreplication contains several long repeats [1]. The SV40 hybridizingsegments are members of a larger family of genomic monkey sequencesthat hybridize well to each other, but not necessarily to SV40 [1].Two regions in the monkey DNA bind the promoter-specific cellulartranscription factor (SP1) and are protected by it in DNaseprotection experiments [2].FEATURES Location/Qualifiers(特征)source 1..436(物种来源) /organism="Chlorocebus aethiops"/mol_type="genomic DNA"/db_xref="taxon:9534"ORIGIN(序列区) SalI site.1 tcgaccacag ccagagtcca tgcatcggga ggttcactcg gtttgcgaag aacgggcagg61 gcatgcacgg cctgggctcg gcgggcgggc gggcgggccg gggcgcagtt cccaggttcg121 ccactagagg tcaggaggtg accgcttcgg ggctggaaga cgggcccgtc gtggattggc181 tagtgccggc ggagggcggg gcggagagtg gggcggggcg gagagtgggg cggggcgcag241 ttccccagtt cgccactaga ggtcaggagg tgaccgcttc ggggcgggaa gactggcccg301 tcggggattg gctagtgccg gcggggggcg gggcgggggg cggagggcgg ggtggacgtg361 gcacctggtt gctgacatct ggaatgactt ttttttggca tcggatttcc tgtctttgtg421 gggctgatgg acccga//2.预习genbank中blast的用法BLAST 是由美国国立生物技术信息中心(NCBI)开发的一个基于序列相似性的数据库搜索程序。
一步一步教你使用NCBI查找DNA、mRNA、cDNA

一步一步教你使用 NCBI 查找DNA、mRNA、cDNA、...最近看到很多战友在论坛上询问如何查询基因序列、如何进行引物设计、如何使用BLAST 进行序列比对……,这些问题在 NCBI 上都可以方便的找到答案。
现在我就结合我自己使用 NCBI的一些经历(经验)跟大家交流一下 BCBI 的使用。
希望大家都能发表自己的使用心得,让我们共同进步!我分以下几个部分说一下 NCBI 的使用:Part one 如何查找基因序列、mRNA、PromoterPart two 如何查找连续的 mRNA、cDNA、蛋白序列Part three 运用 STS 查找已经公布的引物序列Part four 如何运用 BLAST 进行序列比对、检验引物特异性特别感谢本版版主,将这个帖子置顶!从发帖到现在,很多战友对该帖给与了积极的关注,在此向给我投票的(以及想给我投票却暂时不能投票的)各位战友表示真诚的感谢,谢谢各位战友!请大家对以下我发表的容提出自己的意见。
关于NCBI 其他方面的使用也请水平较高的战友给予补充First of all,还是让我们从查找基因序列开始。
第一部分利用Map viewer 查找基因序列、mRNA 序列、启动子(Promoter)下面以人的 IL6(白细胞介素 6)为例讲述一下具体的操作步骤1.打开Map viewer 页面,网址为:/mapview/index.html在 search 的下拉菜单里选择物种,for 后面填写你的目的基因。
操作完毕如图所示:2.点击“GO”出现如下页面:3.在步骤二图示的右下角有一个Quick Filter,下面是让你选择的几个复选框,在Gene前面的小方框里打勾,然后点击Filter. 出现下图:说明一下:1、染色体的红色区域即为你的目的基因所处位置。
2、下面参考序列给出了三个,是不同的部门做出来的,经我验证,序列有微小的差异,但总体来说基本相同。
尽管你分别点击后,序列代码、序列代码等有所差异,但碱基基本一致,不影响大家研究分析序列。
ncbi中查找基因序列的方法和三个登录号
ncbi中查找基因序列的方法和三个号码一.例子:查找酿酒酵母(Saccharomyces cerevisiae)里的海藻糖合成酶基因(tps1)即可出现很多条目,找到Saccharomyces cerevisiae的就是NC_001134了,点击后就进入该基因所在染色体的界面了,再在“编辑”中“查找”tps1就可以看该基因所在的位置,再点击CDS或者GeneID:852423都可以出现相关链接!当然,如果你在文献查到目的蛋白的序列号如NP_009684.1或者GeneID:852423,那分别在Search后选择Protein或者Gene也可以出现相关链接!二.基因CDS区界面的3个号码/entrez/viewer.fcgi?val=50593115&from=488899&to=490386& view=gbwithparts找到后,我发现该界面有3个标记,一个是NC_001134 ,其次是gi:50593115,最后是FEATURES中的gene中的/db_xref= “GeneID:852423”,他们分别是什么号码,用在什么地方呢?尝试中,终于发现,在Search“Nucleotide”或者“Core Nucleotide”时,for后面是NC_001134,最终go 到该基因所在染色体全长序列的信息,所以NC_001134应该是该染色体的登录号吧?在Search“Nucleotide”或者“Core Nucleotide”时,for后面是50593115,最终go到该基因所在染色体全长序列的信息,所以50593115应该是该染色体的号吧?在Search“Gene”时,for后面是852423,最终go到该基因的信息,所以852423应该是该基因的登录号吧?所以我们如果要记住目的基因在ncbi中的位置就记住这个GeneID!其他像NP_009684当然是基因编码的蛋白质的登录号啦,不说了。
教你使用NCBI查找DNA、mRNA、cDNA
一步一步教你使用 NCBI 查找DNA、mRNA、cDNA、...最近看到很多战友在论坛上询问如何查询基因序列、如何进行引物设计、如何使用BLAST 进行序列比对……,这些问题在 NCBI 上都可以方便的找到答案。
现在我就结合我自己使用 NCBI的一些经历(经验)跟大家交流一下 BCBI 的使用。
希望大家都能发表自己的使用心得,让我们共同进步!我分以下几个部分说一下 NCBI 的使用:Part one 如何查找基因序列、mRNA、PromoterPart two 如何查找连续的 mRNA、cDNA、蛋白序列Part three 运用 STS 查找已经公布的引物序列Part four 如何运用 BLAST 进行序列比对、检验引物特异性特别感谢本版版主,将这个帖子置顶!从发帖到现在,很多战友对该帖给与了积极的关注,在此向给我投票的(以及想给我投票却暂时不能投票的)各位战友表示真诚的感谢,谢谢各位战友!请大家对以下我发表的内容提出自己的意见。
关于NCBI 其他方面的使用也请水平较高的战友给予补充First of all,还是让我们从查找基因序列开始。
第一部分利用Map viewer 查找基因序列、mRNA 序列、启动子(Promoter)下面以人的 IL6(白细胞介素 6)为例讲述一下具体的操作步骤1.打开Map viewer 页面,网址为:/mapview/index.html在 search 的下拉菜单里选择物种,for 后面填写你的目的基因。
操作完毕如图所示:2.点击“GO”出现如下页面:3.在步骤二图示的右下角有一个Quick Filter,下面是让你选择的几个复选框,在Gene前面的小方框里打勾,然后点击Filter. 出现下图:说明一下:1、染色体的红色区域即为你的目的基因所处位置。
2、下面参考序列给出了三个,是不同的部门做出来的,经我验证,序列有微小的差异,但总体来说基本相同。
尽管你分别点击后,序列代码、序列代码等有所差异,但碱基基本一致,不影响大家研究分析序列。
NCBI如何查找序列
1下面以人的 IL6(白细胞介素 6)为例讲述一下具体的操作步骤1.打开Map viewer 页面,网址为:/mapview/index.html 在 search 的下拉菜单里选择物种,for 后面填写你的目的基因。
操作完毕如图所示:2.点击“GO”出现如下页面:3.在步骤二图示的右下角有一个Quick Filter,下面是让你选择的几个复选框,在Gene前面的小方框里打勾,然后点击Filter. 出现下图:说明一下:1、染色体的红色区域即为你的目的基因所处位置。
2、下面参考序列给出了三个,是不同的部门做出来的,经我验证,序列有微小的差异,但总体来说基本相同。
尽管你分别点击后,序列代码、序列代码等有所差异,但碱基基本一致,不影响大家研究分析序列。
现在普遍采用的是最上面的那个序列,这一条是世界范围的生物科学家用计算机合成的一个序列。
我也推荐大家使用这个序列。
4.点击上述三条序列第一条序列(即 reference)对应的"Genes seq",出现新的页面,页面下方为:5.点击上图出现的“Download/View Sequence/Evidence ”,即下载查看序列等功能,结果如图所示:先对上面这张图做点简要的说明,在 Sequence Format(序列输出格式)后面是一个下拉式选择菜单,默认的为 FASTA 格式,还有一个是 GenBank 格式。
我推荐大家选择 GenBnak格式,因为这个格式提供了很多该基因的信息,而 FASTA格式只有基因序列。
6.在 Sequence Format 后选择 GenBank,然后点击下面的 Display,目的基因的相关信息和序列就出现在眼前了。
点击后如图所示(网页较大,只抓取一小部分以作示范):在上述打开的网页中,你可以看到基因长度,基因序列,以及这个基因是如何被报道出来的等各种信息。
你会看到: mRNAjoin(3598..3678,3841..4031,5090..5203,5911..6057, 7803..8394) 这代表了从基因的 3598位开始就是转录区了,即我们常说的 mRNA 片断,由于内含子的存在,所以 mRNA 在DNA 序列上分成了几段。
NCBI如何查找序列
NCBI如何查找序列NCBI(National Center for Biotechnology Information)是一个提供生物医学信息服务的国家机构。
NCBI的数据库中包含了大量的生物医学和基因组学的数据和文献,其中包括各种序列数据。
在NCBI上查找序列包括以下几个步骤:2. 选择数据库:由于NCBI有多个数据库,您需要选择适当的数据库来查找您感兴趣的序列。
常用的数据库包括:GenBank、RefSeq、PubMed 等。
3. 使用基本:如果您已经知道您要查找的序列的具体信息,您可以使用基本进行查找。
在NCBI的主页上,您可以看到一个栏,您可以在这里输入您的查询。
例如,如果您想查找一些基因的序列,您可以输入基因的名称或序列的Accession号码。
4. 使用高级选项:如果您想进行更精确的,您可以使用高级选项。
在栏旁边有一个下拉菜单,您可以在这里选择“Advanced search”选项。
在高级页面上,您可以选择更多的限定条件进行。
例如,您可以选择限制的数据库、限定结果的时间范围、指定关键字的位置等。
5. 根据结果浏览:NCBI将会返回与您的查询相匹配的结果列表。
您可以点击每个结果的标题来查看详细信息。
在详细信息页面上,您可以找到该序列的Accession号码、相关文献、相关数据库的链接等。
7. 进行进一步分析:一旦您获得了您感兴趣的序列,您可以将其用于进一步的分析。
您可以在NCBI的其他数据库中使用该序列进行比对、注释、序列比较等。
例如,您可以将序列输入到BLAST(Basic Local Alignment Search Tool)进行比对,并获得与该序列相似的其他序列。
总之,NCBI是一个强大的工具,能够提供各种生物医学信息和序列数据。
通过使用NCBI的功能和相应的数据库,您可以找到所需的序列并进行相关的生物信息学分析。