
算术编码与解码
算术编码与解码
1、编码过程
算术编码方法是将被编码的一则消息或符号串(序列)表示成0和1之间的一个间隔(Interval),即对一串符号直接编码成[0,1]区间上的一个浮点小数。
符号序列越长,编码表示它的间隔越小,表示这一间隔所需的位数就越多。
信源中的符号序列仍然要根据某种模式生成概率的大小来减少间隔。
可能出现的符号概率要比不太可能出现的符号减少范围小,因此,只正加较少的比特位。
在传输任何符号串之前,0符号串的完整范围设为[0,1]。
当一个符号被处理时,这一范围就依据分配给这一符号的那一范围变窄。
算术编码的过程,实际上就是依据信源符号的发生概率对码区间分割的过程。
输入:一个字符串
输出:一个小数
考虑某条信息中可能出现的字符仅有a b c 三种,要压缩保存的信息为bccb。
假设对a b c 三者在信息中的出现概率一无所知(采用自适应模型),暂时认为三者的出现概率相等,也就是都为1/3,将0 - 1 区间按照概率的比例分配给三个字符,即a 从0.0000 到0.3333,b 从0.3333 到0.6667,c 从0.6667 到 1.0000。
用图形表示就是:
+-- 1.0000 | Pc = 1/3 | | +-- 0.6667 | Pb = 1/3 | | +-- 0.3333 | Pa = 1/3 | | +-- 0.0000
对于第一个字符b,选择b 对应的区间0.3333 - 0.6667。
这时由于多了字符b,三个字符的概率分布变成:Pa = 1/4,Pb = 2/4,Pc = 1/4。
再按照新的概率分布比例划分0.3333 - 0.6667 这一区间,划分的结果可以用图形表示为:
+-- 0.6667 Pc = 1/4 | +-- 0.5834 | | Pb = 2/4 | | | +-- 0.4167 Pa = 1/4 | +-- 0.3333
接着字符c,上一步中得到的 c 的区间0.5834 - 0.6667。
新添了c 以后,三个字符的概率分布变成Pa = 1/5,Pb = 2/5,Pc = 2/5。
用这个概率分布划分区间0.5834 - 0.6667:
+-- 0.6667 | Pc = 2/5 | | +-- 0.6334 | Pb = 2/5 | | +-- 0.6001 Pa = 1/5 | +-- 0.5834
现在输入下一个字符c,三个字符的概率分布为:Pa = 1/6,Pb = 2/6,Pc = 3/6。
划分c 的区间0.6334 - 0.6667:
+-- 0.6667 | | Pc = 3/6 | | | +-- 0.6501 | Pb = 2/6 | | +-- 0.6390 Pa = 1/6 | +-- 0.6334
输入最后一个字符b,因为是最后一个字符,不用再做进一步的划分了,上一步中得到的 b 的区间为0.6390 - 0.6501,好,让我们在这个区间内随便选择一个容易变成二进制的数,例如0.64,将它变成二进制0.1010001111,去掉前面没有太多意义的0 和小数点,我们可以输出1010001111,这就是信息被压缩后的结果,我们完成了一次最简单的算术压缩过程。
我的代码:
publicstaticvoidBianMa(String info,StringDeal sd){
int i = 0, j = 0;
//定义上下限
double low = 0, high = 1;
double count = sd.getCount();
//定义初始各字符频率
double[] zifu = new double[(int)(count)];
for(i = 0;i < zifu.length;i++){
zifu[i] = 1;
}
String deal = sd.getDeal();
for(i = 0;i < info.length();i++){
//得到频率范围
double cha = high - low;
double sa = 0;
for(j = 0; j < deal.length(); j++){
//sa表示频率上限分子
sa += zifu[j];
//sb表示频率下限分子
double sb = sa - zifu[j];
if(info.charAt(i) == deal.charAt(j)){
//得到新的上限
high = low + sa/count * cha;
//得到新的下限
low = low + sb/count*cha;
zifu[j]++;
}
} //重置sa为0
sa = 0;
//频率分母
count++; }
shu = (low+high)/2;
System.out.println(shu);
}
2、解码过程
解码是编码的逆过程,对应每个频率范围,若输入位于某各字符的频率范围之内,则将该字符记录,并得到新的上下限。
我的代码:
publicstaticvoid JieMa(StringDeal sd,double shu){
//定义上下限
double low = 0, high = 1;
double count = sd.getCount();
int j = 0, i =0;
String deal = sd.getDeal();
//定义一个初始字符串存储译码结果
String info = "";
//字符初始字符量设置为1
double[] zifu = newdouble[(int)(count)];
for(i = 0;i < zifu.length;i++){
zifu[i] = 1;
}
while((low+high)/2 != shu){
//定义上下限
double cha = high - low;
double sa = 0;
for(j = 0; j < deal.length(); j++){
//sa表示频率上限分子
sa += zifu[j];
//sb表示频率下限分子
double sb = sa - zifu[j];
if(shu < low+sa/count * cha && shu >low+sb/count * cha){
//将译码结果存入字符串
info = info + deal.charAt(j);
//得到新的上限
high = low + sa/count * cha;
//得到新的下限
low = low + sb/count*cha;
zifu[j]++;
}
}
//重置sa
sa = 0;
i++;
}
//输出译码结果
System.out.println(info);
}
实验结果:(运行环境:win10)。
算术编码与解码

算术编码与解码1、编码过程算术编码方法是将被编码的一则消息或符号串(序列)表示成0和1之间的一个间隔(Interval),即对一串符号直接编码成[0,1]区间上的一个浮点小数。
符号序列越长,编码表示它的间隔越小,表示这一间隔所需的位数就越多。
信源中的符号序列仍然要根据某种模式生成概率的大小来减少间隔。
可能出现的符号概率要比不太可能出现的符号减少范围小,因此,只正加较少的比特位。
在传输任何符号串之前,0符号串的完整范围设为[0,1]。
当一个符号被处理时,这一范围就依据分配给这一符号的那一范围变窄。
算术编码的过程,实际上就是依据信源符号的发生概率对码区间分割的过程。
输入:一个字符串输出:一个小数考虑某条信息中可能出现的字符仅有a b c 三种,要压缩保存的信息为bccb。
假设对a b c 三者在信息中的出现概率一无所知(采用自适应模型),暂时认为三者的出现概率相等,也就是都为1/3,将0 - 1 区间按照概率的比例分配给三个字符,即a 从0.0000 到0.3333,b 从0.3333 到0.6667,c 从0.6667 到 1.0000。
用图形表示就是:+-- 1.0000 | Pc = 1/3 | | +-- 0.6667 | Pb = 1/3 | | +-- 0.3333 | Pa = 1/3 | | +-- 0.0000对于第一个字符b,选择b 对应的区间0.3333 - 0.6667。
这时由于多了字符b,三个字符的概率分布变成:Pa = 1/4,Pb = 2/4,Pc = 1/4。
再按照新的概率分布比例划分0.3333 - 0.6667 这一区间,划分的结果可以用图形表示为:+-- 0.6667 Pc = 1/4 | +-- 0.5834 | | Pb = 2/4 | | | +-- 0.4167 Pa = 1/4 | +-- 0.3333接着字符c,上一步中得到的 c 的区间0.5834 - 0.6667。
编码和解码
【这里我说说编码和解码】为什么要编码和解码呢?编码其实就是一种压缩的电脑算术,一段没有压缩过的视频可以很简单的达到1GB 那么大,一部没有压缩过的电影,特别现在的HD视频时代,可以达到20GB-200GB 那么巨大的容量。
所以说,不压缩视频的话,那是不行的。
从以前就有视频压缩这个技术,或者说电脑算数;但是也是这几年的进步比较快。
压缩比例可以到达200:1;也就是说,一部200GB的没有压缩过的视频电影;经过现在先进的压缩技术可以压成1GB,厉害吧。
而这个压缩的过程叫编码。
你压缩了,要看这个压缩后的视频还需要解压才能看;而这个解压的过程就叫解码。
一般的视频播放器都会安装很多解码;那样你就能看各类的不同格式的视频了。
但它不一定也有编码。
没有编码,你就只能看,不能自己压了。
我这里发的编码和解码器是好东西啊,如果是在几年前,这是无价的。
现在免费供给大家使用。
网上我常看到,几分钟的MTV,尽然几百MB那么大。
我下下来了,自己一压,文件几十MB就搞定。
而且画质肯定不比原片差。
几百MB的MTV 可能不算什么,但几GB的电影呢?不管你网络是光钎还是什么,不管你的硬盘有几TB的容量;保存,传播,欣赏视频不用编码和解码是很不智的。
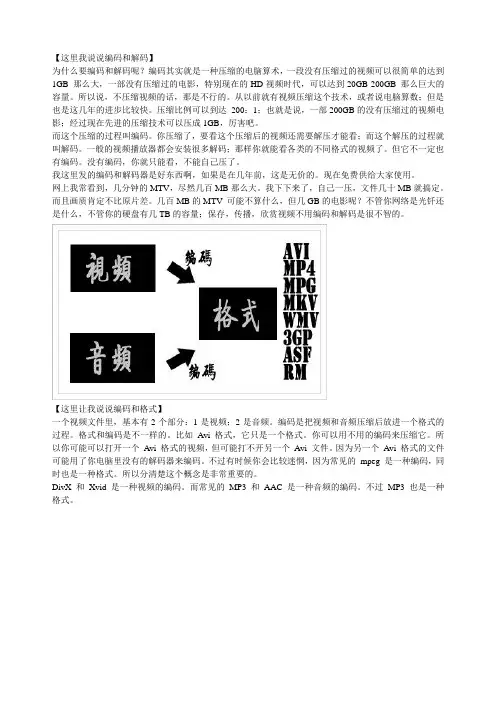
【这里让我说说编码和格式】一个视频文件里,基本有2个部分:1是视频;2是音频。
编码是把视频和音频压缩后放进一个格式的过程。
格式和编码是不一样的。
比如Avi 格式,它只是一个格式。
你可以用不用的编码来压缩它。
所以你可能可以打开一个Avi 格式的视频,但可能打不开另一个Avi 文件。
因为另一个Avi 格式的文件可能用了你电脑里没有的解码器来编码。
不过有时候你会比较迷惘,因为常见的mpeg 是一种编码,同时也是一种格式。
所以分清楚这个概念是非常重要的。
DivX 和Xvid 是一种视频的编码。
而常见的MP3 和AAC 是一种音频的编码。
不过MP3 也是一种格式。
【这里让我说说编码里的bitrate】其实这个比较容易理解。
算术编码
range=high一low=0.7一0.6=0.1 S将区间[0,1) [0.6,0.7) 注意:字符“”表示“分割为”字符。
1 编码过程
•
(3)对第2个字符t编码,使用的新生成范围 为[0.6,0.7),因为t的range low=0.70, range high=1.00,因此下一个low,high分别 为:
1 编码过程
•
将编码后的区间范围综合如图3-9 所示:
我们用0.6753031606代表字符串“state tree”,从而达到高 效编码的目的,这就是算术编码的基本思想。
1 编码过程
• 上述算术编码区间分割过程可用图3-10 表示。
2 解码过程
• 通过编码,最后一个子区间的的下界值 0.6753031606就是字符串“state tree”的惟一 编码。然后在解码时,通过判断哪一个字符能 拥有我们已编码的消息落在的空间来找出消息 中的第一个字符。由于0.6753031606落在[0.6, 0.7]之问,因此马上就可解得第1个符号是S。
•
按对‘state stree”’的算术编码过程为: (1)初始化时,被分割的范围 range=high -low=[0,1) = 1 - 0 = 1,下一个范围 的低、高端分别由下式计算: low=low+range×range low high=low+range×range high 其中等号右边的low为上一个被编码字符的 范围低值;range low和range high分别为本次 被编符号已给定出现的概率范围的low和high。
算术编码
• 用算术编码方法是将被编码的一个消息或一个 符号串(序列)表示成0和1之间的一个间隔, 即对一串符号直接编码成[0,1)区间上的一个 浮点小数,在传输任何符号串(消息)之前, 设符号串的完整范围为[0,1)。当一个符号被 处理时,这一范围就依据分配给这一符号的那 一范围变窄,间隔变小,当符号串序列越长, 则编码表示它的间隔越小,同时表示这一间隔 所需的位数就越多,直到完成对所有符号串的 编码。算术编码的过程,实际上就是依据信息 源符号串的发生概率对码区间分割的过程。
编码与解码的区别

编码与解码的区别有的人会以为编码和解码是程序员的事,其实,我们生活中自己也会编码,现在的信息网络都是数字的,很多东西要保存传输就得编码,比如你要保存一篇文章,里面的字就是一些二进制编码。
编码和解码其实就是两个相反的过程。
下面店铺告诉你这两者的区别。
1.编码和解码的区别编码就是如何把信息转换成数字序列,解码则是把数字序列转换成信息。
编码是正过程,解码是逆过程。
编码/解码本质上是一种映射(对应关系),比如‘a’用ascii编码则是65,计算机中存储的就是00110101,但是显示的时候不能显示00110101,还是要显示'a',但计算机怎么知道00110101是'a'呢,这就需要解码,当选择用ascii解码时,当计算机读到00110101时就到对应的ascii表里一查发现是'a',就显示为'a'。
编码就是真实字符与二进制串的对应关系,真实字符转换成二进制串。
解码就是二进制串与真实字符的对应关系,二进制串转换成真实字符。
2.编码的含义编码是信息从一种形式或格式转换为另一种形式的过程也称为计算机编程语言的代码简称编码。
用预先规定的方法将文字、数字或其它对象编成数码,或将信息、数据转换成规定的电脉冲信号。
编码在电子计算机、电视、遥控和通讯等方面广泛使用。
编码是信息从一种形式或格式转换为另一种形式的过程。
解码,是编码的逆过程。
3.解码的含义将信息从已经编码的形式恢复到编码前原状的过程。
也就是用特定方法把数码还原成它所代表的内容或将电脉冲信号、光信号、无线电波等转换成它所代表的信息、数据等的过程。
解码在无线电技术和通讯等方面广泛应用。
4.霍尔的编码/解码模式加拿大传播学者麦克卢汉(McLuhan)从"技术决定论"出发,预言性地提出了"地球村"、"媒介即信息"、"媒介是人的延伸"、"热媒介和冷媒介"等著名概念,开创了电子传播时代的媒介文化研究。
c++ 算术编码译码

算术编码是一种用于无损数据压缩的熵编码方法。
与更常见的基于符号频率的方法不同,算术编码是基于输入数据流的概率分布。
以下是C++中算术编码和解码的基本实现:```cpp#include <iostream>#include <cmath>using namespace std;// 输入概率分布double P[4] = {0.25, 0.35, 0.15, 0.25};// 编码函数double encode(int symbol) {double low = 0.0, high = 1.0;double range = high - low;for (int i = 0; i < symbol; i++) {low = high;high *= P[i];range *= P[i];}return low + (rand() / (double)RAND_MAX) * range;}// 解码函数int decode(double probability) {int s = 0;while (probability > P[s]) {probability -= P[s];s++;}return s;}int main() {srand(time(NULL)); // 初始化随机数生成器int data[] = {1, 2, 3, 0, 2, 1, 0, 1, 3, 2}; // 输入数据流for (int i = 0; i < 10; i++) {double encoded = encode(data[i]); // 编码数据流 cout << "Encoded value for symbol " << data[i] << " is " << encoded << endl; // 输出编码值}double encoded_data = encode(3); // 编码一个随机符号(这里假设是3)cout << "Encoded value for symbol 3 is " << encoded_data << endl; // 输出编码值int decoded_data = decode(encoded_data); // 解码数据流cout << "Decoded value is " << decoded_data << endl; // 输出解码值return 0;}```这个程序首先定义了一个概率分布数组,然后定义了两个函数:一个用于编码,另一个用于解码。
算数编码介绍

算术编码,是图像压缩的主要算法之一。
是一种无损数据压缩方法,也是一种熵编码的方法。
和其它熵编码方法不同的地方在于,其他的熵编码方法通常是把输入的消息分割为符号,然后对每个符号进行编码,而算术编码是直接把整个输入的消息编码为一个数,一个满足(0.0 ≤ n < 1.0)的小数n。
二、算数编码历史早在1948年,香农就提出将信源符号依其出现的概率降序排序,用符号序列累计概率的二进值作为对芯源的编码,并从理论上论证了它的优越性。
1960年, Peter Elias发现无需排序,只要编、解码端使用相同的符号顺序即可,提出了算术编码的概念。
Elias没有公布他的发现,因为他知道算术编码在数学上虽然成立,但不可能在实际中实现。
1976年,R. Pasco和J. Rissanen分别用定长的寄存器实现了有限精度的算术编码。
1979年Rissanen和G. G. Langdon 一起将算术编码系统化,并于1981年实现了二进制编码。
1987年Witten等人发表了一个实用的算术编码程序,即CACM87(后用于ITU-T的H.263视频压缩标准)。
同期,IBM公司发表了著名的Q-编码器(后用于JPEG和JBIG图像压缩标准)。
从此,算术编码迅速得到了广泛的注意。
算术编码的基本原理是将编码的消息表示成实数0和1之间的一个间隔(Interval),消息越长,编码表示它的间隔就越小,表示这一间隔所需的二进制位就越多。
算术编码用到两个基本的参数:符号的概率和它的编码间隔。
信源符号的概率决定压缩编码的效率,也决定编码过程中信源符号的间隔,而这些间隔包含在0到1之间。
编码过程中的间隔决定了符号压缩后的输出。
给定事件序列的算术编码步骤如下:(1)编码器在开始时将“当前间隔” [ L, H) 设置为[0,1)。
(2)对每一事件,编码器按步骤(a)和(b)进行处理(a)编码器将“当前间隔”分为子间隔,每一个事件一个。
(b)一个子间隔的大小与下一个将出现的事件的概率成比例,编码器选择子间隔对应于下一个确切发生的事件相对应,并使它成为新的“当前间隔”。
遗传算法的编码与解码
遗传算法的编码与解码
遗传算法的编码和解码是指如何将问题的解表示为遗传算法中的个体(或染色体)以及如何将这些个体解码为实际的解。
遗传算法的编码方式可以分为两种:二进制编码和实数编码。
二进制编码是指以二进制串的形式表示问题的解。
例如,对于一个二进制串0101,可以将其解释为一个长度为4的向量(0,1,0,1),表示问题的一个解。
在遗传算法中,二进制编码是最常用的一种编码方式,因为它简单易行,同时也可以很好地避免了其他编码方式中出现的精度问题。
实数编码是指以实数的形式表示问题的解。
例如,对于一个实数编码为(1.5, -0.2, 3.7),可以将其解释为一个三维向量,表示问题的一个解。
实数编码适用于连续型优化问题,但对于离散问题(如旅行商问题)则不适用。
解码是将个体(或染色体)映射为可行解的过程。
对于二进制编码,解码过程简单,只需要将二进制串转化为对应的十进制数,并进行适当的缩放以得到最终的解。
对于实数编码,解码过程更为复杂,需要进行反向变换并进行适当的限制以确保得到的解在问题的可行解空间内。
算术编码
为[0.0624,0.0688)
输入第五个符号a4后,对序列a1a2a3a3 a4进行编码,编码区
间为[0.06752,0.0688)
在区间[0.06752,0.0688)内的任何数字都可以表示消息
a1a2a3a3a4,例0.06752
7
无失真编码
算术编码—编码过程
步骤 1 2 3 4 5 6 输入 a1 a2 a3 a3 a4 编码间隔 [0,0.2) [0.04,0.08) [0.056,0.072) [0.0624,0.0688) [0.06752,0.0688)
输入第二个符号a2后,编码区间由[0,0.2)变为[0.04,0.08),当前区间 长度length=0.08-0.04=0.04
6
无失真编码
算术编码—编码过程
输入第三个符号a3后,对序列a1a2 a3进行编码,编码区间
为[0.056,0.072)
输入第四个符号a3后,对序列a1a2a3a3进行编码,编码区间
4
无失真编码
5
无失真编码
算术编码—编码过程
根据每个符号出现的概率将半开区间[0,1)分成四个区域
[0,0.2) [0.2,0.4) [0.4,0.8) [0.8,1)
对输入的第一个符号a1编码
symbol_high(a1)=0.2
symbol_low(a1)=0
high=0+1.0×0.2=0.2
无失真编码
算术编码
算术编码并不是将单个信源符号映射成一个码字,
而是把整个信源表示为实数线上0到1之间的一个 区间,其长度等于该序列的概率。 制作为实际的编码输出
在该区间内选择一个代表性的小数,转换为二进 消息序列中的每个元素都要用来压缩这个区间 消息序列中元素越多,所得到的区间就越小,当
第四章:算术编码
FX i
i PX k
k 1
i P
k 1
ai
产生标识
❖ 将[0, 1)分为m个区间:
FX i 1, FX i,i 1..m, FX 0 0
定义一一映射:
ak [FX(k-1), FX(k)], k = 1..m, FX(0) = 0
[FX(k-1), FX(k)]区间内的任何数字表示 ak
l
x
log
1 P(x)
1
注意:P(x)为最后区间的宽度,也是该符号串的概率
符合概率匹配原则:出现概率较大的符号取较短的码字,而对出 现概率较小的符号取较长的码字
➢ Initialize l(0) = 0, u(0) = 1.
1. Compute t*=(tag-l(k-1))/(u(k-1)-l(k-1)).
2. Find the xk: FX(xk-1) t* FX(xk). 3. Update u(k), l(k) 4. If done--exit, otherwise goto 1.
1321
算术编码的唯一性和效率
上述产生的标识可以唯一表示一个序列,这意味着该标识 的二进制表示为序列的唯一二进制编码
但二进制表示的精度可以是无限长:保证唯一性但不够有 效
为了保证有效性,可以截断二进制表示,但如何保证唯一 性?
答案:为了保证唯一性和有效性,需取小数点后l位数字 作为信源序列的码字,其中
31
FX
(2)
FX
(3)
FX
(2)FX
(1)
l(2) l(1) u(1) l(1) FX (1)
u(3)
F (3) X
322
,
l ( 3)
算术编码的解码过程
算术编码的解码过程
算术编码的解码过程大致如下:
1. 建立码表:首先需要与编码过程中相同的方式创建码表,包括每个字符及其对应的概率。
2. 确定要解码的码值:接着,需要使用已经编码的数字(通常是二进制或十进制数)来确定要解码的码值。
这个码值通常表示一个小数,其值在0到1之间。
3. 寻找码表对应字符:接下来,开始从码表中查找与码值对应的字符。
为了这样做,需要将码值区间与码表中表示每个字符的区间进行比较,并找到第一个区间包含了码值的字符。
4. 确定解码字符并更新码值:一旦找到了对应的字符,就可以将其输出,并用它的相对区间来更新码值。
这个过程可以重复,直到完整的编码字符串全部解码。