
哈工大编译原理模拟试题
编译原理模拟试题
一、是非题(下列各题,你认为正确地,请在题干地括号内打“ √”,错地打“×”)
1、算符优先关系表不一定存在对应地优先函数.()
2、数组元素地地址计算与数组地存储方式有关.()
3、仅考虑一个基本块,不能确定一个赋值是否真是无用地.()
4、每个文法都能改写为LL(1)文法.()
5、对于数据空间地存贮分配,FORTRAN采用动态贮存分配策略.()
二、填空题
1、从功能上说,程序语言地语句大体可分为()语句和()语句两大类.
2、扫描器地任务是从()中识别出一个个().
3、所谓最右推导是指:().
4、语法分析最常用地两类方法是()和()分析法.
5、一个上下文无关文法所含四个组成部分是().
6、所谓语法制导翻译方法是().
7、符号表中地信息栏中登记了每个名字地有关地性质,如()等等.
8、一个过程相应地DISPLAY表地内容为().
9、常用地两种动态存贮分配办法是()动态分配和()动态分配.
10、产生式是用于定义()地一种书写规则.
三、名词解释
1、遍
2、无环路有向图(DAG)
3、语法分析
4、短语
5、后缀式
四、简述题
1、考虑下面程序
…………
Var a:integer;
Procedure S(X);
Var X:integer;
Begin
a:=a+1;
X:=a+X
End;
Begin
a:=5;
S(a);
Print(a)
End.
试问:若参数传递方式分别采取传名和传值时,程序执行后输出a地值是什么?
2、画出C++中实数(不带正负号,可带指数部分)地状态转换图.
3、写出表达式(a+b*c)/(a+b)-d地逆波兰表示及三元式序列.
4、已知文法G(S)
S→a|∧|(T)
T→T,S|S
写出句子((a,a),a)地规范归约过程及每一步地句柄.
5、何谓优化?按所涉及地程序范围可分为哪几级优化?
6、目标代码有哪几种形式?生成目标代码时通常应考虑哪几个问题?
五、计算题
1、写一个文法,使其语言是奇数集,且每个奇数不以0开头.
2、设文法G(S):
S→(L)|a S|a
L→L,S|S
(1)消除左递归和回溯;
(2)计算每个非终结符地FIRST和FOLLOW;
(3)构造预测分析表.
3、While a>0 ∨ b<0 do
Begin
X:=X+1;
if a>0 then a:=a-1
else b:=b+1
End;
翻译成四元式序列.
4、已知文法G(E)
E→T|E+T
T→F|T * F
F→(E)|I
(1)给出句型(T * F+i)地最右推导及画出语法树;(2)给出句型(T * F+i)地短语、素短语.
5、设布尔表达式地文法为
E → E(1)∨E(2)
E → E(1)∧ E(2)
E → I
假定它们将用于条件控制语句中,请
(1)改写文法,使之适合进行语法制导翻译和实现回填;(2)写出改写后地短个产生式地语义动作.
6、设有基本块
T1:=2
T2:=10/T
T3:=S-R
T4:=S+R
A:=T2 * T4
B:A
T5:=S+R
T6:=T3 * T5
B:=T6
(1)画出DAG图;
(2)假设基本块出口时只有A,B还被引用,请写出优化后地四元序列. 参考答案:
一.是非题
1.√2.√3.√4.×5.×
二.填空题
1.执行性、说明性;
2.源程序、单词符号;
3.任何一步αβ都是对α中最右非终结符进行替换地;
4.自上而下、自下而上;
5.一组终结符号,一组非终结符号、一个开始符号、一组产生式;
6.为每个产生式配上一个翻译子程序,并在语法分析地同时执行这些子程序;
7.类型、种属、所占单元大小、地址;
8.现行活动记录地址和所有外层最新活动记录地地址;
9.栈式、堆式;
10.语法范畴.
三.名词解释
1.遍--指编译程序对源程序或中间代码程序从头到尾扫描一次.
2.无环路有向图(DAG)--如果有向图中任一通路都不是环路, 则称庐有向图为无环路有向图,简称DAG.
3.语法分析--按文法地产生式识别输入地符号串是否为一个句子地分析过程.
4.短语--令G是一个文法.S划文法地开始符号,假定αβδ是文法G地一个句型,如果有SαAδ且AB,则称β是句型
αβ相对非终结符A地短语.
5.后缀式--一种把运算量写在前面,把算符写在后面地表示表达式地方法.
四、
1、答:传名:a=12
传值:a=6
2、答:
略
3、逆波兰表示:
abc*+ab+/d-
三元式序列:
① (*,b,c)
② (+,a,①)
③ (+,a,b)
④ (/,②,③)
⑤ (-,④,d)
4、答:句型归约规则句柄
((a,a),a) S→a a
((S,a),a) T→S S
((T,a),a) S→a a
((T,S),a) T→T,S T,S
((S),a) T→S S
((T),a) S→S(T)(T)
(S,a) T→S S
(T,a) S→a a
(T,S) T→T,S T,S
(T) S→(T)(T)
S
5、答:优化:对程序进行各种等价变换,使得从变换后地程序出
发,能产生更有效地目标代码.
三种级别:局部优化、循环优化、全局优化.
6、答:目标代码通常采用三种形式:机器语言,汇编语言,待装配
机器语言模块.
应着重考虑地问题:
(1)如何使生成地目标代码较短;
(2)如何充分利用寄存器,以减少访问内存次数;
(3)如何充分利用指仅系统地地特点.
五、计算题:
1、解:文法G(N):
N→AB|B
A→AC|D
B→1|3|5|7|9
D→B|2|4|6|8
C→0|D
2、解: (1)
S→(L)|aS’
S’→S|ε
L→SL’
L’→SL’|ε
(2)
FIRST)S)={(,a} FOLLOW(S)={#,,,)}
FIRST(S’)={,a,ε} FOLLOW(S’)={#,,,)}
FIRST(L)={(,a} FOLLOW(L)={ )}
FIRST(L’)={,,ε} FOLLOW(L’〕={ )}
(3)
3、解:
(1) (j>,a,0,5)
(2) (j,-,-,3)
(3) (j<,b,0,5)
(4) (j,-,-,15)
(5) (+,×,1,T1)
(6) (:=,T1,-,×)
(7) (j≥,a,0,9)
(8) (j,-,-,12)
(9) (-,a,1,T2)
(10) (:=,T2,-,a)
(11) (j,-,-,1)
(12) (+,b,1, T3)
(13) (:=,T3,-,b)
(14) (j,-,-,1)
(15)
4、解:(1) 最右推导:
E T F(E)(E+T)(E+F)(E+i)
(T+i)(T*F+i)
语法树:
略
(2) 短语:(T*F+i),T*F+i,T*F,i
素短语:T*F,i
5、解:(1) E0→E(1)
E→E0E(2)
E A→E(1)
E→EAE(2)
E→i
(2) E→E(1)
{BACKPATCH(E(1)·FC,NXQ);
E0·TC:=E(1)·TC}
E→E0E(2)
{E·FC:=E(2)·FC;
E·TC:=MERG(E0·TC,E(2)·TC)}
E A→E(1)
{BACKPATCH(E(1)·TC,NXQ);
E0·FC:=E(1)·FC}
E→EAE(2)
{E·TC:=E(2)·TC;
E·FC:=MERG(E A·FC,E(2)·FC}
E→i
{E·TC:=NXQ;E·FC:=NXQ+1;
GEN(jn2,entry(i),-0);
GEN(j,-,-,0)
6、解:(1)DAG:
略
(2) 优化后地四元式
T3:=S-R
T4:=S+R
A:=5*T4
B:=T3+T4。
编译-模拟试卷一

编译原理模拟试卷一一.填空题(每空1分,共20分)1.若一个翻译程序的源程序是用语言编写的,其目标程序是语言或者语言的程序,则称该翻译程序为编译程序。
2.右线性文法的产生式规则限制为。
3.设有文法G: S→AA→B | if A then A else AB→C | B+C | +CC→D | C*D | *DD→x |(A)| -D其中,终结符集V T= ,非终结符集V N= 。
4.词法分析的任务是:依据语言的,分析由字符组成的,把它识别为一个一个具有独立意义的最小语法单位,即“”,并识别出与其相关的属性。
5.词法分析程序在识别标识符时,先识别是否为标识符,然后还要判别标识符是否为。
6.符号表在编译期间两项重要的作用分别是辅助与辅助代码生成。
7.表达式a*b+c*d的逆波兰式为。
8.为了消除左递归,文法A→Ax|y 可变换为。
9.文法G产生的的全体是该文法描述的语言。
10.自下而上语法分析的基本思想是:从左向右扫描输入串,一边,一边检查栈顶是否形成某个产生式的右部――若是,则用相应产生式的左部取代栈顶的那串符号(称为);若不是,则继续重复上述动作,直至栈顶形成文法的时为止。
11.常用的动态存储分配方法有存储分配与存储分配。
12.优化根据所涉及程序的范围,可分为局部优化、和全局优化三种。
二.判断题(正确的在括号中记√,错误的记×,并且说明理由。
每小题2分,共20分)()1.编译程序与解释程序的区别在于编译程序对源程序进行了翻译,而解释程序则没有。
()2.每个句子都有规范推导;每个句型都有规范推导。
()3.若一个语言的句子有无穷多个,则其对应的文法必定是递归的。
()4.一个语言的文法是唯一的。
()5.对于文法G【A】:A →aABe | BaB →dB | ε有人说:因为 FIRST(aABe)∩ FOLLOW(A)=∅FIRST(Ba)∩ FOLLOW(A)≠∅所以,文法G【A】不是LL(l)文法。
编译原理模拟题
编译原理一、单选题1、( B )是两类程序语言处理程序.A.高级语言程序和低级语言程序B.解释程序和编译程序C.编译程序和操作系统D.系统程序和应用程序2.解释程序处理语言时,大多数采用的是( A )方法.A.源程序命令被逐个直接解释执行B.先将源程序转化为中间代码,再解释执行C.先将源程序解释转化为目标程序,再执行D.以上方法都可以3.( A )是一种典型的解释型语言.A.BASICB.CC.FORTRAND.PASCAL4.与编译系统相比,解释系统( D ).A.比较简单,可移植性好,执行速度快B.比较复杂,可移植性好,执行速度快C.比较简单,可移植性差,执行速度慢D.比较简单,可移植性好,执行速度慢5.编译程序是一种( B ).A.汇编程序B.翻译程序C.解释程序D.目标程序6.编译程序是对( D ).A.汇编程序的翻译B.高级语言程序的解释执行C.机器语言的执行D.高级语言的翻译7.用高级语言编写的程序经编译后产生的程序叫( B ).A.源程序B.目标程序C.连接程序D.解释程序8.将编译程序分成若干个“遍”是为了( B ).A.提高程序的执行效率B.使程序的结构更加清晰C.利用有限的机器内存并提高机器的执行效率D.利用有限的机器内存但降低了机器的执行效率9.构造编译程序应掌握( D ).A.源程序B.目标语言C.编译方法D.以上三项都是10.通常一个编译程序中,不仅包含词法分析,语法分析,中间代码生成,代码优化,目标代码生成等五个部分,还应包括( C ).A.模拟执行器B.解释器C.表格处理和出错处理D.符号执行器11.编译程序绝大多数时间花在( D )上.A.出错处理B.词法分析C.目标代码生成D.管理表格12.程序的基本块是指( D ).A.一个子程序B.一个仅有一个入口和一个出口的语句C.一个没有嵌套的程序段D.一组顺序执行的程序段,仅有一个入口和一个出口13.变量应当( C ).A.持有左值B.持有右值C.既持有左值又持有右值D.既不持有左值也不持有右值14.数组的内情向量中肯定不含有数组的( A )的信息.A.维数B.类型C.维上下界D.各维的界差15.一个上下文无关文法G包括四个组成部分:一组终结符,一组非终结符,一个开始符号,以及一组( B ).A.字符串B.产生式C.非开始符号D.文法16.一个文法所描述的语言是( A ).A.唯一的B.不唯一的C.可能唯一,也可能不唯一D.都不对17.文法G产生的( D )的全体是该文法描述的语言.A.句型B.终结符集C.非终结符集D.句子18.若文法G定义的语言是无限集,则文法必然是( A ).A.递归的B.前后文无关的C.二义性的D.无二义性的19.文法分为四种类型,即0型,1型,2型,3型.其中2型文法是( C ).A.短语文法B.正则文法C.上下文有关文法D.上下文无关文法20.四种形式语言文法中,1型文法又称为( D )文法.A.短语文法B.正则文法C.上下文有关文法D.上下文无关文法21.正规式M1和M2等价是指( C ).A.M1和M2的状态数相等B.Ml和M2的有向弧条数相等C.M1和M2所识别的语言集相等D.Ml和M2状态数和有向弧条数相等22.词法分析器的输出结果是( C ).A.单词的种别编码B.单词在符号表中的位置C.单词的种别编码和自身值D.单词自身值23.词法分析器用于识别( C ).A.字符串B.语句C.单词D.标识符24.扫描器所完成的任务是从字符串形式的源程序中识别出一个个具有独立含义的最小语法单位即( B ).A.字符B.单词C.句子D.句型25.一个句型中称为句柄的是该句型的最左( D ).A.非终结符号B.短语C.句子D.直接短语26.下推自动机识别的语言是( C ).A.0型语言B.1型语言C.2型语言D.3型语言27.如果文法G是无二义的,则它的任何句子α( A ).A.最左推导和最右推导对应的语法树必定相同B.最左推导和最右推导对应的语法树可能不同C.最左推导和最右推导必定相同D.可能存在两个不同的最左推导,但它们对应的语法树相同28.采用自上而下分析,必须( C ).A.消除左递归B.消除右递归C.消除回溯D.提取公共左因子29.在规范归约中,用( B )来刻画可归约串.A.直接短语B.句柄C.最左素短语D.素短语30.若a为终结符,则A->α·aβ为( B )项目.A.归约B.移进C.接受D.待约31.高级语言编译程序常用的语法分析方法中,递归下降分析法属于( B )分析方法.A.自左向右B.自顶向下C.自底向上D.自右向左32.在通常的语法分析方法中,( A )特别适用于表达式的分析.A.算符优先分析法B.LR分析法C.递归下降分析法D.LL(1)分析法33.语法分析器则可以发现源程序中的( D ).A.语义错误B.语法和语义错误C.错误并校正D.语法错误34.后缀式ab+cd+/可用表达式( B )来表示.A.a+b/c+dB.(a+b)/(c+d)C.a+b/(c+d)D.a+b+c/d35.中间代码生成时所依据的是( C ).A.语法规则B.词法规则C.语义规则D.等价变换规则36.( B )和代码优化部分不是每个编译程序都必需的.A.语法分析B.中间代码生成C.词法分析D.目标代码生成37.常用的中间代码形式不含( D ).A.三元式B.四元式C.逆波兰式D.语法树38.代码优化的目的是( C ).A.节省时间B.节省空间C.节省时间和空间把编译程序进行等价交换39.优化可生成( D )的目标代码.A.运行时间较短B.占用存储空间较小C.运行时间短但占用内存空间大D.运行时间短且占用存储空间小40.下列( C )优化方法不是针对循环优化进行的.A.强度削弱B.删除归纳变量C.删除多余运算D.代码外提41.基本块内的优化为( B ).A.代码外提,删除归纳变量B.删除多余运算,删除无用赋值C.强度削弱,代码外提D.循环展开,循环合并42.代码生成阶段的主要任务是( C ).A.把高级语言翻译成汇编语言B.把高级语言翻译成机器语言C.把中间代码变换成依赖具体机器的目标代码D.把汇编语言翻译成机器语言43.在目标代码生成阶段,符号表用于( D ).A.目标代码生成B.语义检查C.语法检查D.地址分配44.程序所需的数据空间在程序运行前就可确定,称为( C )管理技术.A.动态存储B.栈式存储C.静态存储D.堆式存储45.堆式动态分配申请和释放存储空间遵守( D )原则.A.先请先放B.先请后放C.后请先放D.任意46.编译程序使用( B )区别标识符的作用域.A.说明标识符的过程或函数名B.说明标识符的过程或函数的静态层次C.说明标识符的过程或函数的动态层次D.标识符的行号47.生成能被5整除的正整数的文法G[Z]是( C ).A.G(Z):Z→AC,A→BA|B,B→0|1|2|…|9,C→0|5B.G(Z):Z→AC,A→BA|ε,B→0|1|2|…|9,C→0|5C.G(Z):Z→AC|5,A→BA|B,B→0|1|2|…|9,C→0|5D.G(Z):Z→AC|C,A→BA|B,B→0|1|2|…|9,C→0|548.符号串ab1b2是给定文法G[A]:A→aB,B→bB|b的句子,该句子的句柄是( B ).A.b1B.b2C.cD..b1b249.一般程序设计语言的定义都涉及( B )三个方面.①语法②语义③语用④程序基本符号的确定A.①,②和③B.①,②和④C.①,③和④D.②,③和④50.下述语句类中,( C )在编译阶段通常不产生可执行代码.A.赋值语句B.流程控制语句C.说明语句D.输入输出语句51.算符文法是指( A )的文法.①没有形如U→...VW...的规则(U,V,W VN)②VT中任意两个符号之间至多存在一种算符优先关系③没有相同右部的规则④没有形如U→ε的规则A.①B.①和②C.①,②和③D.①,②,③和④52.已知文法G[E]:E→ABC,A→1|2|3|4|5|6|7|8|9,B→BA|B0|ε,C→0|2|4|6|8,对符号串128,它的最左推导是( C ).A.EÞABCÞAB8ÞABA8ÞAB28ÞA28Þ128B.EÞABCÞABACÞAACÞ1ACÞ12CÞ128C.EÞABCÞ1BCÞ1BACÞ1ACÞ12CÞ128D.EÞABCÞ1BCÞ1BACÞ1ACÞ1A8Þ12853.程序的基本块是指( D ).A.不含无条件转移语句的程序段B.不含条件转移语句的程序段C.不含停机的语句程序段D.仅含有一个入口语句和一个出口语句的顺序程序段54.在编译程序采用的优化方法中,( D )是在循环语句范围内进行的.①合并已知常量②删除多余运算③删除归纳变量④强度削弱⑤代码外提A.①④B.①⑤C.①④⑤D.③④⑤55.设有文法G[I]:I→I1|I0|Ia|Ic|a|b|c,下列符号串中是该文法的句子的有( B ).①ab0 ②a0c01 ③aaa ④bc10A.①B.②③④C.③④D.①②③④56.LR(0)分析法中,语法分析栈中存放的状态是识别规范句型( B )的DFA状态.A.前缀B.活前缀C.LR(0)项目D.句柄57.常用( D )来识别一个正规集A.无穷自动机B.图灵机C.下推自动机D.有穷自动机58.文法所描述的语言是( D )的集合.A.文法的字汇表V中符号组成的符号串B.文法的字汇表V中终结符号组成的符号串C.由文法开始符推导的符号串D.由文法开始符推导的终结符号串59.LL(1)文法中第一个L表示( C ).A.最左推导B.最左归约C.从左到右识别输入串D.规范归约60.编译程序前三个阶段完成的工作是( C )A.词法分析,语法分析和代码优化代码生成,代码优化和词法分析B.词法分析,语法分析,语义分析和中间代码生成C.词法分析,语法分析和代码优化二.判断题1.逆波兰表示法表示表达式时无须使用括号.( ✔)2.静态数组的存储空间可以在编译时确定.(✘)3.进行代码优化时应着重考虑循环的代码优化,这对提高目标代码的效率将起更大作用.(✘)4.树形表示和四元式不便于优化,而三元式和间接三元式则便于优化.(✘)5.计算机高级语言翻译成低级语言只有解释一种方式.(✘)6.用高级语言书写的源程序都必须通过编译,产生目标代码后才能投入运行.(✘)7.在编译中进行语法检查的目的是为了发现程序中所有错误.(✘)8.甲机上的某编译程序在乙机上能直接使用的必要条件是甲机和乙机的操作系统功能完全相同.(✔)9.编译程序与具体的机器有关,与具体的语言无关.(✘)10.编译程序是对高级语言程序的解释执行.(✘)11.程序语言的语言处理程序是一种应用软件.(✘)12.在程序中标识符的出现仅为使用性的.(✘)13.仅考虑一个基本块,不能确定一个赋值是否真是无用的.(✔)14.符号表中的信息栏中登记了每个名字的属性和特征等有关信息,如类型,种属,所占单元大小,地址等等.(✘)15.一张转换图只包含有限个状态,其中有一个被认为是初态,最多只有一个终态.(✔)16.一个有限状态自动机中,有且仅有一个唯一的终态.(✘)17.产生式是用于定义词法成分的一种书写规则.(✘)18.若一个句型中出现了某产生式的右部,则此右部一定是该句型的句柄.(✘)19.一个句型的句柄一定是文法某产生式的右部.(✔)20.词法分析作为单独的一遍来处理较好.(✘)21.正则文法其产生式为A->a,A->Bb,A,B∈VN,a,b∈VT.(✘)22.正规文法产生的语言都可以用上下文无关文法来描述.(✘)23.设r和s分别是正规式,则有L(r|s)=L(r)L(s).(✘)24.确定的自动机以及不确定的自动机都能正确地识别正规集.(✔)25.每个文法都能改写为LL(1)文法.(✔)26.一个LL(l)文法一定是无二义的.(✘)27.如果一个文法存在某个句子对应两棵不同的语法树,则称这个文法是二义的.(✔)28.语法分析时必须先消除文法中的左递归.(✘)29.综合属性是用于“自上而下”传递信息.(✘)30.规范归约和规范推导是互逆的两个过程.(✘)31.递归下降法允许任一非终极符是直接左递归的.(✔)32.递归下降分析法是自顶向上分析方法.(✔)33.算符优先关系表不一定存在对应的优先函数.(✘)34.一个算符优先文法可能不存在算符优先函数与之对应.(✔)35.自底而上语法分析方法的主要问题是候选式的选择.(✘)36.LR法是自顶向下语法分析方法.(✘)37.LR分析法在自左至右扫描输入串时就能发现错误,但不能准确地指出出错地点.(✔)38.构造LR分析器的任务就是产生LR分析表.(✔)39.LR分析技术无法适用二义文法.(✘)40.简单优先文法允许任意两个产生式具有相同右部.(✘)41.程序中的表达式语句在语义翻译时不需要回填技术.(✔)42.削减运算强度破坏了临时变量在一基本块内仅被定义一次的特性.(✔)43.在中间代码优化中循环上的优化主要有不变表达式外提和削减运算强度.(✘)44.对中间代码的优化依赖于具体的计算机.(✘)45.数组元素的地址计算与数组的存储方式有关.(✘)46.目标代码生成时,应考虑如何充分利用计算机的寄存器的问题.(✘)47.逆波兰法表示的表达式亦称前缀式.(✔)三.填空题1.编译方式与解释方式的根本区别在于是否生成目标代码 .2.若源程序是用高级语言编写的,目标程序是机器语言程序或汇编程序,则其翻译程序称为编译程序 .3.对编译程序而言,输入数据是源程序,输出结果是目标程序.4.编译程序的工作过程一般划分为5个阶段:词法分析, 语法分析,语义分析与中间代码生成,代码优化及目标代码生成.5.一个名字的属性包括类型和作用域.6.设G是一个给定的文法,S是文法的开始符号,如果S->x(其中x∈VT*),则称x是文法的一个句子 .7.扫描器的任务是从源程序中识别出一个个单词符号 .8.规范规约是最左规约.9.词法分析基于正则文法进行,即识别的单词是该类文法的句子.10.文法符号的属性有综合属性和继承属性 .11.语法分析器的输入是单词符号串,其输出是语法单位.12.语法分析的有效工具是语法树 .13.语法分析最常用的两类方法是自上而下和自下而上分析法.14.分析句型时,应用算符优先分析技术时,每步被直接归约的是最左素短语 .15.应用LR分析技术时,每步被直接归约的是句柄 .16.自顶向下的语法分析方法的基本思想是:从文法的开始符号开始,根据给定的输入串并按照文法的产生式一步一步的向下进行直接推导,试图推导出文法的句子,使之与给定的输入串匹配.17.自底向上的语法分析方法的基本思想是:从输入串入手,利用文法的产生式一步一步地向上进行直接归约,力求归约到文法的开始符号.18.自上而下分析法采用移进,归约,错误处理,接受等四种操作.19.一个LR分析器包括两部分:一个总控程序和一张分析表 .20.递归下降法不允许任一非终极符是直接左递归的.21.对于文法的每个产生式都配备了一组属性的计算规则,称为语义规则 .22.如果一个文法存在某个句子对应两棵不同的语法树,则称这个文法是二义性文法 .23.预测分析程序是使用一张分析表和一个符号栈进行联合控制的.四.问答题1.简述编译程序各组成部分的主要功能.[答案]:词法分析器:输入源程序,进行词法分析,输出单词符号.语法分析器:在词法分析的基础上,根据语言的语法规则(文法规则)把单词符号串分解成各类语法单位,并判断输入串是否构成语法上正确的“程序”.中间代码生成器:按照语义规则把语法分析器归约(或推导)出的语法单位翻译成一定形式的中间代码,比如说四元式.优化:对中间代码进行优化处理.目标代码生成器:把中间代码翻译成目标语言程序.表格管理模块保存一系列的表格,登记源程序的各类信息和编译各阶段的进展情况.编译程序各阶段所产生的中间结果都记录在表格中,所需信息多数都需从表格中获取,整个编译过程都在不断地和表格打交道.出错处理程序对出现在源程序中的错误进行处理.此外,编译的各阶段都可能出现错误,出错处理程序对发现的错误都及时进行处理.2.文法G[S]为:S->Ac|aBA->abB->bc写出L(G[S])的全部元素.[答案]:S=>Ac=>abcS=>aB=>abc所以L(G[S])={abc}3.什么是句子?什么是语言?[答案]:设G是一个给定的文法,S是文法的开始符号,如果Sx(其中x∈VT*),则称x是文法的一个句子.设G[S]是给定文法,则由文法G所定义的语言L(G)可描述为:L(G)={x│Sx,x∈VT*}.4.一字母表∑={a,b},试写出∑;上所有以a为首的字组成的正规集相对应的正规式.[答案]:正规式a(a|b)*。
《编译原理》考试试题及答案

《编译原理》考试试题及答案(附录)一、判断题:1.一个上下文无关文法的开始符,可以是终结符或非终结符。
( X )2.一个句型的直接短语是唯一的。
( X )3.已经证明文法的二义性是可判定的。
( X )4.每个基本块可用一个DAG表示。
(√)5.每个过程的活动记录的体积在编译时可静态确定。
(√)6.2型文法一定是3型文法。
( x )7.一个句型一定句子。
( X )8.算符优先分析法每次都是对句柄进行归约。
(应是最左素短语) ( X )9.采用三元式实现三地址代码时,不利于对中间代码进行优化。
(√)10.编译过程中,语法分析器的任务是分析单词是怎样构成的。
( x )11.一个优先表一定存在相应的优先函数。
( x )12.目标代码生成时,应考虑如何充分利用计算机的寄存器的问题。
( )13.递归下降分析法是一种自下而上分析法。
( )14.并不是每个文法都能改写成LL(1)文法。
( )15.每个基本块只有一个入口和一个出口。
( )16.一个LL(1)文法一定是无二义的。
( )17.逆波兰法表示的表达试亦称前缀式。
( )18.目标代码生成时,应考虑如何充分利用计算机的寄存器的问题。
( )19.正规文法产生的语言都可以用上下文无关文法来描述。
( )20.一个优先表一定存在相应的优先函数。
( )21.3型文法一定是2型文法。
( )22.如果一个文法存在某个句子对应两棵不同的语法树,则文法是二义性的。
( )二、填空题:1.( 最右推导 )称为规范推导。
2.编译过程可分为(词法分析),(语法分析),(语义分析和中间代码生成),(代码优化)和(目标代码生成)五个阶段。
3.如果一个文法存在某个句子对应两棵不同的语法树,则称这个文法是()。
4.从功能上说,程序语言的语句大体可分为()语句和()语句两大类。
5.语法分析器的输入是(),其输出是()。
6.扫描器的任务是从()中识别出一个个()。
编译原理考试试卷
编译原理考试试卷一、选择题(每题2分,共20分)1. 编译器的主要功能是将源代码转换成目标代码,以下哪个不是编译器的基本组成部分?A. 词法分析器B. 语法分析器C. 代码优化器D. 运行时环境2. 词法分析器通常不负责以下哪项任务?A. 识别关键字B. 识别标识符C. 进行语义分析D. 去除空白字符3. 语法分析中,递归下降分析是一种:A. 确定性分析方法B. 非确定性分析方法C. 基于语法制导的分析方法D. 基于语法树的分析方法4. LR分析器是用于处理:A. 上下文无关文法B. 上下文有关文法C. 正则文法D. 链式文法5. 语义分析的目的是:A. 检查源代码的语法是否正确B. 检查源代码的语义是否正确C. 将源代码转换为目标代码D. 优化源代码6. 代码生成阶段,编译器将抽象语法树转换成:A. 目标代码B. 源代码C. 汇编代码D. 机器代码7. 编译优化中,常量折叠是一种:A. 局部优化B. 全局优化C. 过程间优化D. 模块内优化8. 编译器的前端主要负责:A. 源代码的输入B. 目标代码的生成C. 源代码的解析和翻译D. 运行时错误检测9. 编译器的后端主要负责:A. 词法分析B. 语法分析C. 代码优化D. 目标代码的生成和链接10. 以下哪个是编译原理中常用的数据结构?A. 栈B. 队列C. 链表D. 所有选项都是二、简答题(每题10分,共30分)1. 简述编译原理中词法分析器的作用及其实现方式。
2. 描述语法分析中自顶向下分析和自底向上分析的区别。
3. 解释编译优化的重要性,并给出一个优化的例子。
三、计算题(每题25分,共50分)1. 给定一个简单的算术表达式 "3 + 4 * 2 - 1",请说明如何使用递归下降分析器来解析这个表达式,并给出相应的语法树。
2. 假设你有一个简单的编译器后端,需要将四元式 "(a, b, +, c)" 转换成目标代码。
编译原理试题及答案

编译原理试题及答案
试题:
1. 解释编译原理的定义,同时给出编译器的作用。
2. 简要描述编译过程中的四个基本步骤。
3. 解释词法分析器的功能和作用。
4. 解释语法分析器的功能和作用。
答案:
1. 编译原理是研究如何将高级语言程序转化为等价机器语言程序的一门学科。
编译器是将高级语言文本转换成等价的机器语言的软件工具。
它负责将源代码转化为目标代码,以便计算机能够理解和执行。
2. (1) 词法分析:将源代码分解成一系列单词或标记。
(2) 语法分析:根据语法规则组织单词或标记形成语法树。
(3) 语义分析:分析语法树以检测语义错误。
(4) 代码生成:根据语法树生成目标代码。
3. 词法分析器的功能是将源代码分解成一系列单词或标记。
它将源代码读取为字符流,然后将这些字符组成单词,同时可以去除空格、注释等不具有实际意义的内容。
词法分析器的作用是为语法分析器提供正确的单词序列,为后续的语义分析和代
码生成步骤建立基础。
4. 语法分析器的功能是根据语法规则组织单词或标记形成语法树。
它通过构建语法树来分析源代码的语法结构,同时可以检测语法错误。
语法分析器的作用是为后续的语义分析和代码生成步骤提供一个结构化的表示形式,便于后续的处理和转换。
哈工大编译原理习题
a a + ( ) < <
+ > > < >
(
) >
< <
> = >
五、给出文 法G(E):
E→ E+T E→T T→T*F T→F F→(E) F→I 请构造文法 SLR(1)的分析 表
解 拓广文法如 答: 下:
S→E E→E+T E→T T→T*F T→F F→(E) F→I
I6 E → E+.T I1 识别活前缀的DFA + S→ E. T → .T*F E→ E.+T T → .F T I5 i F → .(E) F → i. E i F → .i I0 S→ .E F E→ .E+T ( I3 F E→ .T T → F. T→ .T*F F T→ .F I4 i I8 + ( F → (.E) F→ .(E) F → (E.) ) E → .E+T E F→ .i E → .T E → E.+T T T → .T*F ( T → .F I7 F → .(E) I2 ( T → T*.F T F → .i i F → .(E) F E→ T. T→ T.*F F → .i
二、文法G(S) S→S*aT|aT T →+aT|ε 消去左递归,求FIRST和FOLLOW S →aTS’ S’ →*aTS’| ε T →+aT| ε FIRST(S)={a} FOLLOW(S)={$} FIRST(S’)={*, ε} FOLLOW(S’)={$} FIRST(T)={+ ,ε} FOLLOW(T)={*,$}
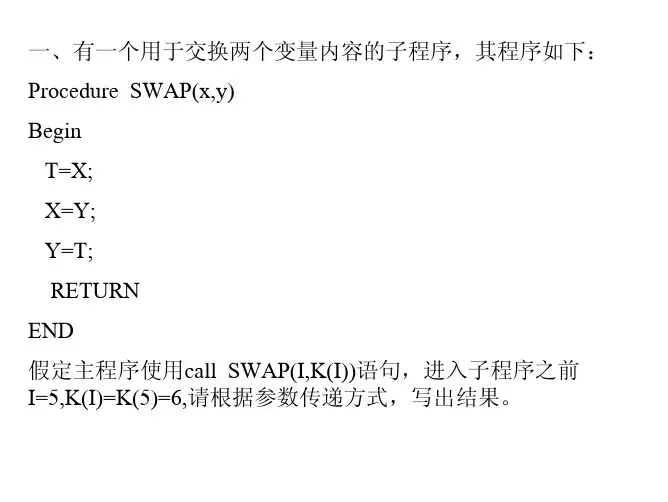
一、有一个用于交换两个变量内容的子程序,其程序如下: Procedure SWAP(x,y) Begin T=X; X=Y; Y=T; RETURN END 假定主程序使用call SWAP(I,K(I))语句,进入子程序之前 I=5,K(I)=K(5)=6,请根据参数传递方式,写出结果。
哈工大汇编考试题(附答案与详细解说)
一、分析题10x3’1.判断对错,指出原因.POP CS (错)_POP其他的段寄存器是可以的,唯独CS不可以_ MOV AL,[CX] (错)AL8位,CX16位,不匹配______SHL BL,1 ( )______DEC AL,1123H (错)DEC指令只有一个操作数______2.MOV CX,3000HMOV BX,5000HMOV AX,2000HMOC SP,AXPUSH BX;POP CX;XCHG AX,BX;JMP AX;3.写出下列指令源操作数部分的寻址方式各自是什么?如果是内存寻址的,则逻辑地址中的偏移地址分别是多少?(指令中标号TABLE 为200H,BX=10H,SI=A0H)寻址方式地址MOV AX,10000H 立即寻址0MOV AX,[7824H] 直接寻址7824HMOV AX,[TABLE] 直接寻址200HMOV AX,TABLE[BX][SI] 相对基址变址寻址200H+10H+A0H MOV AX,ES:[BX] 寄存器间接寻址10H二、简答题6x5=30’4.如何通过标志寄存器的标志位判断两个无符号数A和B的大小?cmp ax, bx指令执行后,sf=1且of=0,得到的结果为负数,而且没有溢出,说明实际的结果与得出的结果一致则ax<bx;sf=1且of=1,得到的结果为负数,而且有溢出,说明实际的结果与得出的结果不一致则ax>bx;sf=0且of=1,得到的结果为非负数,而且有溢出,说明实际的结果与得出的结果不一致则ax<bx;sf=0且of=0,得到的结果为非负数,而且没有溢出,说明实际的结果与得出的结果一致则ax>=bx;与cf无关5.编程序段测试BL寄存器的bit0和bit3是否同时为1,若是则将00H 送BL;否则将01H送AL。
CMP AL,BLJE L1MOV DL,0JMP EXITL1:MOV DL,1EXIT:6.编写程序段比较两个字符串STRING1和STRING2相等。
编译原理考试题及答案
编译原理考试题及答案一、选择题(每题5分,共20分)1. 编译器的主要功能是什么?A. 代码优化B. 代码翻译C. 代码调试D. 代码运行答案:B2. 下列哪个选项不属于编译器的前端部分?A. 词法分析B. 语法分析C. 语义分析D. 代码生成答案:D3. 在编译原理中,文法的产生式通常表示为:A. A -> αB. A -> βC. A -> γD. A -> δ答案:A4. 下列哪个算法用于构建语法分析树?A. LL(1)分析B. LR(1)分析C. SLR(1)分析D. LALR(1)分析答案:A二、填空题(每空5分,共20分)1. 编译器的前端通常包括词法分析、语法分析和________。
答案:语义分析2. 编译器的后端主要负责________和目标代码生成。
答案:代码优化3. 编译器中的词法分析器通常使用________算法来识别单词。
答案:有限自动机4. 语法分析中,________分析是一种自顶向下的分析方法。
答案:递归下降三、简答题(每题10分,共30分)1. 简述编译器的作用。
答案:编译器的主要作用是将高级语言编写的源代码转换成计算机能够理解的低级语言或机器代码,以便执行。
2. 解释一下什么是语法制导翻译。
答案:语法制导翻译是一种翻译技术,它利用源语言的语法信息来指导翻译过程,使得翻译过程能够更好地理解源代码的语义。
3. 什么是词法分析器?答案:词法分析器是编译器前端的一部分,它的任务是将源代码文本分解成一系列的标记(tokens),这些标记是源代码的最小有意义的单位。
四、计算题(每题10分,共30分)1. 给定一个简单的文法G(E):E → E + T | TT → T * F | FF → (E) | id请计算文法的非终结符号E的FIRST集和FOLLOW集。
答案:E的FIRST集为{(, id},FOLLOW集为{), +, $}。
2. 假设编译器在进行语法分析时,遇到一个语法错误的代码片段,请简述编译器如何处理这种情况。
编译原理编译原理考试卷模拟考试题.docx
《编译原理》考试时间:120分钟 考试总分:100分遵守考场纪律,维护知识尊严,杜绝违纪行为,确保考试结果公正。
1、将编译程序分成若干个“遍”是为了()( )A.提高程序的执行效率B.使程序的结构更加清晰C.利用有限的机器内存并提高机器的执行效率D.利用有限的机器内存但降低了机器的执行效率2、构造编译程序应掌握()( )A.源程序B.目标语言C.编译方法D.以上三项都是3、变量应当()( )A.持有左值B.持有右值C.既持有左值又持有右值D.既不持有左值也不持有右值4、编译程序绝大多数时间花在()上。
( ) A.出错处理 B.词法分析 C.目标代码生成 D.管理表格5、词法分析器的输出结果是()( )姓名:________________ 班级:________________ 学号:________________--------------------密----------------------------------封 ----------------------------------------------线-------------------------A.单词的种别编码B.单词在符号表中的位置C.单词的种别编码和自身值D.单词自身值6、正规式MI和M2等价是指()()A.MI和M2的状态数相等B.Ml和M2的有向弧条数相等。
C.M1和M2所识别的语言集相等D.Ml和M2状态数和有向弧条数相等7、中间代码生成时所依据的是()()A.语法规则B.词法规则C.语义规则D.等价变换规则8、后缀式ab+cd+/可用表达式()来表示。
()A.a+b/c+dB.(a+/(c+C.a+b/(c+D.a+b+c/d9、程序所需的数据空间在程序运行前就可确定,称为()管理技术。
()A.动态存储B.栈式存储C.静态存储D.堆式存储10、堆式动态分配申请和释放存储空间遵守()原则。
()A.先请先放B.先请后放C.后请先放D.任意11、一个编译程序中,不仅包含词法分析,(),中间代码生成,代码优化,目标代码生成等五个部分。
(完整word版)编译原理练习题
一章:1、编译程序各阶段都涉及。
A、词法分析B、表格管理C、语法分析D、语义分析2、下列哪个程序不是编译程序的组成部分?。
A、词法分析程序B、代码读入程序C、代码生成程序D、语法分析程序3、编译程序各阶段的工作往往是进行的。
A、顺序B、并行C、成批D、穿插4、词法分析所依据的是。
A、语义规则B、构词规则C、语法规则D、等价变换规则5、编译程序的语法分析器可以发现源程序中的。
A、语义错误B、语法和语义错误C、错误并校正D、语法错误6、高级语言源程序经编译后产生的程序是。
A、源程序B、目标程序C、函数D、过程1、扫描器的任务是从源程序中识别出一个个单词符号。
2、高级语言源程序有两种执行方式,即解释和编译。
判断:高级语言编写的源程序都必须通过编译,产生目标代码后才能运行。
多遍扫描的编译程序的多遍是指多次重复读源程序。
高级语言程序到低级语言程序的转换是基于语义的等价变换。
编译程序中错误处理的任务是对检查出的错误进行修改。
目标程序一定是机器语言程序。
连接装配程序可把经编译程序产生的目标程序变成可执行的机器语言程序。
简答题:1、请指出下列错误信息可能是编译的哪个阶段报告的?①else没有匹配的if;②数组下标越界;③使用的函数没有定义;④在数中出现了非数字信息。
答:①语法分析阶段②语义分析与中间代码生成阶段③语义分析与中间代码生成阶段④词法分析阶段2、何谓源程序、中间代码和目标代码?它们三者之间有何种关系?答:所谓源程序是指用某种高级语言编写的程序,它是编译程序的加工对象。
目标程序是指低级语言(机器语言或汇编语言)编写的程序,它是编译程序的加工结果。
中间代码是其结构介于源程序和目标程序之间的一种机内表示形式,它是编译程序产生的中间临时结果。
它们三者之间的关系是等价关系,即结构不同,但语义相同。
二章:1、文法G:S-xSx|y所识别的语言是。
A、xyx B 、(xyx)* C、x n yx n(n≥0) D、x*yx*2、设有文法G[S]=({S,B},{b},{S-b|bB,B-bS},S),该文法所描述的语言是。