
基于ELK的日志分析系统
DOI:10.14004/ki.ckt.2017.0591
1 Elk 日志分析平台介绍
通常, 日志被分散的储存不同的设备上。如果你管理数十 上百台服务器, 你还在使用依次登录每台机器的传统方法查阅 日志。这样是不是感觉很繁琐和效率低下。当务之急我们使 用集中化的日志管理, 例如: 开源的 syslog , 将所有服务器上的 日志收集汇总。 集中化管理日志后, 日志的统计和检索又成为一件比较麻 烦的事情, 一般我们使用 grep 、 awk 和 wc 等 Linux 命令能实现 检索和统计, 但是对于要求更高的查询、 排序和统计等要求和 庞大的机器数量依然使用这样的方法难免有点力不从心。
{ stdout {} }' Settings: Default pipeline workers: 8 Pipeline main started ysten 2016-05-20T01:53:36.857Z localhost ysten 使用-e 参数在命令行中指定配置是很常用的方式, 不过如 果需要配置更多设置则需要很长的内容。这种情况, 我们首先 创建一个简单的配置文件, 并且指定 logstash 使用这个配置文 件。例如: 在 logstash 安装目录下创建一个 “基本配置” 测试文 件 logstash-test.conf, 文件内容如下: # cat logstash-simple.conf input { stdin { } } output { stdout { codec=> rubydebug } } Logstash 使用 input 和 output 定义收集日志时的输入和输 出的相关配置, 本例中 input 定义了一个叫 "stdin" 的 input , output 定义一个叫"stdout"的 output 。无论我们输入什么字符, Logstash 都会按照某种格式来返回我们输入的字符, 其中 out⁃ put 被定义为 "stdout" 并使用了 codec 参数来指定 logstash 输出 格式。 使用 logstash 的 -f 参数来读取配置文件, 执行如下开始进 行测试: # echo "`date` hello World" Fri May 20 09:58:13 CST 2016 hello World # /usr/local/logstash/bin/logstash agent - f logstash- simple. conf Settings: Default pipeline workers: 8 Pipeline main started Fri May 20 09:58:13 CST 2016 hello World { "message" =>"Fri May 20 09:58:13 CST 2016 hello World", "@version" =>"1", "@timestamp" =>"2016-05-20T01:58:23.138Z", "host" =>"localhost"
收稿日期: 2017-02-15
本栏目责任编辑: 谢媛媛
软件设计开发
69
第 13 卷第 5 期 (2017 2 月) 电脑知识与技术 Computer Knowledge and年 Technology
Vol.13, No.5, February 2017
ISSN 1009-3044
Computer Knowledge and Technology 电脑知识与技术
E-mail: xsjl@dnzs.ቤተ መጻሕፍቲ ባይዱ
Tel:+86-551-65690963 65690964
基于 ELK 的日志分析系统
魏山林
(西南石油大学 计算机科学学院, 四川 成都 610500)
摘要: 日志主要包括系统日志、 应用程序日志和安全日志。系统运维和开发人员可以通过日志了解服务器软硬件信息、 检 查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷, 性能安全性, 从而及时采取措施纠正错 误。 关键词: 日志; 系统运维 中图分类号: TP311 文献标识码: A 文章编号: 1009-3044(2017)05-0069-02
2 开源实时日志分析 ELK 平台部署流程
1) 安装 Logstash 依赖包 JDK Logstash 的运行依赖于 Java 运行环境,Logstash 1.5 以上 版本不低于 java 7 推荐使用最新版本的 Java 。 下载 RPM 包安装 jdk #rpm -ivh jdk-8u91-linux-x64.rpm 设置 JDK 的环境变量, 如下: # tail -5 /etc/profile export JAVA_HOME=/usr/java/jdk1.8.0_91 export PATH=$PATH:$JAVA_HOME/bin export CLASSPATH=.: $JAVA_HOME/lib/dt.jar: $JA⁃ VA_HOME/lib/tools.jar 在 Shell 提示符中执行 java version 命令, 显示如下结果, 说 明安装成功: # java -version java version "1.8.0_91" 2) 安装 Logstash 下载并安装 Logstash , 下载 allplugins 的版本, 安装 logstash 只需将它解压的对应目录即可, 例如: /usr/local 下: # tar zxf logstash-all-plugins-2.3.1.tar.gz -C /usr/local/ #cd /usr/local #mv logstash-2.3.1 logstash 安装完成后运行如下命令: # /usr/local/logstash/bin/logstash -e 'input { stdin { } } output
基于大数据的ELK日志分析系统研究及应用

基于大数据的ELK日志分析系统研究及应用作者:李志民孙林檀吴建军张新征来源:《科学与信息化》2019年第28期摘要基于ELK的日志分析系统研究分析是为了有效的解决当下物联网应用日志处理效率低的问题。
因此,本文首先阐述了基于ELK的日志分析平台,然后总结了对系统日记群集优化大方法,从而提高日志分析系统的运行效率和排查异常的速度。
关键词 ELK;日志分析系统;Elasticsearch日志设计信息系统的重要组成部分,是系统运行、性能分析以及故障诊断的重要来源。
随着科学技术的不断发展和互联网技术的广泛应用,不断增加了系统的日志量,随着日志的应用范围的扩大和复杂程度的增加,传统日志的分析方式和效率已经不能适信息系统对日志的需求。
为了满足信息时代的发展需要,下面就基于ELK的日志分析系统进行相关的研究分析工作。
1 基于ELK的日志分析平台随着实时分析技术的不断发展和成熟应用,在日志领域出现了新的分析系统-ELK,ELK 实时日志分析平台主要运用了Kiba-na(数据可视分析平台)、Logstash(日志采集工具)、Elasticsearch(分布式搜索引擎)[1]。
这些技术的应用可以让系统的运行维护人员在庞大的日志信息量中及时找到所需要管理和维护的信息,从而实现了对日志系统的分析。
1.1 日志分析系统整体架构完整的日志系统是有日志的储存系统、采集系统、解析系统化以及可视化分析系统共同组成的。
日志采集工具是日志的主要采集器,在多台机器当中都有分布,它可以对非结构的日志进行解析,然后把解析的结果传输到分布式搜索引擎中;分布式搜索引擎可以完成全文检索的功能,属于储存日志的中央系统;而Kibana组件的存在不仅可以对分布式搜索引擎中的日志进行可视化操作[2],还可以进行统计分析和高级搜索。
但是日记采集工具及要完成对日志的采集工作又要完成解析工作,这样不仅会致系统的性能下降,严重的时候还会影响工作的进展。
而Beats的推广和应用有效解决了这一问题,图1为Beatsde在系统框架中的应用:Beats在进行信息采集和解析工作的时候可以针对不同的日志格式和来源使用不同的采集器,Beats采集器包括了5中不同种类和功能的日志采集器,分别为:Filebeat、Metricbest、Packetbeat、Winlogbeat、Heartbeat。
ELK日志分析系统

ELK⽇志分析系统⼀、ELK 概述1、ELK简介 ELK平台是⼀套完整的⽇志集中处理解决⽅案,将 ElasticSearch、Logstash 和 Kiabana 三个开源⼯具配合使⽤,完成更强⼤的⽤户对⽇志的查询、排序、统计需求。
ElasticSearch:是基于Lucene(⼀个全⽂检索引擎的架构)开发的分布式存储检索引擎,⽤来存储各类⽇志。
Elasticsearch 是⽤ Java 开发的,可通过 RESTful Web 接⼝,让⽤户可以通过浏览器与 Elasticsearch 通信。
Elasticsearch 是个分布式搜索和分析引擎,优点是能对⼤容量的数据进⾏接近实时的存储、搜索和分析操作。
Logstash:作为数据收集引擎。
它⽀持动态的从各种数据源搜集数据,并对数据进⾏过滤、分析、丰富、统⼀格式等操作,然后存储到⽤户指定的位置,⼀般会发送给 Elasticsearch。
Logstash 由JRuby 语⾔编写,运⾏在 Java 虚拟机(JVM)上,是⼀款强⼤的数据处理⼯具,可以实现数据传输、格式处理、格式化输出。
Logstash 具有强⼤的插件功能,常⽤于⽇志处理。
Kiabana:是基于 Node.js 开发的展⽰⼯具,可以为 Logstash 和 ElasticSearch 提供图形化的⽇志分析 Web 界⾯展⽰,可以汇总、分析和搜索重要数据⽇志。
Filebeat:轻量级的开源⽇志⽂件数据搜集器。
通常在需要采集数据的客户端安装 Filebeat,并指定⽬录与⽇志格式,Filebeat 就能快速收集数据,并发送给 logstash 进⾏解析,或是直接发给 Elasticsearch 存储,性能上相⽐运⾏于 JVM 上的 logstash 优势明显,是对它的替代。
2、为什么要使⽤ ELK ⽇志主要包括系统⽇志、应⽤程序⽇志和安全⽇志。
系统运维和开发⼈员可以通过⽇志了解服务器软硬件信息、检查配置过程中的错误及错误发⽣的原因。
ELK日志分析系统搭建
ELK日志分析系统搭建elk套件是指elasticsearch、logstash、kibana三件套,它们可以组成一套日志分析和监控工具。
本文说明安装过程和典型的配置过程,由于三个软件各自的版本号太多,建议采用官网(https://www.elastic.co/downloads)推荐的搭配组合,版本不搭会引起好多其他问题。
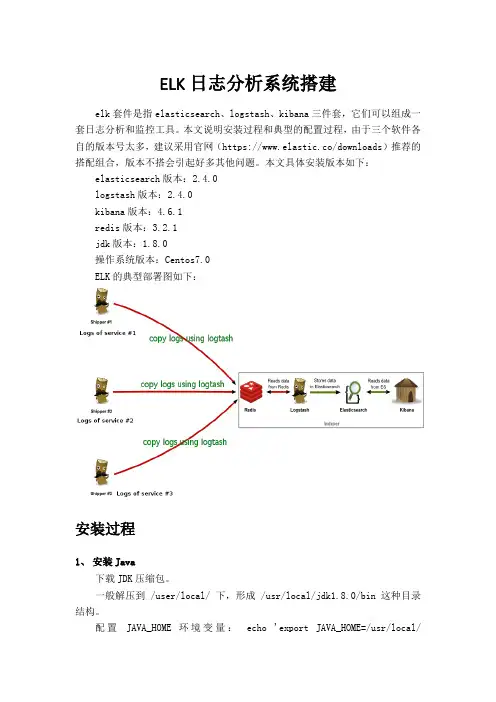
本文具体安装版本如下:elasticsearch版本:2.4.0logstash版本:2.4.0kibana版本:4.6.1redis版本:3.2.1jdk版本:1.8.0操作系统版本:Centos7.0ELK的典型部署图如下:安装过程1、安装Java下载JDK压缩包。
一般解压到 /user/local/ 下,形成 /usr/local/jdk1.8.0/bin 这种目录结构。
配置JAVA_HOME 环境变量:echo 'export JAVA_HOME=/usr/local/jdk1.8.0' >> ~/.bashrc 。
2、安装logstash使用root用户进行安装,实际上解压后直接运行就可以了# tar -zxvf logstash-2.4.0.tar.gz# cd logstash-2.4.0可通过bin/logstash -e 'input {stdin{}} output {stdout{}}'测试[root@localhost logstash-2.4.0]# bin/logstash -e 'input {stdin{}} output {stdout{}}'Settings: Default pipeline workers: 8Pipeline main started键入:hello elktest显示:2016-10-20T03:55:59.121Z localhost.localdomain hello elktest 表示把从标准输入设备输入的内容再通过标准输出设备输出。
项目实战14—ELK企业内部日志分析系统

项⽬实战14—ELK企业内部⽇志分析系统本⽂收录在⼀、els、elk 的介绍1、els,elkels:ElasticSearch,Logstash,Kibana,Beatselk:ElasticSearch,Logstash,Kibana① ElasticSearch 搜索引擎 ElasticSearch 是⼀个基于Lucene的搜索引擎,提供索引,搜索功能。
它提供了⼀个分布式多⽤户能⼒的全⽂搜索引擎,基于RESTful web接⼝。
Elasticsearch是⽤Java开发的,并作为Apache许可条款下的开放源码发布,是当前流⾏的企业级搜索引擎。
设计⽤于云计算中,能够达到实时搜索,稳定,可靠,快速,安装使⽤⽅便② Logstash 接收,处理,转发⽇志的⼯具 Logstash 是⼀个开源的服务器端数据处理流⽔线,它可以同时从多个数据源获取数据,并将其转换为最喜欢的"存储"(Ours is Elasticsearch, naturally.)③ Beats:采集⽇志信息(加上beats 就是els),GO开发的,所以⾼效、很快 Filebeat:Log Files Metricbeat:Metrics Packetbeat:Network Data Winlogbeat:Windows Event Logs Heartbeat:Uptime Monitoring④ Kibana:独⽴的、美观的图形数据展⽰界⾯ Kibana 让你可视化你的Elasticsearch数据并导航Elastic Stack,所以你可以做任何事情,从凌晨2:00分析为什么你得到分页,了解⾬⽔可能对你的季度数字造成的影响。
2、实验前准备①环境准备机器名称IP配置服务⾓⾊els192.168.1.101(私)192.168.10.101(公)elasticsearch(搜索引擎)logstash192.168.1.102(私)192.168.10.102(公)logstash(⽇志处理)redis(缓冲队列)filebeat192.168.1.103(私)192.168.10.103(公)filebeat(⽇志收集)httpd/mysql(⽣成⽇志)kibana192.168.1.104(私)192.168.10.104(公)kibana(展⽰界⾯)②修改主机名、hosts⽂件,确保节点直接能通过主机名连通[root@els ~]# hostnamectl set-hostname [root@logstash ~]# hostnamectl set-hostname [root@filebeat ~]# hostnamectl set-hostname [root@kibana ~]# hostnamectl set-hostname centos7 修改主机名:[root@els ~]# hostnamectl set-hostname 主机名③修改hosts[root@els ~]# vim /etc/hosts192.168.1.101 192.168.1.102 192.168.1.103 192.168.1.104 互相测试[root@els ~]# ping ④关闭防⽕墙、selinux[root@els ~]# iptables -F[root@els ~]# setenforce 0⑤同步时间[root@els ~]# systemctl restart chronyd⼆、安装搭建elasticsearch 和head 插件1、安装elasticsearch Elasticsearch 是⼀个分布式的 RESTful 风格的搜索和数据分析引擎,能够解决不断涌现出的各种⽤例。
ELK+Kafka集群日志分析系统
ELK+Kafka集群⽇志分析系统ELK+Kafka集群分析系统部署因为是⾃⼰本地写好的word⽂档复制进来的。
格式有些出⼊还望体谅。
如有错误请回复。
谢谢!⼀、系统介绍 2⼆、版本说明 3三、服务部署 31) JDK部署 32) Elasticsearch集群部署及优化 33) Elasticsearch健康插件安装 134) Shield之elasticsearch安全插件 155)Zookeeper集群搭建 156)Kafka集群搭建 177)测试Kafka和Zookeeper集群连通性 198) Logstash部署 209) Kibana部署 20四、系统使⽤⽰例 221) Logstash 作为kafka⽣产者⽰例 222) Logstash index 消费kafka⽰例 23⼀、系统介绍随着实时分析技术的发展及成本的降低,⽤户已经不仅仅满⾜于离线分析。
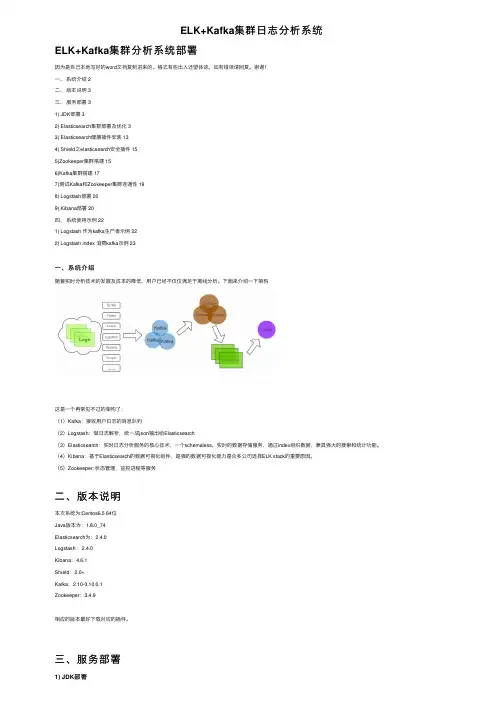
下⾯来介绍⼀下架构这是⼀个再常见不过的架构了:(1)Kafka:接收⽤户⽇志的消息队列(2)Logstash:做⽇志解析,统⼀成json输出给Elasticsearch(3)Elasticsearch:实时⽇志分析服务的核⼼技术,⼀个schemaless,实时的数据存储服务,通过index组织数据,兼具强⼤的搜索和统计功能。
(4)Kibana:基于Elasticsearch的数据可视化组件,超强的数据可视化能⼒是众多公司选择ELK stack的重要原因。
(5)Zookeeper: 状态管理,监控进程等服务⼆、版本说明本次系统为:Centos6.5 64位Java版本为:1.8.0_74Elasticsearch为:2.4.0Logstash :2.4.0Kibana:4.6.1Shield:2.0+Kafka:2.10-0.10.0.1Zookeeper:3.4.9相应的版本最好下载对应的插件。
三、服务部署1) JDK部署下载JDK包到/data⽬录下解压,并将变量导⼊/etc/profile末尾。
基于ELK的日志分析与异常检测系统的设计与实现

基于ELK的日志分析与异常检测系统的设计与实现基于ELK的日志分析与异常检测系统的设计与实现一、引言随着信息技术的不断发展,大规模分布式系统越来越复杂,其日志数据量也越来越庞大。
如何高效地分析和处理这些日志数据成为了一个迫切需要解决的问题。
本文将介绍一种基于ELK (Elasticsearch、Logstash和Kibana)的日志分析和异常检测系统的设计与实现。
二、ELK架构概述ELK是一个开源的日志分析平台,其中Elasticsearch作为分布式搜索引擎用于存储和检索大量的日志数据;Logstash用于日志的收集、过滤和转发;Kibana作为可视化工具展示数据。
三、系统设计1. 数据收集为了收集分布式系统产生的日志数据,我们需要在每个节点上安装Logstash,并配置相应的输入插件,如filebeat,以实时读取日志文件。
同时,为了增加实时性,我们可以使用消息队列,如Kafka,将日志数据传输到Logstash中。
2. 数据过滤在Logstash中,我们可以配置不同的过滤器来过滤和处理日志数据。
例如,我们可以使用grok模式匹配来提取特定的字段,使用date插件来解析时间戳,使用mutate插件来修改日志中的字段等。
通过合理配置过滤器,可以将原始的日志数据转化为结构化的数据,方便后续的分析和可视化。
3. 数据存储过滤后的数据将被存储到Elasticsearch中。
Elasticsearch作为一个分布式搜索引擎,具有高性能和高可扩展性,可以快速地存储和检索大量的日志数据。
4. 数据可视化Kibana作为ELK的可视化工具,提供了丰富的图表和仪表盘,可以帮助用户直观地理解和分析日志数据。
用户可以通过Kibana自定义查询条件、创建仪表盘、设置监控告警等,以满足自己的需求。
四、异常检测算法设计在日志数据中,异常通常体现为与正常行为模式不一致的事件。
为了检测异常,我们可以使用机器学习算法,如聚类、分类和时间序列分析等。
基于ELK架构的日志分析系统研究与实践
基于ELK架构的日志分析系统研究与实践作者:王军利杨卫中来源:《中国信息化》2020年第09期在传统的基于IOE集中架构的IT系统中,部署的主机及软件数量较少,产生的日志种类和数量也较少;随着互联网技术的快速发展,“平台+应用”的分布式架构成为主流,主机数量和软件规模急剧增加,日志分析变得日益困难。
本文主要针对基于ELK架构的日志分析系统进行研究,实现对分布式部署的主机和软件日志进行收集、分析、存储,并提供良好的UI界面进行数据展示、快速搜索、处理分析等功能,从而提升日志分析、问题定位、性能优化等工作的效率。
随着新一代BSS的上线,IT系统架构发生了巨大变化,从传统的IOE集中架构过渡为当前流行的“平台+应用”的分布式架构。
目前新一代BSS系统运行在近500台x86物理机和虚拟机上,众多的主机、组件及应用,每天合计产生TB级的日志,这些日志往往被运维人员忽略,加上日志分析工具的缺乏,这些日志远没有被有效利用起来。
因此,对各组件、各环节、各路径的日志的分析与管控,是传统业务运维走向“统一管控、智能运营”目标的重要手段,是满足IT系统开放、敏捷、智能化要求的重要保障。
在复杂的分布式的主机及应用集群中,记录日志的方式多种多样,且不易归档,以及无法提供有效的日志监控手段等,无论是开发人员还是运维人员都无法高效搜索日志内容从而快速准确定位问题,因此迫切需要一个集中的、独立的、能够收集管理各个应用和服务器上的日志,并提供良好的UI界面进行数据展示、快速搜索、處理分析等功能的工具或系统。
经过分析研究,基于开源ELK组件的日志分析系统(以下简称该系统)提供了相应的解决方案,该方案能高效、简便的满足以上场景。
(一)ELK架构及特点ELK架构主要由ElasticSearch、Logstash和Kibana等三个开源软件组成,其中E (ElasticSearch,也简称ES)是分布式搜索引擎,完成搜索、分析、存储数据等功能;L (Logstash)是收集、分析、过滤日志的工具,支持多种数据获取方式;K(Kibana)为EL提供友好的日志分析Web界面,并可以汇总、分析和搜索日志。
基于ELK的实时日志分析系统
基于ELK的实时日志分析系统ELK是一个开源的日志管理工具,它由三个独立但协作的组件组成:Elasticsearch、Logstash和Kibana。
ELK可以用于实时的日志分析,它可以帮助用户在大量的日志数据中实时、可视化和分析数据。
首先,Elasticsearch是一个分布式引擎,它可以快速地存储、和分析大规模的数据。
它使用倒排索引的方式来存储数据,并提供了灵活的全文、过滤和聚合功能。
对于实时日志分析系统来说,Elasticsearch可以作为一个集中的存储和索引引擎,用于存储和检索大量的日志数据。
其次,Logstash是一个用于数据收集、转换和发送的工具。
它可以从不同的数据源中收集日志数据,如文件、数据库、网络等,并对数据进行预处理、清洗和转换。
同时,Logstash也可以将处理后的数据发送到不同的目标,如Elasticsearch、消息队列等。
对于实时日志分析系统来说,Logstash可以负责收集应用程序生成的日志数据,并将其发送到Elasticsearch中进行索引和存储。
最后,Kibana是一个用于可视化和分析数据的工具。
它提供了一个直观的Web界面,用户可以通过查询和过滤数据来生成各种图表和图形,如柱状图、饼图、地图等。
Kibana还支持用户创建自定义的仪表板和报表,以便更方便地监控和分析日志数据。
对于实时日志分析系统来说,Kibana可以作为一个前端界面,供用户可视化和分析存储在Elasticsearch中的日志数据。
基于ELK的实时日志分析系统可以帮助用户实时地监控和分析应用程序的日志数据。
用户可以通过Kibana的查询功能,快速和过滤感兴趣的日志数据,并通过可视化工具生成图表和报表。
这样,用户可以更方便地分析日志数据,并及时发现应用程序的异常和问题。
此外,ELK还具有高可靠性和可扩展性的特点。
Elasticsearch作为一个分布式系统,可以水平地扩展以处理大规模的数据,并提供高可用性和容错性。
elkfilebeat搭建日志系统
elkfilebeat 搭建日记系统Elasticsearch散布式搜寻和剖析引擎。
拥有高可伸缩、高靠谱和易管理等特色。
鉴于Apache Lucene 建立,能对大容量的数据进行接近及时的储存、搜寻和剖析操作。
Logstash日记采集器。
采集各样数据源,并对数据进行过滤、剖析、格式化等操作,而后储存到Elasticsearch。
Kibana数据剖析和可视化平台。
与 Elasticsearch 配合使用,对此中数据进行搜寻、剖析、图表展现。
Filebeat一个轻量级开源日记文件数据采集器, Filebeat 读取文件内容,发送到 Logstash 进行分析后进入 Elasticsearch,或直接发送到Elasticsearch 进行集中式储存和剖析。
架构介绍鉴于 ELK 的使用方式, Logstash 作为日记采集器,Elasticsearch 进行日记储存, Kibana 作为日记体现,大概以下几种架构。
架构一图中Logstash 多个的原由是考虑到程序是散布式架构的状况,每台机器都需要部署一个Logstash,假如的确是单服务器的状况部署一个Logstash 即可。
前面提到Logstash 会对数据进行剖析、过滤、格式化等操作,这一系列操作对服务器的CPU 和内存资源的耗费都是比较高的,因此这类架构会影响每台服务器的性能,因此并不介绍采纳。
架构二对比于架构一,增添了一个MQ和Logstash,Logstash 的输出和输入支持Kafka 、Redis、RabbitMQ等常见信息行列,MQ 前的Logstash 只作为日记采集和传输,其实不分析和过滤,先将日记加入行列,由MQ 后边的Logstash 持续分析和过滤,这样就不至于每台服务器耗费费源都好多。
架构三这类架构是鉴于架构二简化来的,实质在使用过程中也是能够采纳的,日记直接进入MQ ,Logstash 花费MQ数据即可。
架构四这类架构在日记数据源和Logstash(或 Elasticsearch)中增添了Beats 。
ELk日志采集分析系统搭建
ELk⽇志采集分析系统搭建⽬录⼀、什么是ELK (3)⼆、架构图 (3)三、数据处理流程 (5)四、软件部署 (6)4.1、ElasticSearch7.5集群部署 (6)4.1.1新建⽤户 (6)4.1.2修改⽤户相关权限 (6)4.1.3配置jdk,要求1.8以上 (6)4.1.4将安装包拷贝到指定⽬录 (6)4.1.5修改config下的elasticsearch.yml (6)4.1.6修改config下的jvm.yml (10)4.1.7启动es (11)4.2、Logstash7.5部署 (11)4.2.1配置jdk,要求1.8以上 (11)4.2.2将安装包拷贝到指定⽬录并解压 (11)4.2.3 修改配置⽂件 (11)4.2.4 启动logstash (14)4.3、kibana7.5部署 (15)4.3.1 安装node.js (15)4.3.2 安装kibana (15)4.3.3 启动kibana (15)4.4、filebeat7.5部署 (16)4.4.1 新建⽤户 (16)4.4.2 安装filebeat (16)4.4.3 修改配置⽂件 (16)4.4.4 加载es索引 (19)4.4.5 加载kibana仪表板 (19)4.5、metricbeat7.5部署 (19)4.5.1 安装配置metricbeat (19)4.5.1 加载es索引 (20)4.5.1 加载kibana仪表板 (20)4.5.1 启动metricbeat (20)五、使⽤ (21)5.1、kibana使⽤ (21)5.1.1配置索引模式 (21)5.1.2查看⽇志 (23)5.1.3查看图表 (24)5.1.4配置仪表板 (26)六、常见问题 (30)⼀、什么是ELKELK是Elasticsearch、Logstash、Kibana三⼤开源框架⾸字母⼤写简称。
市⾯上也被成为Elastic Stack。