
应用统计学 第12章例题分析
第12章例题分析(课本340页)(1)相关分析各变量之间的相关关系矩阵(包括自变量和因变量)不良贷款(亿元)各项贷款余额(亿元)本年累计应收贷款(亿元)贷款项目个数(个)本年固定资产投资额(亿元)不良贷款(亿元) 1各项贷款余额(亿元)0.84357136 1本年累计应收贷款(亿元)0.73150501 0.678771764 1贷款项目个数(个)0.70028149 0.848416404 0.58583149 1本年固定资产投资额(亿元)0.51851809 0.779702158 0.47243096 0.746646 1 各变量之间的相关关系矩阵(各个自变量之间的相关关系)各项贷款余额(亿元)本年累计应收贷款(亿元)贷款项目个数(个)本年固定资产投资额(亿元)各项贷款余额(亿元) 1本年累计应收贷款(亿元)0.67877176 1贷款项目个数(个)0.8484164 0.585831 1本年固定资产投资额(亿元)0.77970216 0.472431 0.746646 1 结论:各自变量不仅仅跟因变量存在较强的线性相关关系,而且自变量彼此之间也存在较强的相关关系。
(2)回归分析SUMMARY OUTPUT回归统计Multiple R 0.893086776R Square 0.797603989Adjusted R Square 0.757124787标准误差 1.778752284观测值25方差分析df SS MS F Significance F回归分析 4 249.371206 62.3428 19.70404 1.04E-06残差20 63.2791938 3.16396总计24 312.6504Coefficients 标准误差t StatP-valueLower 95%Upper 95%Intercept-1.021639763 0.78237236 -1.30582292 0.206433969 -2.653639903 0.61036038 各项贷款余额(亿元) 0.0400393530.010433723.83749534 0.0010284640.018274994 0.06180371本年累计应收贷款(亿元)0.148033891 0.078794333 1.8787377980.07493542 -0.016328206 0.31239599贷款项目个数(个) 0.014529353 0.083033158 0.174982537 0.862852686-0.15867478 0.18773349本年固定资产投资额(亿元)-0.029192866 0.015072973 -1.93676892 0.067030076 -0.0606345370.0022488结论:(一)估计的多元线性回归方程为:=i Y-1.021639763+0.040039353x i 1+0.148033891x i 2+0.014529353x i 3-0.029192866x i 4 或者如下写亦可:=Y-1.021639763+0.040039353x 1+0.148033891x 2+0.014529353x 3-0.029192866x 4 (二)拟合优度检验:。
程所解释的比例为产投资额的多元回归方贷款项目个数、固定资本年累计应收贷款、不良贷款与贷款余额、款取值的变差中,能被进行调整后,在不良贷的自变量的个数:在用样本量和模型中实际意义,即修正后的。
所解释的比例为投资额的多元回归方程款项目个数、固定资产本年累计应收贷款、贷贷款余额、差中,能被不良贷款与:在不良贷款取值的变实际意义%76.79 75.71%70.75712478R R %76.79 79.76%90.79760398R a 222====(三)显著性检验(1) 总体的线性关系是否显著(线性关系的显著性检验)Significance F =1.04E-06<0.05,表明总体中因变量Y (不良贷款)与自变量X 1-X4(贷款余额、累计应收贷款、贷款项目个数、固定资产投资额)有显著的线性关系。
(2) 总体中各个变量对Y是否影响显著(回归系数的显著性检验)各项贷款余额(亿元) 0.001028464 本年累计应收贷款(亿元)0.07493542贷款项目个数(个)0.862852686本年固定资产投资额(亿元)0.067030076P-value=0.001028464<0.05,总体中各项贷款余额对不良贷款有显著影响;P-value=0.07493542>0.05,总体中本年累计应收贷款对不良贷款没有显著影响;P-value=0.862852686>0.05,总体中贷款项目个数对不良贷款没有显著影响;P-value=0.067030076>0.05,总体中固定资产投资额对不良贷款没有显著影响;对于以上回归方程的结果,可以通过假设检验判断,总体中只有各项贷款余额一个变量对不良贷款影响显著,其他对不良贷款影响不大。
但是由于相关分析中可以看出,各个变量彼此之间相关关系也很强,那么本回归方程需进一步分析:(逐步回归法)(1)分别做各个自变量与因变量的一元线性回归方程,记录各个判定系数和F 值如下:SUMMARYOUTPUT回归统计Multiple R 0.843571364R Square 0.711612647Adjusted RSquare0.699074066标准误差 1.979947533观测值25方差分析df SS MS F Significance F回归分析 1 222.4859787222.485978756.753844061.18349E-07残差23 90.164421343.920192232总计24 312.6504Coefficients标准误差t Stat P-value Lower 95% Upper 95%Intercept -0.8295206170.723043295-1.1472627190.263067597-2.3252496230.66620839各项贷款余额(亿元)0.037894707 0.00503015 7.5335147221.18349E-070.027489050.048300364SUMMARYOUTPUT回归统计Multiple R 0.731505008 R Square 0.535099577 Adjusted RSquare0.514886515 标准误差 2.513885813 观测值25 方差分析df SS MS F Significance F回归分析 1 167.2990967167.2990967 26.4729599 3.25638E-05残差23 145.35130336.319621883总计24 312.6504Coefficients标准误差t Stat P-value Lower 95% Upper 95%Intercept -0.3181430680.933380849-0.3408502210.736310273-2.2489884531.612702317本年累计应收贷款(亿元)0.416784412 0.0810047 5.1451880333.25638E-050.2492134240.584355399SUMMARYOUTPUT回归统计MultipleR0.700281491 R Square 0.490394166 AdjustedR Square0.468237391 标准误差 2.631981134观测值25 方差分析df SS MS F Significance F回归分析 1 153.3219322153.321932222.132921319.72063E-05残差23 159.32846786.927324688总计24 312.6504Coefficients 标准误差t Stat P-value Lower 95% Upper 95%Intercep t -0.7230952811.082700971-0.6678624120.510868137-2.9628328721.516642309贷款项目个数(个)0.295165470.0627402414.7045638819.72063E-050.1653773940.424953545SUMMARYOUTPUT回归统计Multiple R 0.51851809 R Square 0.26886101 Adjusted RSquare0.237072358 标准误差 3.152575881 观测值25 方差分析df SS MS F Significance F回归分析 1 84.0595022484.059502248.457767 0.007918887残差23 228.59089789.938734685总计24 312.6504Coefficients 标准误差t Stat P-value Lower 95% Upper 95%Intercept 0.979961164 1.1359678940.8626662510.397227184-1.3699674513.329889779本年固定资产投资额(亿元)0.046586405 0.016018852.9082240280.0079188870.0134488890.079723921(2)根据判定系数和F值的大小,选取判定系数(或者F值)最大的方程作为基础方程,然后按照决定系数的大小来逐个添加变量,逐步回归。
(将每个建立的新模型,与原来模型比较,若决定系数(R^2)或其他统计量与原来相比有所改善,则让该变量留在模型中,若无改善,则不留该变量在模型中。
)根据判定系数,先添加X2到基础方程中,即做X1、X2与Y的回归方程如下:回归统计Multiple R 0.870885326R Square 0.758441251Adjusted R Square 0.736481365标准误差1.852804256观测值25 方差分析df SS MS F Significance F回归分析 2 237.1269605118.563480334.537576481.63399E-07残差22 75.523439463.432883612总计24 312.6504Coefficients标准误差t Stat P-value Lower 95% Upper 95%Intercept -1.3788341360.727018066-1.8965610340.071093573-2.8865773160.128909045各项贷款余额(亿元)0.028909390.0064099424.5100861590.0001735440.0156159840.042202795本年累计应收贷款(亿元)0.1678986050.0813001832.0651688320.050887882-0.0007076550.336504864虽然判定系数有所增加,但是由于X2的P-value=0.050887882>0.05,所以对不良贷款影响不显著,所以不能保留X2在模型中。
社会统计学第十二章 相关与回归分析

2. 相关方向:正相关和负相关 所谓正相关关系是指一个变量的值增加时,另一变
量的值也增加。例如,受教育水平越高找到高薪水工作的 机会也越大。而负相关关系是指一个变量的值增加时,另 一变量的值却减少。例如,受教育水平越高,理想子女数 目越少。要强调的是,只有定序以上测量层次的变量才分 析相关方向,因为只有这些变量的值有高低或多少之分。 至于定类变量,由于变量的值并无大小、高低之分,故定 类变量与其他变量相关时就没有正负方向了。
父母智力 组合
优+优
优+劣 一般+一般
劣+劣
子女智力 子女智力
优秀
一般
71.6 25.4
33.6 42.7
18.6 66.9
5.4 34.4
子女智力 低下
3.0 23.7 14.5 60.2
通过列联表研究定类变量之间的关联性,这 实际上是通过相对频数条件分布的比较进行的。 如果对不同的X,Y的相对频数条件分布不同,且 和Y的相对频数边际分布不同,则两变量之间是 相关的。而如果变量间是相互独立的话,必然存 在着Y的相对频数条件分布相同,且和它的相对 频数边际分布相同。后者用数学式表示就是
r×c相对频数联合分布列联表
控制X,Y相对频数条件分布列联表
控制Y,X相对频数条件分布列联表
[例A1]试把下表所示的频数分布列联表,转 化为自变量受到控制的相对频数条件分布列联 表,并加以相关分析。
投票行为
受教育程度X
Y
大学以 大学以
FY
上
下
投票
160
129
289
弃权
7
61
68
合计:FX 167
r×c相对频数分布列联表的一般形式
在相对频数分布列联表中,各数据为各分类
(12)第12章 国民经济统计基础知(曾五一)

统计学 四、国民经济核算的基本原则
STATISTICS
(一)计量社会产品的生产性原则和社会性原则 “生产性原则”是指国民经济核算应对生产活动的 全部有效成果进行计量。 “社会性原则”是指作为核算对象的生产成果还必 须具有社会性,即不仅是生产者个人所需要的,而 且还是社会所需要的,是能得到社会承认的成果。 (二)国民经济核算的平衡原则 社会产品的生产、分配和使用三者在总量上应该是 恒等或平衡的。这就是所谓的“平衡原则”,国外 有的学者将这种关系称作“三方等价原理”。
最常用的国民经济总量指标。
12 - 18
图12-2 常用国民经济统计指标
统计学
STATISTICS
二、国民经济生产指标
(一)国内总产出 “国内总产出”是指一定时期内国民经济各部门生产的社会 总产品的价值总量。 从实物形态看,社会总产品可分为货物和服务两大类。从价 值形态看,国内总产出是社会总产品完全价值的总和,其价 值构成为:(1)生产资料转移价值c,包括劳动手段转移价值 (固定资产折旧)c1和劳动对象转移价值(即中间消耗)c2 ;(2) 活劳动新创价值,包括必要劳动价值v和剩余劳动价值m 。 国内总产出包括了生产资料转移价值的大量重复计算,并且, 这种重复计算的程度还与生产组织的内部结构的变化有关。 国内总产出只是一个有关国民经济生产的“总周转量”指标, 它能够表明全社会生产活动的总规模,并能用于对国民经济 各部门间的技术经济联系进行投入产出分析,但不能说明国 民经济生产活动的最终成果。
12 - 12
统计学 三、国民经济核算的行业与部门分类
STATISTICS
(一)机构部门分类和活动部门分类 1. 机构部门分类。按其在取得收入和支配收入、筹集资金和 运用资金的财务决策权同一性标准进行分类的一种方法。分 类的基本单位是能够拥有资产、承担负债,从事经济活动并 与其它单位进行经济交易的实体。 我国新国民经济核算体系中,常住单位分为四个机构部门: (1)非金融企业部门。 (2)金融机构部门。 (3)政府部门。 (4)住户部门。 2.活动部门分类。按各基层单位活动性质的同类性对掌握生 产经营决策权的基层单位进行分类。这种分类存在层次差别, 根据分析的需要,可粗可细。
h第十二章简单回归分析

b 的统计学意义是:X 每增加(减)一 个单位,Y 平均改变b个单位
16
回归模型的前提假设
线性回归模型的前提条件是:
18
19
回归参数的估计 ——最小二乘原则
➢ 残差(residual)或剩余值,即实测值Y与假定回 归线上的估计值 的Yˆ纵向距离 Y。Yˆ
➢ 求解a、b实际上就是“合理地”找到一条能 最好地代表数据点分布趋势的直线。
原则:最小二乘法(least sum of squares),即可 保证各实测点至直线的纵向距离的平方和最小
38
式中 F
SS回 SS残
回 残
MS回 MS残
,
回
1,
残
n2
MS回 为回归均方 MS残 为残差均方。 F 服从自由度为回、 残 的F 分布。
SS回
blXY
l
2 XY
lXX b2lXX
39
么么么么方面
Sds绝对是假的
t 检验
对 0 这一假设是否成立还可进行如下 t 检验
tb
b0 Sb
线性(linear) 独立(independent) 正态(normal) 等方差(equal variance)
17
公式(12-2)称为样本回归方程,它 是对两变量总体间线性关系的一个估计。 根据散点图我们可以假定,对于 X 各个取 值,相应Y 的总体均数 Y|X 在一条直线上
(图 12-2),表示为 Y|X X
水准同样得到总体回归系数不为 0 的结论,
统计学原理 第12章 统计报告

3. 鲜明。主题要明确表示赞成什么、反
对什么,观点明确,态度明朗,旗帜鲜明。 4.集中。全文要围绕主题,说深说透,选 材要力争选那些最能说明观点和材料,去掉次 要正文要严谨、分明 、
3.密度法,是指适当控制统计分析报告的 数字密度,数字不应太多,也不要过少,一 般控制在全文的10%~30%,其分布要均衡。
4. 概略法,是指把复杂的统计数字概算、 扩算或简化,使读者易读易记。它可采用概 数、大单位数、范围数、代表数、代替数等 方法。 5. 明晰法,是指把一些比较抽象、复杂 的统计数字采用抽象数变具体数,或数字加 解说的办法使其变得更清晰、更明确的方法。 6. 对衬法,是指将差别较大的两种事实 数字进行对照,引起读者注意。
务、研究重点、基本内容和结构形式特征,
统计报告归纳起来主要包括专题性的分析报
告、
总结性的分析报告、进度性的分析报告、预
测决策性分析报告。
二、 (一)“四性” 1.准确性,就是要数字准确,情况真实,观点
正确,分析符合客观实际,依数据分析、判断、提
炼的观点,必须准确。 2.针对性,就是有明确的目的性和实用性,为 一定的对象服务。要“适销对路”,对准需要,不 应“无的放矢”。
7.揭示法,是指揭示统计数字的背后实质, 加强统计数字的效果。 8. 联系法,是指运用突出的事实、典型的 事例,引起人们注意,加强统计数字效果。
9. 形象法,是指利用比喻、夸张等手法使 统计数字变得形象、具体,以使读者理解。 10.图表法,是指通过统计图表来表达统计 数字,给读者直观印象,以增强统计数字效果。
五、统计分析报告例析
END
3. 时效性,就是要保证统计信息的价值。统
第12章假设检验 《统计学实验》 ppt课程ppt
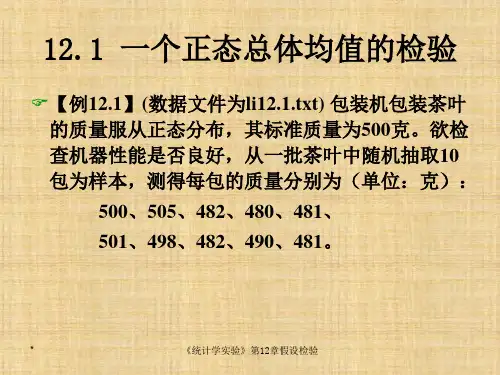
x=read.table(“li12.1.txt”,header=T) #从li11.1.txt中读 入数据,记为x。
(或者:x<c(500,505,482,480,481,501,498,482, 490,481) #输入样本数据x)
t.test(x,mu=500) #检验总体均值是否等于500
Z pˆ p0
p0 1 p0
质量 500 505 482 480 481 501 490 498
频数 20 16 9 1 8 20 8 18
以0.05为显著水平检验:包装机包装出来的茶叶 的平均质量是否为标准质量500克?
2012-6-26
【统计理论】
当样本来自于非正态总体时,要检验总体 均值是否等于某个常数,在原假设成立且n 充分大时,近似地有:
*
《统计学实验》第12章假设检验
(2) 这是一个左侧检验问题,即 H0 : 500 H1 : 500
处理方法与(1)类似,具体程序如下:
x<-c(500,505,482,480,481,501,498,482, 490,481) #输入样本数据x
t.test(x,mu=500,alternative="less") #备择
t = -3.4912, df = 16, p-value = 0.9985
alternative hypothesis: true difference in means is greater than 0
95 percent confidence interval:
-343.1434 Inf
sample estimates:
平均使用寿命短?
2012-6-26
应用统计学第12章多元线性回归

∴该商品在该市下一年的年需求量的置信度为90% 的预测区间为
( yˆ0 d, yˆ0 d ) = (11.20万台,14.46万台)
15
2. 控制
在多元回归情况下,由于解释变量有多个,若控制
当模型中解释变量很多时,通常会存在较多的不显 著变量,以上步骤就非常繁琐。更为有效的方法是采 用“逐步回归”来求解多元线性回归方程。
9
逐步回归方法简介
逐步回归的基本思想是: 采用一定的评价标准,将解释变量一个一个地逐步 引入回归方程。每引进一个新变量后,都对方程 中的所有变量进行显著性检验,并剔除不显著的 变量,被剔除的变量以后就不再进入回归方程。 采用逐步回归方法最终所得到的回归方程与前述方 法的结果是一样的,但计算量要少得多。 在 SPSS 软件的线性回归功能中就提供了逐步回归 的可选项。
16
案例3的控制要求分析
假定下一年度居民家庭的年平均收入估计在 30000-31000元之间,若要以90%概率使该商品在 的年需求量不低于12万台,问应将价格控制在什 么范围内?。 解:此问题仍是单测控制问题,即要控制 X1 的取值
范围,使 P{yˆ d 12} 0.90
其中 d t (N P 1) SE /(N P 1) = t0.1(7)×0.8618 = 1.2194
d t /2(N P 1) SE / (N P 1)
14
案例3的预测分析
预计下一年度该商品的价格水平为1800元,家庭 年平均收入为30000元,求该商品年需求量的置信 度为90%的预测区间。 解:由所得回归方程,可求得
yˆ0 11.167 1.903 1.8 0.1695 30 12.83
第12章多元统计分析第四版
2020/9/13
中国人民大学六西格玛质量管理研究中心
9
目录 上页 下页 返回 结束
§12.1 联合分析的基本理论和方法
2020/9/13
中国人民大学六西格玛质量管理研究中心
10
目录 上页 下页 返回 结束
§12.1 联合分析的基本理论和方法
根据表12-1中对属性和水平的描述,调查中若采取析因设计, 将有729种组合,受测者无法对729种组合做出理性判断并一一 排序。这里需要找到一个合适的子集来代替全集,并且保持了 全集的某些性质。当属性个数或水平数较多时,析因设计会产 生大量的组合,令受测者无法对其一一排序。部分析因设计 (fractional factorial design)是最常用的定义受测体子集的方法。 部分析因设计选择可能的受测体的一个样本,受测体的数目取 决于将定于受测者使用的合成原则。通常我们可以采用对称正 交设计(一个因子中的每个水平出现相同的次数、水平与属性之 间没有相关关系。)。有关试验设计的部分参见文献[6]、[7]。本 例中的对称正交设计的结果如表12-2所示。
2020/9/13
中国人民大学六西格玛质量管理研究中心
4
目录 上页 下页 返回 结束
§12.1 联合分析的基本理论和方法
M.安蒂拉(M.Anttila)等人曾指出联合分析具有以下优点: (1)联合分析既可以分析度量属性(如价格)的重要性,又可 以分析非度量属性(如品牌名称)的重要程度;(2)资料收集 的程序简单易行,受测者只需要对受测体组合进行排序(Rank)或 者评分(Score)。联合分析对受测者只做很少的要求,就可得到相 当可靠的资料;(3)联合分析要求受测者考虑各个属性之间的 兑换(trade-off),比直接询问受测者其理想点(ideal-point) 的属性水平及属性重要性要来得实际;(4)联合分析所求出的 成分效用值可供做尺度不同的属性或是更基本的非度量属性的直 接比较,而这些比较因素正是人们选购决策所面临的真实问题。
南开大学生物统计学课件第12章 实验设计
第12章 实验设计:四、单因素实验设计
3、拉丁方设计(Latin square design) 在现实中,同一区组内的条件未必完全一致,为
A D 了克服之,采用拉丁方设计。 B E C
❖ 具体做法是:安排每一处理在每一行上出现一次,
同时在每一列上出现D一次,A且每行C和每B列只能E出现一
计划书格式:实验方法的确定
❖实验仪器和设备: 列出仪器和设备种类、数量、规
格和型号。 ❖实验材料的来源:
列出所需材料的种类、数量、生 产厂家、等级。 ❖实验流程:每一步干什么。 ❖经费核算:
第12章 实验设计:二、实验计划书的格式
计划书格式:田间规划
❖ 实验地点的选择: ❖ 土壤肥力勘测: ❖ 隔离区的设置: ❖ 保护行的设置:实验地周围种3-5行其他作物。 ❖ 水源:漫灌、喷灌或滴灌。 ❖ 田间规划:绘制田间规划图,标明实验地的
❖ 随机化:是指实验材料(个体)的配置和实验处理 的顺序都是随机确定的。
第12章 实验设计:二、实验计划书的格式
二、实验计划书的格式
➢ 封面:实验名称、计划书编制者名称
➢ 国内外研究动态 ➢ 实验目的
立项项目前人是否已经做过? 现在是否有人在做?已经得 到那些结论?存在的问题?
见 ➢ 预期结果 后 ➢ 实验设计的选择
坐落位置以及小区的划分和小区编号。 ❖ 小区划分:确定小区面积,划章 实验设计:三、简单实验设计
三、简单实验设计
把只有一个因素、两个处理(水平)的实验设 计称为简单实验设计。
我们学过:把检验两个不相关的样本是否来自 具有相同均值的总体的t检验称为独立样本t检验; 把检验两个相关的样本是否来自具有相同均值的总 体的t检验称为配对t检验。
应用统计学课后习题答案
《应用统计学》习题解答第一章绪论【1.1】指出下列变量的类型:(1)汽车销售量;(2)产品等级;(3)到某地出差乘坐的交通工具(汽车、轮船、飞机);(4)年龄;(5)性别;(6)对某种社会现象的看法(赞成、中立、反对)。
【解】(1)数值型变量(2)顺序变量(3)分类变量(4)数值型变量(5)分类变量(6)顺序变量【1.2】某机构从某大学抽取200个大学生推断该校大学生的月平均消费水平。
要求:(1)描述总体和样本。
(2)指出参数和统计量。
(3)这里涉及到的统计指标是什么?【解】(1)总体:某大学所有的大学生样本:从某大学抽取的200名大学生(2)参数:某大学大学生的月平均消费水平统计量:从某大学抽取的200名大学生的月平均消费水平(3)200名大学生的总消费,平均消费水平【1.3】下面是社会经济生活中常用的统计指标:①轿车生产总量,②旅游收入,③经济发展速度,④人口出生率,⑤安置再就业人数,⑥全国第三产业发展速度,⑦城镇居民人均可支配收入,⑧恩格尔系数。
在这些指标中,哪些是数量指标,哪些是质量指标?如何区分质量指标与数量指标?【解】数量指标有:①、②、⑤质量指标有:③、④、⑥、⑦、⑧数量指标是说明事物的总规模、总水平或工作总量的指标,表现为绝对数的形式,并附有计量单位。
而质量指标是说明总体相对规模、相对水平、工作质量和一般水平的统计指标,通常是两个有联系的统计指标对比的结果。
【1.4】某调查机构从某小区随机地抽取了50为居民作为样本进行调查,其中60%的居民对自己的居住环境表示满意,70%的居民回答他们的月收入在6000元以下,生活压力大。
回答以下问题:(1)这一研究的总体是什么?(2)月收入是分类变量、顺序变量还是数值型变量?(3)对居住环境的满意程度是什么变量?【解】(1)这一研究的总体是某小区的所有居民。
(2)月收入是数值型变量(3)对居住环境的满意程度是顺序变量。
第二章统计数据的搜集【2.1】从统计调查对象包括的范围、调查登记时间是否连续、搜集资料的方法是否相同等方面,对以下统计调查实例分类,并指出各属于那种统计调查方式。
应用统计学课后习题和参考答案解析
应用统计学课后习题与参考答案第一章一、选择题1.一个统计总体(D)。
A.只能有一个标志 B.只能有一个指标C.可以有多个标志 D.可以有多个指标2.对100名职工的工资收入情况进行调查,则总体单位是(D)。
A.100名职工 B.100名职工的工资总额C.每一名职工 D.每一名职工的工资 3.某班学生统计学考试成绩分别为65分、72分、81分和87分,这4个数字是(D)。
A.指标 B.标志C.变量 D.标志值4.下列属于品质标志的是(B)。
A.工人年龄 B.工人性别C.工人体重 D.工人工资5.某工业企业的职工数、商品销售额是(C)。
A.连续变量 B.离散变量C.前者是离散变量,后者是连续变量 D.前者是连续变量,后者是离散变量 6.下面指标中,属于质量指标的是(C)。
A.全国人口数 B.国内生产总值C.劳动生产率 D.工人工资7.以下指标中属于质量指标的是(C)。
A.播种面积 B.销售量C.单位成本 D.产量8.下列各项中属于数量指标的是(B)。
A.劳动生产率 B.产量C.人口密度 D.资金利税率二、简答题1.一项调查表明,消费者每月在网上购物的平均花费是200元,他们选择在网上购物的主要原因是“价格便宜”。
(1)这一研究的总体是什么?总体是“所有的网上购物者”。
(2)“消费者在网上购物的原因”是定类变量、定序变量还是数值型变量?分类变量。
(3)研究者所关心的参数是什么?所有的网上购物者的月平均花费。
(4)“消费者每月在网上购物的平均花费是200元”是参数还是统计量?统计量。
(5)研究者所使用的主要是描述统计方法还是推断统计方法?推断统计方法。
2.要调查某商场销售的全部冰箱情况,试指出总体、个体是什么?试举若干品质标志、数量标志、数量指标和质量指标。
总体:该商店销售的所有冰箱。
总体单位:该商店销售的每一台冰箱。
品质标志:型号、产地、颜色。
数量标志:容量、外形尺寸;数量指标:销售量、销售额。
质量指标:不合格率、平均每天销售量、每小时电消耗量。