
hadoop生态圈
slave slave
slave slave
slave slave zookeeper
proxy
Hadoop client Hbase client Zookeeper client
Pig Hive
zookeeper zookeeper
Flume汇 Oozie Server
Flume源 Oozie client mahout
HBase
实例
①假定Mysql里有member表,要求使用HBase的shell接口,在HBase中新建并存储此表 ②简述HBase是否适合存储问题①中的结构化数据
身份id 201401 201402 201403 姓名 性别 年龄 教育 职业 收入
aa bb cc
0 1 1
21 22 23
e0 e1 e2
cProxy
功能好熟悉
和Pig有和区别
1.编写MR程序 2.组织处理流
iClient
Hive
是什么
Hive是一个构建在hadoop上的数据仓库框架
cSlave2
cMaster
cSlave0
Hive向hadoop提交任务
概 念 工 作 过 程
Hive会将写好的数 据流处理脚本翻 译成多个Hdfs, Map和Reduce操作 向Hive提交任务 程序员或分析师 根据业务逻辑写 好数据流脚本
Hive
为什么
cSlave2
Hive起源于Facebook内部信息处理平台。由于需 要处理大量新兴社会网络数据,考虑到扩展性, Facebook最终选择hadoop作为存储和处理平台 现 实 需 求
cMaster
cSlave0
cSlave1
Hive的设计目的即是让Facebook内精通SQL的分析 师能够以类SQL的方式查询存放在HDFS的大规模 数据集 提交任务
例 题
cMaster
cSlave0 cSlave2
iClient
cProxy
cSlave1
Zookeeper
为什么
部 分 失 败 现 实 需 求
zookeeper
当一条消息在网络中的两个节点之间传送时,由于可能会出现各 种问题,发送者无法知道接收者是否已经接收到这条消息,比如 在接收者还未接收到消息前,发生网络中断,再比如接收者接收 到消息后发生网络中断,甚至是接收进程死掉。发送者能够获取 真实情况的唯一途径是重新连接接收者,并向它发出询问。
是什么
是一个高可靠性、高性能、列存储、可伸缩、实时读写的分布式数据库系统
适合于存储非结构化数据 概 念
基于列的而不是基于行的模式
HBase架构在hadoop之上
怎么架构在hadoop之上
HBase架构
HBase
是什么
Zookeeper
HMaster
iClient
HRegionServer HRegion Store
cProxy
MapReduce
实例
cSlave0
yum install hadoop-mapreduce
cSlave1
部 署
cSlave2
yum install hadoop-mapreduce-historyserver
cProxy
MapReduce
实例
①使用WordCount,统计input目录下文件里单词出现次数 ②使用Grep程序,查询input下所有文件里,以dfs开头且中间字母a到z的单词
iClient
cSlave1
Hive
cProxy
Hive
是什么
cSlave2
cMaster
cSlave0
架 构
cSlave1
Hive
cProxy
Hive
是什么-语法
数据类型 基本类型:数值型、布尔型、字符串 复杂类型:ARRAY、MAP和STRUCT
操作符 语 法
关系操作:如x='a' 算术操作:加法x+1 逻辑操作:如逻辑或x or y
HLog
MemStore MemStore
HRegionServer HRegion Store
HLog
MemStore MemStore
架 构
StoreFile
Hfile
StoreFile
Hfile
StoreFile
Hfile
StoreFile
Hfile
StoreFile
Hfile
StoreFile
cMaster
cSlave0
现 实 需 求 2006年谷歌发表论文BigTable, 年末、微软旗下自然语言搜索 公司Powerset出于处理大数据 的需求,按论文思想,开启了 HBase项目 在 线 访 问 在线 实时 服务
Hbase
cProxy
cSlave1
分布式 数据库
iClient
HBase
运算符 语 法
操作名称 LOAD FOREACH
功能 载入待处理数据 逐行处理Tuple 过滤不满足条件的Tuple 将结果打印到屏幕 将结果保存到文件
函数
FILTER DUMP STORE
Pig
实例
部 署
iClient
yum install pig
例 题
①使用Pig Latin实现WordCount
例 题
①分别使用命令行接口和API接口向zookeeper存储树中新建一 节点并存入信息 ②假设机器cSlave0上有进程Pa,机器cSlave2上有进程Pb,使 用zookeeper实现进程Pa与Pb相互协作
HBase
为什么
cSlave2
客户欲实 时读HDFS 里数据
太 慢
缓存机制 索引机制
iClient
为什么-是什么
程序员 使用MR 处理 HDFS里 数据
cSlave2
cMaster
cSlave0
1.编写MR程序 2.组织处理流
1.太慢 2.要求高
现 实 需 求 概 念
cSlave1
cProxy
Pig是用来 处理大规模 数据集的脚 本语言平台
提交任务 程序员使用Pig脚本指挥 HDFS、MapReduce 1.编写MR程序 2.组织处理流
例 题
cMaster
cSlave0 cSlave2
iClient
cProxy
cSlave1
Yarn
实例
yum install hadoop-yarn-resourcemanager
cMaster
部 署
cSlave0
hadoop-yarn-nodemanager
cSlave1
cSlave2
yum install hadoop-yarn-proxyserver
zookeeper
概 念
iSend
iReceive iSend iReceive
Zookeeper典型应用-工作过程
Zookeeper
架构
工作原理:Paxos算法
z3 z1
架 构
z2
iSend
iReceive
Zookeeper
实例
cSlave0 cSlave1 cSlave2
部 署
yum install zookeeper-server
HiveQL:SQL类似
函数
Hive内置了上百个函数 基本同SQL一样
count like Rank ------map子句 reduce子句
Hive
实例
部 署 方 式
Hive
实例
部 署
iClient
yum install hive
①在hive里新建member表,并将表6-6中的数据载入hive里的member表中 ②查询member表中所有记录;查询member表中gender值为1的记录;查询member 表中gender值为1且age为22的记录;统计member中男性和女性出现次数 ③试比较pig中“单词计数”和“统计男女出现次数”异同点 例 题
Pig
是什么
cSlave2
cMaster
cSlave0
Pig Latin 解释器 架 构 Pig Latin 环境
Pig
cProxy
cSlave1
Pig
是什么
(1)基本数据类型:int、long、float、double、chararray和bytearray (2)复杂数据类型:字符串或基本类型与字符串的组合 (1)算术运算符:+,-,*,/,% (2)三目运算符:?: (3)比较运算符:==,!= 数据类型
iClient
Pig
是什么
cSlave2
Pig向hadoop提交任务 Pig会将写好的数 据流处理脚本翻 译成多个Hdfs, Map和Reduce操作 向Pig提交任务 程序员或分析师 根据业务逻辑写 好数据流脚本
iCe0
工 作 过 程
cSlave1
Pig
cProxy
实题
为什么
是什么
技术角度:概念、架构
7. Hive
实战:部署、例题
8. Oozie
3.MapReduce模板
相关约定
系统 JDK 集群 客户端 执行例题的机器 CentOS-6.4 64bit jdk-7u45-linux-x64.rpm cMaster、cSlave0、cSlave1、cSlave2、cProxy iClient iClient
Hfile
DFSClient
DFSClient
Hadoop
DataNode DataNode DataNode DataNode DataNode DataNode
hadoop生态圈处理数据的流程
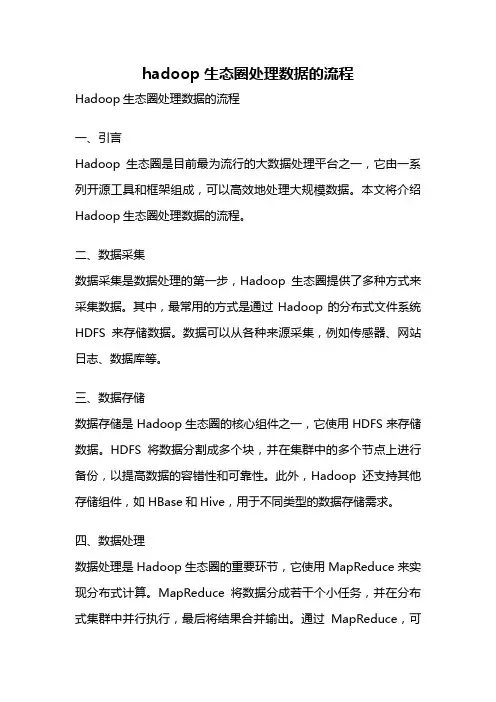
hadoop生态圈处理数据的流程Hadoop生态圈处理数据的流程一、引言Hadoop生态圈是目前最为流行的大数据处理平台之一,它由一系列开源工具和框架组成,可以高效地处理大规模数据。
本文将介绍Hadoop生态圈处理数据的流程。
二、数据采集数据采集是数据处理的第一步,Hadoop生态圈提供了多种方式来采集数据。
其中,最常用的方式是通过Hadoop的分布式文件系统HDFS来存储数据。
数据可以从各种来源采集,例如传感器、网站日志、数据库等。
三、数据存储数据存储是Hadoop生态圈的核心组件之一,它使用HDFS来存储数据。
HDFS将数据分割成多个块,并在集群中的多个节点上进行备份,以提高数据的容错性和可靠性。
此外,Hadoop还支持其他存储组件,如HBase和Hive,用于不同类型的数据存储需求。
四、数据处理数据处理是Hadoop生态圈的重要环节,它使用MapReduce来实现分布式计算。
MapReduce将数据分成若干个小任务,并在分布式集群中并行执行,最后将结果合并输出。
通过MapReduce,可以高效地处理大规模数据,并实现各种复杂的数据分析和挖掘操作。
五、数据查询与分析Hadoop生态圈提供了多种工具和框架来进行数据查询和分析。
其中,最常用的是Hive和Pig。
Hive提供了类似于SQL的查询语言,可以将结构化数据映射到Hadoop集群上,并进行复杂的查询和分析。
Pig则提供了一种类似于脚本的语言,可以用于数据的提取、转换和加载等操作。
六、数据可视化数据可视化是将处理后的数据以图形化的方式展示出来,以便更好地理解和分析数据。
Hadoop生态圈提供了多种工具和框架来实现数据可视化,如Tableau和D3.js等。
这些工具可以将数据转化为直观、易于理解的图表和图形,帮助用户更好地理解和分析数据。
七、数据存储与管理在数据处理过程中,需要对数据进行存储和管理。
Hadoop生态圈提供了多种存储和管理工具,如HBase和ZooKeeper等。
01第一章 初识Hadoop大数据技术
第1章初识Hadoop大数据技术本章主要介绍大数据的时代背景,给出了大数据的概念、特征,还介绍了大数据相关问题的解决方案、Hadoop大数据技术以及Hadoop的应用案例。
本章的主要内容如下。
(1)大数据技术概述。
(2)Google的三篇论文及其思想。
(3)Hadoop概述。
(4)Hadoop生态圈。
(5)Hadoop的典型应用场景和应用架构。
1.1 大数据技术概述1.1.1 大数据产生的背景1946年,计算机诞生,当时的数据与应用紧密捆绑在文件中,彼此不分。
19世纪60年代,IT系统规模和复杂度变大,数据与应用分离的需求开始产生,数据库技术开始萌芽并蓬勃发展,并在1990年后逐步统一到以关系型数据库为主导,具体发展阶段如图1-1所示。
Hadoop 大数据技术与应用图1-1 数据管理技术在2001年前的两个发展阶段 2001年后,互联网迅速发展,数据量成倍递增。
据统计,目前,超过150亿个设备连接到互联网,全球每秒钟发送290万封电子邮件,每天有2.88万小时视频上传到YouTube 网站,Facebook 网站每日评论达32亿条,每天上传照片近3亿张,每月处理数据总量约130万TB 。
2016年全球产生数据量16.1ZB ,预计2020年将增长到35ZB (1ZB = 1百万,PB = 10亿TB ),如图1-2所示。
图1-2 IDC 数据量增长预测报告2011年5月,EMC World 2011大会主题是“云计算相遇大数据”,会议除了聚焦EMC 公司一直倡导的云计算概念外,还抛出了“大数据”(BigData )的概念。
2011年6月底,IBM 、麦肯锡等众多国外机构发布“大数据”相关研究报告,并予以积极的跟进。
19世纪60年代,IT 系统规模和复杂度变大,数据与应用分离的需求开始产生,数据库技术开始萌芽并蓬勃发展,并在1990年后逐步统一到以关系型数据库为主导1946年,计算机诞生,数据与应用紧密捆绑在文件中,彼此不分1946 1951 1956 1961 1970 1974 1979 1991 2001 … 网络型E-RSQL 关系型数据库 数据仓库 第一台 计算机 ENIAC 面世 磁带+ 卡片 人工 管理 磁盘被发明,进入文件管理时代 GE 公司发明第一个网络模型数据库,但仅限于GE 自己的主机 IBM E. F.Dodd 提出关系模型 SQL 语言被发明 ORACLE 发布第一个商用SQL 关系数据库,后续快速发展数据仓库开始涌现,关系数据库开始全面普及且与平台无关,数据管理技术进入成熟期 0.8ZB :将一堆DVD 堆起来够地球到月亮一个来回 35ZB :将一堆DVD 堆起来是地球到火星距离的一半IDC 报告“Data Universe Study ”预测:全世界数据量将从2009年的0.8ZB 增长到2020年的35ZB ,增长44倍!年均增长率>40%!1.1.2 大数据的定义“大数据”是一个涵盖多种技术的概念,简单地说,是指无法在一定时间内用常规软件工具对其内容进行抓取、管理和处理的数据集合。
大数据开发工程师招聘笔试题与参考答案(某大型国企)2024年

2024年招聘大数据开发工程师笔试题与参考答案(某大型国企)(答案在后面)一、单项选择题(本大题有10小题,每小题2分,共20分)1、以下哪个技术栈是大数据开发工程师常用的核心技术栈之一?A、Java + Hadoop + SparkB、Python + Pandas + NumPyC、C++ + Redis + KafkaD、JavaScript + React + Node.js2、在大数据生态中,以下哪个组件用于实现数据仓库的构建?A、HiveB、HBaseC、ElasticsearchD、Kafka3、某大型国企在进行数据仓库设计时,需要考虑数据仓库的以下哪些特点?(多选)A、数据仓库是面向主题的B、数据仓库是集成的C、数据仓库是非易失的D、数据仓库是实时更新的4、在数据仓库的ETL(Extract, Transform, Load)过程中,以下哪个步骤属于数据转换阶段?(单选)A、数据抽取B、数据清洗C、数据加载D、数据映射5、在以下关于Hadoop的描述中,哪项是错误的?A、Hadoop是一个开源的分布式计算框架,用于处理大规模数据集。
B、Hadoop使用MapReduce编程模型来处理数据。
C、Hadoop的存储系统是HDFS(Hadoop Distributed File System),它不保证数据的原子性。
D、Hadoop的主要组件包括HDFS、MapReduce、YARN和ZooKeeper。
6、以下哪个不是Spark的组件?A、Spark SQLB、Spark StreamingC、Spark MLlibD、Hadoop YARN7、某大型国企的数据仓库中包含了一个用户行为数据表,该表记录了用户在平台上的浏览、购买等行为。
以下关于该数据表的说法,正确的是:A、该数据表应该是时序数据库,因为记录了用户的行为时间序列。
B、该数据表应该是文档数据库,因为存储了用户的具体行为描述。
大数据处理之 Hadoop 原理与应用介绍

Input
Input Data:
A DD BB A BB A
Map Task Map
Map
0,A 1,DD
A,1 DD,1
Reduce Task
Shuffle & Sort
Reduce
map, sort, combiner, partition, spill, merge
copy partition data A,[1, 1, 1]
1、问题:
有如下数据,字段内容分别为:url,catePath0,catePath1,catePath2,unitparams
https:///confluence 0 1 8 {"store":{"fruit":[{"weight":1,"type":"apple"},{"weight":9,"type":"pear"}],"bicycle":{"price":19.951,"color":"red1"}},"email":" amy@only_for_json_udf_","owner":"amy1"} /leejun2005/blog/83058 0 1 23 {"store":{"fruit":[{"weight":1,"type":"apple"},{"weight":2,"type":"pear"}],"bicycle":{"price":19.951,"color":"red1"}},"email":"
使用Ambari快速部署Hadoop大数据环境

作者:杨鑫奇前言做大数据相关的后端开发工作一年多来,随着Hadoop社区的不断发展,也在不断尝试新的东西,本文着重来讲解下Ambari,这个新的Apache的项目,旨在让大家能够方便快速的配置和部署Hadoop生态圈相关的组件的环境,并提供维护和监控的功能.作为新手,我讲讲我自己的学习经历,刚刚开始学习的时候,当然最简单的 Google 下Hadoop ,然后下载相关的包,在自己的虚拟机(CentOS 6.3) 上安装一个单机的Hadoop版本用来做测试,写几个测试类,然后做下CRUD测试之类的,跑跑Map/Reduce的测试,当然这个时候对于Hadoop还不是很了解,不断的看别人的文章,了解下整体的架构,自己所做的就是修改conf下的几个配置文件,让Hadoop能够正常的跑起来,这个时候几种在修改配置上,这个阶段之后,又用到了HBase,这个Hadoop生态圈的另外一个产品,当然还是修改配置,然后 start-all.sh , start-hbase.sh 把服务起起来,然后就是修改自己的程序,做测试,随着用Hbase 学了下 Zookeeper 和Hive等, 接着过了这个操作阶段了之后,开始研究Hadoop2.0看了董的博客的相关文章,还有CSDN上很多大牛的文章了之后, 算是对Hadoop的生态圈整体有一些了解,介于自己在公司所承担的开发所涉及到相关的技术仅仅就这些.但是作为一个爱好探索的人,是否想多了解下呢,它的性能怎么样? 它是具体如何运作的? 看大公司的那些PPT,人家(淘宝等大公司)动不动就是几十个,几百个,乃至几千个节点,人家是如何管理的,性能是怎么样的?看着PPT里面的那些性能测试的曲线,你是否也能够详细的了解,并且对自己的项目进行性能调优呢? 我貌似找到答案了,那就是 Ambari , 由HortonWorks开发的一个Hadoop相关的项目,具体可以上官方去了解.了解Hadoop生态圈现在我们经常看到的一些关键字有:HDFS,MapReduce,HBase,Hive,ZooKeeper,Pig,Sqoop,Oozie,Ganglia,Nagios,CDH3,CDH4,Flume,Scri be,Fluented,HttpFS等等,其实应该还有更多,Hadoop生态圈现在发展算是相当繁荣了,而在这些繁荣的背后又是谁在推动的呢? 读过Hadoop历史的朋友可能知道,Hadoop最早是始于Yahoo,但是现在主要是由 HortonWorks 和 Cloudera这2家公司在维护者,大部分的commiter 都属于这2家公司,所以现在市面上看到的主要有2个版本,CDH系列,和社区版, 我最早用的是社区版本,后来换到CDH3,现在又换回社区版,因为有Ambari.当然,用什么和不用什么,只要自己的技术到家,还是都能修改的跑的正常的.这里就不多说了. 讲了这么多废话了,开始讲 Ambari安装吧.开始部署首先了解下Ambari, 项目地址在:/ambari/安装文档在:/ambari/1.2.2/installing-hadoop-using-ambari/content/index.h tmlHortonWorks的人写的一篇介绍安装的文章我翻译了下:/scotoma/archive/2013/05/18/3085040.html安装的时候请大家先看下安装文档吧,安装文档必须认真看,结合自己当前所使用的系统版本,配置不同的源,而且安装过程中需要的时间相对比较长,所以需要认真的做好安装文档的每个步骤. 这里我就说我遇到的一些问题.以下说说我自己的安装过程.机器准备:我的测试环境采用 9 台 HP 的烂机器,分别是 cloud100 - cloud108 , cloud108做为管理节点.Ambari安装的环境路径:各台机器的安装目录:/usr/lib/hadoop/usr/lib/hbase/usr/lib/zookeeper/usr/lib/hcatalog/usr/lib/hiveLog路径, 这里需要看出错信息都可以在目录下找到相关的日志/var/log/hadoop/var/log/hbase配置文件的路径/etc/hadoop/etc/hbase/etc/hiveHDFS的存储路径/hadoop/hdfs安装过程需要注意的点:1, 安装的时候,需要做好每台机器的ssh免密码登陆,这个之前的文章/scotoma/archive/2012/09/18/2689902.html 中提到了,做好之后,从管理节点到各个集群节点之间,都能使用这个登陆.2, 如果你的机器之前安装过 Hadoop的相关服务,特别是Hbase 里面配置了 HBASE_HOME 的环境变量,需要 unset掉, 这个环境变量会影响,因为我之前把这些路径放到 /etc/profile 里面导致影响了HBase,因为Ambari安装的路径和你之前安装的可能不一样.3,在服务选择页面的时候, NameNode 和 SNameNode 需要布置在一起, 我之前尝试做 HA 而把他们分开,但是SNameNode一直起不来,导致整个启动失败,接下来时间需要花在HA上.4. JobTrakcer 不和Namenode在一起也会导致启动不起来.5. Datanode的节点不能少于 Block replication 中数, 基本都是需要 >= 3.6. Confirm Hosts 的时候,需要注意里面的 Warning 信息,把相关的Warning都处理掉,有一些Warning会导致安装出错.7. 记住安装中所新建的用户,接下来需要用到这些用户.8. Hive和HBase Master 部署在同一个节点,这里当然你也可以分开. 设置好后就开始安装了.9.如果安装失败的情况下,如何重新安装.首先,先删除掉系统已经安装的文件相关的目录,sh file_cp.sh cmd "rm -rf /usr/lib/hadoop && rm -rf /usr/lib/hbase && rm -rf/usr/lib/zookeeper"sh file_cp.sh cmd "rm -rf /etc/hadoop && rm -rf /etc/hbase && rm -rf /hadoop && rm -rf /var/log/hadoop"sh file_cp.sh cmd "rm -rf /etc/ganglia && rm -rf /etc/hcatalog && rm -rf /etc/hive && rm -rf /etc/nagios && rm -rf /etc/sqoop && rm -rf /var/log/hbase && rm -rf /var/log/nagios && rm -rf /var/log/hive && rm -rf /var/log/zookeeper && rm -rf /var/run/hadoop && rm -rf/var/run/hbase && rm -rf /var/run/zookeeper "再在Yum remove 掉安装的相关的包.sh file_cp.sh cmd "yum -y remove ambari-log4j hadoop hadoop-lzo hbase hive libconfuse nagios sqoop zookeeper"我这里使用到了自己写的Shell,方便在多台机器之间执行命令:https:///xinqiyang/opshell/tree/master/hadoop10.注意时间的同步,时间问题会导致regionserver起不来11. iptables 需要关闭,有的时候可能机器会重新启动,所以不单单需要 service stop 也需要chkconfig 关闭掉.最后安装完成后,登陆地址查看下服务的情况:http://管理节点ip:8080 , 比如我这里的: http://192.168.1.108:8080/ 登陆之后,需要设置之前在安装Ambari-server时候输入的账号和密码,进入查看 ganglia的监控查看 nagios 的监控测试安装完成后,看着这些都正常了,是否需要自己验证一下呢? 不过基本跑了冒烟测试后,正常的话,基本还是正常的,但是我们自己也得来操作下吧.验证HDFS验证Map/Reduce验证HBase验证Hive总结到这里,相关的 hadoop 及 hbase 及hive 的相关配置就都配置完成了,接下来需要做一些压力测试.还有其他方面的测试, 对于Ambari带的是 HortonWorks 打包的rpm版本的 Hadoop相关的源码,所以这里可能会和其他的版本有一些不同,但是作为开发环境来说,暂时还是没有很多大的影响的,但是现在还没有在生产上使用, 所以也不管说如何的稳定,接下来我会在开发项目的过程中,将所遇到的Bug给列出来. 总体来说Ambari还是很值得使用的,毕竟能够减少很多不必要的配置时间,而且相对在单机环境下, 在集群环境下更能贴近生产做一些相关的性能测试和调优测试等等,而且配置的ganglia和nagios的监控也能够发布的让我们查看到集群相关的数据,总体来说还是推荐使用的,新东西有Bug是在所难免的,但是在用的过程中我们会不断的完善. 接下来如果有时间,会对Ambariserver的功能进行扩展,添加诸如redis/nginx之类的常用的高性能模块的监控选项. 这个有时间在弄了. 总之,欢迎使用Ambari.分类: 基础配置, 云后端开发系列标签: Ambari, Hadoop集群快速安装, Ambari实践。
大数据产品经理招聘笔试题与参考答案(某世界500强集团)

招聘大数据产品经理笔试题与参考答案(某世界500强集团)(答案在后面)一、单项选择题(本大题有10小题,每小题2分,共20分)1、大数据产品经理在产品生命周期管理中,以下哪个阶段最关键?A. 需求分析B. 设计开发C. 测试上线D. 运营优化2、在数据挖掘过程中,以下哪种算法最适合处理分类问题?A. 聚类算法B. 关联规则算法C. 决策树算法D. 主成分分析3、在数据仓库中,以下哪个是数据仓库设计的重要原则?A. 数据的实时性B. 数据的精确性C. 数据的一致性D. 数据的可用性4、在Hadoop生态系统中,以下哪个组件主要用于实现分布式文件存储?A. HBaseB. HiveC. ZooKeeperD. HDFS5、在数据分析领域,以下哪个不是大数据处理的关键技术?A. 数据挖掘B. 分布式计算C. 数据清洗D. 数据可视化6、以下关于大数据产品经理的职责描述,不正确的是:A. 分析市场需求,制定产品战略B. 管理产品生命周期,推动产品迭代C. 搭建数据分析平台,提供数据支持D. 负责产品上线后的用户运营和推广7、某世界500强集团正在开发一款面向零售行业的大数据产品,以下哪项不是产品经理在需求分析阶段需要关注的关键因素?A、市场趋势分析B、用户画像构建C、技术可行性评估D、竞争对手分析8、在制定大数据产品原型设计时,以下哪种方法最适合用于验证用户的核心操作流程?A、专家评审B、A/B测试C、用户故事地图D、可用性测试9、大数据产品经理在产品设计中,以下哪个选项不属于数据驱动决策的关键要素?A. 用户需求分析B. 数据采集与清洗C. 数据可视化D. 硬件设备选择 10、某大数据产品经理在进行市场调研时,发现以下哪个指标最能反映用户对产品功能的满意度?A. 用户日活跃度B. 用户留存率C. 用户转化率D. 用户满意度调查结果二、多项选择题(本大题有10小题,每小题4分,共40分)1、以下哪些是大数据产品经理在产品生命周期中需要关注的阶段?()A、需求调研B、产品设计C、数据采集与处理D、产品测试E、产品上线与运维F、市场推广2、以下哪些工具和技术是大数据产品经理在工作中常用的?()A、Hadoop生态圈B、数据可视化工具C、SQL查询语言D、Python数据分析E、机器学习算法F、项目管理工具3、在构建数据产品时,以下哪些步骤是必要的?A、需求分析与定义B、数据收集与清洗C、模型训练与验证D、产品设计与开发E、用户反馈与迭代F、无需考虑数据隐私与合规性4、大数据技术栈中,以下哪些工具可以用于数据存储?A、Hadoop HDFSB、Apache KafkaC、Apache HBaseD、Apache SparkE、MySQL5、以下哪些是大数据产品经理在产品设计过程中需要考虑的关键因素?()A. 数据质量B. 用户需求C. 技术可行性D. 商业价值E. 法规合规6、在数据产品生命周期中,以下哪些阶段属于产品迭代优化阶段?()A. 市场调研B. 产品设计C. 上线测试D. 运营监控E. 用户反馈7、在构建大数据产品时,以下哪些步骤对于确保产品的成功至关重要?A. 数据收集与清洗B. 数据分析与挖掘C. 用户界面设计D. 用户体验测试E. 数据安全与隐私保护F. 仅关注技术实现而忽略用户体验8、关于大数据在产品管理中的应用,下列说法正确的是:A. 大数据可以用来预测市场趋势B. 大数据能帮助公司了解客户行为模式C. 大数据仅能用于历史数据分析,无法提供实时洞察D. 利用大数据可以个性化推荐服务给客户E. 大数据的应用能够减少决策过程中的不确定性F. 大数据在任何情况下都能保证决策的准确性9、以下哪些技术栈是大数据产品经理在设计和开发大数据产品时常用的?()A. Hadoop生态系统(如HDFS、MapReduce、Hive等)B. Spark生态系统(如Spark SQL、Spark Streaming等)C. NoSQL数据库(如MongoDB、Cassandra等)D. SQL数据库(如MySQL、PostgreSQL等)E. 容器技术(如Docker、Kubernetes等) 10、以下哪些是大数据产品经理在评估大数据解决方案时需要考虑的因素?()A. 数据存储和处理的性能B. 数据安全和隐私保护C. 系统的可扩展性和高可用性D. 成本效益分析E. 用户体验和易用性三、判断题(本大题有10小题,每小题2分,共20分)1、数据仓库是一个面向主题的、集成的、相对稳定的、反映历史变化的数据集合,用于支持管理决策。
大数据开发工程师招聘笔试题与参考答案2025年
2025年招聘大数据开发工程师笔试题与参考答案(答案在后面)一、单项选择题(本大题有10小题,每小题2分,共20分)1、在大数据处理中,以下哪个技术或框架主要用于实时数据流处理?A. HadoopB. SparkC. KafkaD. Flink2、在大数据存储中,HDFS(Hadoop Distributed File System)的设计目标是?A. 提供低延迟的数据访问B. 支持随机读写操作C. 提供高吞吐量的数据访问D. 适用于小型数据集3、题干:以下哪种数据结构最适合存储大规模数据集,并支持快速的数据检索?A. 数组B. 链表C. 树D. 哈希表4、题干:在分布式系统中,以下哪个组件负责处理数据分片和分布式事务?A. 数据库B. 应用服务器C. 分布式文件系统D. 分布式数据库中间件5、大数据开发工程师在处理大规模数据集时,通常使用的分布式文件系统是:A. HDFS(Hadoop Distributed File System)B. NFS(Network File System)C. SMB(Server Message Block)D. APFS(Apple File System)6、在数据仓库中,用于存储元数据的表通常被称为:A. fact table(事实表)B. dimension table(维度表)C. lookup table(查找表)D. metadata table(元数据表)7、大数据开发工程师在处理海量数据时,以下哪种技术通常用于数据存储和管理?A. 关系型数据库B. NoSQL数据库C. 文件系统D. 数据库管理系统8、在大数据技术中,以下哪个组件通常用于实现数据流处理?A. Hadoop MapReduceB. Apache KafkaC. Apache SparkD. Apache HBase9、在Hadoop生态系统中,用于进行分布式存储的是哪一个组件?A. HDFSB. YARNC. MapReduceD. Hive 10、以下哪个算法不是机器学习中的监督学习算法?A. 支持向量机(SVM)B. 决策树C. 深度学习D. K-均值聚类二、多项选择题(本大题有10小题,每小题4分,共40分)1、以下哪些技术或工具通常用于大数据开发?()A、Hadoop HDFSB、Spark SQLC、MongoDBD、ElasticsearchE、MySQL2、以下哪些算法或模型在机器学习的大数据处理中应用广泛?()A、K-Means聚类B、决策树C、神经网络D、朴素贝叶斯E、线性回归3、关于大数据开发工程师所需掌握的技术栈,以下哪些技术是必要的?()A. Hadoop生态系统(包括HDFS、MapReduce、Hive等)B. Spark大数据处理框架C. NoSQL数据库(如MongoDB、Cassandra)D. 关系型数据库(如MySQL、Oracle)E. 容器技术(如Docker)4、以下关于大数据处理流程的描述,哪些是正确的?()A. 数据采集是大数据处理的第一步,需要从各种数据源获取原始数据。
《OpenStack云平台实战》课程测试试卷-1
《OpenStack云平台实战》课程测试试卷说明:本试卷由选择题和简答题两部分组成,满分100分。
一、选择题说明:共30题,每题2分,共计60分。
针对以下题目,请选择最符合题目要求的答案。
针对每一道题目,所有答案都选对,则该题得分,所选答案错误或不能选出所有答案,则该题不得分。
1.OpenStack中有关Dashboard的描述正确的是()。
A.Dashboard提供OpenStack认证服务B.Dashboard提供OpenStack存储服务C.Dashboard提供Web管理界面D.Packstack部署OpenStack后,Dashboard需要单独安装2.下列()不属于OpenStack资源池。
A.计算资源B. 存储资源C. 网络资源D. 软件资源3.下列()属于云计算模型中SaaS具有的功能。
A.提供IT基础设施服务,用户可从中获取虚拟硬件资源B.可直接通过互联网为用户提供软件和应用程序服务C.用户可通过租赁方式获取安装在供应商那里的软件D.用户可在其上安装其他应用程序4.在192.168.8.8机器上面通过packstack一键安装了OpenStack,可以通过()访问web页面。
A.http://192.168.8.8/webB.http://192.168.8.8/dashboardC.http://192.168.8.8/horizonD.http://192.168.8.8/index5.OpenStack存储服务通过()组件实现。
A.CinderB.NeutronC.KeystoneD.Nova6.下列关于Keystone的说法错误的是()。
A.认证服务通过对用户身份的确认,来判断一个请求是否被允许B.OpenStack中的一个项目可以有多个用户,一个用户只属于一个项目C.全局的角色适用于所有项目中的资源权限,而项目内的角色只适合自己项目内的权限D.令牌是一串数字字符串,用于访问服务的API以及资源7.下列()是glance不支持的镜像格式。
大数据开发工程师招聘笔试题与参考答案(某世界500强集团)2025年
2025年招聘大数据开发工程师笔试题与参考答案(某世界500强集团)(答案在后面)一、单项选择题(本大题有10小题,每小题2分,共20分)1、以下哪项不是大数据开发工程师常用的编程语言?A. JavaB. PythonC. C++D. SQL2、在Hadoop生态系统中,以下哪个组件用于数据存储?A. Hadoop MapReduceB. Hadoop YARNC. Hadoop HDFSD. Hadoop Hive3、题干:以下哪种技术不是大数据处理中常用的分布式存储技术?A、Hadoop HDFSB、CassandraC、MySQLD、HBase4、题干:在Hadoop生态系统中,以下哪个组件主要用于实现流式计算?A、Hadoop MapReduceB、HiveC、Spark StreamingD、HBase5、以下哪种技术不属于大数据处理框架?A. HadoopB. SparkC. MongoDBD. Kafka6、以下哪种算法不适合用于大数据处理?A. MapReduceB. K-meansC. 决策树D. 回归分析7、在大数据处理中,以下哪个技术通常用于数据的实时处理?A. Hadoop MapReduceB. Spark StreamingC. ElasticsearchD. Hive8、以下哪种数据库管理系统适合用于大数据应用场景?A. MySQLB. PostgreSQLC. MongoDBD. Oracle9、在以下关于Hadoop生态系统组件的描述中,哪一个是负责处理海量数据的分布式存储系统?A. Hadoop MapReduceB. Hadoop HDFSC. Hadoop YARND. Hadoop Hive 10、在数据分析中,以下哪个工具主要用于数据清洗和预处理?A. PandasB. Scikit-learnC. TensorFlowD. Keras二、多项选择题(本大题有10小题,每小题4分,共40分)1、以下哪些技术栈是大数据开发工程师在项目中可能会使用的?()A、Hadoop生态圈(HDFS、MapReduce、Hive等)B、Spark生态圈(Spark SQL、Spark Streaming等)C、JavaD、PythonE、SQL2、以下哪些是大数据处理中常见的算法?()A、数据清洗算法B、数据挖掘算法C、机器学习算法D、分布式算法E、优化算法3、以下哪些技术是大数据处理中常用的分布式计算框架?()A、HadoopB、SparkC、FlinkD、MapReduceE、Drools4、以下哪些是大数据开发工程师需要掌握的编程语言?()A、JavaB、PythonC、ScalaD、SQLE、Shell5、以下哪些技术是大数据开发工程师在数据仓库设计中需要熟悉的?()A. ETL(Extract, Transform, Load)B. SQLC. NoSQLD. Hadoop6、大数据开发工程师在进行数据清洗时,以下哪些步骤是必要的?()A. 去除重复数据B. 处理缺失值C. 数据标准化D. 数据转换E. 数据校验7、以下哪些技术或工具通常用于大数据开发?()A. HadoopB. SparkC. MySQLD. KafkaE. Python8、大数据开发中,以下哪些是数据挖掘和分析常用的算法?()A. 决策树B. 聚类算法C. 支持向量机D. 主成分分析E. 时间序列分析9、以下哪些技术栈是大数据开发工程师在项目中常用的?()A. Hadoop生态圈(HDFS, MapReduce, YARN等)B. Spark生态圈(Spark Core, Spark SQL, Spark Streaming等)D. ElasticsearchE. Docker 10、以下关于大数据开发工程师的职责描述,正确的是?()A. 负责大数据平台的设计、开发和优化B. 负责数据采集、存储、处理和分析C. 负责数据挖掘和机器学习算法的应用D. 负责编写和维护数据可视化工具E. 负责大数据项目的前期规划和后期评估三、判断题(本大题有10小题,每小题2分,共20分)1、大数据开发工程师在数据处理时,通常使用Hadoop作为分布式存储和处理平台,而Hadoop的MapReduce编程模型是最核心的计算模型。
Hadoop核心概念及入门
Hadoop核⼼概念及⼊门HadoopHadoop背景什么是HADOOPHADOOP是apache旗下的⼀套开源软件平台HADOOP提供利⽤服务器集群,根据⽤户的⾃定义业务逻辑,对海量数据进⾏分布式处理,HADOOP的核⼼组件有:HDFS(分布式⽂件系统)、YARN(运算资源调度系统)、MAPREDUCE(分布式运算编程框架),⼴义上来说,HADOOP通常是指⼀个更⼴泛的概念——HADOOP⽣态圈HADOOP产⽣背景HADOOP最早起源于Nutch。
Nutch的设计⽬标是构建⼀个⼤型的全⽹搜索引擎,包括⽹页抓取、索引、查询等功能,但随着抓取⽹页数量的增加,遇到了严重的可扩展性问题——如何解决数⼗亿⽹页的存储和索引问题。
2003年、2004年⾕歌发表的两篇论⽂为该问题提供了可⾏的解决⽅案。
——分布式⽂件系统(GFS),可⽤于处理海量⽹页的存储——分布式计算框架MAPREDUCE,可⽤于处理海量⽹页的索引计算问题。
Nutch的开发⼈员完成了相应的开源实现HDFS和MAPREDUCE,并从Nutch中剥离成为独⽴项⽬HADOOP,到2008年1⽉,HADOOP成为Apache顶级项⽬,迎来了它的快速发展期。
HADOOP在⼤数据、云计算中的位置和关系云计算是分布式计算、并⾏计算、⽹格计算、多核计算、⽹络存储、虚拟化、负载均衡等传统计算机技术和互联⽹技术融合发展的产物。
借助IaaS(基础设施即服务)、PaaS(平台即服务)、SaaS(软件即服务)等业务模式,把强⼤的计算能⼒提供给终端⽤户。
现阶段,云计算的两⼤底层⽀撑技术为“虚拟化”和“⼤数据技术”⽽HADOOP则是云计算的PaaS层的解决⽅案之⼀,并不等同于PaaS,更不等同于云计算本⾝。
HADOOP⽣态圈以及各组成部分的简介HDFS:分布式⽂件系统MAPREDUCE:分布式运算程序开发框架HIVE:基于⼤数据技术(⽂件系统+运算框架)的SQL数据仓库⼯具HBASE:基于HADOOP的分布式海量数据库ZOOKEEPER:分布式协调服务基础组件Mahout:基于mapreduce/spark/flink等分布式运算框架的机器学习算法库Oozie:⼯作流调度框架Sqoop:数据导⼊导出⼯具Flume:⽇志数据采集框架分布式系统概述注:由于⼤数据技术领域的各类技术框架基本上都是分布式系统,因此,理解hadoop、storm、spark等技术框架,都需要具备基本的分布式系统概念什么是分布式分布式系统是由⼀组通过⽹络进⾏通信、为了完成共同的任务⽽协调⼯作的计算机节点组成的系统。