
用极大似然法进行参数估计
北京工商大学《系统辨识》课程上机实验报告(2014年秋季学期)专业名称:控制工程上机题目:极大似然法进行参数估计专业班级:2015年1月实验目的通过实验掌握极大似然法在系统参数辨识中的原理和应用。
二实验原理1极大似然原理设有离散随机过程{V k }与未知参数二有关,假定已知概率分布密度 fMR 。
如果我们得到n 个独立的观测值 V 1 ,V 2,…,V n ,则可得分布密度 , f (V 20),…,f(V n 0)。
要求根据这些观测值来估计未知参数 二,估计的准则是观测值 {{V k } }的出现概率为最大。
为此,定义一个似然函数LMM,f(Vn"上式的右边是n 个概率密度函数的连乘, 似然函数L 是日的函数。
如果L 达到极大值,{V k } 的出现概率为最大。
因此,极大似然法的实质就是求出使 L 达到极大值的二的估值二。
为了便于求d ,对式(1.1 )等号两边取对数,则把连乘变成连加,即n解上式可得二的极大似然估计"ML O2系统参数的极大似然估计Newton-Raphson 法实际上就是一种递推算法,可以用于在线辨识。
不过它是一种依每 L 次观测数据递推一次的算法,现在我们讨论的是每观测一次数据就递推计算一次参数估计值 得算法。
本质上说,它只是一种近似的极大似然法。
设系统的差分方程为a(z') y(k) =b(z°)u(k) + :(k)(2.1 )式中a(z') =1 a 1z^ …a n z 」 b(z')二 b °…dz"因为(k)是相关随机向量,故(2.1 )可写成a(z')y(k) =b(zju(k) +c(z')g(k)(2.2 )式中c(z') ;(k)二(k) (2.3 ) c(z\ =1 C|Z ,亠 亠(2.4 );(k)是均值为0的高斯分布白噪声序列。
多项式a(z=) , b(z*)和c(z^)中的系数 a i,..,a,b o ,…b n,G,…C n 和序列{^(k)}的均方差o ■ln L =瓦 ln f (V i 日)由于对数函数是单调递增函数,当 对二的偏导数,令偏导数为0,可得::ln L cOi 4L 取极大值时,lnL 也同时取极大值。
求式(1.2 ) 1.2 )=0(1.3 )都是未知参数。
设待估参数V - [a 「a n b o b n C iC n 1并设y(k)的预测值为AAAAAy(k) - -a j y(k -1) - - a n y(k - n) b 0u(k)川…^b n u(k - n)AAG e(k-1)…-C n e(k - n)( 2.6)式中e(k -i)为预测误差;a i ,b i ,C i 为a ,,b ,c ,的估值。
预测误差可表示为n ne(k) =y(k) — y(k) = y(k)—卜送 a ,y(k —i)+J : bu(k —i) +IL i4Tn •' Ce(k -i) =(1 a i z " 「a n z 』)y(k)-(b o b i z —「b n z 』)u(k)- y(C I z C 2 z 川…川 sz )e(k)(2.7)或者(1 c i z 」亠 亠C n z 』)e(k) = (1 ■ a i z 」亠 亠 a n z 』)y(k) -(bo + b i z +…+b n z )u(k)(2.8)因此预测误差〈e(k)1满足关系式=a (z 」)y(k) —b (z°)u(k)(2.9)式中j j _n a(z ) =i a z a n zMzHd bz 亠 亠b n znc(z ) = i c z c n z假定预测误差e(k)服从均值为o 的高斯分布,并设序列fe(k 「具有相同的方差c 2。
因 为'e(k) /与c(z JL), a(z °)和b(z 4)有关,所以二2是被估参数二的函数。
为了书写方便, 把式(2.9)写成c(z ,)e(k) =a(z °)y(k) -b(z ,)u(k)(2. i o )e(k) =y(k) a y(k -i )亠亠a “y(k - n) - b o u(k-i) - bi u(k-i)--b n u(k - n) - C i e(k -1 )- -c n (k-n),k = n ,i ,n 2,( 2. i i )或写成nnne(k)二 y(k) ' a^k -i)八 0u(k -i) - ' qe(k -i)(2.1 2)i=1i=oi=1令k=n+1,n+2,…,n+N,可得e(k)的N 个方程式,把这 N 个方程式写成向量-矩阵形式eN =YN八‘ N71(2.5)(2.13 )Y N =_y(n+1)] y(n+2)「e(n +1) | e(n +2)a nb o.y(n + N)__-y( n) -y( n+1)e(n + N)-y(1) -y(2) u(n 1) u(1) u(n 2)u(2)e(n) e(n 1)…e(1) 1 …e(2)u(n N) u(N)e(n N -1) e(N)-y (n + N —1)…-y (N ) 因为已假定 沁(k)■是均值为0的高斯噪声序列,高斯噪声序列的概率密度函数为 1 1 2 f 1 exp[ 2 (y 一 m )] 2 2 2 (2二厂)2式中y 为观测值,二2和m 为y 的方差和均值,那么1 1 2f ?exp[ 2 e (k )] 2 2 2<T(2二广)2对于e (k )符合高斯噪声序列的极大似然函数为 (2.14 ) (2.15 ) L(K 日®)=L[e(n+1),e(n+2),…,e(n + N)|8] = f[e(n+1)8]f[e(n + 2)0]・f[e(n +N)|8] 1 1 2 2 2 N exp{ 2[e (n 1) e (n 2)叶…“ e (n N)]} 口 2 —2厲(2 二;「)21 N2 — (2二厂)2exp( —~2 e N e N )2" (2.16 )—exp[一(Y N ")T (Y N ")] (2心尸 27对上式(2.17 )等号两边取对数得 1 1 T NNln L(Y Nd ;「)=ln N ln exp( 2e N e N ) ln 2 ln(2 — )2 2二 2 22;" 或写为 ln L (Y N D 二号 求In L (Y N 二匚)对二2的偏导数, :Tn L (Y N 叮)(2.17 )1 T2 eN eN2(2.18 )1 n N 八 e 2(k)k =n "1N | _22 2令其等于 0,可得N 1 :N2八、0 24 e(k)=02- 2- *In2- (2.19 )(2.20 )J⑶计算J 的梯度r 和海赛矩阵::e(k)dQ式中 2 i n4N(kr2®e 2(k)(2.21 )J =丄 ' e 2(k) 2心1(2.22 ) 二2越小越好,因为当方差 小 2 2 2 二最小时,e (k)最小,即残差最小。
因此希望 -的估值取最 八22 min J N 因为式(2.10 )可理解为预测模型,而 e(k)可看做预测误差。
因此使式(2.22 )最小 就是使误差的平方之和最小, 即使对概率密度不作任何假设, 这样的准则也是有意义的。
因 此可按J 最小来求c ,…,a,b 0,…b n ,c 1^ c n 的估计值。
(2.23 ) 由于e(k)式参数a v , ,a,b 0^ b n ,c,,…q 的线性函数,因此J 是这些参数的二次型函数。
求使In L(Y N H 二)最大的v ,等价于在式(2.10 )的约束条件下求v 使J 为最小。
由于J 对 C |是非线性的,因而求J 的极小值问题并不好解, 只能用迭代方法求解。
求J 极小值的常用 迭代算法有拉格朗日乘子法和牛顿 -拉卜森法。
下面介绍牛顿-拉卜森法。
整个迭代计算步骤 如下: (1)确定初始的 肌值。
对于 氏中的a 1,…,a,b 0,…0可按模型 A d A d e(k) =a(z )y(k) -b(z )u(k) (2.24 ) 用最小二乘法来求,而对于 中的G ,…Cn 可先假定一些值。
(2)计算预测误差 Ae(k)二 y(k) - y(k) 给出 1 n N 2J e (k)j 1(2.25 ) 并计算 n 'N飞k 』(k)(2.26 )(2.27 )n "N二 ' e(k)k =n "1T出(k) 「£e(k)…6e(k)庞(k)…ce(k) fie(k)…ce(k)~\ ----- = ------- -------- 胡 倒 Ca n 和0 cb n CC| 5C n「[y(k) a !y(k-1)亠 亠a n y(k -n) —b 0u(k) -b |u(k-1) - -b n u(k — n)-Ge(k -1) " -c n e(k - n)]同理可得j=e ca ij =e匚冃CQ i j =ec(z 4) =1c n z 」所以得C(z\ 辿=y(k —i);:e(k)=y(k - i ) - ci;:e(k-1) c ::e(k-2) . .. c ::e(k - n)…c(2.28)::e(k);a::e(k-j)(2.29)b ij =1C jre(k_j)cb(2.30)型Vi 」C j 迴S C ij3将式(2.29 )移项化简,有y(k 」r 型「C ji eM <Cj^^ ta ij mjm Fa j因为e(k - j)二 e(k)z —j由e(k - j)求偏导,故(2.31)(2.32)(2.33)::e(k_j) ::e(k)z —jca i将(2.34 )代入(2.32),所以nn y(k-i)=5: C 哑二n 权 :a i(2.34)(2.35)(2.36)ca i同理可得(2.30 )和(2.31 )为根据(2.36 )构造公式些偏导数分别为{y (k )},{u (k )}和{e (k )}的线性函数。
下面求关于 二的二阶偏导数,即T工 n .N:e(k) :e(k):.N 汽(k)二 2 一 -r re(k丿二 2。
廿 k" 0廿-讯」k=B 十也A当二接近于真值二时,e (k )接近于0。
在这种情况下,式(2.44 )等号右边第2项接近刊 _ 广 fie(k) ®(k)Th k■■将其代入(2.36 ),可得廿)屮-(1)]= / 冬 ce(k)c(z )(2.40)ca消除c (z')可得;:e(k) ::e(k -i j) ,e(k-i 1)(2.41 )a ca j ca 1同理可得(2.37 )和(2.38 ) 式::e(k) ::e(k - i j)::e(k - i)(2.42 );:b cb j ::bo:e(k) ::e(k -i j) ::e(k-i 1)(2.43 ):c i cc j式(2.29 )、式(2.30 ) 和式(2.31 ) 均为差分方程,这些差分方程的初始条件为0,(2.39 )可通过求解这些差分方程,分别求出e (k )关于耳…,a,b 0,…b n ,C |,…G的全部偏导数,而这c 才厂丫)cb i 二-u(k 「i) (2.37 )c(z 」)竺cC i--e(k -i) (2.38 )c(z 」)V f y[k —(i —j) —j] =y(k —i)ca j(2.44 )于0, -2 a才可近似表示为(2.45 )⑷按牛顿-拉卜森计算二的新估值R ,有(2.46)重复(2)至(4)的计算步骤,经过r 次迭代计算之后可得 “,近一步迭代计算可得如果则可停止计算,否则继续迭代计算。
极大似然估计
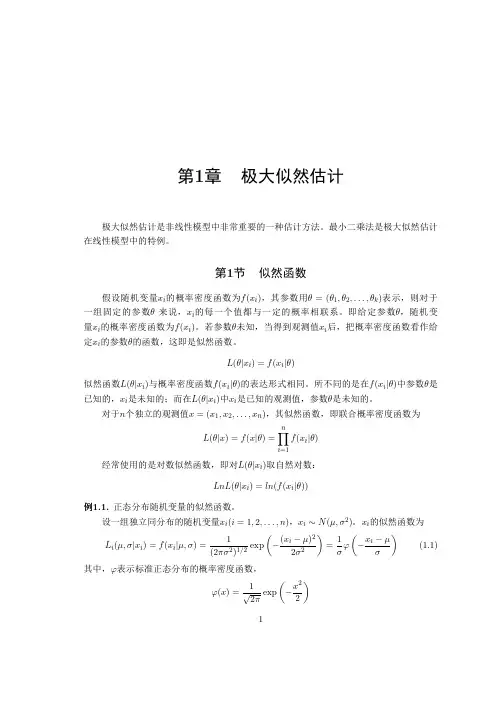
6
第1章 极大似然估计
1.2.4
方差矩阵的估计方法
( = ∂ 2 LnL −E ′ ∂θ0 ∂θ0 [ [ ])−1
由渐进公式 [I (θ0 )]
−1
ˆ带入上式作为θ ˆ的方差估计量,即信息矩阵的逆, 可以将θ ( ˆ) = Var(θ 在线性回归模型中, [I (θ0 )]−1 = [ ∂ 2 LnL −E ∂θ∂θ′ ( −E ] = [ ])−1
n n i=1 i=1
梯度向量也称为得分向量(score vector) 。梯度向量g 为k × 1向量。将所有观测值对 应的gi 构成的矩阵G = [g1 , g2 , . . . , gN ]′ (N × k )称为梯度向量的贡献矩阵。梯度向量g 的每 个元素为矩阵G的各列的和。 似然函数的二阶导数称为海赛矩阵(Hessian Matrix) : ∂ 2 ln f (y |θ) ∑ ∂ 2 ln f (yi |θ) ∑ H= = = Hi ∂θ∂θ′ ∂θ∂θ′
i=1 i=1
(1.2)
λxi e−λ xi !
第2节
1.2.1 极大似然估计的原理
极大似然估计
极 大 似 然 估 计 是 指 使 得 似 然 函 数 极 大 化 的 参 数 估 计 方 法,即 估 计 那 些 使 得 样 本(x1 , x2 , . . . , xN )出现的概率最大的参数。 例1.3. 正态分布的ML估计 对于n个相互独立的随机变量x = (x1 , x2 , . . . , xn ), xi ∼ N (µ, σ 2 )(i = 1, 2, . . . , n)。 根 据前面推导的(x1 , x2 , . . . , xn )的联合似然函数: ∑n (xi − µ)2 n n LnL(µ, σ |x) = − ln(σ 2 ) − ln(2π ) − i=1 2 2 2σ 2
时间序列的极大似然估计

时间序列的极大似然估计1. 引言(150-200字)时间序列分析是指通过观察时间序列数据,确定数据的模式、趋势和周期性等属性,并预测未来的发展趋势。
在时间序列分析中,极大似然估计(Maximum Likelihood Estimation,简称MLE)是一种常用的参数估计方法,它利用观测到的样本数据,推断出该数据的参数的最优值。
本文将深入探讨时间序列极大似然估计的原理、公式和步骤,以及如何应用于实际数据分析中。
2. 时间序列分析概述(250-300字)时间序列分析可用于统计、金融、经济学等领域,对于预测和决策具有重要意义。
在时间序列分析中,我们通常假设数据是来自某一分布的随机过程,而该分布的参数则需要进行估计。
极大似然估计是一种经典的参数估计方法,它寻求参数使得样本数据在给定参数下出现的概率最大化。
3. 极大似然估计原理(300-400字)极大似然估计的核心思想在于选择参数使得观测到的数据出现的概率最大化。
在时间序列分析中,我们通常假设数据服从某一特定分布,如正态分布、指数分布等。
以正态分布为例,假设观测到的数据为x1, x2, ..., xn,那么极大似然估计的目标就是找到最适合数据分布的参数值。
4. 极大似然估计公式(300-400字)在极大似然估计中,我们通过最大化似然函数的对数来推导参数的最优值。
以正态分布为例,似然函数为L(θx1, ..., xn) = Π[1/(σ√(2π))] * e^(-(xi-μ)²/(2σ²)),其中θ表示参数,μ表示均值,σ表示标准差。
极大似然估计的公式为:θ^ = argmax[ln(L(θx1, ..., xn))]。
5. 极大似然估计步骤(400-500字)极大似然估计的实施步骤分为以下几步:(1)根据数据分析确定所采用的概率分布模型;(2)写出似然函数;(3)对似然函数取对数,并进行化简;(4)求解由对数似然函数导数为零得到的方程组;(5)检查所得估计值的合理性,并进行参数的显著性检验。
各种参数的极大似然估计

各种参数的极大似然估计1.引言在统计学中,参数估计是一项关键任务。
其中,极大似然估计是一种常用且有效的方法。
通过极大化似然函数,我们可以估计出最有可能的参数值,从而进行推断、预测和优化等相关分析。
本文将介绍各种参数的极大似然估计方法及其应用。
2.独立同分布假设下的参数估计2.1参数估计的基本理论在独立同分布假设下,我们假设观测数据相互独立且具有相同的概率分布。
对于一个已知的概率分布,我们可以通过极大似然估计来估计其中的参数。
2.2二项分布参数的极大似然估计对于二项分布,其参数为概率$p$。
假设我们有$n$个独立的二项分布样本,其中成功的次数为$k$。
通过极大似然估计,我们可以得到参数$p$的估计值$\h at{p}$为:$$\h at{p}=\f ra c{k}{n}$$2.3正态分布参数的极大似然估计对于正态分布,其参数为均值$\mu$和标准差$\si gm a$。
假设我们有$n$个独立的正态分布样本,记为$x_1,x_2,...,x_n$。
通过极大似然估计,我们可以得到参数$\mu$和$\si gm a$的估计值$\h at{\m u}$和$\ha t{\s ig ma}$分别为:$$\h at{\mu}=\f rac{1}{n}\su m_{i=1}^nx_i$$$$\h at{\si gm a}=\s q rt{\fr ac{1}{n}\s um_{i=1}^n(x_i-\h at{\mu})^2}$$3.非独立同分布假设下的参数估计3.1参数估计的基本理论在非独立同分布假设下,我们允许观测数据的概率分布不完全相同。
此时,我们需要更加灵活的方法来估计参数。
3.2伯努利分布参数的极大似然估计伯努利分布是一种二点分布,其参数$p$表示某事件发生的概率。
假设我们有$n$组独立的伯努利分布样本,其中事件发生的次数为$k$。
通过极大似然估计,我们可以得到参数$p$的估计值$\h at{p}$为:$$\h at{p}=\f ra c{k}{n}$$3.3泊松分布参数的极大似然估计泊松分布是一种描述罕见事件发生次数的概率分布,其参数$\la mb da$表示单位时间(或单位面积)内平均发生的次数。
python 极大似然估计求解对数正态分布参数

python 极大似然估计求解对数正态分布参数对数正态分布的参数可以使用极大似然估计法进行求解。
以下是一个示例代码,演示如何使用Python进行对数正态分布的极大似然估计。
```pythonimport numpy as npfrom import minimize定义对数正态分布的pdf函数def lognormal_pdf(x, mean, std):return (-(((x) - mean) 2) / (2 std 2)) / (x std (2 ))定义似然函数def lognormal_likelihood(params, data):mean, std = paramsreturn (lognormal_pdf(data, mean, std))生成模拟数据data = (mean=1, sigma=, size=100)初始参数值initial_params = [((data)), (data)]最小化负对数似然函数result = minimize(lambda params: -lognormal_likelihood(params, data), initial_params, method='Nelder-Mead')输出估计参数值print('Estimated mean:', ([0]))print('Estimated std:', ([1]))```在上述代码中,我们首先定义了对数正态分布的pdf函数`lognormal_pdf`,然后定义了似然函数`lognormal_likelihood`,它接受参数和数据作为输入,并返回对数似然函数的值。
接下来,我们使用模拟数据生成器生成了一些模拟数据,并使用初始参数值进行极大似然估计。
最后,我们输出了估计的参数值。
参数估计极大似然法

将其取对数,然后对 1 , 2 ,, 2 , , k ) 0 1 ln L( 1 , 2 , , k ) 0 k
该方程组的解 ˆi ˆi (x1, x2 ,, xn ),i 1,2,, k , 即为 i 的极 大似然估计值.
求极大似然估计的一般步骤归纳如下:
(1)求似然函数 L( ) ;
(2)求出 ln L( ) 及方程
d ln L( ) 0 d
;
(3)解上述方程得到极大似然估计值
ˆ ˆ( x , x ,, x ) 1 2 n .
(4)解上述方程得到极大似然估计量
ˆ ˆ( X , X ,, X ) 1 2 n .
令
ˆ( x , x ,, x ) 解此方程得θ的极大似然估计值 1 2 n ,
从而得到θ的极大似然估计量ˆ( X1, X 2 ,, X n ) .
因为 解方程
L( )
与
ln L( )
具有相同的最大值点
d ln L( ) 0 d
也可得θ的极大似然估计值
ˆ( x , x ,, x ) 和θ的极大似然估计量 ˆ( X , X ,, X ) . 1 2 n 1 2 n
~ x d 2 ln L() 且 0 2 d ~ x
~ 从而得出λ的极大似然估计量为 X
例:设总体 X 服从参数为λ 的指数分布,其中λ 未
( x1 , x2 ,, xn ) ( X 1 , X 2 ,, X n ) 为从总体抽取一个样本, 知,
为其样本观测值, 试求参数λ 的极大似然估计值和 估计量.
例:设随机变量X服从泊松分布:
P{ X k}
k e
k!
,
极大似然估计

a* = m { X1 , X2 ,L Xn } in , b =m ax{ X1 , X2 ,L Xn } ,
*
是取自总体X的一个样本 例5设X1,X2,…Xn是取自总体 的一个样本 设 θ xθ −1 , 0 < x < 1 X ~ f ( x) = 其中θ >0, 的极大似然估计. 求θ 的极大似然估计 解:似然函数为
i =1 n
求导并令其为0 求导并令其为
d ln L(θ ) n n = + ∑ln xi =0 dθ θ i =1
从中解得
θ * = −n
∑ln x
i =1
n
i
即为θ 的MLE .
是取自总体X的一个样本 例6 设X1,X2,…Xn是取自总体 的一个样本
1 −( x−µ ) θ e , x≥µ X ~ f ( x) = θ θ , µ为未知参数 0, 其它
的极大似然估计.(注 我们把σ 看作一个参数) 的极大似然估计.(注:我们把σ2看作一个参数) .(
解:
似然函数L(µ,σ ) = ∏ f ( xi , µ,σ )
2 2 i =1
n
=∏
i =1
n
− 1 e 2πσ
( xi −µ )2 2σ
2
= (2πσ) e
n − 2
−
1 2σ 2
∑
i=1
n
( xi −µ )2
n i i=1
x!
e
−λ
x = 0,1,2,L
i
i =1
i =1
xi !
似然方程为
1 n ∂ log L(λ) = −n + ∑ xi = 0 λ i =1 ∂λ
极大似然估计方法
极大似然估计方法极大似然估计(Maximum Likelihood Estimation,MLE)方法是一种用于估计参数的统计方法,它基于观测到的样本数据,通过选择最大化观测数据出现的概率的参数值来估计未知参数。
极大似然估计是概率论和统计学中最重要的方法之一,广泛应用于各个领域的数据分析与建模中。
极大似然估计方法的核心思想是基于某一参数下观测数据出现的概率,选择使得这个概率最大的参数值。
具体而言,给定一个观测数据集合X,其来自于一个具有参数θ的概率分布,我们要估计未知参数θ的值。
极大似然估计的目标是找到一个参数值θ^,使得给定θ^条件下观测数据集合X出现的概率最大。
数学上,极大似然估计可以通过最大化似然函数来求解。
似然函数是一个参数的函数,表示给定某个参数θ下观测数据出现的概率。
似然函数的定义如下:L(θ|X) = P(X|θ)数的函数,表示给定某个参数θ下观测数据出现的概率。
极大似然估计的目标是寻找一个参数θ^,使得似然函数最大化,即:θ^ = arg max L(θ|X)为了方便计算,通常将似然函数转化为其对数形式,即对数似然函数:l(θ|X) = log L(θ|X)本文将主要介绍如何利用极大似然估计来估计参数。
具体而言,将分为两个部分:首先是介绍极大似然估计的理论基础,包括似然函数和对数似然函数的定义,以及如何通过最大化似然函数来估计参数;其次是通过一个实际的例子,展示如何使用极大似然估计来求解参数。
理论基础似然函数是极大似然估计的核心概念之一。
似然函数是一个参数的函数,表示给定某个参数θ下观测数据出现的概率。
似然函数的定义如下:L(θ|X) = P(X|θ)数的函数,表示给定某个参数θ下观测数据出现的概率。
似然函数的值越大,则表示给定参数θ的取值越可能产生观测数据X。
对数似然函数是似然函数的对数变换,通常在实际计算中会更加方便。
它的定义如下:l(θ|X) = log L(θ|X)对数似然函数和似然函数存在着一一对应关系,因此在求解参数时,两者等价。
极大似然估计 参数回归模型
极大似然估计参数回归模型极大似然估计是统计学中常用的一种参数估计方法,它通过寻找使得观测数据出现的概率最大化的参数值来估计模型的参数。
在回归分析中,极大似然估计可以用来估计线性回归模型的参数。
假设我们有一个简单的线性回归模型,表示为:Y = β0 + β1X + ε。
其中,Y是因变量,X是自变量,β0和β1是我们要估计的参数,ε是误差项。
我们的目标是通过观测数据来估计β0和β1的值,使得观测数据出现的概率最大化。
假设我们有n个观测数据,表示为{(x1, y1), (x2, y2), ..., (xn, yn)},我们假设误差项ε服从正态分布,即ε~N(0, σ^2)。
我们可以建立似然函数来描述观测数据出现的概率。
对于第i 个观测数据,其观测值yi可以表示为:yi = β0 + β1xi + εi.其中,εi服从正态分布N(0, σ^2)。
似然函数可以表示为:L(β0, β1,σ^2) = Π(1/√(2πσ^2)) exp(-(yi β0β1xi)^2 / (2σ^2))。
为了简化计算,通常我们会对似然函数取对数,得到对数似然函数:l(β0, β1, σ^2) = Σ(-log(√(2πσ^2))) Σ((yi β0β1xi)^2 / (2σ^2))。
然后通过最大化对数似然函数来估计参数β0和β1的值。
这通常可以通过数值优化算法来实现,比如梯度下降法或者牛顿法。
通过极大似然估计,我们可以得到对参数β0和β1的估计值,从而建立起回归模型。
这种方法在统计学和机器学习中被广泛应用,能够帮助我们通过观测数据来估计模型参数,从而进行预测和推断。
极大似然估计法步骤
极大似然估计法步骤极大似然估计法(Maximum Likelihood Estimation,MLE)是一种常用的参数估计方法,它利用样本数据来估计概率模型的参数。
它的基本思想是选择参数值使得观测到的样本出现的概率最大化。
极大似然估计法被广泛应用于统计学、机器学习以及其他领域。
极大似然估计法的步骤可以概括为以下几个主要步骤:1.确定参数化模型:首先,必须确定概率模型的形式和参数化,以便进行参数估计。
例如,对于二项分布模型,我们需要确定参数p 表示成功概率。
2.构建似然函数:接下来,需要构建似然函数。
似然函数是指在给定模型参数条件下观测到的样本的条件概率密度(或离散情况下的概率质量函数)。
似然函数的形式可以根据不同的概率模型进行定义。
例如,对于离散情况下的伯努利分布,似然函数可以表示为:L(p) = p^k * (1-p)^(n-k),其中k是观测到的成功次数,n是总的观测次数。
对于连续情况下的正态分布,似然函数可以表示为:L(μ,σ) = (2πσ^2)^(-n/2) * exp[-(1/2σ^2) * Σ(xi-μ)^2]。
3.对数似然函数的求解:通常,为了便于计算和优化,我们会使用对数似然函数进行求解。
对数似然函数和似然函数具有相同的最大值点,但其大大简化了计算过程。
4.最大化对数似然函数:确定参数的MLE估计值等于使得对数似然函数最大化时的参数值。
常见的最大化方法包括数值方法(如牛顿法、梯度下降法等)和解析方法。
对于某些简单的模型,可以通过求导数等条件判断来获得解析解。
例如,对于伯努利分布中的参数p,可以通过求取对数似然函数的一阶导数,并令其等于0,解得MLE估计值为p = k/n。
5.参数估计:得到MLE估计值后,就可以根据估计参数进行进一步的分析和预测了。
通常,MLE估计值具有良好的频率特性,即当样本数量趋近于无穷大时,估计值收敛到真实参数。
极大似然估计法的优点在于其较好的性质和理论基础。
极大似然参数估计
1.4 1.2 1 0.8 0.6
ˆ
0.4 0.2 0 -0.2 -0.4
ML
1
1.2
1.4
1.6
1.8
2
2.2
2.4
2.6
2.8
3
N 1 N [ yi ]2 ln L(YN | ) ln 2 2 2 2 i 1 2
d 1 N 1 ln L(YN | ) 2( yi ) 2 2 d 2 i 1
数的确定问题)
12
似然函数的确定 L(YL | ) ?
1)独立观测情况 各观测量 y(1), y(2),, y( N ) 由随机变量 y 的独立 样本所组成,观测量是独立的。
L(YN | ) p( y(1) | ) p( y(2) | ) p( y( N ) | ) p( y(i) | )
L(YN | ) -------- 似然函数
L(YN | ) p(YN | )
ML
ˆ ML ------- 使似然函数取极大值。 L(YN | ) ˆ
Max ( p (YN | ))
7
或
L(YN | ) 0 ˆ ML ln L(YN | ) 0 ˆ ML
L(YN | )
L(YN | H )
H1N1 !!!
L(YN | S ) > L(YN | H )
ˆ S
11
说明:
极大似然法是根据对观测量(输出量)y 的观测, 估计未知参数的一种方法,必然需要可观测变量
y
的
联合概率密度函数 p(YN | )的先验知识.(涉及到似然函
2 ML