
GREP模型
GREP模型
[编辑]
什么是GREP模型?
GREP模型是进行组织内环境分析的有效工具,是分析企业竞争优势的内生战略分析法,即将企业的战略结构由四个部分组成:治理结构,资源,企业家,产品或服务,如下图所示:
[编辑]
GREP模型内容分析
[编辑]
G(Governance,公司治理)
因为代理问题的存在,确切地说是组织成员(所有者、雇员等)之间存在利益冲突,且因交易费用之大使代理问题不可能通过合约解决,导致公司治理问题就必然在一个组织中产生。
公司治理是一种合同关系,功能是配置权、责、利。
国内学者吴敬琏教授认为,“所谓公司治理结构,是指由所有者、董事会和高级执行人员即高级经理三者组成的一种组织结构。
在这种结构中,上述三者之间形成一定的制衡关系。
通过这一结构,所有者将自己的资产交由公司董事会托管;公司董事会是公司的决策机构,拥有对高级经理人员的聘用、奖惩和解雇权;高级经理人员受雇于董事会,组成在董事会领导下的执行机构,在董事会的授权范围内经营企业。
”
[编辑]
R(Resource,资源)
组织拥有资源的种类、数量、质量、稀缺性、流动性等对组织的发展方向和空间有很大的影响,许多企业是因拥有自然资源而存在的,如矿山,则他对所拥有的矿山资源必须有十分清楚的了解,政府的资源是他拥有的公权这一资源,许多企业把人力资源放在很重要的位置,从一定意义上来说摸清资源就是认清企业的竞争优势有劣势。
[编辑]
E(Enterpriser,企业家)
企业家或者说管理团队,对企业的业绩起着重要作用,是企业资本获得超额回报的源泉,企业家有多优秀,企业就有多优秀。
企业应该由何种类型的企业家来经营,现在的企业家是不是合适的人选,应该建立怎样的管理团队,这是研究组织必须了解的问题。
[编辑]
P(Product,产品)
产品或服务是组织用来与社会交换的载体,企业现在产品、产品线,研制、试制、在制产品情况,产品处于产品生命周期的哪个阶段,都是关系企业命运的问题。
Linux命令高级技巧使用grep进行文件内容的多个关键词的逻辑匹配

Linux命令高级技巧使用grep进行文件内容的多个关键词的逻辑匹配在Linux系统中,grep命令是一个非常常用的文本搜索工具,可以根据指定的关键词在文件中查找匹配的文本行。
不仅如此,grep还支持使用多个关键词进行逻辑匹配,从而更加精准地找到我们需要的信息。
本文将介绍grep命令的高级技巧,帮助读者更好地利用grep进行文件内容的多个关键词的逻辑匹配。
一、grep命令的基本使用在开始介绍grep命令的高级技巧之前,我们先回顾一下grep命令的基本用法。
grep命令的一般语法如下:grep [选项] [匹配模式] [文件名]其中,选项用于指定grep命令的一些特定行为,匹配模式用于指定要匹配的关键词,文件名则用于指定要搜索的文件。
例如,要在文件example.txt中查找包含关键词"hello"的文本行,我们可以使用以下命令:grep "hello" example.txt二、使用grep进行单个关键词的匹配grep命令可以非常方便地用于查找包含单个关键词的文本行。
下面是一些实用的选项,可以帮助我们更好地使用grep进行单个关键词的匹配。
1. 不区分大小写的匹配:使用选项"-i"可以忽略关键词的大小写,实现不区分大小写的匹配。
例如,要在文件example.txt中查找包含关键词"hello"的文本行,无论其大小写如何,我们可以使用以下命令:grep -i "hello" example.txt2. 输出匹配的行数:使用选项"-c"可以输出匹配的文本行数。
例如,要统计文件example.txt中包含关键词"hello"的文本行数,我们可以使用以下命令:grep -c "hello" example.txt3. 输出不匹配的文本行:使用选项"-v"可以输出不包含关键词的文本行。
战略分析:组织内部环境分析的GREP模型
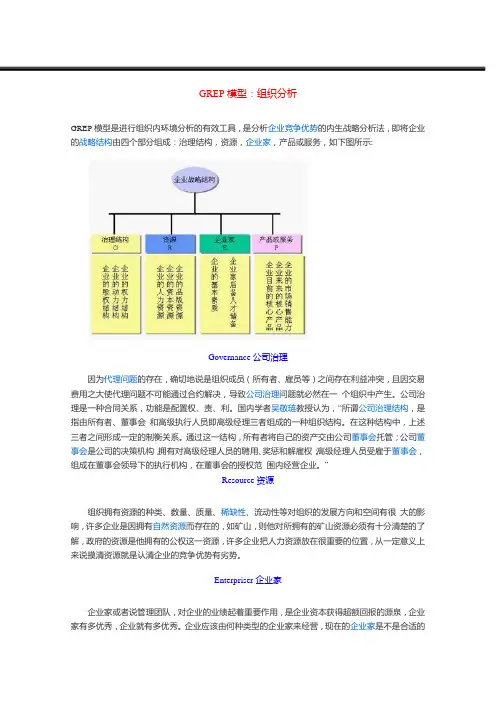
GREP模型:组织分析GREP模型是进行组织内环境分析的有效工具,是分析企业竞争优势的内生战略分析法,即将企业的战略结构由四个部分组成:治理结构,资源,企业家,产品或服务,如下图所示:Governance公司治理因为代理问题的存在,确切地说是组织成员(所有者、雇员等)之间存在利益冲突,且因交易费用之大使代理问题不可能通过合约解决,导致公司治理问题就必然在一个组织中产生。
公司治理是一种合同关系,功能是配置权、责、利。
国内学者吴敬琏教授认为,“所谓公司治理结构,是指由所有者、董事会和高级执行人员即高级经理三者组成的一种组织结构。
在这种结构中,上述三者之间形成一定的制衡关系。
通过这一结构,所有者将自己的资产交由公司董事会托管;公司董事会是公司的决策机构,拥有对高级经理人员的聘用、奖惩和解雇权;高级经理人员受雇于董事会,组成在董事会领导下的执行机构,在董事会的授权范围内经营企业。
”Resource资源组织拥有资源的种类、数量、质量、稀缺性、流动性等对组织的发展方向和空间有很大的影响,许多企业是因拥有自然资源而存在的,如矿山,则他对所拥有的矿山资源必须有十分清楚的了解,政府的资源是他拥有的公权这一资源,许多企业把人力资源放在很重要的位置,从一定意义上来说摸清资源就是认清企业的竞争优势有劣势。
Enterpriser企业家企业家或者说管理团队,对企业的业绩起着重要作用,是企业资本获得超额回报的源泉,企业家有多优秀,企业就有多优秀。
企业应该由何种类型的企业家来经营,现在的企业家是不是合适的人选,应该建立怎样的管理团队,这是研究组织必须了解的问题。
Product产品产品或服务是组织用来与社会交换的载体,企业现在产品、产品线,研制、试制、在制产品情况,产品处于产品生命周期的哪个阶段,都是关系企业命运的问题。
结束语。
grep -r -n的用法
grep -r -n的用法主题:grep r n的用法摘要:grep是一个强大的文本搜索工具,用于在文件中查找匹配指定模式的文本行。
本文将详细介绍grep命令中-r和-n选项的用法,以及它们在日常工作中的实际应用。
*第一步:理解grep命令和其常用选项在介绍grep命令的-r和-n选项之前,我们先来了解一下grep命令及其常用选项。
grep是一种在文本文件中搜索指定模式的行的常用命令。
它的基本语法是:grep [options] pattern [files]其中,pattern是我们要搜索的模式,可以是一个简单的字符串,也可以是一个正则表达式。
files是我们希望在其中搜索的文件列表。
常用的grep选项包括:- -i:忽略大小写进行匹配。
- -v:打印不匹配模式的行。
- -l:只打印包含匹配模式的文件名。
- -r/recursive:递归搜索指定目录下的文件。
- -n/line-number:显示匹配行的行号。
第二步:使用-r选项进行递归搜索-r或recursive选项告诉grep命令递归地搜索指定目录下的文件。
这对于查找包含指定模式的大量文件非常有用。
例如,假设我们有一个名为"documents"的目录,该目录下有多个子目录,每个子目录下都有一些文本文件。
我们想要在这些文件中查找包含"hello world"的行。
我们可以使用以下命令:grep -r "hello world" documents这样,grep将递归地搜索"documents"目录中的所有文件,并打印出包含"hello world"的行。
通过使用-r选项,我们可以轻松地搜索整个目录树,而无需在每个目录中单独运行grep命令。
第三步:使用-n选项显示匹配行的行号-n或line-number选项告诉grep命令在匹配行之前显示行号。
grep命令的参数-i,表示模式匹配时区分大小写
一、grep命令的基本概念grep命令是Linux系统中常用的文本搜索工具,用于在文件或标准输入中搜索指定的模式,并将匹配的行打印出来。
它可以根据用户提供的正则表达式进行模式匹配,从而达到快速定位目标文本内容的目的。
grep命令的参数很多,其中-i参数表示模式匹配时不区分大小写。
二、grep命令的常见用法grep命令通常用于查找包含特定字符或模式的行,并将其输出到标准输出。
其基本用法如下:```grep [option] pattern [file]```其中,option是命令的参数,pattern是要匹配的模式,file是要进行搜索的文件。
三、-i参数的作用在使用grep命令进行模式匹配时,默认情况下是区分大小写的,也就是说大写和小写字母是不同的。
而使用了-i参数之后,grep命令将不再区分大小写,即不管是大写还是小写都可以匹配到相应的内容。
四、使用实例假设有一个文件test.txt,内容如下:```Hello, world!hello, world!HELLO, WORLD!```我们希望查找包含hello的行,可以使用以下命令:```grep -i "hello" test.txt```使用了-i参数之后,不再区分大小写,上述命令将匹配到所有包含hello的行,输出如下:```Hello, world!hello, world!```如果不使用-i参数,则只会匹配到第二行。
五、-i参数的注意事项使用-i参数可以方便地进行不区分大小写的模式匹配,但也要注意一些问题。
如果模式本身包含了大小写字母,那么-i参数将不再起作用,需要注意模式的书写方式。
另外,使用-i参数可能会对性能产生一定影响,因为要进行更多的匹配工作。
六、总结grep命令是Linux系统中非常常用的文本搜索工具,而-i参数可以方便地进行不区分大小写的模式匹配,提高了搜索的灵活性和通用性。
在实际使用过程中,合理地应用-i参数可以提高工作效率,但也需要注意一些使用注意事项。
grep命令中的正则表达式
grep命令中的正则表达式grep命令是一种强大的文本搜索工具,它通过使用正则表达式来匹配和查找文本中的特定模式。
正则表达式是一种用于描述文本模式的语法规则,它可以帮助我们在大量的文本数据中快速定位和提取我们需要的信息。
本文将从不同的角度探讨grep命令中的正则表达式的应用。
一、匹配数字正则表达式中可以使用\d来匹配任意一个数字,使用\d+来匹配一个或多个数字。
例如,我们可以使用grep命令来查找一个文本文件中所有的数字,并将其打印出来。
命令如下:```shellgrep -o '\d+' filename```在这个命令中,-o选项用来只打印匹配到的内容,\d+代表一个或多个数字,filename代表要搜索的文件名。
二、匹配单词正则表达式中可以使用\w来匹配一个单词字符,使用\w+来匹配一个或多个单词字符。
例如,我们可以使用grep命令来查找一个文本文件中所有的单词,并将其打印出来。
命令如下:```shellgrep -o '\w+' filename```在这个命令中,-o选项用来只打印匹配到的内容,\w+代表一个或多个单词字符,filename代表要搜索的文件名。
三、匹配邮箱地址正则表达式中可以使用\w+@\w+\.\w+来匹配一个邮箱地址。
例如,我们可以使用grep命令来查找一个文本文件中所有的邮箱地址,并将其打印出来。
命令如下:```shellgrep -o '\w+@\w+\.\w+' filename```在这个命令中,-o选项用来只打印匹配到的内容,\w+@\w+\.\w+代表一个邮箱地址,filename代表要搜索的文件名。
四、匹配IP地址正则表达式中可以使用\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}来匹配一个IP地址。
例如,我们可以使用grep命令来查找一个文本文件中所有的IP地址,并将其打印出来。
命令如下:```shellgrep -o '\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}' filename```在这个命令中,-o选项用来只打印匹配到的内容,\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}代表一个IP地址,filename代表要搜索的文件名。
Linux命令高级技巧使用grep命令进行多文件搜索和匹配
Linux命令高级技巧使用grep命令进行多文件搜索和匹配Linux命令高级技巧:使用grep命令进行多文件搜索和匹配在Linux操作系统中,grep命令是一种非常强大的文本搜索工具,它允许用户在一个或多个文件中搜索特定模式的文本。
本文将介绍如何使用grep命令进行多文件搜索和匹配,并探讨一些高级技巧。
1. 基本语法grep命令的基本语法如下:```grep [option] pattern [file...]```其中,pattern表示要匹配的模式,可以是普通字符、正则表达式或者模式文件;file表示要进行搜索的文件名,可以是一个或多个文件。
2. 搜索多个文件使用grep命令搜索多个文件非常简单,只需要将要搜索的文件名依次列出即可。
例如,搜索文件file1.txt和file2.txt中包含字符串"example"的行,可以使用以下命令:```grep "example" file1.txt file2.txt```这样就会显示所有包含"example"的行的内容。
3. 递归搜索grep命令还支持递归搜索,可以在指定目录中搜索包含特定模式的文件。
例如,搜索当前目录及其子目录下所有扩展名为.txt的文件中包含字符串"example"的行,可以使用以下命令:```grep "example" -r --include "*.txt" .```其中,-r选项表示递归搜索,--include "*.txt"表示只搜索扩展名为.txt的文件,"."表示当前目录。
4. 搜索排除文件有时,我们可能希望在搜索时排除某些文件或目录。
grep命令提供了--exclude和--exclude-dir选项来实现这一功能。
例如,搜索当前目录下扩展名为.txt的文件中包含字符串"example"的行,但排除file1.txt文件,可以使用以下命令:```grep "example" --exclude "file1.txt" --include "*.txt" .```这样就会搜索除file1.txt以外的所有扩展名为.txt的文件。
grep -e命令详解正则
grep -e命令详解正则grep -e命令用于在文件中搜索匹配指定模式的文本行。
它支持使用正则表达式进行模式匹配。
使用格式为:grep -e pattern file其中,pattern表示要搜索的模式,可以是简单的字符串,也可以是复杂的正则表达式。
file表示要搜索的文件名。
常用选项:-i:忽略大小写-v:只显示不匹配的行-n:显示行号-r:递归搜索目录下的文件-c:显示匹配的行数正则表达式的使用:1. 普通字符:普通字符表示它们本身,例如a表示字符"a"。
2. 元字符:元字符是一些特殊字符,具有特殊的含义,例如"."表示任意一个字符,"*"表示前一个字符的零个或多个副本。
3. 字符类:使用方括号[]表示,表示匹配方括号中的任意一个字符。
例如[a-z]表示小写字母a到z中的任意一个字符。
4. 重复限定符:用于限定某个模式的重复次数。
例如*表示0次或多次,+表示1次或多次,?表示0次或1次,{n}表示重复n次,{n,}表示至少重复n次,{n,m}表示重复n到m次。
5. 锚定字符:用于限定某个模式的位置。
例如^表示行的起始位置,$表示行的结束位置。
示例:1. 搜索文件中包含"hello"的行:grep -e "hello" file.txt2. 搜索文件中以"abc"开头的行:grep -e "^abc" file.txt3. 搜索文件中以"xyz"结尾的行:grep -e "xyz$" file.txt4. 搜索文件中包含数字的行:grep -e "[0-9]" file.txt5. 搜索文件中以字母开头,后面跟着数字的行:grep -e "^[a-zA-Z][0-9]" file.txt以上是grep -e命令详解正则的介绍,希望对你有帮助!。
营销管理的常用模型和理论
营销管理的常用模型和理论多点竞争战略杜邦分析法(DuPont Analysis)GE矩阵(GE Matrix/Mckinsey Matrix)盖洛普路径(The Gallup Path)竞争资源四层次模型价值链信息化管理竞争优势因果关系模式竞争对手分析工具完整价值链分析(VCA)的基本原理脚本法(Scenarios,Scenario Analysis)KT决策法(KT Matrix)扩张方法矩阵利益相关者分析(StakeholderAnalysis)雷达图分析法卢因的力场分析法六顶思考帽(Six Thinking Hats)华信惠悦人力资本指数(HCI,Human Capital Index)横向价值链分析行业内战略集团分析基本竞争战略(Generic Competitive Strategies)竞争战略三角模型(Triangle Model)价值网模型(value net)绩效棱柱模型(Performance Prism)利润库分析法核心竞争力分析模型(Core competence analysis)麦肯锡7S模型(Mckinsey 7S Model)麦肯锡三层面理论(Three aspect theories)麦肯锡逻辑树分析法诺兰的阶段模型PEST分析模型(PEST Analysis)PESTEL分析模型PAEI管理角色模型PIMS分析佩罗的技术分类企业素质与活力分析QFD法ECR系统(Efficient Consumer Response,有效消费者反应系统) SECI模型(SECI Model)过程决策程序图法(PDPC法,Process Decision Program Chart)树状图(Tree Diagram or Dedrogram)关联图法(Inter-relationship diagraph)KJ法又称A型图解法、亲和图法(Affinity Diagram信息孤岛管理信息系统(Management Information System,简称MIS)SWOT分析模型SCOR模型SFO模型SCP分析模型安索夫矩阵三维商业定义ADL矩阵安迪•格鲁夫的六力分析模型标杆分析SERVQUAL模型鱼骨图头脑风暴法PDCA循环帕累托法则(Pareto Principle,80/20法则)SMART原则ABC分类法(Activity Based Classification)KPI(Key Performance Indicator,关键绩效指标)波特钻石理论模型(Michael Porter diamond Model)波特竞争战略轮盘模型定向政策矩阵(Directional Policy Matrix,指导性政策矩阵,简称DPM或DP矩阵) 二元核心模式(dual-core approach)服务金三角(Service Triangle)福克纳和鲍曼的顾客矩阵服务质量(Quality of Service,QoF)全面质量管理朱兰的质量三元论DMAIC模型六西格玛(Six Sigma)差距分析(Gap Analysis,又称缺口分析、差异分析)CSP模型QSPM矩阵战略地位与行动评价矩阵(SPACE矩阵)波士顿矩阵(BCG Matrix)BCG三四规则矩阵波士顿经验曲线(BCG Experience Curve)内部因素评价矩阵(Internal Factor Evaluation Matrix,IFE矩阵)外部因素评价矩阵(EFE矩阵)内部-外部矩阵(Internal-External Matrix,IE矩阵)大战略矩阵(Grand Strategy Matrix)变革五因素策略方格模型(Strategic Grid Model)波特行业竞争结构分析模型价值链管理(Value Chain Management,VCM)学习型组织(Learning Organization)企业价值关联分析模型企业竞争力九力分析模型企业战略五要素分析法人力资源成熟度模型(People Capability Maturity Model,PCMM)人力资源经济分析RATER指数RFM模型瑞定的学习模型GREP模型3C战略三角模型汤姆森和斯特克兰方法V矩阵陀螺理论(Gyroscope Theory)SIPOC模型战略钟模型战略地图(Strategy Map)组织成长阶段模型(Growth_Phases Model)战略选择矩阵管理要素分析模型360度薪酬目标管理(mbo)鱼缸会议情形分析图TDC矩阵(Time Distance Complexity Matrix)QQTC模型PARTS战略(Participators、Added values、Rules、Tactics、Scope)布莱克的管理方格理论(Management Grid Theory)布雷德福的敏感性训练理论(Sensitivity Training)情绪ABC理论期望理论(Expectancy Theory)“复杂人”假设赫兹伯格的双因素激励理论霍桑效应奥卡姆剃刀定律(Occam's Razor, Ockham's Razor)符号互动论(symbolic interactionism)戈夫曼拟剧论(Goffman's Dramaturgical Theory)常人方法学(Ethnomethodology)皮格马利翁效应(Pygmalion Effect)利克特的支持关系理论(Support Relation Theory)马斯洛人类需求五层次理论(Maslow's Hierarchy of Needs)X理论和Y理论(Theory X and Theory Y)理性选择理论(Rational Choice Theory)心理定格(Frames)团体力学理论社会惰化(social loafing)领导行为连续体理论(Leadership Continuum)“自我实现人”假设(Self-Actualizing Man)战略群模型综合战略理论重要性-迫切性模型(PQM)知识链模型(Knowledge Chain)知识价值链模型(Knowledge value chain, KVC)知识螺旋(Knowledge Spiral)平衡计分卡(The Balanced ScoreCard,简称BSC)组织结构模型供应链管理(Supply Chain Management ,简称SCM)波特价值链分析模型(Michael Porter's Value Chain Model)客户关系管理(Customer Relationship Management,CRM)PIMS分析(Profit Impact of Market Strategies)企业核心能力(Core Capability of Enterprise)BPR(Business Process Reengineering/Business Process Re-engineering,业务流程重)欢迎您的下载,资料仅供参考!致力为企业和个人提供合同协议,策划案计划书,学习资料等等打造全网一站式需求。
通过grep命令进行高级文本搜索和过滤
通过grep命令进行高级文本搜索和过滤在Linux系统中,grep是一个非常有用的命令,它被用来在文本文件中进行搜索和过滤。
grep命令可以根据特定的模式来匹配文件中的内容,并将匹配到的内容进行输出。
它支持正则表达式,能够实现更加灵活的搜索和过滤。
在本文中,我们将介绍如何使用grep命令进行高级文本搜索和过滤。
1. 基本用法grep命令的基本语法如下:```grep [选项] 模式文件```其中,选项用于指定grep的具体功能,模式用于描述我们希望匹配的内容,文件则是希望进行搜索和过滤的文件名。
示例:```grep "keyword" file.txt```上述命令将会在file.txt文件中搜索包含"keyword"的行,并将匹配到的行进行输出。
2. 匹配模式grep支持多种不同的匹配模式,下面列举了几种常用的模式及其用法:2.1 普通字符串匹配如果我们的模式是一个普通字符串,那么grep将会在文本中查找该字符串的所有匹配项。
示例:```grep "apple" fruits.txt```上述命令将会在fruits.txt文件中搜索包含"apple"的行,并将匹配到的行进行输出。
2.2 正则表达式匹配grep支持使用正则表达式进行更加灵活的匹配。
正则表达式可以描述一系列字符的模式,从而更加精确地匹配我们的需求。
示例:```grep -E "a{2,3}b" file.txt```上述命令将会在file.txt文件中搜索包含连续2到3个"a"后跟着一个"b"的行,并将匹配到的行进行输出。
2.3 匹配整个单词有时候,我们可能只想要匹配整个单词,而不是在文本中匹配到的每一个部分。
为了实现这个目标,我们可以使用grep命令的"-w"选项。
示例:```grep -w "apple" fruits.txt```上述命令将会在fruits.txt文件中搜索包含整个单词"apple"的行,并将匹配到的行进行输出。
grep 正则表达式使用
grep 正则表达式使用(实用版)目录1.引言2.grep 的基本概念3.grep 的命令格式4.grep 的应用实例5.结论正文一、引言在计算机领域,文本处理是非常常见的任务之一。
正则表达式(Regular Expression,简称 regex)作为一种强大的文本处理工具,被广泛应用于各种编程语言中。
在 Linux 系统中,grep(全局正则表达式打印,global regular expression print)命令是基于正则表达式进行文本搜索和替换的工具,它可以快速地在文件或文本中查找与给定模式匹配的行。
本文将为大家介绍 grep 正则表达式的基本概念、命令格式以及应用实例。
二、grep 的基本概念1.正则表达式(Regular Expression):正则表达式是一种用于描述字符或字符串模式的强大工具,它可以用来检查文本是否符合某种模式、提取文本中的特定部分等。
正则表达式的基本语法包括字符集、量词、分组、选择等。
2.grep:grep 命令是 Linux 系统中用于进行文本搜索和替换的工具,它根据给定的正则表达式在文件或文本中查找匹配的行,并将匹配的行输出。
grep 命令还可以进行文本替换等操作。
三、grep 的命令格式grep 的基本命令格式如下:```grep "pattern" file```其中,pattern 表示正则表达式,file 表示要搜索的文件。
根据需要,grep 命令还可以添加各种选项和参数,例如:- -i:忽略大小写- -v:反转匹配,输出不匹配的行- -r:递归查找目录下的所有文件- -n:显示匹配行的行号- -w:只匹配整个单词- -c:显示匹配的行数而非具体内容四、grep 的应用实例1.在文件中查找指定字符串例如,在 file.txt 文件中查找字符串“hello”:```grep "hello" file.txt```2.使用正则表达式进行模糊匹配例如,在 file.txt 文件中查找以“example”开头的行:```grep "^example" file.txt```3.使用正则表达式进行精确匹配例如,在 file.txt 文件中查找包含字母“e”的行:```grep "^[eE]" file.txt```4.在多个文件中查找指定内容例如,在 directory 目录下的所有文件中查找字符串“world”:```grep -r "world" directory```五、结论grep 命令是 Linux 系统中功能强大的文本处理工具,通过结合正则表达式,可以实现各种复杂的文本搜索和替换任务。