
西文字符编码与汉字编码共18页
汉字编码

具体的,
GBKindex = ((unsigned char)GBKword[0]-129)*190 +
((unsigned char)GBKword[1]-64) - (unsigned char)GBKword[1]/128;
三、怎样判断一个汉字的是什么编码
return true;
else return false;
}
else return false;
}
2、判断是否是GBK编码
bool isGBKCode(const string& strIn)
{
unsigned char ch1;
if (ch1>=129 && ch1<=254 && ch2>=64 && ch2<=254)
return true;
else return false;
}
else return false;
}
3、对于Big5
对于第二块,计算偏移量时因为有两块数值,所以在计算后面一段值时,不要忘了前面还有一段值。0x7E-0x40+1=63。
四、如果判断一个字符是西文字符还是中文字符
大家知道西文字符主要是指ASCII码,它用一个字节表示。且这个字符转换成数字之后,该数字是大于0的,而汉字是两个字节的,第一个字节的转化为数字之后应该是小于0的,因此可以根据每个字节转化为数字之后是否小于0,判断它是否是汉字。
{
ch1 = (unsigned char)strIn.at(0);
ch2 = (unsigned char)strIn.at(1);
西文字符的编码
约有6800种语言和文字在使用,需要建立一个多文种(Multilingual)处理环境
在ISO2022基础上,使用代码页号切换不同字符集的方法过于繁琐,且与其他系统不兼容
目标与途径:实现所有字符在同一字符集中统一编码
UCS/Unicode与GB18030汉字编码标准
3)汉字的编码(一)
GB2312-80汉字编码
A.第一部分:字母、数字和各种符号,包括拉丁字母、俄文、日文平假名与片假名、希腊字母、汉语拼音等共682个(统称为GB2312图形符号)
B.第二部分:一级常用汉字,共3755个,按汉语拼音排列
C.第三部分:二级常用字,共3008个,按偏旁部首排列
区位码:GB2312国标字符集构成一个二维平面,它分成94行、94列,行号称为区号,列号称为位号。每一个汉字或符号在码表中都有各自的位置,字符的位置用它所在的区号(行号)及位号(列号)来表示。每个汉字的区号和位号分别用1个字节来表示{如:“大”字的区号20,位号83,区位码是20 83
用2个字节表示为:00010100 01010011}
4)国标交换码:
问题:信息通信中,汉字的区位码与通信使用的控制码(00H~1FH)发生冲突。解决方案:为了避免汉字区位码与通信控制码的冲突,ISO2022规定,每个汉字的区号和位号必须分别加上32(20H)得到国标交换码。
5)机内码:
问题:文本中的汉字与西文字符经常是混合在一起使用的,汉字信息如不予以特别的标识,它与单字节的标准ASCII码就会混淆不清。解决方法:把一个汉字看作两个扩展ASCII码,使表示GB2312汉字的两个字节的最高位(b7)都等于“1”。这种高位为l的双字节(16位)汉字编码就称为GB2312汉字的“机内码”,又称内码。(如:“大”字的内码是:10110100 11110011(B4F3))
数据编码的基本方式

28
机内码
文档仅供参考,如有不当之处,请联系改正。
GB2312-80统一要求了中文旳基本编码原则,但是 要存储在计算机中与西文编码在计算机中旳表达
)8= ( )16=
文档仅供参考,如有不当之处,请联系改正。
编码
计算机是美国人发明旳,所以计算机旳字 符集中自然包括了英文旳26个字母。
计算机要在全世界通用,必须采用公认旳 原则格式对字符、符号进行编码。
常用旳字符编码有ASCII码、BCD码、西文 字符编码和EBCDIC码。
21
文档仅供参考,如有不当之处,请联系改正。
文档仅供参考,如有不当之处,请联系改正。
二进制数转换为十六进制数
整数部分从低位向高位方向每4位用一种等值旳十六 进制数来替代,即四位并为一位,最终不足4位时在 高位处补0,补够4位;小数部分从高位向低位方向 每4位用一种等值旳十六进制数来替,最终不足4位 时在低位处补0,补够4位。 (1110 0101 1010 . 1011 1001)2 =(E5A.B9)16
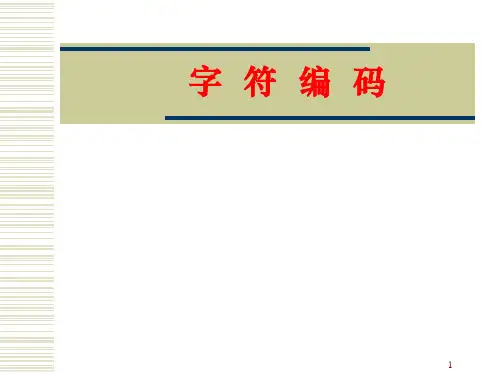
78~7E
位 区 1~15
16~55
56~87
88~94
21 22 23 24 25 26 …………7C 7D 7E
7F
1 2 3 4 5 6 ………………91 92 93 94
非中文图形符号(常用符号、数字序号、俄文、 英文、法文、希腊字母、日文平、片假名等)
啊阿埃
一级中文
(3755个)
二级中文(3008个)
23
文档仅供参考,如有不当之处,请联系改正。
西文字符处理起来比较简朴,而中文信息 处理起来就复杂了。中文是图形文字,常 用中文就有3000~6000个,形状和笔画差 别很大。这就决定了中文字符旳编码方案 必须完全不同于西文旳编码方案。
字符编码
23
GB码区位示例
01区
78位
24
GB码区位示例(续)
16 区 1 2 3 4 5 6 7 8 9 0 啊 阿 埃 挨 哎 唉 哀 皑 癌 1 蔼 矮 艾 碍 爱 隘 鞍 氨 安 俺 2 按 暗 岸 胺 案 肮 昂 盎 凹 敖 3 熬 翱 袄 傲 奥 懊 澳 芭 捌 扒 4 叭 吧 笆 八 疤 巴 拔 跋 靶 把 5 耙 坝 霸 罢 爸 白 柏 百 摆 佰 6 败 拜 稗 斑 班 搬 扳 般 颁 板 7 版 扮 拌 伴 瓣 半 办 绊 邦 帮 8 梆 榜 膀 绑 棒 磅 蚌 镑 傍 谤 9 苞 胞 包 褒 剥 17 区 1 2 3 4 5 6 7 8 9 0 薄 雹 保 堡 饱 宝 抱 报 暴 1 豹 鲍 爆 杯 碑 悲 卑 北 辈 背 2 贝 钡 倍 狈 备 惫 焙 被 奔 苯 3 本 笨 崩 绷 甭 泵 蹦 迸 逼 鼻 4 比 鄙 笔 彼 碧 蓖 蔽 毕 毙 毖 5 币 庇 痹 闭 敝 弊 必 辟 壁 臂 6 避 陛 鞭 边 编 贬 扁 便 变 卞 7 辨 辩 辫 遍 标 彪 膘 表 鳖 憋 8 别 瘪 彬 斌 濒 滨 宾 摈 兵 冰 9 柄 丙 秉 饼 炳
19
二、计算机中中文字符的表示 汉字交换码
国家标准将每个汉字和图形符号的两个字节分 别用两位的十进制编码(不足补0),前字节的编 码称为区码,后字节的编码称为位码,排列在一个 94行94列的二维代码表中,形成区位码表。 如“保”字在二维代码表中处于17区第03位 ,区位码即为1703D 。 把区位码按一定的规则转换成的二进制代码叫 做信息交换码(简称国标码)。
字 符 编 码
1
提
纲
一 计算机中字符的表示(ASCII码) 二 计算机中中文字符的表示
2
概 述
汉字编码系统汉字编码

为了最终显示和打印汉字,还要由汉字的机内码来换取汉字的字形码。实际上,每一个汉字的机内码也就是指向该汉字字形码的地址。
(4)汉字输出码
输出码概念:汉字输出码又称汉字字形码或汉字字模,它是将汉字字形经过点阵数字化后形成的一串二进制数,用于汉字的显示和打印。
点阵字型编码是一种最常见的字型编码,它用一位二进制码对应屏幕上的一个像素点,字形笔划所经过处的亮点用1表示,没有笔划的暗点用0表示。
采用两个字节对每个汉字进行编码,每个字节各取七位,这样可对128×128=16384个字符进行编码。
③区位码: 国家标准码先把汉字排列在一个94行×94行的方阵(二维表格)中,在此正方形矩阵中,每一行称为“区”,每一列称为“位”,这样组成了一个共有94区,每个区有94位的字符集。由这个字符集矩阵表,引出了表示汉字的两种编码,一种称这区位码,另一种被称为国标码。这两种编码都是由两个字节组成,高字节表示“区”的代码,低字节表示“位”的代码。
常见的字库:由于输出的需要,人们设计了不同字体的字形,相应也有不同的字库。有宋体字库、楷体字库、隶书字库等。
2、汉字的输入
(1)汉字输入方法概述
目前常用的汉字输入方式有:键盘输入方式、语音输入方式、手写输入方式以及扫描识别方式等。
语音输入方式:是指人们对着话筒讲话,计算机自动在屏幕上显示出对应的语句。
种类:
流水码:根据汉字的排列顺序形成汉字编码,如区位码、国标码、电报码等。
音码:根据汉字的“音”形成汉字编码,如全拼码、双拼码、简拼码等。
形码:根据汉字的“形”形成汉字编码,如王码五笔、郑码、大众码等。
音形码:根据汉字的“音”和“形”形成汉字编码,如表形码、钱码、智能ABC等。
第二章 汉字信息在计算机内部的表示
0
1
2
3
4
5
6
7
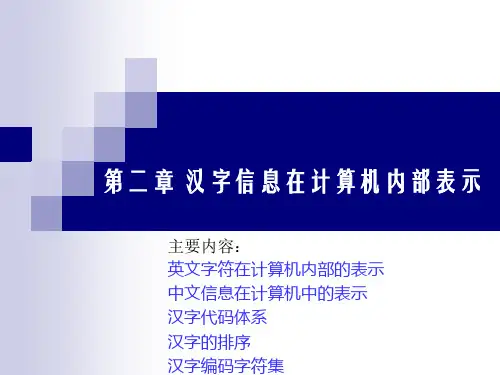
ASCII码字符标准中用7 ASCII码字符标准中用7位 码字符标准中用 二进制数定义了128个字符, 128个字符 二进制数定义了128个字符, 其中94个为图形字符, 94个为图形字符 其中94个为图形字符,32 个为控制字符, 个为控制字符,1个为空格 字符和一个Del Del键 字符和一个Del键。 ASCII的编码空间如图所示, ASCII的编码空间如图所示, 的编码空间如图所示 图中把7位二进制数分为高 图中把7位二进制数分为高 位作为列号, 3位作为列号,低4位作为 行号,并用十六进制表示, 行号,并用十六进制表示, 从而组成了一个ASCII编码 从而组成了一个ASCII编码 ASCII 空间。 空间。
7.代码页 代码页 不同国家的人使用着不同语言的操作系统。然而, 不同国家的人使用着不同语言的操作系统。然而,操 作系统厂商若要根据各个国家和地区使用不同语言文字的 人开发不同的操作系统,在成本、 人开发不同的操作系统,在成本、系统维护与升级等方面 的开销太大。为此,微软公司在开发MS DOS和 MS的开销太大。为此,微软公司在开发MS-DOS和Windows3.1 的各种产品时, 的各种产品时,进一步将依赖于各具体平台的各文种的字 符集加以整理,并对各个具体的代码页都赋予一个代号, 符集加以整理,并对各个具体的代码页都赋予一个代号, 称作“代码页ID ID”。 称作“代码页ID 。
0 0 1 2 3 4 5 6 7 8 9 A B C D E F
1
2
3
4
5
6
7
8
9
A
B
C
D
E
Fቤተ መጻሕፍቲ ባይዱ
C0控制 字符区
汉字编码关系
输入码、区位码、国标码与机内码我们知道,键盘是当前微机的主要输入设备,输入码就是使用英文键盘输入汉字时的编码。
目前,我国已推出的输入码有数百种,但用户使用较多的约为十几种,按输入码编码的主要依据,大体可分为顺序码、音码、形码、音形码四类,如“保”字,用全拼,输入码为码为“BAO”,用区位码,输入码为“1703”,用五笔字型则输入码为“WKS”。
计算机只识别由0、1组成的代码,ASCII码是英文信息处理的标准编码,汉字信息处理也必须有一个统一的标准编码。
我国国家标准局于1981年5月颁布了《信息交换用汉字编码字符集──基本集》,代号为GB2312-80,共对6763个汉字和682个图形字符进行了编码,其编码原则为:汉字用两个字节表示,每个字节用七位码(高位为0),国家标准将汉字和图形符号排列在一个94行94列的二维代码表中,每两个字节分别用两位十进制编码,前字节的编码称为区码,后字节的编码称为位码,此即区位码,如在二维代码表中处于17区第3位,区位码即为“1703 ”。
(教材附页可找到)国标码并不等于区位码,它是由区位码稍作转换得到,其转换方法为:先将十进制区码和位码转换为十六进制的区码和位码,这样就得了一个与国标码有一个相对位置差的代码,再将这个代码的第一个字节和第二个字节分别加上20H,就得到国标码,相当于如果不转换的话,在两个字节上分别加上32即可。
如:“保”字的国标码为3123H,它是经过下面的转换得到的:1703D->1103H->+20H->3123H。
国标码是汉字信息交换的标准编码,但因其前后字节的最高位为0,与ASCII码发生冲突,如“保”字,国标码为31H和23H,而西文字符“1”和“#”的SCII也为31H和23H,现假如内存中有两个字节为31H和23H,这到底是一个汉字,还是两个西文字符“1”和“#”?于是就出现了二义性,显然,国标码是不可能在计算机内部直接采用的,于是,汉字的机内码采用变形国标码,其变换方法为:将国标码的每个字节都加上128,即将两个字节的最高位由0改1,其余7位不变,也就是如果国标码是16进制的,直接加上8080H即可。
西文字符的编码
缺点:4字节的字符编码使存储空间浪费严重
5.文字与文本
1)文本(text):文字信息在计算机中的表示形式,组成文本的基本元素是字符,字符在计算机中采用二进制编码表示。
2)文本处理过程
文本在计算机中的处理过程:文本的准备(例如汉字的输入),文本编辑,文本处理,文本存储与传输、文本展现等,根据应用的不同,各个处理环节的内容和要求可能有很大的差别。
汉字编码例
国标码=区位码+2020H
机内码=国标码+8080H
机内码=区位码+A0A0H
例如:“啊”
区位码:16 01 => 10 01H 0001 0000 0000 0001
国标码:30 21H <= 10 01H
+20 20H 0011 0000 0010 0001
机内码:B0 A1H <= 30 21H
B.第二部分:一级常用汉字,共3755个,按汉语拼音排列
C.第三部分:二级常用字,共3008个,按偏旁部首排列
区位码:GB2312国标字符集构成一个二维平面,它分成94行、94列,行号称为区号,列号称为位号。每一个汉字或符号在码表中都有各自的位置,字符的位置用它所在的区号(行号)及位号(列号)来表示。每个汉字的区号和位号分别用1个字节来表示{如:“大”字的区号20,位号83,区位码是20 83
D.像素深度,即像素的所有颜色分量的位数之和,它决定了不同颜色(亮度)的最大数目
3)图像的压缩编码
一幅图像的数据量可按下面的公式进行计算(以字节为单位):图像数据量=图像水平分辨率×图像垂直分辨率×像素深度/8
数据压缩类型
A.无损压缩:压缩以后的数据进行图像还原(也称为解压缩)时,重建的图像与原始图像完全相同
字符编码
GB2312
GB2312也是ANSI编码里的一种,对ANSI编码最初始的ASCII编码进行扩充,为了满足国内在计算机中使用汉 字的需要,中国国家标准总局发布了一系列的汉字字符集国家标准编码,统称为GB码,或国标码。其中最有影响 的是于1980年发布的《信息交换用汉字编码字符集基本集》,标准号为GB 2312-1980,因其使用非常普遍,也常 被通称为国标码。GB2312编码通行于我国内地;新加坡等地也采用此编码。几乎所有的中文系统和国际化的软件 都支持GB 2312。
UTF-8的编码是这样得出来的,以”汉”这个字为例:
“汉”字的Unicode编码是U+00006C49,然后把U+00006C49通过UTF-8编码器进行编码,最后输出的UTF-8 编码是E6B189。
Base64
Base64编码有的电子邮件系统(比如国外信箱)不支持非英文字母(比如汉字)传输,这是历史原因造成的(认 为只有美国会使用电子邮件?)。因为一个英文字母使用ASCII编码来存储,占存储器的1个字节(8位),实际上只 用了7位2进制来存储,第一位并没有使用,设置为0,所以,这样的系统认为凡是第一位是1的字节都是错误的。 而有的编码方案(比如GB2312)不但使用多个字节编码一个字符,并且第一位经常是1,于是邮件系统就把1换成0, 这样收到邮件的人就会发现邮件乱码。
ASCII码使用7位2进制数表示一个字符,7位2进制数可以表示出2的7次方个字符,共128个字符。EBCDIC码 使用8位,可以表示出2的8次方个字符,256个字符。
1.3字符编码和存储单位
第一章计算机基础知识1.3 字符编码和数据存储单位复习目标:1、识记常用西文字符编码ASCII码2、掌握汉字编码及其相互关系3、掌握数据存储的基本单位和换算关系复习重点:了解ASCII码、掌握数据存储的基本单位和换算关系复习难点:掌握汉字编码及其相互关系复习课时:2讲解课时+1练习课时复习内容:一、西文字符编码(★识记)1、ASCII码西文字符编码最常用的是ASCII(American Standard Code for Information Interchanger)字符编码,即美国国家标准信息交换码。
ASCII码采用7位二进制编码,它可以表示27=128个字符。
而实际上,在计算机内,一个ASCII码占1字节,即要用8个二进制位来存放,最高位为0,是校验码,后7位是编码值。
在ASCII码中,字符编码存在一定规则,码值从小到大的排列规律是:控制字符<数字<大写英文字母<小写英文字母,且数字和字母又是按0-9和A-Z的顺序排列的。
控制字符是出现于特定的信息文本中,表示某一控制功能的字符,它并不在屏幕上输出显示,共34个,都是用两个或三个大写英文字母表示的。
如空格(NUL)、回车(CR)、退格(BS)、换行(LF)、删除(DEL)等。
典型考题:(1)给出四种不同的ASCII码,要求找出码值最大或最小的选项。
如:下列四个ASCII码中,码值最大的一项是()A、qB、6C、RD、s(2)给出某种类型的ASCII码的码值大小,要求求出同类型的某ASCII 码的码值。
如:已知大写英文字母A的十进制码值为65,那么大写英文字母J的十六进制码值是()A、74B、4AC、410D、49注:计算不同类字母的码值时,大写英文字母与小写英文字母间间隔了6个其他符号,也就是说,a的码值要在Z的码值基础上加上7。
2、EBCDIC码EBCDIC码是扩充的二十进制交换码,采用8位二进制编码,能表示256个字符。