
第三章 Linux内核分析
Linux高级系统级性能分析工具-perf
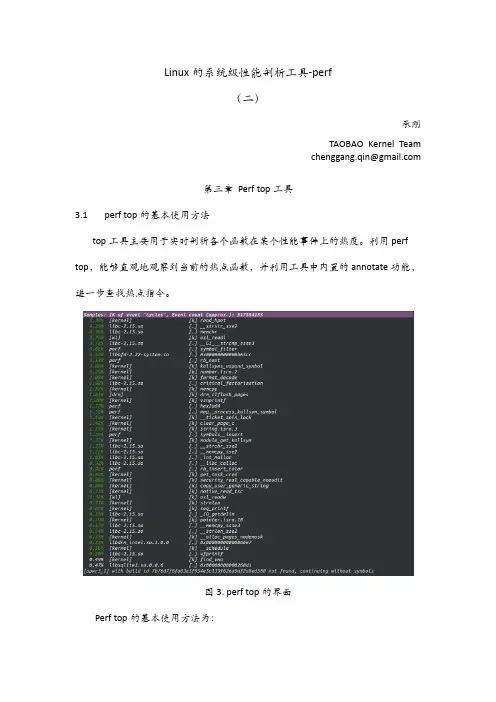
perf top 的界面会清爽很多。 ‘‐m’ or ‘‐‐mmap‐pages’ <n> 指定 perf 开辟的 mmap 页面的数量。mmap 缓存主要用于用户空间与内核空
‘‐p’ or ‘‐‐pid’ <pid> 该参数用于指定待分析进程的 pid。指定 pid 后,perf top 仅仅分析目标进程
以及目标进程创建的线程。 ‘‐t’ or ‘‐‐tid’ <tid> 该参数用于指定带分析线程的 tid。指定 tid 后,perf top 仅分析目标线程,
不包括此线程创建的其它线程。 ‘‐a’ or ‘‐‐all‐cpus’ 采集系统中所有 CPU 产生的性能事件。这也是 perf top 的默认情况。 ‘‐C’ or ‘‐‐cpu’ <cpu> 指定待分析的 CPU 列表。如系统中有 4 个 CPU,如果仅需采集 CPU0 与 CPU3
仅使用’‐c’指定的值作为采样周期。 ‘‐E’ or ‘‐‐entries’ <n> 指定界面上显示的符号数。如果用户仅希望查看 top <n>个符号,可以通过
此参数实现。 ‘‐U’ or ‘‐‐hide_user_symbols’ 仅显示属于内核的符号,隐藏属于用户程序的符号,即类型为[.]的符号。 ‘‐‐tui’ 使用 tui 界面。tui 为 perf top 的默认界面。如前所述,tui 界面需要 newt 软
的数据,可通过如下方法调用 perf top: $perf top ‐C 0,3
‘‐k’ or ‘‐‐vmlinux’ <file> 指定带符号表的内核映像所在的路径。与 GDB 类似,perf 只有在 DSO 存在
linux,内核的物理内存分配的基本方式

Linux内核的物理内存分配基本方式在Linux内核中,物理内存分配的基本方式可以通过以下几个方面进行解释。
1. 内核启动阶段的物理内存分配在Linux内核启动阶段,内核需要为自身和各个子系统分配物理内存。
这个过程包括以下几个步骤:•内核从BIOS或者bootloader中获取系统的物理内存信息。
•内核根据系统的内存布局,将物理内存分成多个区域,如低端内存、高端内存等。
•内核为自身分配一部分物理内存,包括内核代码、数据、堆栈等。
•内核为各个子系统分配物理内存,如设备驱动、文件系统等。
2. 动态分配物理内存在运行时,Linux内核还需要动态分配物理内存来满足进程和内核的需求。
这个过程包括以下几个关键点:页框分配:内核使用页框作为最小的内存分配单位。
当一个进程或内核需要分配物理内存时,内核会使用页框分配算法来选择可用的物理页框。
页框可以通过使用位图或者链表等数据结构来管理。
伙伴系统:为了高效地管理和分配物理内存,Linux内核采用了伙伴系统。
伙伴系统将整个物理内存空间分成不同大小的块(通常是2的幂次方),每个块称为一个伙伴块。
当一个进程需要分配内存时,内核会在合适的伙伴块中找到一个合适大小的块来满足需求。
页面回收:当物理内存不足时,Linux内核会使用页面回收机制来回收部分物理内存。
页面回收可以通过将不再使用的内存页面写回硬盘,或者将内存页面移动到交换分区来实现。
回收后的物理内存可以重新分配给其他进程或内核使用。
3. 内存管理算法为了高效地管理物理内存,Linux内核采用了一些内存管理算法。
其中一些重要的算法包括:最先适应算法(First Fit):内核首先查找第一个满足分配要求的伙伴块。
这个算法简单直观,但可能导致伙伴块的碎片化。
最佳适应算法(Best Fit):内核在所有可用的伙伴块中选择最小的一个来满足分配需求。
这个算法可以减少碎片化,但需要更多的搜索开销。
循环首次适应算法(Next Fit):内核在上一次分配的位置开始搜索,直到找到第一个满足分配要求的伙伴块。
linux操作系统的结构及详细说明
linux操作系统的结构及详细说明linux的操作系统的结构你了解多少呢?下面由店铺为大家整理了linux操作系统的结构及详细说明的相关知识,希望对大家有帮助!linux操作系统的结构及详细说明:一、 linux内核内核是操作系统的核心,具有很多最基本功能,它负责管理系统的进程、内存、设备驱动程序、文件和网络系统,决定着系统的性能和稳定性。
Linux 内核由如下几部分组成:内存管理、进程管理、设备驱动程序、文件系统和网络管理等。
系统调用接口:SCI 层提供了某些机制执行从用户空间到内核的函数调用。
这个接口依赖于体系结构,甚至在相同的处理器家族内也是如此。
SCI 实际上是一个非常有用的函数调用多路复用和多路分解服务。
在 ./linux/kernel 中您可以找到 SCI 的实现,并在 ./linux/arch 中找到依赖于体系结构的部分。
1. 内存管理对任何一台计算机而言,其内存以及其它资源都是有限的。
为了让有限的物理内存满足应用程序对内存的大需求量,Linux 采用了称为“虚拟内存”的内存管理方式。
Linux 将内存划分为容易处理的“内存页”(对于大部分体系结构来说都是 4KB)。
Linux 包括了管理可用内存的方式,以及物理和虚拟映射所使用的硬件机制。
不过内存管理要管理的可不止 4KB 缓冲区。
Linux 提供了对 4KB 缓冲区的抽象,例如 slab 分配器。
这种内存管理模式使用 4KB 缓冲区为基数,然后从中分配结构,并跟踪内存页使用情况,比如哪些内存页是满的,哪些页面没有完全使用,哪些页面为空。
这样就允许该模式根据系统需要来动态调整内存使用。
为了支持多个用户使用内存,有时会出现可用内存被消耗光的情况。
由于这个原因,页面可以移出内存并放入磁盘中。
这个过程称为交换,因为页面会被从内存交换到硬盘上。
内存管理的源代码可以在 ./linux/mm 中找到。
2 .进程管理进程实际是某特定应用程序的一个运行实体。
Linux内核数据结构之kfifo详解

Linux内核数据结构之kfifo详解本⽂分析的原代码版本: 2.6.24.4kfifo的定义⽂件: kernel/kfifo.ckfifo的头⽂件: include/linux/kfifo.h kfifo是内核⾥⾯的⼀个First In First Out数据结构,它采⽤环形循环队列的数据结构来实现,提供⼀个⽆边界的字节流服务,并且使⽤并⾏⽆锁编程技术,即当它⽤于只有⼀个⼊队线程和⼀个出队线程的场情时,两个线程可以并发操作,⽽不需要任何加锁⾏为,就可以保证kfifo的线程安全。
下⽂着重于代码剖析,各部分代码后⾯有关键点说明,同时可参考注释进⾏理解:struct kfifo {unsigned char *buffer; /* the buffer holding the data : ⽤于存放数据的缓存 */unsigned int size; /* the size of the allocated buffer : 空间的⼤⼩,在初化时将它向上扩展成2的幂,为了⾼效的进⾏与操作取余,后⾯会详解 */unsigned int in; /* data is added at offset (in % size) :如果使⽤不能保证任何时间最多只有⼀个读线程和写线程,需要使⽤该lock实施同步*/unsigned int out; /* data is extracted from off. (out % size) :⼀起构成⼀个循环队列。
in指向buffer中队头,⽽且out指向buffer中的队尾 */spinlock_t *lock; /* protects concurrent modifications :⽤于put和get过程中加锁防⽌并发*/}; 以上是kfifo的数据结构,kfifo主要提供了如下操作: //根据给定buffer创建⼀个kfifostruct kfifo *kfifo_init(unsigned char *buffer, unsigned int size,gfp_t gfp_mask, spinlock_t *lock);//给定size分配buffer和kfifostruct kfifo *kfifo_alloc(unsigned int size, gfp_t gfp_mask,spinlock_t *lock);//释放kfifo空间void kfifo_free(struct kfifo *fifo);//向kfifo中添加数据unsigned int kfifo_put(struct kfifo *fifo,const unsigned char *buffer, unsigned int len);//从kfifo中取数据unsigned int kfifo_get(struct kfifo *fifo,unsigned char *buffer, unsigned int len); //获取kfifo中有数据的buffer⼤⼩ unsigned int kfifo_len(struct kfifo *fifo);(1)初始化部分:/* 创建队列 */struct kfifo *kfifo_init(unsigned char *buffer, unsigned int size,gfp_t gfp_mask, spinlock_t *lock){struct kfifo *fifo;/* size must be a power of 2 :判断是否为2的幂*/BUG_ON(!is_power_of_2(size));fifo = kmalloc(sizeof(struct kfifo), gfp_mask);if (!fifo)return ERR_PTR(-ENOMEM);fifo->buffer = buffer;fifo->size = size;fifo->in = fifo->out = 0;fifo->lock = lock;return fifo;}/* 分配空间 */struct kfifo *kfifo_alloc(unsigned int size, gfp_t gfp_mask, spinlock_t *lock){unsigned char *buffer;struct kfifo *ret;if (!is_power_of_2(size)) { /*判断是否为2的幂 */BUG_ON(size > 0x80000000);size = roundup_pow_of_two(size); /* 如果不是则向上扩展成2的幂 */}buffer = kmalloc(size, gfp_mask);if (!buffer)return ERR_PTR(-ENOMEM);ret = kfifo_init(buffer, size, gfp_mask, lock);if (IS_ERR(ret))kfree(buffer);return ret;}巧妙点①:保证buffer size为2的幂 通常循环队列⼊队和出队操作要不断的对size 进⾏求余,⼀般采⽤ mInOffset % size(其他类似) 的⽅法,但是乘、除和求余等会执⾏多次加法器运算,它们没有单纯的加法运算效率⾼,更没有位运算效率⾼。
Linux内核模块

⼯作模式⼯作性质层次权限影响竞态运⾏⽅式应⽤程序USR 模式策略性⽤户层低局部局部主动内核模块SVC 模式功能性内核层⾼全局全局被挡Linux 内核模块1、什么是内核模块?内核模块是Linux 提供的⼀种机制,允许在内核运⾏时动态加载进内核中,具有两个特点: 1)内核模块本⾝不编译⼊内核映像,有效控制缩减内核镜像⼤⼩ 2)内核模块⼀旦被加载,他就和内核中的其他部分完全⼀样2、为什么需要内核模块?如果在内核编译时把所有的功能都编译进去,就会导致内核很⼤,⽽且要往内核中添加或删除功能时必须重新编译内核⽐如在Ubuntu 在通⽤PC 平台上,预先⽆法知道需要什么设备,就不知道预先编译什么驱动。
3、内核模块和应⽤程序的区别4、内核模块的基本构成|——两个函数(⼀般需要)| |——模块初始化(加载)函数:当内核模块加载进内核的时候,做⼀些准备⼯作| |——模块卸载函数:回收、清理资源||——授权(许可证声明)(必须):Linux 内核受GPL (General Public License )授权约束|——模块参数(可选):模块被加载时可以被传递给它的值,本⾝对应模块内的全局变量|——模块导出符号(可选)|——模块信息说明(可选)5、模块加载(初始化)函数⼀般以 __init 标识声明函数命名规则 xxx_init xxx 设备名 init 功能名(初始化)函数形式:static ini __init xxx_init(void ){/* 初始化代码* 返回值: 成功:0 失败:负数,绝对值是错误码* 应⽤层得到的返回值是-1,错误码保存到errno (每个进程有⼀个); 标准化errno.h 已经明确定义linux/errno.h */}注册⽅式: module_init(x); x 为模块初始化函数的⾸地址 6、模块卸载函数⼀般以 __exit 标识声明函数命名规则 xxx_exit xxx 设备名 exit 功能名(卸载)static ini __exit xxx_exit(void ){/* 释放代码 */}注册⽅式: module_exit(x); x为模块卸载函数的⾸地址7、模块许可证声明MODULE_LICENSE(_license) //_license就是授权名称的字符串//"GPL" [GNU Public License v2 or later]//"GPL v2" [GNU Public License v2]//"GPL and additional rights" [GNU Public License v2 rights and more]//"Dual BSD/GPL" [GNU Public License v2 or BSD license choice]//"Dual MIT/GPL" [GNU Public License v2 or MIT license choice]//"Dual MPL/GPL" [GNU Public License v2 or Mozilla license choice]8、模块声明与描述在Linux内核模块中,我们可以⽤MODULE_AUTHOR、MODULE_DESCRIPTION、MODULE_VERSION、MODULE_DEVICE_TABLE、MODULE_ALIAS分别来声明模块的作者、描述、版本、设备表和别名,例如:MODULE_AUTHOR(author);MODULE_DESCRIPTION(description);MODULE_VERSION(version_string);MODULE_DEVICE_TABLE(table_info);MODULE_ALIAS(alternate_name);对于USB、PCI等设备驱动,通常会创建⼀个MODULE_DEVICE_TABLE,表明该驱动模块⽀持的设备,如:/* 对应此驱动的设备列表 */static struct usb_device_id skel_table [ ] = {{USB_DEVICE(USB_SKEL_VENDOR_ID, USB_SKEL_PRODUCT_ID) }, { } /* 表结束 */}};MODULE_DEVICE_TABLE (usb, skel_table);9、模块参数:在加载模块时,可以给模块传参头⽂件 linux/moduleparam.hA、传递普通变量module_param(name, type, perm);声明内核模块参数/*name - 接收参数的变量名type - 变量类型 Standard types are: byte, short, ushort, int, uint, long, ulong charp: a character pointer bool: a bool, values 0/1, y/n, Y/N. invbool: the above, only sense-reversed (N = true)perm - 权限 头⽂件 linux/stat.h #define S_IRWXUGO (S_IRWXU|S_IRWXG|S_IRWXO) #define S_IALLUGO (S_ISUID|S_ISGID|S_ISVTX|S_IRWXUGO) #define S_IRUGO (S_IRUSR|S_IRGRP|S_IROTH) #define S_IWUGO (S_IWUSR|S_IWGRP|S_IWOTH) #define S_IXUGO (S_IXUSR|S_IXGRP|S_IXOTH)*/范例:int i = 0;module_param(i, int, 0644);运⾏:# insmod xxx.ko i=10B、传递数组参数module_param_array(name, type, nump, perm)/*声明内核模块数组参数name - 数组名type - 数组成员类型nump – ⼀个指向保存数组长度的整型变量的指针perm - 权限*/范例:int arr[] = {1,2,3,4,5,6};int len=0;module_param(arr, int, &len, 0644);运⾏:# insmod xxx.ko arr=1,2,3,4,5C、传递字符串参数module_param_string(name, string, len, perm)/*声明内核模块字符串参数name - 字符串缓存的外部名(传⼊变量名)string - 字符串缓存的内部名nump - 数组的数量perm - 权限*/范例:char insidestr[] = "hello world";module_param(extstr, insidestr, szieof(insidestr), 0644);运⾏:# insmod xxx.ko extstr="hello"10、编译内核模块如果⼀个内核模块要加载到某个内核中运⾏,则这个模块必须使⽤编译该内核镜像的源码进⾏编译,否则运⾏时会出错A、头⽂件(语法问题)B、编译结果(最主要影响)编译时符号表(只在编译时使⽤)运⾏时内核符号表# cat /proc/kallsyms 运⾏时内核符号表C、编译系统⽰例Makefile:# 内核模块的Makefile(模块源码在内核源码外,且内核先编译)# 1、找内核的Makefile# 2、内核的Makefile找内核模块的Makeifle内核模块的Makeifle定义要编译对象ifneq ($(KERNELRELEASE),)#要编译对象表⽰把demo.c编译成demo.ko obj-m = demo.oelse#内核源码⽬录KERNELDIR := /lib/modules/$(shell uname -r)/buildPWD := $(shell pwd)modules: $(MAKE) -C $(KERNELDIR) M=$(PWD) modulesendifclean: rm -rf .tmp_versions Module.symvers modules.order .tmp_versions .*.cmd *.o *.ko *.mod.cKERNELRELEASE 是在内核源码的顶层Makefile中定义的⼀个变量,在第⼀次读取执⾏此Makefile时,KERNELRELEASE没有被定义,所以make将读取执⾏else之后的内容。
linux系统的内核子系统之间的关系
linux系统的内核子系统之间的关系Linux系统的内核子系统之间的关系Linux操作系统的内核是其最核心的组成部分,它负责管理和控制整个系统的运行。
内核由多个子系统组成,每个子系统负责不同的功能模块,它们之间相互配合,共同完成系统的各项任务。
本文将介绍几个常见的内核子系统及其之间的关系。
1. 文件系统子系统文件系统子系统负责管理文件和目录的存储和访问。
它提供了对文件系统的抽象,使用户和应用程序可以通过文件路径来访问文件和目录。
文件系统子系统由虚拟文件系统层、各种具体的文件系统类型和存储设备驱动程序组成。
虚拟文件系统层提供了一个统一的接口,使不同的文件系统可以以相同的方式进行访问。
具体的文件系统类型如ext4、NTFS等负责实现不同的文件系统格式,而存储设备驱动程序则负责控制硬盘、闪存等存储设备的读写。
2. 进程管理子系统进程管理子系统负责管理系统中的进程。
它负责创建、终止和调度进程,并提供进程间通信和同步的机制。
进程管理子系统包括进程调度器、进程控制块、进程间通信和同步机制等。
进程调度器决定了系统中运行哪些进程以及它们的优先级和时间片分配。
进程控制块保存了进程的状态信息,包括程序计数器、寄存器和运行时堆栈等。
进程间通信和同步机制如管道、信号量、消息队列等,使不同进程之间可以进行数据交换和协调工作。
3. 设备驱动子系统设备驱动子系统负责管理和控制硬件设备的访问。
它提供了对设备的抽象接口,使应用程序可以通过统一的方式访问不同类型的设备。
设备驱动子系统包括字符设备驱动和块设备驱动。
字符设备驱动用于管理字符设备,如串口、键盘等,它提供了以字节为单位的读写接口。
块设备驱动用于管理块设备,如硬盘、闪存等,它提供了以块为单位的读写接口。
设备驱动子系统还包括中断处理、DMA控制等功能,用于处理设备的中断请求和数据传输。
4. 网络子系统网络子系统负责管理和控制系统的网络功能。
它提供了网络协议栈、网络接口和网络设备驱动等功能。
linux内核中断处理的irq_thread机制 -回复
linux内核中断处理的irq_thread机制-回复Linux内核中断处理的irq_thread机制是一种处理中断请求的机制,旨在提高中断处理的效率和可扩展性。
在本文中,我们将详细介绍irq_thread 的原理和实现细节,并分析其对系统性能的影响。
一、引言随着计算机系统的发展,硬件设备的种类和数量不断增加,从而引发了对中断处理的需求。
在传统中断处理模式下,Linux内核需要通过一个叫做中断处理程序(interrupt handler)的功能模块来处理硬件设备发出的中断请求。
然而,这种模式在多核系统和高速设备的环境下往往存在性能瓶颈和可扩展性问题。
为了解决这些问题,Linux内核引入了irq_thread机制。
二、irq_thread机制的原理irq_thread机制的核心思想是将中断处理程序从内核上下文中移出,转而在用户态创建一个专门的线程来处理中断请求。
这个线程被称为irq_thread。
irq_thread在内核注册的中断向量表中占据一个特殊的槽位,当对应的硬件设备发生中断时,硬件会触发相应的中断请求,并将中断处理程序的控制权交给irq_thread。
在irq_thread的实现中,内核通过分配一个独立的线程栈和一组寄存器保存irq_thread的上下文。
同时,irq_thread中还有一个运行队列,用于保存需要处理的中断任务。
当一个中断请求到达时,irq_thread会从硬件设备读取中断状况,并将相应的中断任务放入运行队列。
三、irq_thread机制的实现细节1. 中断控制器:irq_thread机制需要硬件支持,其中关键的组件是中断控制器(interrupt controller)。
中断控制器是一种硬件设备,用于管理和分发中断请求。
在Linux内核中,主流的中断控制器有APIC(Advanced Programmable Interrupt Controller)和IOAPIC(Input/Output Advanced Programmable Interrupt Controller)等。
Linux操作系统修改内核参数的三种方法详细说明
Linux操作系统修改内核参数的三种方法详细说明linux内核的参数设置怎么弄呢,Linux 操作系统修改内核参数有以下三种方式:修改 /etc/sysctl.conf 文件;在文件中加入配置项,格式为 key = value,保存修改后的文件,执行命令 sysctl -p 加载新配置。
使用 sysctl 命令临时修改;如:sysctl -w net.ipv4.tcp_mem = “379008 505344 758016”直接修改/proc/sys/ 目录中的文件。
如:echo “379008 505344 758016” 》 /proc/sys/net/ipv4/tcp_mem 注意:第一种方式在重启操作系统后自动永久生效;第二种和第三种方式在重启后失效。
内核参数kernel.core_uses_pi d = 1core_uses_pid 可以控制 core 文件的文件名中是否添加 pid 作为扩展名。
设置为1,表示添加 pid 作为扩展名,生成的 core 文件格式为core.xxx;设置为0(默认),表示生成的 core 文件统一命名为 core。
kernel.core_pat te rn = corecore_pattern 可以控制 core 文件的保存位置和文件格式。
如:kernel.core_pattern = “/corefile/core-%e-%p-%t”,表示将core 文件统一生成到 /corefile 目录下,产生的文件名为 core-命令名-pid-时间戳。
以下是参数列表:%p - insert pid into filename 添加 pid%u - insert current uid into filename 添加当前 uid%g - insert current gid into filename 添加当前 gid%s - insert signal that caused the coredump into the filename 添加导致产生 core 的信号%t - insert UNIX ti me that the coredump occurred into filename 添加 core 文件生成时的 unix 时间%h - insert hostname where the coredump happened into filename 添加主机名%e - insert coredumping executable name into filename 添加命令名kernel.msgmax = 8192进程间的消息传递是在内核的内存中进行的。
linux内核
15.4 内核编译系统
Linux内核代码的复杂,需要一个强大的工程管理系统 ,幸好GNU提供了Makefile机制,此外,内核的开发者们还 提供了KBuild机制。通过Makefile和KBuild的结合,可以 出色的管理Linux内核代码。Linux内核的编译系统和代码 结构是紧密联系的,了解内核编译系统对分析内核代码和编 译内核都有帮助作用。
15.2.7 依赖体系结构的代码
Linux内核支持众多体系结构,内核把与设备无关的代 码放在arch目录,对应的头文件放在include/asm-<体系名 称>目录下。这样的划分代码结构清晰,同时提高了代码的 复用率。在arch目录里,每个子目录对应一种体系结构,存 放这种体系结构对应的代码,如果代码较多会单独建立一个 目录,例如arch/arm目录下,有一个kernel目录,存放的是 kernel目录中在arm体系结构上特有的函数或者实现方法; 在arch/i386目录存放了Intel X86体系结构的代码,不仅有 kernel目录,而且还有多个目录,例如mm目录包含了x86 体系上内存管理的实现方法,math-emu包含了x86体系上 浮点数模拟的实现等。读者在阅读内核代码的时候可以从一 个体系结构代码入手,对不同体系结构移植代码的主要工作 是arch里面的代码。
15.4.3 内核编译文件分析
Linux内核代码使用KBuild作为Makefile的基础架构。 Kbuild定义了若干的内置变量,本节介绍Kbuild的主要内置 变量和常用方法。 1.目标定义 2.内嵌对象 - obj-y 3.可加载模块 - obj-m 4.导出符号目标 5.库文件 - lib-y 6.目录递归 7.编译标记 8.依赖关系 9.特殊规则 10.$(CC)支持功能
Linux内核bridge浅析
Linux内核bridge浅析Linux网桥模型:Linux内核通过一个虚拟的网桥设备来实现桥接的,这个设备可以绑定若干个以太网接口设备,从而将它们桥接起来。
如下图所示:网桥设备br0绑定了eth0和eth1。
对于网络协议栈的上层来说,只看得到br0,因为桥接是在数据链路层实现的,上层不需要关心桥接的细节。
于是协议栈上层需要发送的报文被送到br0,网桥设备的处理代码再来判断报文该被转发到eth0或是eth1,或者两者皆是;反过来,从eth0或从eth1接收到的报文被提交给网桥的处理代码,在这里会判断报文该转发、丢弃、或提交到协议栈上层。
而有时候eth0、eth1也可能会作为报文的源地址或目的地址,直接参与报文的发送与接收(从而绕过网桥)。
相关数据结构:其中最左边的net_device是一个代表网桥的虚拟设备结构,它关联了一个net_bridge结构,这是网桥设备所特有的数据结构。
在net_bridge结构中,port_list成员下挂一个链表,链表中的每一个节点(net_bridge_port结构)关联到一个真实的网口设备的net_device。
网口设备也通过其br_port指针做反向的关联(那么显然,一个网口最多只能同时被绑定到一个网桥)。
net_bridge结构中还维护了一个hash表,是用来处理地址学习的。
当网桥准备转发一个报文时,以报文的目的Mac地址为key,如果可以在hash表中索引到一个net_bridge_fdb_entry结构,通过这个结构能找到一个网口设备的net_device,于是报文就应该从这个网口转发出去;否则,报文将从所有网口转发。
网桥数据包的处理流程:接收过程:对于数据包的处理流程并没有明显的主线,主要就是根据内核代码中网桥部分的源码进行分析。
网口设备接收到的报文最终通过net_receive_skb函数被网络协议栈所接收。
这个函数主要做三件事情:1、如果有抓包程序需要skb,将skb复制给它们;2、处理桥接;3、将skb提交给网络层。