
厦门大学机器学习考试题
第一题 判断题(10分,每小题1 分)
[1] 逻辑斯蒂回归模型可以用来做分类,但是SVM 不能用来做回归。
( ) [2] 训练数据较少时更容易发生过拟合。
( )
[3] 如果回归函数A 比B 简单,则A 一定会比B 在测试集上表现更好。
( )
[4] 在核回归中,最影响回归的过拟合性和欠拟合之间平衡的参数为核函数的宽度。
( ) [5] 在AdaBoost 算法中,所有被错分的样本的权重更新比例相同。
( ) [6] Boosting 的一个优点是不会过拟合。
( )
[7] 梯度下降有时会陷于局部极小值,但EM 算法不会。
( ) [8] SVM 对噪声(如来自其他分布的噪声样本)鲁棒。
( ) [9] 经验风险最小化在一定条件下与极大似然估计是等价的。
( )
[10] 在回归分析中,最佳子集选择可以做特征选择;Lasso 模型也可以实现特征选择。
( )
第二题 统计学习方法的三要素(10分)
1. (5分)H 是一个函数空间,(,)p x y 是X Y ⨯上一个概率测度,1{,}n i i i D x y ==是X Y ⨯的一个子集(采样),()(,,(,)X Y
f L x y f x y dp ε⨯=⎰
,1
1()(,,(,))n
i i i i i f L x y f x y n ε==
∑, {}{}arg min (),arg min (),H z f H
f H
f f f f εε∈∈==请问:
[1] (2分)()()z H f f εε-随着N 增大而增大吗?为什么? [2] (3分)()()z H f f εε-随着H 增大而增大吗?为什么?
2. (5分) 比较感知机、逻辑斯蒂回归模型、AdaBoost 和SVM 的损失函数。
第三题 产生式模型和判别式模型 (10分)
[1] (5分)解释产生式模型和判别式模型,并分析二者的不同点; [2] 列出三种判别式模型(3分)和两种产生式模型(2分)
第四题 EM and Naive Bayes (15分)
[1] (5分)概述EM 算法的用途及其主要思想;
[2] (10分)EM 算法可以用到朴素贝叶斯法的非监督学习,写出其算法。
第五题 HMM (10分) 考虑盒子和球模型
,状态集合
,观测集合
,
0.50.20.30.30.50.20.20.30.5A ⎡⎤⎢⎥=⎢⎥⎢⎥⎣⎦,0.50.50.40.60.70.3B ⎡⎤⎢⎥=⎢⎥
⎢⎥⎣⎦
,
设T=3,O=(红、白、红),试用前向算法计算
.
第六题 SVM (15分)
考虑利用线性支持向量机对如下两类可分数据进行分类:
+1:(1,1), (2,2), (2,0) -1:(0,0), (1,0), (0,1)
[1] (4分)在图中做出这6个训练点,构造具有最优超平面和最优间隔的权重向量; [2] (3分)哪些是支撑向量?
[3] (8分)通过寻找拉格朗日乘子i α来构造在对偶空间的解,并将它与[1]中的结果比较。
第七题 Logistic 回归模型(15分)
如图1(a)所示,数据采用简化的线性logistic 回归模型进行两类分类,即,
()()()
12112211221
1,,1exp ()P Y x w w g w x w x w x w x ==+=
+-+ 为了简化,不采用偏差w 0,训练数据可以被完全分开(训练误差为0,如图1(b)所示的L 1)。
++
++
+
+o o o o o o
o
o ++
++
+
+o o o
o o o o
o
图1(a) 二维训练数据
图1(b) 可能的决策面:L 1,L 2,L 3,L 4L 1
L 2
L 3L
4
[1] (8分)考虑一个正则化的方法,即最大化()2
1221
log ,,2
N i i i C P y x w w w =-
∑,注意只有被惩
罚。
则当C 很大时,如图1(b)所示的4 个决策边界中,哪条线可能是由该正则方法得到的?L 2、L 3 和L 4 可以通过正则
得到吗?简要说明理由。
[2] (7分)如果我们将正则项给出L 1 范式,即最大化()()12121
log ,,2
N i i i C
P y x w w w w =-
+∑,则随着 C 增大,下面哪种情形可能出现(单选) ?注:简要说明理由 (A) 将变成0,然后 也将变成0。
(B)将变成0,然后也将变成0。
(C)和
将同时变成0。
(D)两个权重都不会变成0,只是随着C 的增大而减小为0。
第八题 AdaBoost (15分)
考虑如下图2所示的训练样本,其中’X’和’O’分别表示正样本和负样本。
采用AdaBoost 算法对上述样本进行分类。
在Boosting 的每次迭代中,选择加权错误率最小的弱分类器。
假设采用的弱分类器为平行两个坐标轴的线性分类器。
0.511.522.533.544.555.560
1
2
3
4
5
6
-1+1
图2 训练数据
[1]
(4分)在图2中标出第一次迭代选择的弱分类器(L 1),并给出决策面的‘+’和‘-’面。
[2] (4分)在图2中用圆圈标出在第一次迭代后权重最大的样本,其权重是多少? [3] (4分)第一次迭代后权重最大的样本在经过第二次迭代后权重变为多少?
[4]
(3分)强分类器为弱分类器的加权组合。
则在这些点中,存在被经过第二次迭代后的
强分类器错分的样本吗?给出简短理由。
(含答案)机器学习第一阶段测试题

机器学习第一阶段测试题一、选择题1.以下带佩亚诺余项的泰勒展开式错误的一项是(D)A.)x (o x !x !x e x 33231211++++= B.)x (o x *x x arcsin 33321++=C.)x (o x !x !x x sin 5535131++-= D.)x (o x !x !x cos 44241211+-+=分析:)x (o x !x !x cos 44241211++-=2.以下关于凸优化的说法错误的一项是(C )A.集合C 任意两点间线段均在集合C 内,则C 为凸集B.集合C 的凸包是能够包含C 的最小凸集C.多面体不一定是凸集D.线性变换能保持原集合的凸性分析:多面体是指有限半空间和超平面的交集,多面体一定是凸集3.以下说法错误的一项是(C )A.当目标函数是凸函数时,梯度下降法的解是全局最优解B.进行PCA 降维时需要计算协方差矩阵C.沿负梯度下降的方向一定是最优的方向D.利用拉格朗日函数能解带约束的优化问题分析:沿负梯度方向是函数值下降最快的方向但不一定是最优方向4.K-means 无法聚以下哪种形状样本?()A.圆形分布B.螺旋分布C.带状分布D.凸多边形分布分析:基于距离的聚类算法不能聚非凸形状的样本,因此选B5.若X 1,X 2,...X n 独立同分布于(2σ,μ),以下说法错误的是(C )A.若前n 个随机变量的均值,对于任意整数ε,有:B.随机变量的收敛到标准正态分布C.随机变量收敛到正态分布D.样本方差其中样本均值分析:A:大数定理概念;B、C:中心极限定理概念;C 错,应该收敛到正态分布D:样本的统计量公式二、公式推理题1.请写出标准正态分布的概率密度函数、期望、以及方差分析:概率密度函数:2221x e π)x (f -=;期望:0=)x (E ;方差:1=)x (D 2.请根据表中的分类结果混淆矩阵给出查准率(准确率)P 和查全率(召回率)R 的计算公式真实情况预测结果正例反例正例TP(真正例)FN(假反例)反例FP(假正例)TN(真反例)分析:FP TP TP P +=,NF TP TP R +=三、简答题1.求函数y ln x )y ,x (f 32+=的梯度向量分析:)y)y ,x (f ,x )y ,x (f ()y ,x (f ∂∂∂∂=∇,所以答案为(2x,3/y)∑==n i i n X n Y 111=<-∞→}ε|μY {|P lim n n σn μn X Y n i i n -=∑=1∑==n i i n X Y 1)σ,μ(N 2∑=--=n i i )X X (n S 1211)σn ,μn (N 2∑==n i i X n X 112.列举你知道的无约束最优化方法(至少三个),并选一种方法进行详细介绍分析:梯度下降法,牛顿法,拟牛顿法,共轭梯度法...(介绍略)3.请简要叙述正则化项中的L1和L2方法分析:1正则化和L2正则化可以看做是损失函数的惩罚项。
机器学习基础期末考试试题

机器学习基础期末考试试题一、选择题(每题2分,共20分)1. 在机器学习中,下列哪个算法属于监督学习算法?A. 决策树B. K-meansC. 遗传算法D. 随机森林2. 以下哪个是线性回归的假设条件?A. 特征之间相互独立B. 特征与目标变量之间存在非线性关系C. 目标变量的误差项服从正态分布D. 所有特征都是类别型变量3. 支持向量机(SVM)的主要目标是什么?A. 找到数据点之间的最大间隔B. 减少模型的复杂度C. 增加模型的泛化能力D. 所有选项都正确4. 在深度学习中,卷积神经网络(CNN)通常用于处理哪种类型的数据?A. 音频数据B. 图像数据C. 文本数据D. 时间序列数据5. 交叉验证的主要目的是:A. 减少模型的过拟合B. 增加模型的复杂度C. 减少训练集的大小D. 增加模型的运行时间二、简答题(每题10分,共30分)6. 解释什么是过拟合,并给出一个避免过拟合的策略。
7. 描述随机森林算法的基本原理,并简述其相对于决策树的优势。
8. 解释梯度下降算法的工作原理,并说明为什么它在优化问题中如此重要。
三、计算题(每题25分,共50分)9. 假设你有一个线性回归模型,其目标函数为 \( J(\theta) =\frac{1}{2m} \sum_{i=1}^{m} (h_\theta(x^{(i)}) - y^{(i)})^2 \),其中 \( h_\theta(x) = \theta_0 + \theta_1 x_1 + \theta_2x_2 \)。
给定以下数据点:\[\begin{align*}x_1 & : [1, 2, 3] \\x_2 & : [1, 3, 4] \\y & : [2, 4, 5]\end{align*}\]请计算该模型的损失函数 \( J(\theta) \)。
10. 给定一个二分类问题的数据集,使用逻辑回归模型进行分类。
如果模型的决策边界是 \( w_1 x_1 + w_2 x_2 - \theta = 0 \),其中\( w_1 = 0.5 \),\( w_2 = -1 \),\( \theta = 0.5 \)。
机器学习考试题目及答案
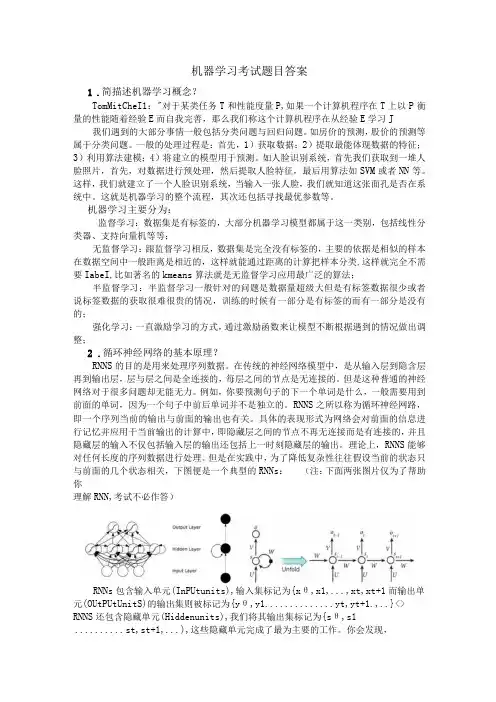
机器学习考试题目答案1.简描述机器学习概念?TomMitCheI1:"对于某类任务T和性能度量P,如果一个计算机程序在T上以P衡量的性能随着经验E而自我完善,那么我们称这个计算机程序在从经验E学习J 我们遇到的大部分事情一般包括分类问题与回归问题。
如房价的预测,股价的预测等属于分类问题。
一般的处理过程是:首先,1)获取数据;2)提取最能体现数据的特征;3)利用算法建模;4)将建立的模型用于预测。
如人脸识别系统,首先我们获取到一堆人脸照片,首先,对数据进行预处理,然后提取人脸特征,最后用算法如SVM或者NN等。
这样,我们就建立了一个人脸识别系统,当输入一张人脸,我们就知道这张面孔是否在系统中。
这就是机器学习的整个流程,其次还包括寻找最优参数等。
机器学习主要分为:监督学习:数据集是有标签的,大部分机器学习模型都属于这一类别,包括线性分类器、支持向量机等等;无监督学习:跟监督学习相反,数据集是完全没有标签的,主要的依据是相似的样本在数据空间中一般距离是相近的,这样就能通过距离的计算把样本分类,这样就完全不需要IabeI,比如著名的kmeans算法就是无监督学习应用最广泛的算法;半监督学习:半监督学习一般针对的问题是数据量超级大但是有标签数据很少或者说标签数据的获取很难很贵的情况,训练的时候有一部分是有标签的而有一部分是没有的;强化学习:一直激励学习的方式,通过激励函数来让模型不断根据遇到的情况做出调整;2.循环神经网络的基本原理?RNNS的目的是用来处理序列数据。
在传统的神经网络模型中,是从输入层到隐含层再到输出层,层与层之间是全连接的,每层之间的节点是无连接的。
但是这种普通的神经网络对于很多问题却无能无力。
例如,你要预测句子的下一个单词是什么,一般需要用到前面的单词,因为一个句子中前后单词并不是独立的。
RNNS之所以称为循环神经网路,即一个序列当前的输出与前面的输出也有关。
具体的表现形式为网络会对前面的信息进行记忆并应用于当前输出的计算中,即隐藏层之间的节点不再无连接而是有连接的,并且隐藏层的输入不仅包括输入层的输出还包括上一时刻隐藏层的输出。
2022机器学习专项测试试题及答案
2022机器学习专项测试试题及答案1.机器学习的流程包括:分析案例、数据获取、________和模型验证这四个过程。
()A.数据清洗A、数据清洗B.数据分析C.模型训练(正确答案)D.模型搭建2.机器翻译属于下列哪个领域的应用?() *A.自然语言系统(正确答案)A. 自然语言系统(正确答案)B.机器学习C.专家系统D.人类感官模拟3.为了解决如何模拟人类的感性思维, 例如视觉理解、直觉思维、悟性等, 研究者找到一个重要的信息处理的机制是()。
*A.专家系统B.人工神经网络(正确答案)C.模式识别D.智能代理4.要想让机器具有智能, 必须让机器具有知识。
因此, 在人工智能中有一个研究领域, 主要研究计算机如何自动获取知识和技能, 实现自我完善, 这门研究分支学科叫()。
*A. 专家系统A.专家系统B. 机器学习(正确答案)C. 神经网络D. 模式识别5.如下属于机器学习应用的包括()。
*A.自动计算, 通过编程计算 456*457*458*459 的值(正确答案)A. 自动计算,通过编程计算 456*457*458*459 的值(正确答案)A.自动计算,通过编程计算 456*457*458*459 的值(正确答案)B.文字识别, 如通过 OCR 快速获得的图像中出汉字, 保存为文本C.语音输入, 通过话筒将讲话内容转成文本D.麦克风阵列, 如利用灵云该技术实现远场语音交互的电视6.对于神经网络模型, 当样本足够多时, 少量输入样本中带有较大的误差甚至个别错误对模型的输入-输出映射关系影响很小, 这属于()。
*A. 泛化能力A.泛化能力B. 容错能力(正确答案)C. 搜索能力D. 非线性映射能力7.下列选项不属于机器学习研究内容的是() *A. 学习机理A.学习机理B. 自动控制(正确答案)C. 学习方法D. 计算机存储系统8.机器学习的经典定义是: () *A.利用技术进步改善系统自身性能A. 利用技术进步改善系统自身性能B.利用技术进步改善人的能力C.利用经验改善系统自身的性能(正确答案)D.利用经验改善人的能力9.研究某超市销售记录数据后发现, 买啤酒的人很大概率也会购买尿布, 这种属于数据挖掘的那类问题()。
机器学习基础知识试题
机器学习基础知识试题一、选择题1. 机器学习的主要目标是什么?A. 让机器能够像人一样思考B. 让机器能够自动学习C. 提高计算机的运算速度D. 使机器具备无限的记忆能力2. 哪个是监督学习的主要特点?A. 需要标记好的训练数据B. 无需人工干预C. 机器能独立学习D. 只能处理分类问题3. 以下哪个属于非监督学习?A. 图像分类B. 垃圾邮件过滤C. 聚类分析D. 情感分析4. 在机器学习中,过拟合指的是什么?A. 模型无法适应新的数据B. 模型在训练集上表现较好,在测试集上表现较差C. 模型无法收敛D. 模型的准确率低5. 以下哪个是机器学习中常用的性能评估指标?A. 准确率B. 召回率C. F1值D. 所有选项都正确二、填空题1. 机器学习是一门研究怎样使计算机能够__________的科学。
2. 监督学习中,训练数据包括__________和__________。
3. __________是一种无监督学习算法,用于将数据分成相似的组或簇。
4. 过拟合是指模型在训练集上过度学习,导致在测试集上_____________。
5. 准确率是用来评估__________模型性能的指标。
三、简答题1. 请简要解释机器学习中的模型训练过程。
2. 什么是特征工程?为什么它在机器学习中很重要?3. 请解释交叉验证的概念及其作用。
4. 解释机器学习中的偏差和方差之间的关系。
5. 什么是集成学习?如何应用于机器学习中?四、应用题假设你是一个房地产公司的数据科学家,公司希望使用机器学习模型来预测未来一年的房屋价格。
你被要求开发一个模型,基于房屋的相关特征,帮助公司预测房屋的售价。
1. 请列举至少五个可能有用的特征,用于训练模型。
2. 你认为是分类问题还是回归问题?为什么?3. 你将如何评估你开发的模型的性能?4. 请描述你将如何使用交叉验证来提高模型的泛化能力。
5. 除了单一的机器学习模型,你可以考虑使用哪些集成学习方法来提高预测性能?答案:一、选择题1. B2. A3. C4. B5. D二、填空题1. 自动学习2. 特征、标签3. 聚类分析4. 表现较差5. 分类器三、简答题1. 模型训练过程包括选择合适的算法和模型结构、准备训练数据、使用训练数据对模型进行训练、评估模型性能以及根据评估结果调整模型参数。
人工智能与机器学习考试 选择题 52题

1. 什么是人工智能的核心目标?A. 创建智能机器B. 提高计算机性能C. 优化网络速度D. 增强数据存储2. 机器学习的主要类型不包括以下哪一项?A. 监督学习B. 无监督学习C. 半监督学习D. 超监督学习3. 以下哪项不是深度学习的一个应用?A. 图像识别B. 自然语言处理C. 数据清洗D. 语音识别4. 在机器学习中,什么是过拟合?A. 模型在训练数据上表现不佳B. 模型在测试数据上表现不佳C. 模型在训练数据上表现良好,但在新数据上表现不佳D. 模型在所有数据上表现一致5. 以下哪种算法是监督学习算法?A. K-均值聚类B. 决策树C. 主成分分析D. 关联规则学习6. 在神经网络中,什么是激活函数的主要作用?A. 增加网络的复杂性B. 减少网络的计算量C. 引入非线性特性D. 提高网络的稳定性7. 以下哪项技术不是用于防止过拟合的?A. 正则化B. 交叉验证C. 数据增强D. 数据清洗8. 什么是强化学习中的“奖励”?A. 模型预测的准确性B. 模型在特定任务上的表现C. 模型在训练过程中的反馈D. 模型在测试集上的错误率9. 在自然语言处理中,什么是词嵌入?A. 将词语转换为数字向量B. 将句子转换为数字向量C. 将文档转换为数字向量D. 将词语转换为图像10. 以下哪种方法不是用于提高模型泛化能力的?A. 增加数据量B. 使用更多的特征C. 使用正则化技术D. 进行交叉验证11. 什么是卷积神经网络(CNN)的主要应用领域?A. 图像处理B. 文本分析C. 声音识别D. 数据挖掘12. 在机器学习项目中,数据预处理的主要步骤不包括以下哪一项?A. 数据清洗B. 数据集成C. 数据变换D. 数据存储13. 以下哪项不是评估机器学习模型性能的常用指标?A. 准确率B. 召回率C. F1分数D. 平均值14. 什么是集成学习?A. 使用单一模型进行学习B. 使用多个模型进行学习C. 使用单一算法进行学习D. 使用多个算法进行学习15. 在机器学习中,什么是特征选择?A. 选择最重要的特征B. 增加新的特征C. 删除无关的特征D. 优化特征的表示16. 以下哪种算法是基于概率的机器学习算法?A. 支持向量机B. 随机森林C. 朴素贝叶斯D. 梯度提升机17. 在深度学习中,什么是梯度消失问题?A. 梯度变得非常大B. 梯度变得非常小C. 梯度保持不变D. 梯度随机变化18. 以下哪项技术不是用于解决梯度消失问题的?A. 使用ReLU激活函数B. 使用批量归一化C. 使用Sigmoid激活函数D. 使用残差网络19. 什么是迁移学习?A. 在不同任务间迁移数据B. 在不同任务间迁移模型C. 在不同任务间迁移算法D. 在不同任务间迁移特征20. 在机器学习中,什么是交叉验证?A. 使用单一数据集进行验证B. 使用多个数据集进行验证C. 将数据集分成多个部分,多次进行训练和验证D. 将数据集分成两个部分,一次进行训练和验证21. 以下哪种方法不是用于处理不平衡数据集的?A. 过采样B. 欠采样C. 合成少数类过采样技术(SMOTE)D. 增加数据量22. 什么是生成对抗网络(GAN)?A. 一种用于生成数据的网络B. 一种用于分类数据的网络C. 一种用于回归数据的网络D. 一种用于聚类数据的网络23. 在机器学习中,什么是超参数?A. 模型训练过程中学习的参数B. 模型训练过程中固定的参数C. 模型训练过程中变化的参数D. 模型训练过程中优化的参数24. 以下哪种方法不是用于调整超参数的?A. 网格搜索B. 随机搜索C. 贝叶斯优化D. 数据清洗25. 什么是强化学习中的“策略”?A. 模型在特定任务上的表现B. 模型在训练过程中的反馈C. 模型在测试集上的错误率D. 模型在特定环境下采取的行动26. 在机器学习中,什么是监督学习?A. 使用标记数据进行学习B. 使用未标记数据进行学习C. 使用半标记数据进行学习D. 使用无标记数据进行学习27. 以下哪种算法是无监督学习算法?A. 线性回归B. 逻辑回归C. K-均值聚类D. 支持向量机28. 什么是深度学习中的“层”?A. 数据处理的单元B. 数据存储的单元C. 数据输入的单元D. 数据输出的单元29. 在机器学习中,什么是特征工程?A. 选择最重要的特征B. 增加新的特征C. 删除无关的特征D. 优化特征的表示30. 以下哪种方法不是用于提高模型鲁棒性的?A. 增加数据量B. 使用更多的特征C. 使用正则化技术D. 进行数据清洗31. 什么是强化学习中的“状态”?A. 模型在特定任务上的表现B. 模型在训练过程中的反馈C. 模型在测试集上的错误率D. 模型在特定环境下的情况32. 在机器学习中,什么是无监督学习?A. 使用标记数据进行学习B. 使用未标记数据进行学习C. 使用半标记数据进行学习D. 使用无标记数据进行学习33. 以下哪种算法是半监督学习算法?A. 线性回归B. 逻辑回归C. K-均值聚类D. 标签传播算法34. 什么是深度学习中的“权重”?A. 数据处理的单元B. 数据存储的单元C. 数据输入的单元D. 数据输出的单元35. 在机器学习中,什么是模型评估?A. 选择最重要的特征B. 增加新的特征C. 删除无关的特征D. 评估模型的性能36. 以下哪种方法不是用于提高模型准确性的?A. 增加数据量B. 使用更多的特征C. 使用正则化技术D. 进行数据清洗37. 什么是强化学习中的“动作”?A. 模型在特定任务上的表现B. 模型在训练过程中的反馈C. 模型在测试集上的错误率D. 模型在特定环境下采取的行动38. 在机器学习中,什么是半监督学习?A. 使用标记数据进行学习B. 使用未标记数据进行学习C. 使用半标记数据进行学习D. 使用无标记数据进行学习39. 以下哪种算法是强化学习算法?A. 线性回归B. 逻辑回归C. K-均值聚类D. Q-学习40. 什么是深度学习中的“偏置”?A. 数据处理的单元B. 数据存储的单元C. 数据输入的单元D. 数据输出的单元41. 在机器学习中,什么是模型选择?A. 选择最重要的特征B. 增加新的特征C. 删除无关的特征D. 选择最合适的模型42. 以下哪种方法不是用于提高模型性能的?A. 增加数据量B. 使用更多的特征C. 使用正则化技术D. 进行数据清洗43. 什么是强化学习中的“环境”?A. 模型在特定任务上的表现B. 模型在训练过程中的反馈C. 模型在测试集上的错误率D. 模型在特定环境下的情况44. 在机器学习中,什么是监督学习?A. 使用标记数据进行学习B. 使用未标记数据进行学习C. 使用半标记数据进行学习D. 使用无标记数据进行学习45. 以下哪种算法是无监督学习算法?A. 线性回归B. 逻辑回归C. K-均值聚类D. 支持向量机46. 什么是深度学习中的“层”?A. 数据处理的单元B. 数据存储的单元C. 数据输入的单元D. 数据输出的单元47. 在机器学习中,什么是特征工程?A. 选择最重要的特征B. 增加新的特征C. 删除无关的特征D. 优化特征的表示48. 以下哪种方法不是用于提高模型鲁棒性的?A. 增加数据量B. 使用更多的特征C. 使用正则化技术D. 进行数据清洗49. 什么是强化学习中的“状态”?A. 模型在特定任务上的表现B. 模型在训练过程中的反馈C. 模型在测试集上的错误率D. 模型在特定环境下的情况50. 在机器学习中,什么是无监督学习?A. 使用标记数据进行学习B. 使用未标记数据进行学习C. 使用半标记数据进行学习D. 使用无标记数据进行学习51. 以下哪种算法是半监督学习算法?A. 线性回归B. 逻辑回归C. K-均值聚类D. 标签传播算法52. 什么是深度学习中的“权重”?A. 数据处理的单元B. 数据存储的单元C. 数据输入的单元D. 数据输出的单元答案1. A2. D3. C4. C5. B6. C7. D8. C9. A10. B11. A12. D13. D14. B15. A16. C17. B18. C19. B20. C21. D22. A23. B24. D25. D26. A27. C28. A29. D30. D31. D32. B33. D34. D35. D36. D37. D38. C39. D40. D41. D42. D43. D44. A45. C46. A47. D48. D49. D50. B51. D52. D。
2023年6月机器学习考试题及答案
2023年6月机器学习考试题及答案考试题目1. 什么是机器研究?2. 请简要说明监督研究和无监督研究的区别。
3. 什么是过拟合?如何避免过拟合?4. 请解释什么是决策树,并列举一些常用的决策树算法。
5. 什么是集成研究?列举两种常见的集成研究方法。
6. 请解释支持向量机(SVM)的工作原理。
7. 什么是深度研究?列举两个常用的深度研究模型。
8. 请简要介绍一下主成分分析(PCA)的原理和应用领域。
9. 什么是聚类分析?请列举一个常用的聚类算法。
10. 请说明机器研究中的特征选择方法。
答案1. 机器研究是一种人工智能的分支,旨在通过使用算法和统计模型,使计算机能够从数据中研究和改进,而无需明确编程。
它涉及让计算机从经验中自动研究,并利用研究到的知识来进行决策和预测。
3. 过拟合指模型在训练集上表现很好,但在新数据上表现较差的现象。
为了避免过拟合,可以采用以下方法:- 使用正则化技术,如L1正则化和L2正则化,限制模型的复杂度。
- 进行特征选择,排除一些对模型泛化能力影响较大的特征。
4. 决策树是一种基于树结构的分类和回归模型,它代表了对数据进行决策的过程。
常见的决策树算法包括ID3、C4.5和CART。
5. 集成研究是一种使用多个研究器进行组合预测的方法。
常见的集成研究方法包括随机森林和梯度提升树。
6. 支持向量机(SVM)是一种二分类模型,其工作原理是将数据映射到高维空间,在高维空间中找到一个最优超平面来分割不同类别的数据点。
7. 深度研究是一种基于神经网络的机器研究方法,它通过多层次的非线性变换来研究和表示数据。
常见的深度研究模型包括卷积神经网络(CNN)和循环神经网络(RNN)。
8. 主成分分析(PCA)是一种常用的降维技术,它通过线性变换将原始数据映射到低维空间,保留数据集中的主要特征。
主成分分析在数据预处理、图像处理和模式识别等领域有广泛的应用。
9. 聚类分析是一种将数据点划分为不同组别或类别的无监督研究方法。
机器学习考试试题
机器学习考试试题一、选择题(每题 3 分,共 30 分)1、以下哪种情况不属于机器学习的应用场景?()A 图像识别B 自然语言处理C 传统的数值计算D 预测股票价格2、在监督学习中,如果预测值与真实值之间的差异较大,通常使用以下哪种方法来衡量模型的性能?()A 准确率B 召回率C 均方误差D F1 值3、下列哪种算法不是聚类算法?()A KMeansB 决策树C 层次聚类D 密度聚类4、对于一个过拟合的模型,以下哪种方法可以缓解?()A 增加训练数据量B 减少模型的复杂度C 增加正则化项D 以上都是5、以下关于特征工程的描述,错误的是?()A 特征工程是将原始数据转换为更有意义和有用的特征的过程B 特征选择是特征工程的一部分C 特征工程对于机器学习模型的性能影响不大D 特征缩放可以提高模型的训练效率6、在深度学习中,以下哪个不是常见的激活函数?()A Sigmoid 函数B ReLU 函数C Tanh 函数D Logistic 函数7、支持向量机(SVM)主要用于解决什么问题?()A 回归问题B 分类问题C 聚类问题D 降维问题8、以下哪种优化算法常用于神经网络的训练?()A 随机梯度下降(SGD)B 牛顿法C 共轭梯度法D 以上都是9、下面关于集成学习的说法,错误的是?()A 随机森林是一种集成学习算法B 集成学习可以提高模型的稳定性和泛化能力C 集成学习中的个体学习器必须是同一种类型的模型D 集成学习通过组合多个弱学习器来构建一个强学习器10、对于一个二分类问题,若混淆矩阵如下:||预测正例|预测反例||||||实际正例| 80 | 20 ||实际反例| 10 | 90 |则该模型的准确率是多少?()A 80%B 90%C 70%D 85%二、填空题(每题 3 分,共 30 分)1、机器学习中的有监督学习包括________、________和________等任务。
2、常见的无监督学习算法有________、________和________。
机器学习与人工智能测试 选择题 52题
1. 机器学习的主要目的是什么?A. 使计算机能够自主学习B. 提高计算机的计算速度C. 减少计算机硬件成本D. 增加计算机软件功能2. 下列哪项不是机器学习的主要类型?A. 监督学习B. 无监督学习C. 半监督学习D. 超监督学习3. 在监督学习中,下列哪项是正确的?A. 数据集没有标签B. 数据集只有标签C. 数据集有输入和输出标签D. 数据集只有输入4. 无监督学习的典型应用是?A. 图像识别B. 语音识别C. 聚类分析D. 情感分析5. 下列哪项是深度学习的主要特点?A. 使用浅层神经网络B. 使用深层神经网络C. 不使用神经网络D. 使用线性模型6. 卷积神经网络(CNN)主要用于?A. 文本处理B. 图像处理C. 声音处理D. 数据聚类7. 循环神经网络(RNN)主要用于?A. 静态图像识别B. 动态序列数据处理C. 静态文本处理D. 静态数据分类8. 下列哪项是强化学习的核心概念?A. 监督B. 反馈C. 无监督D. 半监督9. 在机器学习中,过拟合是指?A. 模型在训练数据上表现不佳B. 模型在测试数据上表现不佳C. 模型在训练数据上表现良好,但在测试数据上表现不佳D. 模型在训练数据和测试数据上都表现良好10. 下列哪项技术可以用来防止过拟合?A. 增加数据量B. 减少数据量C. 增加模型复杂度D. 减少模型训练时间11. 交叉验证的主要目的是?A. 增加模型复杂度B. 减少模型复杂度C. 评估模型的泛化能力D. 增加数据量12. 下列哪项是特征选择的主要方法?A. 随机选择B. 主成分分析(PCA)C. 增加特征数量D. 减少数据量13. 下列哪项是决策树算法的特点?A. 线性模型B. 非线性模型C. 深度学习模型D. 浅层学习模型14. 随机森林算法是基于什么构建的?A. 单个决策树B. 多个决策树C. 单个神经网络D. 多个神经网络15. 支持向量机(SVM)主要用于?A. 回归问题B. 分类问题C. 聚类问题D. 关联分析16. 下列哪项是自然语言处理(NLP)的主要任务?A. 图像识别B. 语音识别C. 文本分类D. 数据聚类17. 词嵌入(Word Embedding)技术主要用于?A. 图像处理B. 语音处理C. 文本处理D. 数据聚类18. 下列哪项是生成对抗网络(GAN)的主要组成部分?A. 生成器和判别器B. 生成器和分类器C. 判别器和分类器D. 生成器和回归器19. 下列哪项是强化学习中的主要算法?A. Q-learningB. K-meansC. PCAD. SVM20. 下列哪项是深度强化学习的主要应用?A. 自动驾驶B. 图像识别C. 语音识别D. 文本分类21. 下列哪项是迁移学习的主要优势?A. 减少数据需求B. 增加数据需求C. 减少模型复杂度D. 增加模型训练时间22. 下列哪项是元学习(Meta-Learning)的主要目标?A. 学习如何学习B. 学习如何分类C. 学习如何聚类D. 学习如何回归23. 下列哪项是人工智能伦理的主要关注点?A. 算法效率B. 数据隐私C. 模型复杂度D. 计算速度24. 下列哪项是人工智能在医疗领域的主要应用?A. 图像识别B. 语音识别C. 疾病诊断D. 文本分类25. 下列哪项是人工智能在金融领域的主要应用?A. 风险评估B. 图像识别C. 语音识别D. 文本分类26. 下列哪项是人工智能在教育领域的主要应用?A. 个性化学习B. 图像识别C. 语音识别D. 文本分类27. 下列哪项是人工智能在交通领域的主要应用?A. 自动驾驶B. 图像识别C. 语音识别D. 文本分类28. 下列哪项是人工智能在零售领域的主要应用?A. 个性化推荐B. 图像识别C. 语音识别D. 文本分类29. 下列哪项是人工智能在农业领域的主要应用?A. 病虫害识别B. 图像识别C. 语音识别D. 文本分类30. 下列哪项是人工智能在制造业领域的主要应用?A. 质量控制B. 图像识别C. 语音识别D. 文本分类31. 下列哪项是人工智能在能源领域的主要应用?A. 智能电网B. 图像识别C. 语音识别D. 文本分类32. 下列哪项是人工智能在环境保护领域的主要应用?A. 污染监测B. 图像识别C. 语音识别D. 文本分类33. 下列哪项是人工智能在安全领域的主要应用?A. 视频监控B. 图像识别C. 语音识别D. 文本分类34. 下列哪项是人工智能在娱乐领域的主要应用?A. 游戏开发B. 图像识别C. 语音识别D. 文本分类35. 下列哪项是人工智能在法律领域的主要应用?A. 案件分析B. 图像识别C. 语音识别D. 文本分类36. 下列哪项是人工智能在社交媒体领域的主要应用?A. 内容推荐B. 图像识别C. 语音识别D. 文本分类37. 下列哪项是人工智能在旅游领域的主要应用?A. 个性化推荐B. 图像识别C. 语音识别D. 文本分类38. 下列哪项是人工智能在体育领域的主要应用?A. 运动员分析B. 图像识别C. 语音识别D. 文本分类39. 下列哪项是人工智能在艺术领域的主要应用?A. 创作辅助B. 图像识别C. 语音识别D. 文本分类40. 下列哪项是人工智能在科学研究领域的主要应用?A. 数据分析B. 图像识别C. 语音识别D. 文本分类41. 下列哪项是人工智能在太空探索领域的主要应用?A. 行星探测B. 图像识别C. 语音识别D. 文本分类42. 下列哪项是人工智能在灾难响应领域的主要应用?A. 救援规划B. 图像识别C. 语音识别D. 文本分类43. 下列哪项是人工智能在人机交互领域的主要应用?A. 语音助手B. 图像识别C. 语音识别D. 文本分类44. 下列哪项是人工智能在虚拟现实领域的主要应用?A. 环境模拟B. 图像识别C. 语音识别D. 文本分类45. 下列哪项是人工智能在增强现实领域的主要应用?A. 交互体验B. 图像识别C. 语音识别D. 文本分类46. 下列哪项是人工智能在智能家居领域的主要应用?A. 自动化控制B. 图像识别C. 语音识别D. 文本分类47. 下列哪项是人工智能在智能穿戴设备领域的主要应用?A. 健康监测B. 图像识别C. 语音识别D. 文本分类48. 下列哪项是人工智能在智能机器人领域的主要应用?A. 自主导航B. 图像识别C. 语音识别D. 文本分类49. 下列哪项是人工智能在智能城市领域的主要应用?A. 交通管理B. 图像识别C. 语音识别D. 文本分类50. 下列哪项是人工智能在智能医疗设备领域的主要应用?A. 诊断辅助B. 图像识别C. 语音识别D. 文本分类51. 下列哪项是人工智能在智能交通系统领域的主要应用?A. 交通流量管理B. 图像识别C. 语音识别D. 文本分类52. 下列哪项是人工智能在智能能源管理领域的主要应用?A. 能耗优化B. 图像识别C. 语音识别D. 文本分类答案部分1. A3. C4. C5. B6. B7. B8. B9. C10. A11. C12. B13. B14. B15. B16. C17. C18. A19. A20. A21. A22. A23. B24. C25. A26. A27. A28. A29. A30. A31. A32. A33. A34. A35. A36. A37. A38. A39. A40. A41. A42. A43. A44. A45. A46. A47. A48. A49. A50. A52. A。
《机器学习》期末考试试卷附答案
《机器学习》期末考试试卷附答案一、选择题(每题5分,共25分)1. 机器学习的主要目的是让计算机从数据中____,以实现某些任务或预测未知数据。
A. 抽取特征B. 生成模型C. 进行推理D. 分类标签答案:B. 生成模型2. K-近邻算法(K-NN)是一种____算法。
A. 监督学习B. 无监督学习C. 半监督学习D. 强化学习答案:A. 监督学习3. 在决策树算法中,节点的分裂是基于____进行的。
A. 信息增益B. 基尼不纯度C. 均方误差D. 交叉验证答案:A. 信息增益4. 支持向量机(SVM)的主要目的是找到一个超平面,将不同类别的数据点____。
A. 完全分开B. 尽量分开C. 部分分开D. 不分开答案:B. 尽量分开5. 哪种优化算法通常用于训练深度学习模型?A. 梯度下降B. 牛顿法C. 拟牛顿法D. 以上都对答案:D. 以上都对二、填空题(每题5分,共25分)1. 机器学习可以分为监督学习、无监督学习和____学习。
A. 半监督B. 强化C. 主动学习D. 深度答案:A. 半监督2. 线性回归模型是一种____模型。
A. 线性B. 非线性C. 混合型D. 不确定型答案:A. 线性3. 在进行特征选择时,常用的评估指标有____、____和____。
A. 准确率B. 召回率C. F1 分数D. AUC 值答案:B. 召回率C. F1 分数D. AUC 值4. 神经网络中的激活函数通常用于引入____。
A. 非线性B. 线性C. 噪声D. 约束答案:A. 非线性5. 当我们说一个模型具有很好的泛化能力时,意味着该模型在____上表现良好。
A. 训练集B. 验证集C. 测试集D. 所有集答案:C. 测试集三、简答题(每题10分,共30分)1. 请简要解释什么是过拟合和欠拟合,并给出解决方法。
2. 请解释什么是交叉验证,并说明它的作用。
答案:交叉验证是一种评估模型泛化能力的方法,通过将数据集分成若干个互斥的子集,轮流用其中若干个子集作为训练集,其余子集作为验证集,对模型进行评估。