
模式识别练习题简答和计算汇总
1、试说明Mahalanobis 距离平方的定义,到某点的Mahalanobis 距离平方为常数的轨迹的几何意义,它与欧氏距离的区别与联系。
答:Mahalanobis 距离的平方定义为:∑---=12)()(),(u x u x u x r T其中x ,u 为两个数据,1-∑是一个正定对称矩阵(一般为协方差矩阵)。
根据定义,距某一点的Mahalanobis 距离相等点的轨迹是超椭球,如果是单位矩阵Σ,则Mahalanobis 距离就是通常的欧氏距离。
2、试说明用监督学习与非监督学习两种方法对道路图像中道路区域的划分的基本做法,以说明这两种学习方法的定义与它们间的区别。
答:监督学习方法用来对数据实现分类,分类规则通过训练获得。
该训练集由带分类号的数据集组成,因此监督学习方法的训练过程是离线的。
非监督学习方法不需要单独的离线训练过程,也没有带分类号(标号)的训练数据集,一般用来对数据集进行分析,如聚类,确定其分布的主分量等。
就道路图像的分割而言,监督学习方法则先在训练用图像中获取道路象素与非道路象素集,进行分类器设计,然后用所设计的分类器对道路图像进行分割。
使用非监督学习方法,则依据道路路面象素与非道路象素之间的聚类分析进行聚类运算,以实现道路图像的分割。
3、已知一组数据的协方差矩阵为⎪⎪⎭⎫ ⎝⎛12/12/11,试问(1) 协方差矩阵中各元素的含义。
(2) 求该数组的两个主分量。
(3) 主分量分析或称K-L 变换,它的最佳准则是什么? (4) 为什么说经主分量分析后,消除了各分量之间的相关性。
答:协方差矩阵为⎪⎪⎭⎫⎝⎛12/12/11,则(1) 对角元素是各分量的方差,非对角元素是各分量之间的协方差。
(2) 主分量,通过求协方差矩阵的特征值,用⎪⎪⎪⎪⎭⎫ ⎝⎛----121211λλ=0得4/1)1(2=-λ,则 ⎩⎨⎧=2/32/1λ,相应地:2/3=λ,对应特征向量为⎪⎪⎭⎫ ⎝⎛11,21=λ,对应⎪⎪⎭⎫ ⎝⎛-11。
这两个特征向量,即为主分量。
(3) K-L 变换的最佳准则为:对一组数据进行按一组正交基分解,在只取相同数量分量的条件下,以均方误差计算截尾误差最小。
(4) 在经主分量分解后,协方差矩阵成为对角矩阵,因而各主分量间相关性消除。
4、试说明以下问题求解是基于监督学习或是非监督学习:(1) 求数据集的主分量 (2) 汉字识别 (3) 自组织特征映射 (4) CT 图像的分割答:(1) 求数据集的主分量是非监督学习方法;(2) 汉字识别:对待识别字符加上相应类别号—有监督学习方法;(3) 自组织特征映射—将高维数组按保留近似度向低维映射—非监督学习; (4) CT 图像分割—按数据自然分布聚类—非监督学习方法; 5、试列举线性分类器中最著名的三种最佳准则以及它们各自的原理。
答:线性分类器三种最优准则:Fisher准则:根据两类样本一般类内密集,类间分离的特点,寻找线性分类器最佳的法线向量方向,使两类样本在该方向上的投影满足类内尽可能密集,类间尽可能分开。
这种度量通过类内离散矩阵Sw和类间离散矩阵Sb实现。
感知准则函数:准则函数以使错分类样本到分界面距离之和最小为原则。
其优点是通过错分类样本提供的信息对分类器函数进行修正,这种准则是人工神经元网络多层感知器的基础。
支持向量机:基本思想是在两类线性可分条件下,所设计的分类器界面使两类之间的间隔为最大,它的基本出发点是使期望泛化风险尽可能小。
6、试分析五种常用决策规则思想方法的异同。
答、五种常用决策是:1. 基于最小错误率的贝叶斯决策,利用概率论中的贝叶斯公式,得出使得错误率最小的分类规则。
2. 基于最小风险的贝叶斯决策,引入了损失函数,得出使决策风险最小的分类。
当在0-1损失函数条件下,基于最小风险的贝叶斯决策变成基于最小错误率的贝叶斯决策。
3. 在限定一类错误率条件下使另一类错误率最小的两类别决策。
4. 最大最小决策:类先验概率未知,考察先验概率变化对错误率的影响,找出使最小贝叶斯奉献最大的先验概率,以这种最坏情况设计分类器。
5. 序贯分类方法,除了考虑分类造成的损失外,还考虑特征获取造成的代价,先用一部分特征分类,然后逐步加入性特征以减少分类损失,同时平衡总的损失,以求得最有效益。
7、 1. 什么是特征选择?2. 什么是Fisher 线性判别?答:1. 特征选择就是从一组特征中挑选出一些最有效的特征以达到降低特征空间维数的目的。
2. Fisher 线性判别:可以考虑把d 维空间的样本投影到一条直线上,形成一维空间,即把维数压缩到一维,这在数学上容易办到,然而,即使样本在d 维空间里形成若干紧凑的互相分得开的集群,如果把它们投影到一条任意的直线上,也可能使得几类样本混在一起而变得无法识别。
但是在一般情况下,总可以找到某个方向,使得在这个方向的直线上,样本的投影能分开得最好。
问题是如何根据实际情况找到这条最好的、最易于分类的投影线,这就是Fisher 算法所要解决的基本问题。
8、写出两类和多类情况下最小风险贝叶斯决策判别函数和决策面方程。
两类问题:判别函数 )()()(2121111x w p x w p x g λλ+=)()()(2221212x w p x w p x g λλ+=决策面方程:)()(21x g x g =C 类问题:判别函数 )()(1x w p x g j ij cj i λ=∑=,c i ,......2,1=决策面方程:)()(x g x g j i =,j i ≠,c i ,......2,1=,c j ,......2,1= 9、请论述模式识别系统的主要组成部分及其设计流程,并简述各组成部分中常用方法的主信息获取:通过测量、采样和量化,可以用矩阵或向量表示二维图像或波形。
预处理:去除噪声,加强有用的信息,并对输入测量仪器或其他因素造成的退化现象进行复原。
特征选择和提取:为了有效地实现分类识别,就要对原始数据进行变换,得到最能反映分类本质的特征。
分类决策:在特征空间中用统计方法把识别对象归为某一类。
10、简述支持向量机的基本思想。
答:SVM 从线性可分情况下的最优分类面发展而来。
最优分类面就是要求分类线不但能将两类正确分开(训练错误率为0),且使分类间隔最大。
SVM 考虑寻找一个满足分类要求的超平面,并且使训练集中的点距离分类面尽可能的远,也就是寻找一个分类面使它两侧的空白区域(margin)最大。
过两类样本中离分类面最近的点,且平行于最优分类面的超平面上H 1,H 2的训练样本就叫支持向量。
四、计算题1、设两类样本的类内散布矩阵分别为⎥⎦⎤⎢⎣⎡--=⎥⎦⎤⎢⎣⎡=11,112121221211S S , 两类的类心分别为m 1=(2,0)T , m 2=(2,2)T , 试用fisher 准则求其决策面方程。
解:⎥⎦⎤⎢⎣⎡=+=1001)(2121S S S w ,⎥⎦⎤⎢⎣⎡=-10011w S 22)1,2(1001)2,0()()()(221212121+-=--⎪⎪⎭⎫ ⎝⎛-=--=+-x x x x S m m x d T m m w T ρρρρρρ ⎩⎨⎧∈⇒<>210)(ωωx x d ρρ或 写出决策面方程 01)(2=+-=x x d ρ2、已知两个一维模式类别的类概率密度函数为:其它211002)/(1≤≤<≤⎪⎩⎪⎨⎧-=x x x x x p ω 其它3221031)/(2≤≤<≤⎪⎩⎪⎨⎧--=x x x x x p ω先验概率P(ω1)=0.6,P(ω2)=0.4, (1)求0-1代价Bayes 判决函数; (2)求总错误概率P(e );(3)判断样本{x 1=1.35, x 2=1.45, x 3=1.55, x 4=1.65} 各属于哪一类别。
答:(1) 基于0-1代价Bayes 判决函数为:当67.0326.04.0)()()|()|(1221≈==ωωωωP P x p x p 时,1w x ∈,否则2w x ∈, (2) 总的误判概率P(e )为:由3212=--x x , 得:6.158==x 12.0 )1(*4.0)2(*6.0)|(*)()|(*)()(6.1126.1221112=-+-=+=⎰⎰⎰⎰dx x dx x dxx p P dx x p P e P D D ωωωω(3) 67.086.135.0/65.0)/(/)/(,35.1211>≈==ωωx p x p x ,所以11w x ∈ 67.022.145.0/55.0)/(/)/(,45.1212>≈==ωωx p x p x ,所以12w x ∈> <67.082.055.0/45.0)/(/)/(,55.1213>≈==ωωx p x p x ,所以13w x ∈67.054.065.0/35.0)/(/)/(,65.1214<≈==ωωx p x p x ,所以24w x ∈3、假设在某个地区细胞识别中正常(w 1)和异常(w 2)两类先验概率分别为8.0)(1=w P ,2.0)(2=w P ,现有一待识别的细胞,其观察值为x ,从类条件概率密度分布曲线上查得25.0)(1=w x P ,6.0)(2=w x P ,并且已知011=λ,612=λ,121=λ,022=λ试对该细胞x 用一下两种方法进行分类:(1) 基于最小错误率的贝叶斯决策; (2) 基于最小风险的贝叶斯决策; 请分析两种结果的异同及原因。
答:(1) 利用贝叶斯公式,分别计算出1w 和2w 的后验概率:625.02.06.08.025.08.025.0)()()()()(211111=⨯+⨯⨯==∑=j j jwp w x p w p w x p x w p375.0)(1)(12=-=x w p x w p根据贝叶斯决策规则:375.0)(625.0)(21=>=x w p x w p ,所以把x 归为正常状态。
(2) 根据条件和上面算出的后验概率,计算出条件风险:125.3)()()()(2121112111=+==∑=x w p x w p x w p x R j j j λλλα75.1)()()()(22221212122=+==∑=x w p x w p x w p x R j j j λλλα由于)()(21x R x R αα>,即决策为2w 的条件风险小于决策为1w 的条件风险,因此采取决策行动2α,即判断待识别的细胞x 为2w 类----异常细胞。
将 (1) 与 (2) 相对比,其分类结果正好相反,这是因为这里影响决策结果的因素又多了一个,即“损失”;而且两类错误决策所造成的损失相差很悬殊,因此“损失”起了主导作用。
模式识别试卷及答案
模式识别试卷及答案一、选择题(每题5分,共30分)1. 以下哪一项不是模式识别的主要任务?A. 分类B. 回归C. 聚类D. 预测答案:B2. 以下哪种算法不属于监督学习?A. 支持向量机(SVM)B. 决策树C. K最近邻(K-NN)D. K均值聚类答案:D3. 在模式识别中,以下哪一项是特征选择的目的是?A. 减少特征维度B. 增强模型泛化能力C. 提高模型计算效率D. 所有上述选项答案:D4. 以下哪种模式识别方法适用于非线性问题?A. 线性判别分析(LDA)B. 主成分分析(PCA)C. 支持向量机(SVM)D. 线性回归答案:C5. 在神经网络中,以下哪种激活函数常用于输出层?A. SigmoidB. TanhC. ReLUD. Softmax答案:D6. 以下哪种聚类算法是基于密度的?A. K均值聚类B. 层次聚类C. DBSCAND. 高斯混合模型答案:C二、填空题(每题5分,共30分)1. 模式识别的主要任务包括______、______、______。
答案:分类、回归、聚类2. 在监督学习中,训练集通常分为______和______两部分。
答案:训练集、测试集3. 支持向量机(SVM)的基本思想是找到一个______,使得不同类别的数据点被最大化地______。
答案:最优分割超平面、间隔4. 主成分分析(PCA)是一种______方法,用于降维和特征提取。
答案:线性变换5. 神经网络的反向传播算法用于______。
答案:梯度下降6. 在聚类算法中,DBSCAN算法的核心思想是找到______。
答案:密度相连的点三、简答题(每题10分,共30分)1. 简述模式识别的基本流程。
答案:模式识别的基本流程包括以下几个步骤:(1)数据预处理:对原始数据进行清洗、标准化和特征提取。
(2)模型选择:根据问题类型选择合适的模式识别算法。
(3)模型训练:使用训练集对模型进行训练,学习数据特征和规律。
模式识别考试题答案
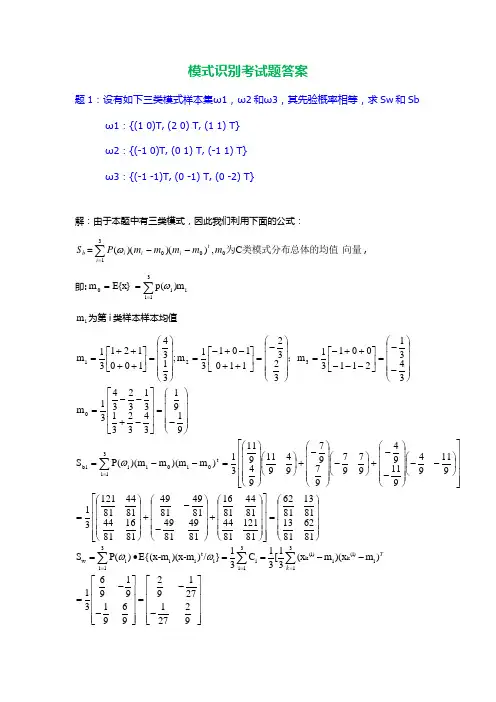
模式识别考试题答案题1:设有如下三类模式样本集ω1,ω2和ω3,其先验概率相等,求Sw 和Sb ω1:{(1 0)T, (2 0) T, (1 1) T} ω2:{(-1 0)T, (0 1) T, (-1 1) T}ω3:{(-1 -1)T, (0 -1) T, (0 -2) T}解:由于本题中有三类模式,因此我们利用下面的公式:b S =向量类模式分布总体的均值为C ,))()((00031m m m m m P t i i i i --∑=ω,即:i31i i0m )p(E{x }m ∑===ωi m 为第i 类样本样本均值⎪⎪⎪⎪⎭⎫⎝⎛=⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎣⎡⎪⎪⎪⎪⎭⎫ ⎝⎛+⎪⎪⎪⎪⎭⎫ ⎝⎛--+⎪⎪⎪⎪⎭⎫⎝⎛=⎥⎥⎥⎥⎦⎤⎢⎢⎢⎢⎣⎡⎪⎭⎫ ⎝⎛--⎪⎪⎪⎪⎭⎫⎝⎛--+⎪⎭⎫ ⎝⎛-⎪⎪⎪⎪⎭⎫ ⎝⎛-+⎪⎭⎫ ⎝⎛⎪⎪⎪⎪⎭⎫ ⎝⎛=--=⎪⎪⎪⎪⎭⎫ ⎝⎛-=⎥⎥⎥⎦⎤⎢⎢⎢⎣⎡-+--=⎪⎪⎪⎪⎭⎫⎝⎛--=⎥⎦⎤⎢⎣⎡---++-=⎪⎪⎪⎪⎭⎫ ⎝⎛-=⎥⎦⎤⎢⎣⎡++-+-=⎪⎪⎪⎪⎭⎫ ⎝⎛=⎥⎦⎤⎢⎣⎡++++=∑=81628113811381628112181448144811681498149814981498116814481448112131911949119497979797949119491131)m m )(m m ()(P S 919134323131323431m 343121100131m 323211010131m ;313410012131m t0i 0i 31i i b10321ω;333t(i)(i)k k w i i i i i i i i 1i 11111S P()E{(x-m )(x-m )/}C [(x m )(x m )33361211999271612399279Tk ωω====•==--⎡⎤⎡⎤--⎢⎥⎢⎥==⎢⎥⎢⎥⎢⎥⎢⎥--⎢⎥⎢⎥⎣⎦⎣⎦∑∑∑题2:设有如下两类样本集,其出现的概率相等: ω1:{(0 0 0)T , (1 0 0) T , (1 0 1) T , (1 1 0) T}ω2:{(0 0 1)T , (0 1 0) T , (0 1 1) T , (1 1 1) T}用K-L 变换,分别把特征空间维数降到二维和一维,并画出样本在该空间中的位置。
机器视觉与模式识别试题

机器视觉与模式识别试题一、简答题(每题10分,共10题)1. 请简要解释机器视觉的概念,并举例说明其在实际应用中的作用。
2. 什么是图像分割?请简要介绍常用的图像分割方法。
3. 请解释什么是特征提取,并描述至少两种常用的特征提取方法。
4. 什么是机器学习?简要描述监督学习和无监督学习的区别。
5. 请简要介绍常见的分类器,并说明它们的优缺点。
6. 什么是物体检测?请简要介绍常用的物体检测算法。
7. 请解释什么是模式识别,并举例说明其应用领域。
8. 简要介绍支持向量机(SVM)的原理及其应用。
9. 什么是深度学习?简要解释深度学习与传统机器学习的区别。
10. 简要介绍卷积神经网络(CNN)及其在图像分类中的应用。
二、分析题(共20分)1. 请分析图像分割的难点和挑战,并提出解决方案。
2. 请分析特征提取的关键问题,并探讨如何改进现有的特征提取方法。
3. 请分析支持向量机(SVM)的优势和不足,并提出使用SVM解决模式识别问题的注意事项。
4. 以人脸识别为例,分析深度学习模型相较于传统机器学习模型的优势和局限性。
三、应用题(共30分)1. 设计一个图像分类系统,能够将手写数字图像分为0~9十个类别。
请详细描述你的设计思路并给出实现代码。
2. 以目标检测为任务,设计一个基于卷积神经网络(CNN)的物体检测系统。
请详细描述你的设计思路并给出实现代码。
四、论述题(共40分)请综合所学的机器视觉与模式识别相关知识,自选一个课题进行深入探讨,并撰写一篇论文。
论文应包括问题定义、相关工作综述、解决方案设计和实验结果分析等内容。
请确保论文结构合理,逻辑清晰,表达准确。
以上是机器视觉与模式识别试题,根据题目要求,正文不再重复。
请根据试题内容自行判断和格式化撰写。
模式识别期末试题及答案

模式识别期末试题及答案正文:模式识别期末试题及答案1. 选择题1.1 下列关于机器学习的说法中,正确的是:A. 机器学习是一种人工智能的应用领域B. 机器学习只能应用于结构化数据C. 机器学习不需要预先定义规则D. 机器学习只能处理监督学习问题答案:A1.2 在监督学习中,以下哪个选项描述了正确的训练过程?A. 通过输入特征和预期输出,训练一个模型来进行预测B. 通过输入特征和可能的输出,训练一个模型来进行预测C. 通过输入特征和无标签的数据,训练一个模型来进行预测D. 通过输入特征和已有标签的数据,训练一个模型来进行分类答案:D2. 简答题2.1 请解释什么是模式识别?模式识别是指在给定一组输入数据的情况下,通过学习和建模,识别和分类输入数据中的模式或规律。
通过模式识别算法,我们可以从数据中提取重要的特征,并根据这些特征进行分类、聚类或预测等任务。
2.2 请解释监督学习和无监督学习的区别。
监督学习是一种机器学习方法,其中训练数据包含了输入特征和对应的标签或输出。
通过给算法提供已知输入和输出的训练样本,监督学习的目标是学习一个函数,将新的输入映射到正确的输出。
而无监督学习则没有标签或输出信息。
无监督学习的目标是从未标记的数据中找到模式和结构。
这种学习方法通常用于聚类、降维和异常检测等任务。
3. 计算题3.1 请计算以下数据集的平均值:[2, 4, 6, 8, 10]答案:63.2 请计算以下数据集的标准差:[1, 3, 5, 7, 9]答案:2.834. 综合题4.1 对于一个二分类问题,我们可以使用逻辑回归模型进行预测。
请简要解释逻辑回归模型的原理,并说明它适用的场景。
逻辑回归模型是一种用于解决二分类问题的监督学习算法。
其基本原理是通过将特征的线性组合传递给一个非线性函数(称为sigmoid函数),将实数值映射到[0,1]之间的概率。
这个映射的概率可以被解释为某个样本属于正类的概率。
逻辑回归适用于需要估计二分类问题的概率的场景,例如垃圾邮件分类、欺诈检测等。
模式识别练习题

2013模式识别练习题一。
填空题1、模式识别系统的基本构成单元包括: 模式采集、特征选择与提取和模式分类。
2、统计模式识别中描述模式的方法一般使用特征矢量;句法模式识别中模式描述方法一般有串、树、网。
3、影响层次聚类算法结果的主要因素有计算模式距离的测度、聚类准则、类间距离阈值、预定的类别数目。
4、线性判别函数的正负和数值大小的几何意义是正(负)表示样本点位于判别界面法向量指向的正(负)半空间中;绝对值正比于样本点到判别界面的距离.5、感知器算法1,H—K算法(2)。
(1)只适用于线性可分的情况;(2)线性可分、不可分都适用。
6、在统计模式分类问题中,聂曼—皮尔逊判决准则主要用于某一种判决错误较另一种判决错误更为重要情况;最小最大判别准则主要用于先验概率未知的情况.7、“特征个数越多越有利于分类”这种说法正确吗?错误。
特征选择的主要目的是从n个特征中选出最有利于分类的的m个特征(m〈n),以降低特征维数。
一般在可分性判据对特征个数具有单调性和(C n m>>n )的条件下,可以使用分支定界法以减少计算量。
8、散度J ij越大,说明ωi类模式与ωj类模式的分布差别越大;当ωi类模式与ωj类模式的分布相同时,J ij= 0 。
二、选择题1、影响聚类算法结果的主要因素有( B C D).A.已知类别的样本质量;B。
分类准则;C。
特征选取;D.模式相似性测度2、模式识别中,马式距离较之于欧式距离的优点是( C D)。
A。
平移不变性;B。
旋转不变性;C尺度不变性;D.考虑了模式的分布3、影响基本K—均值算法的主要因素有( D A B)。
A。
样本输入顺序;B.模式相似性测度;C.聚类准则;D.初始类中心的选取4、位势函数法的积累势函数K(x)的作用相当于Bayes判决中的( B D)。
A. 先验概率;B。
后验概率;C. 类概率密度;D。
类概率密度与先验概率的乘积5、在统计模式分类问题中,当先验概率未知时,可以使用(B D)。
模式识别练习题(简答和计算)

这两个特征向量,即为主分量。 (3) K-L 变换的最佳准则为:
对一组数据进行按一组正交基分解,在只取相同数量分量的条件下,以均方误差计算 截尾误差最小。 (4) 在经主分量分解后,协方差矩阵成为对角矩阵,因而各主分量间相关性消除。
4、试说明以下问题求解是基于监督学习或是非监督学习: (1) 求数据集的主分量 (2) 汉字识别 (3) 自组织特征映射 (4) CT 图像的分割 答:(1) 求数据集的主分量是非监督学习方法; (2) 汉字识别:对待识别字符加上相应类别号—有监督学习方法; (3) 自组织特征映射—将高维数组按保留近似度向低维映射—非监督学习; (4) CT 图像分割—按数据自然分布聚类—非监督学习方法; 5、试列举线性分类器中最著名的三种最佳准则以及它们各自的原理。 答:线性分类器三种最优准则: Fisher 准则:根据两类样本一般类内密集,类间分离的特点,寻找线性分类器最佳的法线 向量方向,使两类样本在该方向上的投影满足类内尽可能密集,类间尽可能分开。 这种度量通过类内离散矩阵 Sw 和类间离散矩阵 Sb 实现。 感知准则函数:准则函数以使错分类样本到分界面距离之和最小为原则。 其优点是通过错分类样本提供的信息对分类器函数进行修正,这种准则是人工神经元 网络多层感知器的基础。 支持向量机:基本思想是在两类线性可分条件下,所设计的分类器界面使两类之间的 间隔为最大,它的基本出发点是使期望泛化风险尽可能小。 6、试分析五种常用决策规则思想方法的异同。 答、五种常用决策是: 1. 基于最小错误率的贝叶斯决策,利用概率论中的贝叶斯公式,得出使得错误率最小 的分类规则。 2. 基于最小风险的贝叶斯决策,引入了损失函数,得出使决策风险最小的分类。当在 0-1 损失函数条件下,基于最小风险的贝叶斯决策变成基于最小错误率的贝叶斯决
中科院模式识别考题总结(详细答案)
1 .简述模式的概念及其直观特性,模式识别的分类,有哪几种方法。
(6')答(1):什么是模式?广义地说,存在于时间和空间中可观察的物体,如果我们可以区别它们是否相同或是否相似,都可以称之为模式。
模式所指的不是事物本身,而是从事物获得的信息,因此,模式往往表现为具有时间和空间分布的信息。
模式的直观特性:可观察性;可区分性;相似性.答(2):模式识别的分类:假说的两种获得方法(模式识别进行学习的两种方法):•监督学习、概念驱动或归纳假说:•非监督学习、数据驱动或演绎假说。
模式分类的主要方法:•数据聚类:用某种相似性度量的方法将原始数据组织成有意义的和有用的各种数据集。
是一种非监督学习的方法,解决方案是数据驱动的。
•统计分类:基于概率统计模型得到各类别的特征向量的分布,以取得分类的方法。
特征向量分布的获得是基于一个类别已知的训练样本集。
是一种监督分类的方法,分类器是概念驱动的。
•结构模式识别:该方法通过考虑识别对象的各部分之间的联系来达到识别分类的目的。
(句法模式识别)•神经网络:由一系列互相联系的、相同的单元(神经元)组成。
相互间的联系可以在不同的神经元之间传递增强或抑制信号。
增强或抑制是通过调整神经元相互间联系的权重系数来(weight)实现。
神经网络可以实现监督和非监督学习条件下的分类。
2.什么是神经网络?有什么主要特点?选择神经网络模式应该考虑什么因素?(8,)•(1 ):所谓△工神经网络就是基于模仿生物大脑的结构和功能而构成的二种值息处理系统计算机Z由于我们建立的信息处理系统实际上是模仿生理神经网络, 的复杂程度,通过调整内部大量节点之间相互连接的关系, 人工神经网络的两种操作过程:训练学习、正常操作答(2):人工神经网络的特点:•固有的并行结构和并行处理;•知识的分布存储,•有较强的容错性,•有一定的自适应性,人工神经网络的局限性:•人工神经网络不适于高精度的计算;•人工神经网络不适于做类似顺序计数的工作;•人工神经网络的学习和训练往往是一个艰难的过程;•人工神经网络必须克服时间域顺序处理方面的困难;•硬件限制:•正确的训练数据的收集。
四川大学模式识别期末考试内容
四川⼤学模式识别期末考试内容⼀.计算题1、在图像识别中,假定有灌⽊和坦克2种类型,它们的先验概率分别是0.7和0.3,损失函数如下表所⽰。
其中,类型w 1和w 2分别表⽰灌⽊和坦克,判决a 1=w 1,a 2=w 2。
现在做了2次实验,获得2个样本的类概率密度如下:5.02.0)|(1=ωx P 3.06.0)|(2=ωx P(1)试⽤最⼩错误率贝叶斯准则判决2个样本各属于哪⼀类?坦克、灌⽊。
(2)试⽤最⼩风险决策规则判决2个样本各属于哪⼀类?灌⽊、灌⽊。
答:(1)最⼩错误率贝叶斯准则,决策为坦克第⼀个样本:2121221111)|()|(5625.04375.01)|(1)|(4375.032143.0*6.07.0*2.07.0*2.0)()|()()|()|(ωωωωωωωωωω∈?>=-=-===+==∑=x x P x P x P x P P x p P x p x P j j j ,决策为灌⽊第⼆个样本:1121221111)|()|(449205.0795.01)|(1)|(795.044353.0*3.07.0*5.07.0*5.0)()|()()|()|(ωωωωωωωωωω∈?<==-≈-=≈=+==∑=x x P x P x P x P P x p P x p x P j j j(2)最⼩风险决策规则,决策为灌⽊第⼀个样本1212221212122212111211122211211)|()|(3175.25625.0*0.14375.0*4)|()|()|()|(35375.15625.0*24375.0*5.0)|()|()|()|(0.1425.0ωωλωλωλωλωλωλλλλλ∈?<=+=+===+=+======∑∑==x x a R x a R x P x P x P x a R x P x P x P x a R j j j j j j ,决策为灌⽊第⼆个样本12122212121222121112111)|()|(385.3205.0*0.1795.0*4)|()|()|()|(8075.0205.0*2795.0*5.0)|()|()|()|(ωωλωλωλωλωλωλ∈?<=+=+===+=+==∑∑==x x a R x a R x P x P x P x a R x P x P x P x a R j j j j j j2、给出⼆维样本数据(-1,1),(2,2),(1,-1),(-2,-2),试⽤K-L 变换作⼀维数据压缩。
(完整word版)模式识别试题及总结
一、填空与选择填空(本题答案写在此试卷上,30分)1、模式识别系统的基本构成单元包括:模式采集、特征提取与选择和模式分类。
2、统计模式识别中描述模式的方法一般使用特真矢量;句法模式识别中模式描述方法一般有串、树、网。
3、聚类分析算法属于(1);判别域代数界面方程法属于(3)。
(1)无监督分类 (2)有监督分类(3)统计模式识别方法(4)句法模式识别方法4、若描述模式的特征量为0-1二值特征量,则一般采用(4)进行相似性度量。
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度5、下列函数可以作为聚类分析中的准则函数的有(1)(3)(4)。
(1)(2) (3)(4)6、Fisher线性判别函数的求解过程是将N维特征矢量投影在(2)中进行。
(1)二维空间(2)一维空间(3)N-1维空间7、下列判别域界面方程法中只适用于线性可分情况的算法有(1);线性可分、不可分都适用的有(3)。
(1)感知器算法(2)H-K算法(3)积累位势函数法8、下列四元组中满足文法定义的有(1)(2)(4)。
(1)({A, B}, {0, 1}, {A→01, A→ 0A1 , A→ 1A0 , B→BA , B→ 0}, A)(2)({A}, {0, 1}, {A→0, A→ 0A}, A)(3)({S}, {a, b}, {S → 00S, S → 11S, S → 00, S → 11}, S)(4)({A}, {0, 1}, {A→01, A→ 0A1, A→ 1A0}, A)9、影响层次聚类算法结果的主要因素有(计算模式距离的测度、(聚类准则、类间距离门限、预定的类别数目))。
10、欧式距离具有( 1、2 );马式距离具有(1、2、3、4 )。
(1)平移不变性(2)旋转不变性(3)尺度缩放不变性(4)不受量纲影响的特性11、线性判别函数的正负和数值大小的几何意义是(正(负)表示样本点位于判别界面法向量指向的正(负)半空间中;绝对值正比于样本点到判别界面的距离。
大学模式识别考试题及答案详解完整版
大学模式识别考试题及答案详解HUA system office room 【HUA16H-TTMS2A-HUAS8Q8-HUAH1688】一、填空与选择填空(本题答案写在此试卷上,30分)1、模式识别系统的基本构成单元包括:模式采集、特征提取与选择和模式分类。
2、统计模式识别中描述模式的方法一般使用特真矢量;句法模式识别中模式描述方法一般有串、树、网。
3、聚类分析算法属于(1);判别域代数界面方程法属于(3)。
(1)无监督分类 (2)有监督分类(3)统计模式识别方法(4)句法模式识别方法4、若描述模式的特征量为0-1二值特征量,则一般采用(4)进行相似性度量。
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度5、下列函数可以作为聚类分析中的准则函数的有(1)(3)(4)。
(1)(2) (3)(4)6、Fisher线性判别函数的求解过程是将N维特征矢量投影在(2)中进行。
(1)二维空间(2)一维空间(3)N-1维空间7、下列判别域界面方程法中只适用于线性可分情况的算法有(1);线性可分、不可分都适用的有(3)。
(1)感知器算法(2)H-K算法(3)积累位势函数法8、下列四元组中满足文法定义的有(1)(2)(4)。
(1)({A, B}, {0, 1}, {A01, A 0A1 , A 1A0 , B BA , B 0}, A)(2)({A}, {0, 1}, {A0, A 0A}, A)(3)({S}, {a, b}, {S 00S, S 11S, S 00, S 11}, S)(4)({A}, {0, 1}, {A01, A 0A1, A 1A0}, A)二、(15分)简答及证明题(1)影响聚类结果的主要因素有那些?(2)证明马氏距离是平移不变的、非奇异线性变换不变的。
答:(1)分类准则,模式相似性测度,特征量的选择,量纲。
(2)证明:(2分)(2分)(1分)设,有非奇异线性变换:(1分)(4分)三、(8分)说明线性判别函数的正负和数值大小在分类中的意义并证明之。