
最新算法设计与分析C 语言描述(陈慧南版)课后答案讲解学习
6-10.
T仍是新图的最小代价生成树。
证明:假设T不是新图的最小代价生成树,T’是新图的最小代价生成树,那么cost(T’)<cost(T)。有cost(T’)-c(n-1)<cost(t)-c(n-1),即在原图中存在一颗生成树,其代价小于T的代价,这与题设中T是原图的最小代价生成树矛盾。所以假设不成立。证毕。
3
4
5
[8
5]
∞
4
[2]
3
3
4
5
[8
5]
∞
5
2
3
3
4
5
[5]
8
∞
排序结果
2
3
3
4
5
5
8
∞
12.(1)证明:当 或 或 时,程序显然正确。
当n=right-left+1>2时,程序执行下面的语句:
int k=(right-left+1)/3;
StoogeSort(left,right-k);
StoogeSort(left+k,right);
{
while(!Small(left,right)&&left<right)
{
int m=Divide(left,right);
if(x<P(m) right=m-1;
else if(x>P[m]) left=m+1;
else return S(P)
}
}
5-7.template <class T>
int SortableList<T>::BSearch(const T&x,int left,int right) const
③再次执行StoogeSort(left,right-k);使序列的前2/3有序。
经过三次递归,最终使序列有序。
所以,这一排序算法是正确的。
(2)最坏情况发生在序列按递减次序排列。
, , 。
设 ,则 。
冒泡排序最坏时间复杂度为 ,队排序最坏时间复杂度为 ,快速排序最坏时间复杂度为 。所以,该算法不如冒泡排序,堆排序,快速排序。
2-11. (1)当 时, ,所以 , 。可选 , 。对于 , ,即 。注意:是f(n)和g(n)的关系。
(2)当 时, ,所以 , 。可选 , 。对于 , ,即 。
(3)因为 , 。当 时, , 。所以,可选 , ,对于 , ,即 。
第二章
2-17.证明:设 ,则 。
当 时, 。所以, 。
第五章
5-4.SolutionType DandC1(int left,int right)
for(int i=0;i<m;i++)
{
while(k>0)
{
do
{
mid=(left+right)/2;
if(a[mid]<b[i]) left=mid;
else if(a[mid]>b[i]) right=mid;
else {cnt=mid; break;}
}while(left<right-1)
第一章
1-3.最大公约数为1。快1414倍。
主要考虑循环次数,程序1-2的while循环体做了10次,程序1-3的while循环体做了14141次(14142-2循环)
若考虑其他语句,则没有这么多,可能就601倍。
第二章
2-8.(1)画线语句的执行次数为 。 。划线语句的执行次数应该理解为一格整体。
9.
证明:因为该算法在成功搜索的情况下,关键字之间的比较次数至少为 ,至多为 。在不成功搜索的情况下,关键字之间的比较次数至少为 ,至多为 。所以,算法的最好、最坏情况的时间复杂度为 。
假定查找表中任何一个元素的概率是相等的,为 ,那么,
不成功搜索的平均时间复杂度为 ,
成功搜索的平均时间复杂度为 。
(2)画线语句的执行次数为 。 。
(3)画线语句的执行次数为 。 。
(4)当n为奇数时画线语句的执行次数为 ,
当n为偶数时画线语句的执行次数为 。 。
2-10.(1)当 时, ,所以,可选 , 。对于 , ,所以, 。
(2)当 时, ,所以,可选 , 。对于 , ,所以, 。
(3)由(1)、(2)可知,取 , , ,当 时,有 ,所以 。
{
if (left<=right)
{
int m=(right+left)/3;
if (x<l[m]) return BSearch(x,left,m-1);
else if (x>l[m]) return BSearch(x,m+1,right);
else return m;
}
return -1;
}
第五章
StoogeSort(left,right-k);
①首次递归StoogeSort(left,right-k);时,序列的前2/3的子序列有序。
②当递归执行StoogeSort(left+k,right);时,使序列的后2/3的子序列有序,经过这两次递归排序,使原序列的后1/3的位置上是整个序列中较大的数,即序列后1/3的位置上数均大于前2/3的数,但此时,前2/3的序列并不一定是有序的。
if(a[left]<b[i]) cnt=left;
else cnt=left-1;
if(k>cnt)
{
if(cnt>0)
{
for(j=0;j<cnt;j++)
{
temp[j]=a[r];
r++;
}
left=cnt;
k-=cnt;
}
else
{
temp[j]=b[i];
left=0;
k--;
}
}
else
{
for(j=0;j<k;j++)
{
temp[j]=a[r];
r++;
}
left=cnt;
k-=cnt;
return temp[k-1];
}
}
}
}
第六章
1.由题可得: ,
所以,最优解为 ,
最大收益为 。
8.
第六章
6-9.
普里姆算法。
因为图G是一个无向连通图。
所以n-1<=m<=n (n-1)/2;
O(n)<=m<=O(n2);
其中, 是二叉判定树的内路径长度, 是外路径长度,并且 。
11.
步数
0
1
2
3
4
5
初始时
1
1
1
1
1
1
[1
1]
1
[1
1]
∞
2
[1]
1
1
[1
1]
∞
3
1
1
1
[1
1]
∞
4
1
1
1
[1]
1
∞
排序结果
1
1
1
1
1
∞
步数
0
1
2
3
4
5
6
7
初始时
5
5
8
3
4
3
2
∞
1
[4
2
3
3]
5
[85]∞2[323]
4
5
[8
5]
∞
3
[3
2]
13.template <class T>
select (T&x,int k)
{
if(m>n) swap(m,n);
if(m+n<k||k<=0) {cout<<"Out Of Bounds"; return false;}
int *p=new temp[k];
int mid,left=0,right=n-1,cnt=0,j=0,r=0;
算法设计与分析C语言描述(陈慧南版)课后答案
算法设计与分析C语⾔描述(陈慧南版)课后答案第⼀章15P1-3. 最⼤公约数为1。
快1414倍。
主要考虑循环次数,程序1-2的while 循环体做了10次,程序1-3的while 循环体做了14141次(14142-2循环)若考虑其他语句,则没有这么多,可能就601倍。
第⼆章32P2-8.(1)画线语句的执⾏次数为log n 。
(log )n O 。
划线语句的执⾏次数应该理解为⼀格整体。
(2)画线语句的执⾏次数为111(1)(2)16jnii j k n n n ===++=∑∑∑。
3()n O 。
(3)画线语句的执⾏次数为。
O 。
(4)当n 为奇数时画线语句的执⾏次数为(1)(3)4n n ++,当n 为偶数时画线语句的执⾏次数为 2(2)4n +。
2()n O 。
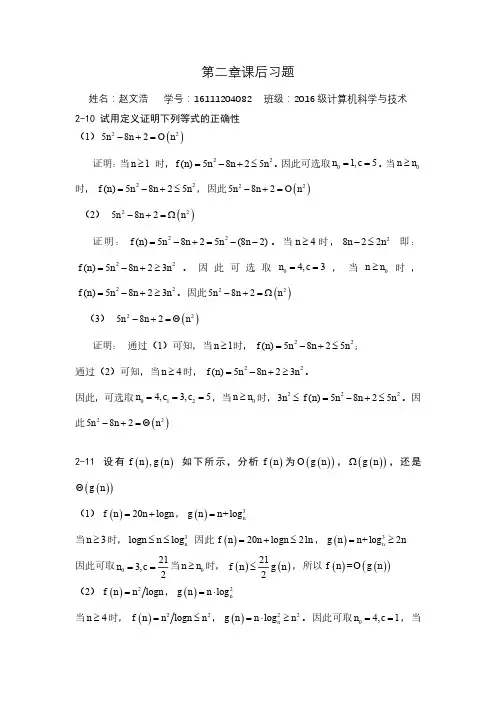
2-10.(1)当 1n ≥ 时,225825n n n -+≤,所以,可选 5c =,01n =。
对于0n n ≥,22()5825f n n n n =-+≤,所以,22582()n n n -+=O 。
(2)当 8n ≥ 时,2222582524n n n n n -+≥-+≥,所以,可选 4c =,08n =。
对于0n n ≥,22()5824f n n n n =-+≥,所以,22582()n n n -+=Ω。
(3)由(1)、(2)可知,取14c =,25c =,08n =,当0n n ≥时,有22212582c n n n c n ≤-+≤,所以22582()n n n -+=Θ。
2-11. (1) 当3n ≥时,3log log n n n <<,所以()20log 21f n n n n =+<,3()log 2g n n n n =+>。
可选 212c =,03n =。
对于0n n ≥,()()f n cg n ≤,即()(())f n g n =O 。
注意:是f (n )和g (n )的关系。
(陈慧南 第3版)算法设计与分析——第3章课后习题答案

第三章课后习题姓名:赵文浩学号:16111204082 班级:2016级计算机科学与技术3-2 在如下图所示的二叉搜索树上完成下列运算及随后的伸展操作,画出每次运算加伸展操作后的结果伸展树。
5030601040201585 70901)搜索80从图中可以看出,元素80不存在,因此伸展结点应为搜索过程中遇到的最后一个结点,即70,伸展过程如下图所示:503060104020158570905030601040201585709050301040201585907060状态1状态2状态32)插入80元素80插入后的状态以及将元素8作为伸展结点的伸展过程如下图所示:5030601040201585 709080插入元素80后50306010402015857090805030601040201585709080变换1变换25030601040201585908070变换33)删除30首先,将元素30结点伸展至根结点,然后删除根结点30,并将结点20(左边最大的结点、右边最小的结点)作为伸展结点,伸展过程如下图所示:3010402015709050856030102015709085605040102070908560504015709085605040变换1将30作为根结点删除结点30并变换将20作为伸展结点伸展至根节点102015。
(陈慧南 第3版)算法设计与分析——第6章课后习题答案
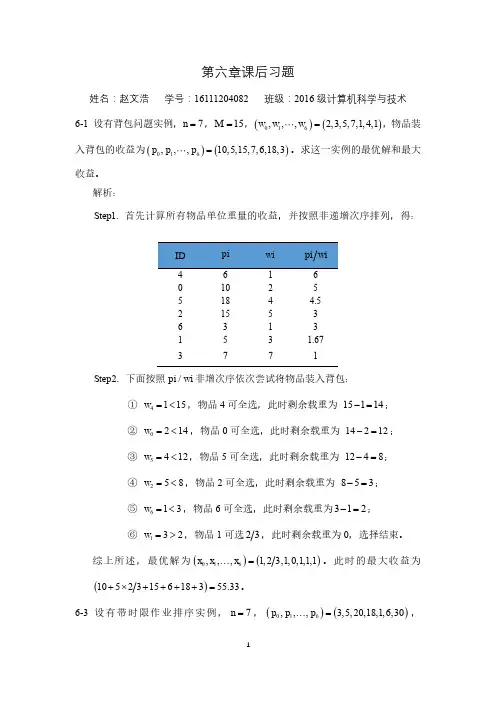
⑥ 选择作业 1,则 X 6, 2,3,5,1 。将其按照期限 di 非减次序排列可
得:
ID
di
5
1
6
2
3
3
1
3
2
4
作业5
作业3 作业2
-1
0
1
2
3
4
作业6 作业1(冲突)
该集合无可行排序,因此 X 6, 2,3,5,1 不可行, X 6, 2,3,5 ;
3
⑦ 选择作业 0,则 X 6, 2,3,5, 0 。将其按照期限 di 非减次序排列
可得:
ID
di
5
1
0
1
6
2
3
3
2
4
作业5
作业3 作业2
-1
0
1
2
3
4
作业0(冲突)作业6
该集合无可行排序,因此 X 6, 2,3,5, 0 不可行,X 6, 2,3,5 ;
⑧ 选择作业 4,则 X 6, 2,3,5, 4 。将其按照期限 di 非减次序排列
可得:
ID
Hale Waihona Puke di516
12,5,8,32, 7,5,18, 26, 4,3,11,10, 6 。请给出最优存储方案。
解析:首先将这 13 个程序按照程序长度非降序排列,得:
程序 ID
9 8 1 5 12 4 2 11 10 0 6 7 3
程序长度 ai 3 4 5 5 6 7 8 10 11 12 18 26 32
根据定理可知,按照程序编号存放方案如下:
解析:已知 Prim 算法时间复杂度为 O n2 ,受顶点 n 影响;
Kruskal 算法时间复杂度为 O m logm ,受边数 m 影响;
数据结构-C语言描述(第三版)(陈慧南)章 (11)
第11章 内 排 序
First 12
q 21
p 33
sorted
…
55
unsorted
26
42
…
(a)
First
③
q
p
sorted
unsorted
12
21
33
…
55
26
42
…
① ②
(b)
图11-3 链表的直接插入排序 (a) 插入26前;(b) 插入26后
第11章 内 排 序
与顺序表的直接插入排序一样,链表上的直接插入排序算 法首先将第一个记录视为只有一个记录的有序子序列,将第二 个记录插入该有序子序列中,再插入第三个记录,……,直到 插入最后一个记录为止。每趟插入,总是从链表的表头开始搜 索适当的插入位置。程序11-3中,指针p指示表中与待插入的 记录比较的结点,q指示p的前驱结点。指针sorted总是指向单链 表中已经有序的部分子表的尾部,而指针unsorted指向sorted的 后继结点,即待插入的记录结点,见图11-3(a)。如果待插入的 记录小于第一个记录,则应将其插在最前面。请注意,下面的 while循环总会终止。
1)
n(n 4
1)
(n
1)
O(n 2
)
(11-5)
AM(n)
n1
i1
i 2
2
1 2
n 1 i1
i+2(n
1)
n(n 1) 4
2(n
1)
O(n 2
)
(11-6)
第11章 内 排 序
2.链表上的直接插入排序
直接插入排序也可以在链表上实现。程序11-3是在单 链表上的直接插入排序算法的C语言程序。单链表采用程序 11-1中描述的单链表结构类型。在单链表表示下,将一个 记录插入到一个有序子序列中,搜索适当的插入位置的操作 可从链表的表头开始。图11-3中,从11到55之间的记录已 经有序,现要插入26。我们从表头开始,将26依次与12、21 和33比较。直到遇到大于或等于26的记录33为止,将26插在 21与33之间。该插入操作如图11-3(b)所示。
数据结构-C语言描述(第三版)(陈慧南)章 (6)
第6章 树 例如,设有序表为(21, 25, 28, 33, 36, 43),若要在表中 查找元素36,通常的做法是从表中第一个元素开始,将待查元素 与表中元素逐一比较进行查找,直到找到36为止。粗略地说,如 果表中每个元素的查找概率是相等的,则平均起来,成功查找一 个元素需要将该元素与表中一半元素作比较。如果将表中元素组 成图6-3所示的树形结构,情况就大为改观。我们可以从根结点 起,将各结点与待查元素比较,在查找成功的情况下,所需的最 多的比较次数是从根到待查元素的路径上遇到的结点数目。当表 的长度n很大时,使用图6-3所示的树形结构组织表中数据,可 以很大程度地减少查找所需的时间。为了查找36,我们可以让36 与根结点元素28比较,36比28大,接着查右子树,查找成功。显 然,采用树形结构能节省查找时间。
第6章 树
E
E
A
F
B
G
CD
LJ
M
N
T1
X
YZ
U T2
B
F
A
DC
G
JL
T3 N
M
(a)
(b)
图6-2 树的例子
(a) 树T1和T2组成森林;(b) 树T3
第6章 树
6.2 二 叉 树
二叉树是非常重要的树形数据结构。很多从实际问题中抽 象出来的数据都是二叉树形的,而且许多算法如果采用二叉树 形式解决则非常方便和高效。此外,以后我们将看到一般的树 或森林都可通过一个简单的转换得到与之相应的二叉树,从而 为树和森林的存储及运算的实现提供了有效方法。
第6章 树
图6-1描述了欧洲部分语言的谱系关系,它是一个后裔图, 图中使用的描述树形结构数据的形式为倒置的树形表示法。在 前几章中,我们学习了多种线性数据结构,但是一般来讲,这 些数据结构不适合表示如图6-1所示的层次结构的数据。为了 表示这类层次结构的数据,我们采用树形数据结构。在本章中 我们将学习多种不同特性的树形数据结构,如一般树、二叉树、 穿线二叉树、堆和哈夫曼树等。
(陈慧南 第3版)算法设计与分析——第2章课后习题答案
因此 T (n) (n 2 ) (3) a 28, b 3, f n cn3
nlogb a nlog3 28 n3.033 ,则 f (n) c n 2 (nlogb a - ) ,其中可取 =0.04 。符合主定理
的情况 1 ,因此 T (n) (n3.033 )
21 21 当 n n0 时, f n g n ,所以 f n = g n 2 2
(2) f n n 2 logn , g n n log 2 n
2 当 n 4 时, f n n 2 logn n 2 , g n n log 2 n n 。因此可取 n0 4, c 1 ,当
g n
(1) f n 20n logn , g n n+ log 3 n
f n 20n logn 21n , g n n+ log 3 当 n 3 时, logn n log3 n 2n n 因此
因此可取 n0 3, c
f n g n ,所以 f n = g n
2-12 将下列时间函数按增长率的非递减次序排列
3 2
n
, log n , log 2 n , n log n , n ! , log(log(n)) , 2 n , n1 log n , n 2
答: n1 log n
f ( n ) ( n m )
证明:
f (n) am nm am1nm1 a1n a0 F (n) am n m am1 n m1
a1 n a0
由 F (n) 单调性易知,存在 nt 0 ,使得 F (n) 取 n 1 ,且 nt0 nt , F (nt0 ) 0 ,则 当 n nt0 时, F (n) 0 即: f (n) am n m am1 n m1
(陈慧南 第3版)算法设计与分析——第7章课后习题答案
③ 其余元素
w[0][2] q[2] p[2] w[0][1] 15
k 1: c[0][0] c[1][2] c[0][2] min k 2 : c[0][1] c[2][2] w[0][2] 22 r[0][2] 2
17000
s[0][2]
0
m[1][3]
min
k k
1: m[1][1] m[2][3] 2 : m[1][2] m[3][3]
p1 p2 p4 p1 p3 p4
10000
s[1][3]
2
m[1][3]
min
k k
0 : m[0][0] m[1][3] 1: m[0][1] m[2][3]
第七章课后习题
姓名:赵文浩 学号:16111204082 班级:2016 级计算机科学与技术 7-1 写出对图 7-19 所示的多段图采用向后递推动态规划算法求解时的计算过程。
3
1
3
1
6
5
0
2
6
6
3
4
4 6
5
2
7
8
3
2
8
5
2
7
解析:
V 5 cost(5,8) 0 d (5,8) 8
V4
cos t(4, 6) minc(6,8) cos t(5,8) 7 cos t(4, 7) minc(7,8) cos t(5,8) 3
k 1: c[0][0] c[1][3] c[0][3] min k 2 : c[0][1] c[2][3] w[0][3] 25
数据结构与算法分析c语言描述中文答案
数据结构与算法分析c语言描述中文答案【篇一:数据结构(c语言版)课后习题答案完整版】选择题:ccbdca6.试分析下面各程序段的时间复杂度。
(1)o(1)(2)o(m*n)(3)o(n2)(4)o(log3n)(5)因为x++共执行了n-1+n-2+??+1= n(n-1)/2,所以执行时间为o(n2)(6)o(n)第2章线性表1.选择题babadbcabdcddac 2.算法设计题(6)设计一个算法,通过一趟遍历在单链表中确定值最大的结点。
elemtype max (linklist l ){if(l-next==null) return null;pmax=l-next; //假定第一个结点中数据具有最大值 p=l-next-next; while(p != null ){//如果下一个结点存在if(p-data pmax-data) pmax=p;p=p-next; }return pmax-data;(7)设计一个算法,通过遍历一趟,将链表中所有结点的链接方向逆转,仍利用原表的存储空间。
void inverse(linklist l) { // 逆置带头结点的单链表 l p=l-next; l-next=null; while ( p) {q=p-next; // q指向*p的后继p-next=l-next;l-next=p; // *p插入在头结点之后p = q; }}(10)已知长度为n的线性表a采用顺序存储结构,请写一时间复杂度为o(n)、空间复杂度为o(1)的算法,该算法删除线性表中所有值为item的数据元素。
[题目分析] 在顺序存储的线性表上删除元素,通常要涉及到一系列元素的移动(删第i个元素,第i+1至第n个元素要依次前移)。
本题要求删除线性表中所有值为item的数据元素,并未要求元素间的相对位置不变。
因此可以考虑设头尾两个指针(i=1,j=n),从两端向中间移动,凡遇到值item的数据元素时,直接将右端元素左移至值为item的数据元素位置。
(陈慧南 第3版)算法设计与分析——第1章课后习题答案
第一章课后习题
姓名:赵文浩 学号:16111204082 班级:2016 级计算机科学与技术
1-4 证明等式 gcd(m,n)=gcd(n mod m, m) 对每对正整数 m 和 n,m>0 都成立。
1-13 写一个递归算法和一个迭代算法计算二项式系数:
#include<stdio.h> int Coef_recursive(int n,int m);//递归算法 int Coef_iteration(int n,int m);//迭代算法 int Factorial(int n);//计算 n 的阶乘 int main() { int n,m;
1-12 试用归纳法证明程序 1-7 的排列产生器算法的正确性。
证明:主函数中,程序调用 perm(a,0,n),实现排列产生器。 ① 当 n=1 时,即数组 a 中仅包含一个元素。函数内 k=0,与(n-1)=0 相等,因此函 数内仅执行 if(k==n-1)下的 for 语句块,且只执行一次。即将 a 数组中的一个元 素输出,实现了对一个元素的全排列。因此当 n=1 时,程序是显然正确的; ② 我们假设程序对于 n=k-1 仍能够满足条件, 将 k-1 个元素的全排列产生并输出; ③ 当 n=k 时,程序执行 else 下语句块的内容。首先执行 swap(a[0],a[0]),然后执 行 Perm(a,1,n),根据假设②可知,该语句能够产生以 a[0]为第一个元素,余下 (k-1)个元素的全排列; 然后再次执行 swap(a[0],a[0]), 并进行下一次循环。 此时 i=1, 即在本次循环中, 先执行 swap(a[0],a[1]), 将第二个元素与第一个元素互换, 下面执行 Perm(a,1,n), 根据假设②可知, 该语句产生以 a[1]为第一个元素, 余下(k-1)个元素的全排列; 以此类推,该循环每一次将各个元素调到首位,通过执行语句 Perm(a,1,n)以及 基于假设②,能够实现产生 k 个元素的全排列。 因此 n=k 时,程序仍满足条件。 ④ 综上所述,该排列器产生算法是正确的,证毕。
(陈慧南 第3版)算法设计与分析——第5章课后习题答案
int main() { int n, x, *a; cin >> n; a = new int[n]; for (int i = 0; i < n; i++) cin >> a[i]; cin >> x; if (Triple_search(a, 0, n - 1, x) == -1) cout << "NotFound!" << endl; else cout << Triple_search(a, 0, n - 1, x) << endl; delete []a; return 0; } int Triple_search(int a[], int l, int r, int x) { if (l <= r) { int m1 = l + (r-l)/3; int m2 = l + (r-l)*2/3; if (a[m2]<x) return Triple_search(a, m2 + 1, r, x); else if (a[m1] < x && a[m2] > x) return Triple_search(a, m1 + 1, m2 - 1, x); else if (a[m1] > x) return Triple_search(a, l, m1 - 1, x); else if (a[m1] == x) return m1; else if (a[m2] == x) return m2; } return -1; }
(3) 分析算法的时间复杂度 上述算法的时间复杂度为 n 2
5-19 给定 n 个点, 其坐标为 xi , y j 0 i n 1 , 要求使用分治策略求解设计算 法,算出其中距离最近的两个点。两点间的距离公式为: (1) 写出算法的伪代码;