
常用医学统计学符号word精品
医学统计学符号-公式-重点

在偏态分布时,易受极值影响;
1. 当观察例数 n 为奇数时,中位
算术均数
数是按顺序排列在第(n+1)/2 项
算数均数(均数):线性尺度上的 n 为偶数时,中位
几何均数及应用
数是按顺序排列在第 n/2 和
几何均数:对数尺度上的平均水
(n/2)+1 项观察值的平均值;
几何均数
中位数
均数尺度 适用
线性 对称分布
对数
对数正态分布 (指数、等比分布)
顺序 偏态分布
单侧 95%=双侧 90%=1.645 μ±σ:68%
正态分布及应用
μ±1.96σ:95%
正态分布有两个参数 和 , 分别表示均数和标准差
μ±2.58σ:99% 二、医学参考值范围的制定方法
页脚内容7
医学统计学总结
平;
百分位数
1. 几何均数的对数等于各观察 百分位数 Px:指在一组数据中找
值对数的算术均数;
到这样一个数值,全部观察值的
页脚内容5
x%小于 Px ,其余(100-x)%大于 Px。
算术均数
几何均数
中位数
均数尺度 适用
线性
对数
对称分布
对数正态分布 (指数、等比分布)
顺序 偏态分布
医学统计学总结
定量:频数表/图
异
不同类型变异程度指标的比较
当μ=0,σ=1 时,称为标准正态
特点
极差
四分位数间距 方差和标准差
变异系数
特点
简单,粗略;不 稳定,受极端值
影响大
相对稳定;未使 用所有观察值
使用全部信息, 应用广泛
比较无量纲或多 组均数相差较大
数据
统计学符号及读音

统计学符号及读音
统计学符号意义及读音
按照国家标准GB3358-82《统计学名词及符号》的有关规定书写,常用
如下:
(1) 样本的算术平均数用英文小与x ( 中位数仍用M) ;
(2) 标准差用英文小与s;
(3) 标准误用英文小写Sx;
(4) t 检验用英文小写t;
(5) F 检验用英文大写F;
(6) 卡方检验用希文小写字X2;
(7) 相关系数用英文小写r;
(8) 白由度用希文小写u;
(9) 概率用英文大写P (P 值前应给出具体检验值,如t 值、字2值、q 值等) 。
以上符号均用斜体。
拉丁字母
假定均数X 样本均数Y
Y 变量;变量值,观察值;回归中的应(因)变量y Y 变换后的变量或变量值Y 样本均数
希腊字母
符号名称符号名称
a 检验水准,显著性水准;第一类错误的概率1- a 可信度,置信度
B 第二类错误的概率;总体回归系数1- B 检验效能,把握度
v(n') 自由度n 总体率
卩总体均数p 总体相关系数
艺求和的符号(T 总体标准差
(T 2 总体方差x 2 x 2检验的统计量
符号名称符号名称
A X2 检验中的实际频数A,b,c,d 四格表中的实际频
a 样本回归直线在丫轴上的截距
b 样本回归系数
C 校正数;常量;x2 检验中的列(栏)数CI 可信区间CL 可信限CV 变异系数
d 两数之差值d 差值的均数
f ( X) 连续型分布密度函数,密度f 观察频数,实际频数。
医学期刊中常用的统计学符号
肝 肾功 能轻 度损 害、 肌病稳定 期的患者应 谨慎的逐 步增加他 汀类的剂量进行治疗 , 从而确定 患者 的反应性 和耐受 性 。 目
[0 Cn o P Ba n a , cae H,t1 n ni r s o e 1 ] an n , r w d M c e a It s e e u m r C n l E b C . e v v ¥ d - a p w r g i a n ae au r a n r e[ ] N t l i l e n t s f s fr ct c o r s d m s J . eid o i w h t t e o n y y o i
作用是肯定 , C A S患者应 该早期 进行强 化调脂 治疗 。对 于有
paatt rvs i an(+ /一cls rm n/ i i)iia di eityat o t a ie na n nt t ey c ie mm dae fr l e
acrnr vn:terno i dLpdCrn r A t i ae[ oo ayeet h d m z ii・ooay r r Ds s L a e e y e
1 9 3 4:3 3~9. 9 4,4 1 8
y nr e a e k r f l i s i y J . A o a i s d m : nwi i i c i t l [ ]J m C iC r o y o n e o cn a n a i l b t l dl
—
C D Suy J . m J a i , 0 , :23 8 A ] t [] A C r o 2 0 8 1 9 — . d dl 0 6
医学统计学公式整理

医学统计学公式整理1. 平均数(Mean):平均数是一组数据的所有观察值之和除以观察值的个数。
用数学符号表示为:μ = (x1 + x2 + ... + xn) / n。
其中,μ表示总体均值,x1,x2,...,xn表示样本数据,n表示样本容量。
2. 中位数(Median):中位数是将一组数据按照大小排序后,位于中间位置的数值。
对于有奇数个数的数据,中位数是中间的那个数;对于有偶数个数的数据,中位数是中间两个数的平均值。
3. 众数(Mode):众数是一组数据中出现次数最多的数值,可以有一个或多个。
4. 方差(Variance):方差是一组数据与其均值之差的平方的平均值,用来衡量数据的离散程度。
用数学符号表示为:σ^2 = ( (x1-μ)^2 + (x2-μ)^2 + ... + (xn-μ)^2 ) / n。
5. 标准差(Standard Deviation):标准差是方差的平方根,用来衡量数据的离散程度。
用数学符号表示为:σ = sqrt( ( (x1-μ)^2 + (x2-μ)^2 + ... + (xn-μ)^2 ) / n )。
6. 相对风险(Relative Risk):相对风险是比较两个暴露组之间罹患其中一种疾病的风险大小的指标。
计算方式为:相对风险=(发病率在暴露组中的比例)/(发病率在非暴露组中的比例)。
相对风险大于1表示暴露组的风险大于非暴露组,相对风险小于1表示暴露组的风险小于非暴露组,相对风险等于1表示两组风险相等。
7. 绝对风险差(Absolute Risk Difference):绝对风险差是比较两个暴露组之间发病率差异的指标。
计算方式为:绝对风险差=(发病率在暴露组中的比例)-(发病率在非暴露组中的比例)。
绝对风险差大于0表示暴露组的发病率高于非暴露组,绝对风险差小于0表示暴露组的发病率低于非暴露组,绝对风险差等于0表示两组发病率相等。
8. 相对危险度(Relative Risk Ratio):相对危险度是比较两个暴露组之间发病率的相对大小的指标。
(完整word版)医学统计学公式整理
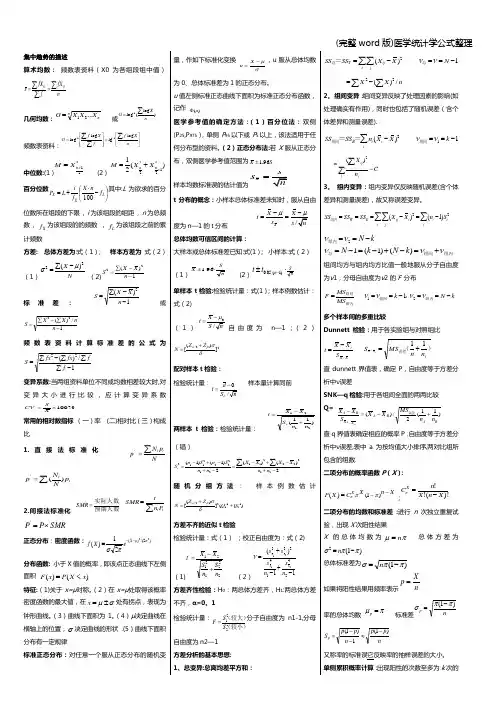
集中趋势的描述算术均数: 频数表资料(X0为各组段组中值)n fX ffX x OO∑∑∑==几何均数:n nX X X G ...21= 或)log (log 1nX G ∑-=频数表资料:⎥⎦⎤⎢⎣⎡=⎥⎥⎦⎤⎢⎢⎣⎡=∑∑∑--n X f f X f G log lg log log 11 中位数:(1)*21+=n XM (2) )(21*12*2++=n n X X M百分位数⎪⎭⎫⎝⎛-⋅+=L X X f n X f i L P 100其中:L 为欲求的百分位数所在组段的下限 , i 为该组段的组距 , n 为总频数 , X f 为该组段的的频数 , L f 为该组段之前的累计频数方差: 总体方差为:式(1); 样本方差为 式(2) (1)N X 22)(μσ-∑=(2)1)(22--∑=n X X S标准差:1)(2--∑=n X X S或 1/)(22-∑-∑=n nX X S频数表资料计算标准差的公式为1/)(22-∑∑∑-∑=f f fx fx S变异系数:当两组资料单位不同或均数相差较大时,对变异大小进行比较,应计算变异系数%100⨯=X SCV常用的相对数指标 (一)率 (二)相对比(三)构成比1.直接法标准化NpN p ii∑='∑=i i p NN p )('2.间接法标准化预期人数实际人数=SMR∑=ii P n rSMRSMR P P ⨯='正态分布:密度函数:)2/()(2221)(σμπσ--=X e X f分布函数: 小于X 值的概率,即该点正态曲线下左侧面积 )()(x X P x F <=特征:(1)关于x=μ对称。
(2)在x=μ处取得该概率密度函数的最大值,在σμ±=x 处有拐点,表现为钟形曲线。
(3)曲线下面积为1。
(4)μ决定曲线在横轴上的位置,σ决定曲线的形状 .(5)曲线下面积分布有一定规律标准正态分布:对任意一个服从正态分布的随机变量,作如下标准化变换σμ-=X u ,u 服从总体均数为0、总体标准差为1的正态分布。
统计学符号及读音

统计学符号意义及读音按照国家标准GB3358-82《统计学名词及符号》的有关规定书写,常用如下:(1) 样本的算术平均数用英文小与x ( 中位数仍用M) ;(2) 标准差用英文小与s;(3) 标准误用英文小写Sx;(4) t 检验用英文小写t;(5) F 检验用英文大写F;(6) 卡方检验用希文小写字X2;(7) 相关系数用英文小写r;(8) 白由度用希文小写u;(9) 概率用英文大写P (P 值前应给出具体检验值,如t 值、字2值、q 值等) 。
以上符号均用斜体。
拉丁字母假定均数X 样本均数YY 变量;变量值,观察值;回归中的应(因)变量y Y 变换后的变量或变量值Y 样本均数希腊字母符号名称符号名称a 检验水准,显著性水准;第一类错误的概率1- a 可信度,置信度B 第二类错误的概率;总体回归系数1- B 检验效能,把握度v(n') 自由度n 总体率卩总体均数p 总体相关系数艺求和的符号(T 总体标准差(T 2 总体方差x 2 x 2检验的统计量符号名称符号名称A X2 检验中的实际频数A,b,c,d 四格表中的实际频a 样本回归直线在丫轴上的截距b 样本回归系数C 校正数;常量;x2 检验中的列(栏)数CI 可信区间CL 可信限CV 变异系数d 两数之差值d 差值的均数f ( X) 连续型分布密度函数,密度f 观察频数,实际频数G 几何均数;对数似然比检验的统计量H 调和均数;H 检验的统计量Hg检验假设,无效假设H1备择假设i组距;行次L 下限各样本含量的总和M中位数N 有限总体含量;n样本含量;各样本含量的总和P 概率P(1)单侧检验的概率P (2)双侧检验的概率Px 第x 百分位数P 样本率R 极差;样本复相关系数;x2 检验中的行数r 样本相关系数RR 相对危险度s 样本标准差S2 样本方差sb 样本回归系数的标准误S02 合并样本方差sd (样本)差值的标准差s-d (样本)差值均数的标准误sp 样本率的标准误Sp1-p2 两样本率差的标准误sX 样本均数的标准误SD 标准差SE 标准误T X2 检验的理论频数;Wilcoxon 秩和检验的统计量t t 检验的统计量u 标准正态变量;标准正态(离)差;u 检验的统计量X 变量;变量值,观察值;回归中的自变量x X 变换后的变量或变量值Xi 变量X 的第i 个观察值;第i 个变量XO这些都是希腊文序号大写小写英文注音国际音标注音中文注音1 A a alpha a:lf 阿尔法2 B B beta bet 贝塔3 r Y gamma ga:m 伽马4 A S delta delt 德尔塔5 E e epsilon ep'silon 伊普西龙6 Z Z zeta zat 截塔7 H n eta eit 艾塔8 0 0 thet 0 it 西塔9 I i iot aiot 约塔10 K K kappa kap 卡帕11 A 入lambda lambd 兰布达12 M 卩mu mju 缪13 N v nu nju 纽14 S E xi ksi 克西15 O o omicron omik'ron 奥密克戎16 n n pi pai 派17 P p rho rou 肉18 刀c sigma 'sigma 西格马19 T T tau tau 套20 Y u upsilon jup'silon 宇普西龙21①© phi fai 佛爱22 X x chi phai 西23 W psi psai 普西24 Q 3 omega o'miga 欧米伽3(德尔塔)£ (艾普西龙)欢迎您的下载,资料仅供参考!致力为企业和个人提供合同协议,策划案计划书,学习资料等等打造全网一站式需求。
统计学符号及读音
统计学符号及读音统计学符号意义及读音按照国家标准GB3358-82《统计学名词及符号》的有关规定书写,常用如下:(1) 样本的算术平均数用英文小与x (中位数仍用M) ;(2) 标准差用英文小与s;(3) 标准误用英文小写Sx;(4) t检验用英文小写t;(5) F检验用英文大写F;(6) 卡方检验用希文小写字X2;(7) 相关系数用英文小写r;(8) 白由度用希文小写u;(9) 概率用英文大写P (P值前应给出具体检验值,如t值、字2值、q 值等)。
以上符号均用斜体。
拉丁字母假定均数X样本均数YY变量;变量值,观察值;回归中的应(因)变量y Y变换后的变量或变量值Y样本均数希腊字母符号名称符号名称α检验水准,显著性水准;第一类错误的概率1-α可信度,置信度β第二类错误的概率;总体回归系数1-β检验效能,把握度ν(n′)自由度π总体率μ总体均数ρ总体相关系数Σ求和的符号σ总体标准差σ2总体方差χ2χ2检验的统计量符号名称符号名称A X2检验中的实际频数A,b,c,d四格表中的实际频a样本回归直线在Y轴上的截距b样本回归系数C校正数;常量;x2检验中的列(栏)数CI可信区间--------------------------------------------------------------------------------CL可信限CV变异系数--------------------------------------------------------------------------------d两数之差值d差值的均数f(X)连续型分布密度函数,密度f观察频数,实际频数G几何均数;对数似然比检验的统计量H调和均数;H检验的统计量Hg检验假设,无效假设H1备择假设i组距;行次L下限M中位数N有限总体含量;各样本含量的总和n样本含量;各样本含量的总和P概率P(1)单侧检验的概率P(2)双侧检验的概率Px第x百分位数P样本率R极差;样本复相关系数;x2检验中的行数r样本相关系数RR相对危险度s样本标准差S2样本方差sb样本回归系数的标准误S02合并样本方差sd(样本)差值的标准差s-d(样本)差值均数的标准误sp样本率的标准误Sp1-p2两样本率差的标准误sX样本均数的标准误SD标准差SE标准误T X2检验的理论频数;Wilcoxon秩和检验的统计量t t检验的统计量u标准正态变量;标准正态(离)差;u检验的统计量X变量;变量值,观察值;回归中的自变量x X变换后的变量或变量值Xi变量X的第i个观察值;第i个变量XO这些都是希腊文序号大写小写英文注音国际音标注音中文注音1 Ααalpha a:lf 阿尔法2 Ββbeta bet 贝塔3 Γγgamma ga:m 伽马4 Δδdelta delt 德尔塔5 Εεepsilon ep`silon 伊普西龙6 Ζζzeta zat 截塔7 Ηηeta eit 艾塔8 Θθthet θit 西塔9 Ιιiot aiot 约塔10 Κκkappa kap 卡帕11 ∧λlambda lambd 兰布达12 Μμmu mju 缪13 Ννnu nju 纽14 Ξξxi ksi 克西15 Οοomicron omik`ron 奥密克戎16 ∏πpi pai 派17 Ρρr ho rou 肉18 ∑σsigma `sigma 西格马19 Ττtau tau 套20 Υυupsilon jup`silon 宇普西龙21 Φφphi fai 佛爱22 Χχchi phai 西23 Ψψpsi psai 普西24 Ωωomega o`miga 欧米伽δ(德尔塔)ε(艾普西龙)。
word完整版医学统计学公式总结推荐文档
资料的描述性统计(一)算术均数(mean )(1)简单算术平均值定义公式为(直接法)(2)利用频数表计算均数(加权法)计算95%或 99%勺可信区间)(可信区间计算是用标准误,参考值范围计算用标准差,百分位数法大家自己看书)三T 检验与方差分析(一) T 检验(1)单样本T 检验X 1 X 2 X 3X nf l X i f 2X 2f 3X 3 f k X kfx1f 2f 3方差(即标准差的平方)(X ① s- n 1X 2 ( X )2/n变异系数 CV100%均数的标准误二参数估计与参考值范围s Sx —In样本率的标准误SPP(1 P ) n(p 为样本率)(四)T 分布t X(u 为总体均数)s v n总体均数的区间估计X t /2, s XX t /2, s x般要求(五)总体率的区间估计p u /2s pU /2S p(六)参考值范围估计 双侧1-a 参考值范围:U a/2Sx 单侧1-a 参考值范围:U a s 或 X U a S统计量t 值的计算:t X 0 X 0 s x s/侖(2)配对T 检验检验假设:H 0:12(二) 单因素方差分析来源 SSvMSF组间2SS BT iCBk1 SS BB组内SS VniWNkMS B MSvsw SS BSSW, W合计SS TX 2 CTN 1(2) 随机单位组设计资料的方差分析SS 总=SS 处理+SS 区组+SS 误差 V 总=V 处理+V 区组+V 误差这里C ( X )2/N TX (T 即为该组数据之和) ij检验假设H o :(假设样本来自均数为 u 0的正态总体)统计量t 值的计算:ds d(d 为两组数据的差值,Sd 为差值的标准差) (3)两样本T 检验 检验假设:H:0・1 2统计量t 值的计算:t(XlX2)( 12)n 1 n 2 2其中X 2X 1(X 1X 1)2 n 1n 1(X 2 乂2)2两样本方差齐性检验 的比值)2 S 1_ 2 S21 n 12 n 2 1(即为两样本方差SS B B B MS B FSS W WMS W(1 )完全随机设计资料的方差分析 SS 、SSt 间 Sgt 内总组间 组内四列联表分析卡方检验(三)双向无序资料的关联性检验(四)多个样本率间的多重比较每一个两两比较的检验水准:注意:1、有1/5以上格子的理论频数小于5;2、 一个理论频数小于 1;3、 总样本例数小于 40当有以上三种情况或之一存在时,均不适宜进行卡方检验来源 表5-7随机单位组设计资料的方差分析表F(两种方差分析的主要区别在于:从组内变异中分解出单位组变异与误差变异。
(完整word版)医学统计学符号,公式,重点
(完整word版)医学统计学符号,公式,重点第⼀章医学统计中的基本概念1、医学统计学是研究医学数据的收集、整理、分析、解释和呈现其结果的⼀门学科。
2、个体:研究的基本观察单位。
3、变量:⽤于观察研究对象的指标。
4、观察值:个体变量的数值。
5、资料:⼜称为数据,由变量的观察值构成。
变异:个体观察值之间具有的差异。
变异和同质是对统计学数据的要求!变异是统计学研究的真正对象!统计学是研究变异规律的科学!同质:个体观察值之间的变异在允许范围内。
异质:个体观察值之间的变异超出允许范围。
⼀、总体、抽样、样本、参数、统计量总体:同质的个体所构成的全体研究对象。
总体同时具有同质和变异两个特点。
有限总体:总体中的个体数量是有限的。
⽆限总体:总体中的个体数量是⽆限的。
样本:从总体中随机抽取的部分个体。
样本量:样本所包含的个体数⽬。
参数:刻画总体特征的指标。
统计量:刻画样本特征的指标。
抽样:从总体中随机抽取部分个体的过程。
抽样具有代表性、随机性、可靠性、可⽐性;原则:代表性:样本能充分反映总体特征。
随机性:保证总体中每个个体都有相同的⼏率被抽样。
随机性是代表性的保证;⽣活中随机性的例⼦(思考题);计量资料:由连续变量的观察值构成的资料。
对每个观察对象的观察指标⽤定量⽅法测定其数值⼤⼩所得的资料,⼀般有度量衡单位,例如年龄、⾝⾼、⾎糖。
计数资料:由离散变量的观察值构成的资料。
先将观察对象的观测指标按性质或类别进⾏分组,然后计数各组的数⽬所得的资料,例如性别、患病、⾎型。
等级分组资料:由等级变量的观测值构成的资料。
具有计数资料的特征,同时⼜具有半定量性质的资料,例如细菌培养阳性结果。
⼆、3种设计类型:完全随机设计;配对设计;配伍组设计。
三、抽样误差、概率和⼩概率事件抽样误差:由抽样引起的样本统计量与总体参数之间的差异。
抽样误差的原因;抽样误差是不可避免的。
概率P :表⽰某事件发⽣的可能性⼤⼩的度量。
⼩概率事件:统计学上习惯将P ≤0.05或P ≤0.01的事件称为⼩概率事件,表⽰该事件发⽣的可能性很⼩。
医学常用简写与符号(打印版)
医学符号及常用药的别名(打印张贴版)一、常用医学符号qd——1日1次 bid——1日2次 tid——1日3次qid——1日4次 qod——隔日1次 qw——每周1次biw——两周1次 q2h——每2小时1次 q8h——每8小时1次qn——每晚睡前1次 2~3次/d——每日2~3次二、用药符号三、常用药别名普萘洛尔-心得安阿替洛尔-胺酰心安硝酸异山梨酯-消心痛硝苯地平-心痛定曲克芦丁-维脑路通氢氧化铝-胃舒平沙丁胺醇-舒喘灵醋酸甲羟孕酮-安宫黄酮甲氧氯普胺-胃复安甲硝唑-灭滴灵去甲肾上腺素-正肾素肾上腺素-副肾素15AA-肝安9AA-肾安消旋山莨菪碱-654-2 头孢噻肟钠-治菌必妥头孢曲松纳-曲而松喷托维林-咳必清诺氟沙星-氟哌酸呋喃唑酮-痢特灵洛贝林-山梗菜碱尼可刹米-可拉明拉米夫定-贺普丁吲哚美辛-消炎痛吡罗昔康-炎痛喜康复方氨基比林-安痛定去痛片-索密痛酚氨咖敏-扑感敏利巴韦林-病毒唑小檗碱-黄连素异烟肼-雷米封胞磷胆碱-胞二磷胆碱乙酰谷酰胺-醋谷胺罗痛定-颅痛定氨咖黄敏胶囊-速效伤风胶囊苯海索-安坦苯妥英纳-大伦丁苯巴比妥钠-鲁米那吡硫醇-脑复新吡拉西坦-脑复康异丙酚-丙泊酚(得普利麻)维拉帕米-异博定间羟胺-阿拉明酚妥拉明-利其丁桂利嗪-脑益嗪去乙酰毛花苷-西地兰普罗帕酮-心律平美西律-慢心律倍他司汀-培他啶卡托普利-巯甲丙脯酸复方甘草合剂-棕色合剂碳酸氢钠-小苏打西咪替丁-甲氰咪胍干酵母-食母生多潘立酮-吗丁啉酚酞-果导葡醛内酯-肝泰乐氢氯噻嗪-双克呋塞米-速尿螺内酯-安体舒通缩宫素-催产素肾上腺色综-安络血氨甲苯酸-止血芳酸酚磺乙胺-止血敏亚硫酸氢纳甲萘醌-维生素K3硫酸氢钠甲萘醌-维生素K4 叶绿醌-维生素K1 利血生-利可君双嘧达莫-潘生丁异丙嗪-非那根氯苯那敏-扑尔敏地塞米松-氟米松泼尼松龙-强的松龙泼尼松-强的松氢化可的松-皮质醇曲安奈德-康宁克通丙酸睾丸素-丙酸睾酮甲基睾丸素-甲睾酮氯米芬-克罗米芬格列本脲-优降糖苯乙双胍-降糖灵甲巯咪唑-他吧唑丙基硫氧嘧啶-丙噻优多柔比星-阿霉素表柔比星-表阿霉素他莫昔芬-三苯氧胺地芬尼多-眩晕停维生素C-抗坏血酸氯化钠-生理盐水(N.S)葡萄糖-G.S氯化钠葡萄糖-G.N.S 地西泮-安定艾司唑仑-舒乐安定氯硝西泮-氯硝安定咪达唑仑-力月西(咪唑安定)可待因-甲基吗啡布桂嗪-强痛定哌替啶-杜冷丁汞溴红溶液-红药水过氧化氢-双氧水高锰酸钾粉-P.P粉乙酰唑胺-醋氮酰胺头孢噻吩-先锋1号头孢噻啶-先锋2号头孢氨苄-先锋4号头孢唑林纳-先锋5号头孢拉定-先锋6号头孢羟氨苄-先锋9号头孢哌酮-先锋必多西环素-强力霉素米若环素-美满霉素阿昔洛韦-无环鸟苷异丙肾上腺素-喘息定依托泊苷-足叶乙甙林可霉素-洁霉素复方肝浸膏-肝铁片(力勃隆)苄星青霉素-长效青霉素复方愈创木酚磺酸钾-非那根合剂复方甘草酸单胺-强力宁己烯雌酚-乙底酚(求偶素)亚叶酸钙-甲酰四氢叶酸钙阿米卡星-丁胺卡那霉素复方磺胺甲恶唑-复方新若明(SMZ) 依托红霉素-无味红霉素。