
实验设计的统计学基本原则
第十一章实验设计的统计学基本原则
实验(Experiment):指由研究者主动地决定给予部分实验对象某种处理,给予另部分对象某种对照处理的研究设计形式,这种处理的分配常常是随机的。
实验设计(Experimental design):是通过良好地计划对象的选择、处理因素的分配、结果指标的测量和资料分析来保证比较组间对象和实验条件是均衡的,实验结果有较好的可比性,并且较好地控制误差以能用较小的样本获取可靠的结论。
一.实验设计的三要素:受试对象、处理因素和实验效应。
1.处理因素(treatment):根据研究目的,对受试对象施加的某种措施,称为处理因素。
注意:①抓住主要因素。
②控制混杂因素(“非处理因素”在各组中应尽可能相同)。
③标准化(处理因素应该标准化,即研究过程中处理应该自始至
终保持一致,不能因任何原因中途改变。
)
2.受试对象(subject):动物——种类,品系,窝别
人——诊断,依从性
注意受试对象的同质性 (homogeneity)
3.实验效应(effect):
指标选择:有效,客观,灵敏,精确。
(头痛,发烧)
指标观察:对人的观察应注意避免偏性,提倡盲法。
主观指标的量化:如划记评分。
完全不满意完全满意
0 1 2 3 4 5 6 7 8 9 10
二.实验研究的分类:根据实验的对象不同,实验分成三类。
1. 动物实验(animal experiment)
2. 临床试验(Clinical trial)
3. 现场干预试验(Intervention trial)
三.实验中的变异及其来源:
在实验中,由于实验对象自身特点、实验条件的变化和实验结果测量的不确定性造成实验结果与真值的差别称实验误差,根据统计分析上的处理不同,实验误差分成两类:
1. 随机误差:由大量、微小的、偶然的因素的共同作用引起的不易控制的误差称随机误差。
如在实验中,温度、湿度、风向、振动、试剂、仪器、操作员等都可能造成结果的偏差。
随机变异是没有倾向性的,在大量观察条件下,随机误差的分布呈标准N。
随机误差的规律可以用统计方法分析。
正态分布()1,0
2.系统误差(systematic error):由于在对象选择、处理因素分配的不随机、测量结果的不准确造成实验结果有倾向性地偏离真值称系统误差,或称偏倚(bias)。
(1)选择偏倚(selection bias):指在选择研究对象和分组时的非随机化,造成结果的偏倚。
如肝癌手术治疗与化疗的疗效比较中,由于手术对象的选择性造成有利于手术组的结果。
(2)信息偏倚(information bias):指测量方面的误差,特别是主观因素造成的有倾向性的偏倚。
如在临床试验中,实验组是在医院测量,对照组是在家中测量。
(3)混杂偏倚(confounding bias):指实验组与对照组在一些影响实验结果的非处理因素不均衡造成结果的偏倚。
如病情轻重、并发症、辅助治疗和护理等因素不均衡。
四.实验设计的原则:
(一)对照原则(control):指设立对照组以排除非处理因素而显示出处理的
效应。
处理组处理因素+ 非处理因素= 处理和非处理的效应
对照组非处理因素= 非处理因素的效应
对比:处理因素= 处理效应
均衡 (balance):指各对比组之间除处理因素不同外,其它重要的可控制的非处理因素的分布保持一致。
(1)实验对象的特征保持一致,如年龄、性别、病情轻重、社会地位、文化、收入等。
(2)实验条件保持一致,如实验过程、药的形状、仪器、护理、辅助治疗等。
(3)测定结果和疗效评价保持一致,如调查的地点、询问的方式、疗效的评判标准、指标的测量过程等。
为避免医生和病人的主观性,常采用盲法和安慰剂。
(4)依从性(Compliance)在临床疗效评价试验中,病人的依从性也会影响到研究结果,如对照组的病人可能依从性较差,造成虚假的新药有效的结果。
评价依从性的最常用也是最简单的方法是数药片。
其它还有询问法和测定法。
临床试验中对照组的选择:
试验组(处理组):受试者接受新药治疗。
对照组:受试者接受对照药物的治疗。
1.安慰剂对照:
安慰剂(Placebo)指外形、味道和包装都与实验药物一样的无疗效的药物。
排除服药行为的疗效作用。
目的是在于消除研究者、受试者和参与评价人员等由心理因素等影响而形成的偏倚,分离出由试验药物所引起的真正的效应。
2.阳性药物对照:以在临床试验中采用已知的、已批准上市的有效药物作为试验药的对照, 称为阳性药物对照。
3.剂量-反应对照:将试验药物设计成几个剂量, 而受试者随机地分入其中一个剂量组;它可以包括安慰剂对照即零剂量,也可以不包括安慰剂组。
剂量-反应对照主要用于研究剂量与疗效的关系,或者仅用于说明疗效。
★盲法试验(Blind trial):单盲法指病人不知道接受了何种治疗,双盲法指病人、执行医生都不知道接受了何种治疗。
三盲法指病人、执行医生和统计工作者都不知道接受了何种治疗。
★双模拟技术(double dummy):由申办者制备一个与试验药外观相同的安慰剂,称为试验药的安慰剂;再制备一个与对照药外观相同的安慰剂,称为对照药品的安慰剂。
按编码结果,试验组服用试验药加上对照药的安慰剂;对照组服用对照药加上试验药的安慰剂;各药和其安慰剂服用方法相同。
因此从整个用药情况来看,每个病例所服用的药物,每日次数,每次片数都是一样的,这就保证盲法的实施。
(二)随机原则(randomization):指在实验对象的抽样、分组、治疗顺序和结果测量等方面每个对象都有同等的概率。
在实验中,许多不可控制的混杂因素是没办法完全达到均衡的,而且许多因素事先无法预知会影响实验结果,也就未能在设计时加以控制。
这些因素在组间的均衡就依赖于随机化来保障。
在分析内科年鉴、英国医学杂志、Lancet、新英格兰医学杂志上发表的80篇随机对照临床试验文章,30%没有清楚的证据说明是真正随机化的。
1.简单随机化:
设有n个对象,需分配到k个组,实验对象分别编号为1,2,…,n。
在随机数字表找出n个随机数,相同的随机数舍弃,将随机数按值大小排秩,每个秩就对应一个实验对象。
然后将前面的n/k个对象分到第一组,第二部分的n/k 分到第二组,余类推。
例如:将20例实验对象随机分为两组。
2.区组随机化:
随机化不能保证比较的组间达到均衡。
一些重要的混杂因素必须通过分层或区组随机化来保障。
在区组内的随机化,设每个区组有k个对象,分别编号为1,2,…,k。
从随机数字表抽出k个随机数,舍弃相同值,按大小编秩,每个秩号对应区组内的一个对象,再按随机数顺序分配处理。
随机数 1 9 3 6 2
秩次 1 5 3 4 2
分组 A B C D E
(三)重复原则(replication):是指实验要有足够的样本,在同样的实验条件下要重复观察足够的次数,即在实验设计中需估计样本含量。
1.容许误差δ。
2.总体标准差σ。
3.第一类错误的概率α。
4.第二类错误的概率β。
五.临床试验中的伦理学问题:
基本原则:
1. 新药必须经过严格的临床前实验,并通过有关部门检验和批准。
2. 告知受试病人所有有权知道的信息,取得病人的书面同意。
3. 报告进行临床试验的单位和医生必须有必要的资格和计划。
无特效药时,伦理学问题较小。
有特效药时,而仅寻找类似的新药时,伦理学问题大。
在不知治疗是否有效时,使用安慰剂无伦理学问题。
如已知治疗有效时,使用安慰剂则有伦理学问题,这时最好用阳性药物对照。
统计学教案习题13实验设计

第十三章实验设计一、教学大纲要求(一)掌握内容1. 实验设计的基本原则随机化原则、对照的原则(对照的类型,对照的设置)、重复的原则。
2. 实验设计的基本内容和步骤3. 常用的实验设计方法(1)随机化分组方法;(2)完全随机分组设计;(3)配对设计;(4)配伍组设计及随机分组方法。
4.确定样本含量确定样本含量应当具备的条件:α、1-β、δ、σ 。
(二) 熟悉内容1. 常用的估计样本含量的计算方法及估计该试验的检验效能的方法。
(1)两样本均数比较。
(2)配对试验。
(3)样本均数与总体均数的比较。
(4)两样本率的比较。
(5)配对资料进行卡方检验时的样本含量估计。
(6)抽样调查估计总体均数的样本含量。
(7)抽样调查估计总体率的样本含量。
2. 一致性检验:Kappa值的意义及计算。
(三)了解内容1 实验设计的特点和分类。
2.临床设计书的主要内容。
3.Kappa值的抽样误差和假设检验。
二、教学内容精要(一)实验设计的特点和分类实验研究(experimental study)是指研究者根据研究目的(或研究假设),主动加以干预措施,并观察总结其结果,回答假设研究所提出的问题的一种研究方法。
实验研究可根据研究对象的不同分为两类:以动物或标本为研究对象的实验研究(experiment)和以人为研究对象的临床试验(clinical trial)。
(二)实验设计的基本原则1.随机化原则总体中的每一个观察单位都有同等的机会被选入实验组和对照组或进入样本,保证了非处理因素在各组间均衡一致而使样本具有代表性。
2.对照原则正确的设立对照可可控制实验过程中非实验因素的影响和偏倚,从而使处理因素的效应充分的显露出来。
设立对照组的常见方法有:空白对照、安慰剂(placebo)对照、实验对照、标准对照及自身对照。
3.重复的原则保证每一个处理都有足够的重复数(样本量),避免把偶然性或巧合的现象当作必然的规律性现象,并能正确的估计实验误差。
设计实验的方案和统计学的基本原理
设计实验的方案和统计学的基本原理在科学研究中,实验是发现和验证事实的一个重要途径。
设计一个合理的实验方案,不仅能够更准确地获取实验数据,还能够更好地减少误差和提高实验效率。
而在实验数据分析中,统计学是一个不可或缺的工具,它可以帮助我们更好地理解和解释实验结果。
本文将介绍设计实验的方案和统计学的基本原理。
一、实验设计的基本原则1.确定实验目的在设计实验方案时,首先需要明确实验目的。
实验目的应当明确具体,不应当过于笼统,同时也需要注重实际应用和研究价值。
只有明确实验目的,才能更好地制定实验方案和评估实验结果。
2.确定实验种类实验可以分为控制实验和观察实验两种。
控制实验是通过对研究对象的控制,来得出结论的方法;而观察实验则是通过对现象进行观察和记录,来得出结论的方法。
在设计实验方案时,需要根据实验目的和研究对象的特点,选择控制实验或观察实验。
3.确定实验独立变量和因变量在实验设计中,需要明确实验的独立变量和因变量。
实验独立变量是指实验中进行改变的变量,它会对因变量产生影响;而因变量是指实验中依赖于独立变量而发生变化的变量。
明确实验中的独立变量和因变量,有助于更好地控制实验条件和分析实验结果。
4.制定实验流程制定实验流程是实验设计中的重要环节。
在制定实验流程时,需要考虑实验操作的可行性,实验设备的可靠性,实验时序的合理性等因素。
只有合理地制定实验流程,才能得到可靠的实验结果。
二、统计学的基本原理在实验数据分析中,统计学是一个不可或缺的工具。
统计学是研究数据的收集、分析和解释的一门学科。
它可以帮助我们更好地理解和解释实验结果。
以下是统计学的基本原理:1.总体和样本总体是指研究对象的全部内容。
样本是指从总体中选取的一部分数据。
在进行实验时,通常只能获取到样本数据,而无法获取到全部总体数据。
2.参数和统计量参数是指描述总体特征的量,例如总体均值、总体标准差等。
统计量是指描述样本特征的量,例如样本均值、样本标准差等。
生物统计学实验设计
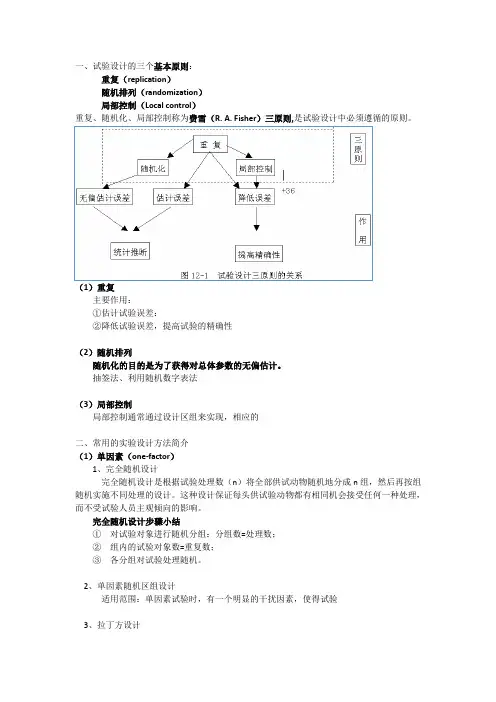
一、试验设计的三个基本原则:
重复(replication)
随机排列(randomization)
局部控制(Local control)
重复、随机化、局部控制称为费雪(R. A. Fisher)三原则,是试验设计中必须遵循的原则。
(1)重复
主要作用:
①估计试验误差:
②降低试验误差,提高试验的精确性
(2)随机排列
随机化的目的是为了获得对总体参数的无偏估计。
抽签法、利用随机数字表法
(3)局部控制
局部控制通常通过设计区组来实现,相应的
二、常用的实验设计方法简介
(1)单因素(one-factor)
1、完全随机设计
完全随机设计是根据试验处理数(n)将全部供试动物随机地分成n组,然后再按组随机实施不同处理的设计。
这种设计保证每头供试验动物都有相同机会接受任何一种处理,而不受试验人员主观倾向的影响。
完全随机设计步骤小结
①对试验对象进行随机分组:分组数=处理数;
②组内的试验对象数=重复数;
③各分组对试验处理随机。
2、单因素随机区组设计
适用范围:单因素试验时,有一个明显的干扰因素,使得试验
3、拉丁方设计
(2)两因素
1、交叉分组设
2、两因素随机区组设计
3、裂区设计
(3)多因素
正交设计。
3实验设计的基本原则
3实验设计的基本原则
实验设计是指一系列的活动,从定义实验目标、设定实验条件和实验
方法,优化实验过程,到解读实验数据,采取措施依据实验结果,直至实
现实验总目标。
实验设计涉及多个学科领域,特别是统计学、系统工程、
机械工程、控制理论和计算机科学。
实验设计是实验研究的重要组成部分,是基础研究和应用研究的基础,是理解实验研究的关键,也是获取可靠的
实验结果的前提。
实验设计的基本原则包括:
(1)科学原理原则:即将科学方法纳入实验设计,遵循科学原理,
以保证实验质量。
(2)准确控制原则:即实验设计中尽量采用控制技术,确保实验样
本和条件的准确性,以保证实验准确度。
(3)有效分析原则:实验设计中尽量利用统计学方法,以有效地分
析实验变量,以保证实验结果的可靠性。
(4)实用原则:即实验设计尽量简单实用,以保证实验的可行性及
可操作性。
(5)有效进行原则:在实验设计中尽量控制实验的时间和选择合适
的实验方法,以保质量的有效进行。
(6)经验原则:即实验设计要参考相关的实验经验,以保证实验结
果的真实性。
统计学中的统计学原则
统计学中的统计学原则统计学是一门研究数据收集、分析和解释的学科,它在经济学、社会学、医学等领域发挥着重要作用。
在统计学中,有一些基本的原则被广泛运用,以确保数据的有效性和可信度。
本文将介绍统计学中的三个重要原则:样本代表性、随机性和样本大小。
样本代表性样本代表性是指从总体中选取的样本应该能够准确地反映出总体的特征。
在统计学中,总体是指我们感兴趣的所有个体或现象的集合,而样本是从总体中选取的部分个体或现象的集合。
通过分析样本数据,我们可以对总体的特征进行推断。
为了确保样本代表性,我们需要采用随机抽样方法。
随机抽样是一种无偏的抽样方法,每个个体或现象都有相同的被选中的机会。
通过随机抽样,我们可以避免个人主观因素的干扰,并且能够更好地推断总体的特征。
此外,还可以使用分层抽样方法,将总体划分为不同的层次,并在每个层次中进行随机抽样,以确保各层次的代表性。
随机性随机性是统计学中的一个重要原则,它要求我们在数据收集和分析过程中遵循随机的原则。
具体来说,随机性要求我们避免对数据的选择性偏见,以及避免人为干扰。
在数据收集过程中,我们需要使用随机化方法来选择样本或实验单位。
例如,在实验设计中,可以通过随机分组来避免实验组和对照组之间的差异。
在调查研究中,可以使用随机次序来避免顺序效应的影响。
通过随机化,我们可以减少系统性误差,并提高数据的可信度。
样本大小样本大小是指我们从总体中选取的样本的个数。
在统计学中,样本大小对于数据分析的可靠性和推断的精度至关重要。
一般而言,样本大小越大,数据分析的结果越可靠,推断的精度越高。
为了确定合适的样本大小,我们可以使用统计学中的抽样技术和样本大小计算方法。
根据总体的大小、预计误差、置信水平等因素,可以计算出所需的样本大小。
通过合理选择样本大小,我们可以在保证分析结果可信的前提下,降低调查成本和研究时间。
总结在统计学中,样本代表性、随机性和样本大小是三个基本的统计学原则。
遵循这些原则可以确保数据的有效性和可信度,提高数据分析的准确性和推断的精度。
实验设计的统计学基本原则
第十一章实验设计的统计学基本原则实验(Experiment):指由研究者主动地决定给予部分实验对象某种处理,给予另部分对象某种对照处理的研究设计形式,这种处理的分配常常是随机的。
实验设计(Experimental design):是通过良好地计划对象的选择、处理因素的分配、结果指标的测量和资料分析来保证比较组间对象和实验条件是均衡的,实验结果有较好的可比性,并且较好地控制误差以能用较小的样本获取可靠的结论。
一.实验设计的三要素:受试对象、处理因素和实验效应。
1.处理因素(treatment):根据研究目的,对受试对象施加的某种措施,称为处理因素。
注意:①抓住主要因素。
②控制混杂因素(“非处理因素”在各组中应尽可能相同)。
11③标准化(处理因素应该标准化,即研究过程中处理应该自始至终保持一致,不能因任何原因中途改变。
)2.受试对象(subject):动物——种类,品系,窝别人——诊断,依从性注意受试对象的同质性 (homogeneity)3.实验效应(effect):指标选择:有效,客观,灵敏,精确。
(头痛,发烧)指标观察:对人的观察应注意避免偏性,提倡盲法。
主观指标的量化:如划记评分。
完全不满意完全满意0 1 2 3 4 5 6 7 8 9 10二.实验研究的分类:根据实验的对象不同,实验分成三类。
1. 动物实验(animal experiment)112. 临床试验(Clinical trial)3. 现场干预试验(Intervention trial)三.实验中的变异及其来源:在实验中,由于实验对象自身特点、实验条件的变化和实验结果测量的不确定性造成实验结果与真值的差别称实验误差,根据统计分析上的处理不同,实验误差分成两类:1. 随机误差:由大量、微小的、偶然的因素的共同作用引起的不易控制的误差称随机误差。
如在实验中,温度、湿度、风向、振动、试剂、仪器、操作员等都可能造成结果的偏差。
随机变异是没有倾向性的,在大量观察条件下,随机误差的分布呈标准N。
卫生统计学实验设计
▪ 研究的质量:
实例1
《剖腹产同时放置宫内节育器735例的初步观察》将施 行剖腹产手术1562例中的735例作为实验组,在剖腹产的同 时放置宫内节育器。比较两组被观察对象的术后出血、恶 露干净时间和术后副反应等情况。
▪ 规定实验组适应症为:破膜和总产程都不超过24小 时,无感染(无阳性体征,血常规正常)以及第一胎 产后本人同意放置宫内节育器者。
考核某种药物/治疗方法的疗效
➢ 药物与疗法属处理因素; ➢ 影响疗效的一些非处理因素,如病人的性别、
年龄、病型、病程、病情、健康、营养状况、 医护人员的照护等等;
➢ 在病人分组试验中,各组病人除处理因素不同 之外,各组病人非处理因素应通过随机化尽量 加以控制,使之均衡一致。
对混杂因素的处理:
▪ 采用良好的设计:
龄相仿,上下不超过5岁。原文在未作假设检验的
情况下,认为“两组年龄相仿”。
年龄 病例组人数 对照组人数
20~
36
30~ 72
84
40~ 193
244
50~ 228
199
60~ 101
67
70~ 10
7
▪ 中华流行病学杂志,1981;2(4):253 2=17.25,P=0.004
问题所在
对照组缺乏均衡性!
病人的排除标准是: (1)药物或食物过敏史者; (2)过敏状态,如过敏性疾患合并感染; (3)造血功能障碍(特殊情况例外); (4)妊娠及哺乳期妇女; (5)精神状态不能很好合作者; (6)正在应用其它抗菌类药物者等。
3 实验效应
▪ 关联性 ▪ 客观性 ▪ 准确性与精确性 ▪ 敏感性与特异性
关联性
▪ 请讨论:该文结果是否成立?
《用24小时食管pH监测法诊断食管原性胸痛》(中华外科杂志2019年33卷第2期第69页)
医学统计学第章实验设计
2. 精确性 包括准确度和精密度两层含义。
准确度指观察值与真值的接近程度,主要受系统误差的 影响。
在实验设计中常通过随机数来实现随机化。
获得随机数的常用方法有三种:随机数字表、计算机的 伪随机数发生器与随机排列表。
随机数字表(李晓松附表1)常用于抽样研究及随机分 组。表内随机数字互相独立,无论横行、纵列或斜向等 各种顺序均是随机的。使用时可从任一个数字开始,可 查单行、单列,双行、双列,也可以多行、多列,方向 可向下或向上,亦可向左或向右。
例如:欲了解农村地区的卫生服务需求情况,随机抽取 部分农户询问患病与就医情况。居民的患病或就医不是 由研究者所确定的,也不是随机确定的,而是根据农户 自身的实际情况确定的,研究者只是被动的观察实际情 况。
2. 实验研究
又称干预性研究,是对研究对象人为给予干预措施的研 究。
例如:在关于健康教育能否预防小学生近视的研究中, 将小学生随机分为实验组和对照组,对实验组的小学生 给予有关近视的健康教育,对照组则只是每天做一次眼 保健操,不进行健康教育。观察一段时间后,比较两组 小学生视力下降发生情况。
安慰剂的使用需慎重,应以不损害患者健康为前提,适 用于研究的疾病尚无有效药物治疗或使用安慰剂后对该 疾病病情、临床过程、预后无影响或不利影响小的情况, 一般与盲法结合使用。
2. 空白对照
即对照组不接受任何处理,在动物实验和实验室方法研 究中最常用,常用于评价测量方法的准确度,评价实验 是否处于正常状态。
实验数据处理方法
差。计算公式如下:
S =S
x
n
2.常用统计方法: (1)t 检验(两组均数的显著性检验) t 检验是最常用和最简单的一种统计方法。它主要是用于检验两组样本均数之间的差异在统计 学上是否有显著性意义。t 检验对总体的基本要求是呈常态分布或者近似常态的分布,方差要相齐, 即各组的标准差不能相差太大。根据两组的基本参数可以算出 t 值,t 值越大,统计学意义越大。t 值和 P 值的关系,以及可以得出的结论如下: t < t 0.05 时,P > 0.05,差异无显著意义;
∑ x = x = x1 + x2 + x3 + L + xn
n
n
∑ 式中 表示总和,n 为数据的个数。
(2)标准差:指一组数据的离散性代表值,均数加减标准差的范围内包含了大约 2/3 的测量 样本数据,所以标准差可以用来反映变异程度。标准差越大,变异程度越大,离散越严重,也就 越难用来估计一个未知样本可能的值。计算公式如下:
如,我们要比较 A、B 两个药物的降糖效果,首先可以提出一个假设:“A、B 两药的降糖总体平
均值相等”,这在统计学上称为“无效假设”,即假设 A 与 B 之间的差别是有偶然误差引起的,没
有实质性的差别。然后通过统计学方法计算出,这个假设成立的可能性是多大,常用概率“P”来
表示。最终做出接受还是否定前面假设检验的统计学结论,或者说差别是否有显著意义。因此,
介绍重复原则的时候也提及过,当样本量过小时,个体误差造成影响的可能性就越大。其次,样
本的分布形态、差异程度等也应与总体保持一致,如:总体当中年幼的动物占 20%,那样本中也
必须接近这个比例,否则推论总体就无法让人信服。此外,需要指出的一点是,动物实验最终的
13.2 统计设计的基本原则
=ê ë
0.45 - 0.25
ú û=é1.86 Nhomakorabea7 + 0.7835ù2
êë
0.20
úû
»
176
11
小结
n 实验研究由处理因素、实验单位和实验效应三个要素组 成;应该遵守对照、随机化和重复的基本原则;研究对 象接受不同处理由随机分配决定;
n 观察性研究只能对已存在的状况和有关因素进行观察或 调查,不能用随机化分组来平衡混杂因素的影响;适宜 的统计学设计和分析对于观察性研究而言,尤其重要。
(1) 欲检出HbA1c临床差异≥0.65%
(2) 假定标准差为1.3% (3) 双侧检验水平0.05 (4) 功效80% • 退出率20%
N
=
4
é ê
(Za
/
2
ë
+
d
Zb
)s
ù2 ú û
=
4
é êë
(1.96
+ 0.84) 0.65
´1.3
ù úû
2
(文中:152例)
=
4 êëé (1.96
+ 0.84) 0.65
12
随机化方法、随机数及产生随机数的程序、种子数等均 应有记录(备查)
6
三、重复 (Repeat)
重复实验、重复取样、重复测量
n 在大量重复实验的条件下,该处理的真实效应才会比较 真实地显露出来
n 实验组和对照组的实验单位应具有一定的数量 — 样本 含量
n 与重复实验相比,重复取样和重复测量属于第二位
2Za
/
2
êë
pc
(1 -
pc
)
+
Zb