
关于指数分布的参数的最小二乘方估计
关于指数分布的参数的最小二乘方估计指数分布(Exponential Distribution)属于连续概率分布,由卡尔古德(Kolmogorov)提出,被广泛应用于数学统计。
它的概率密度函数为f(x;λ),其中λ > 0是形态参数。
指数分布的最小二乘法(Least Squares Estimation,LSE)可以帮助我们估计出概率密度函数的形态参数λ。
最小二乘法是一种用来估计概率模型参数的统计方法,它将所有模型给定时观测误差的平方和最小化,从而实现参数估计。
式(1)是最小二乘估计求解模型参数的一般迭代形式,其中n是观测数据中的样本数,x_i和y_i分别是第i个样本的输入向量和输出向量。
LSE(λ) = min λ {∑_(i=1)^n (y_i -f(x_i; λ))^2} (1)
用最小二乘估计法来估计指数分布的形态参数λ,首先要测量观测数据中的样本量,与之相配置的输入向量和输出向量,进而根据(1)式计算出形态参数λ。
关于求解模型参数的具体步骤可以参照:(1)根据实验数据集计算出指数分布定义域中的样本点;
(2)根据指数分布的定义和实验数据,将x和y分别作为样本的输入向量和输出向量,分别令x_i表示实验数据中的i个样本(i = 1,2… n),将模型中的形态参数令为λ;
(3)根据指数分布概率密度函数,构造模型容器f(x; λ),通过最小二乘估计求出模型参数λ,即可得出LSE(λ)的值;
(4)检验模型的结果,查看实验数据是否符合指数分布的概率密度函数f(x;λ),确定是否满意估计结果。
最小二乘方法是一种常用的参数估计方法,用来估计指数分布的形态参数λ,可以很好地有效识别出模型的参数,通过求解式(1)可以估计出概率密度函数最优参数,帮助我们更好地分析数据。
分布函数与概率密度函数的拟合方法及评估

分布函数与概率密度函数的拟合方法及评估一、引言在统计学和概率论中,分布函数和概率密度函数是描述随机变量的重要工具。
它们能够帮助我们了解随机变量的分布规律和特征。
然而,实际数据往往不符合理想的分布函数或概率密度函数,因此我们需要进行拟合来逼近真实数据的分布。
本文将介绍一些常见的分布函数与概率密度函数的拟合方法,并对其评估进行讨论。
二、常见的分布函数与概率密度函数1. 正态分布正态分布是最为常见的一种分布函数,其概率密度函数呈钟形曲线。
在实际数据分析中,如果数据的分布近似于正态分布,则可以使用正态分布进行拟合。
2. 指数分布指数分布常用于描述事件发生的时间间隔,其概率密度函数呈指数下降趋势。
指数分布可用于对时间数据进行拟合。
3. 伽玛分布伽玛分布广泛应用于描述正偏斜且非对称的连续随机变量,如等待时间、寿命等。
伽玛分布的概率密度函数具有较高的灵活性,适用于各种具有不同形状的分布数据。
4. 泊松分布泊松分布常用于描述单位时间内随机事件发生的次数,如客流量、电话接通次数等。
泊松分布的概率密度函数对应的函数图像为上凸的离散分布。
三、分布函数与概率密度函数的拟合方法1. 最大似然估计法最大似然估计法是一种常用的参数估计方法,可以用于拟合分布函数与概率密度函数。
通过选择使得样本观测值出现的概率最大的概率密度函数参数值,得到最佳的拟合结果。
2. 最小二乘法最小二乘法是一种常见的数学优化方法,也可用于拟合分布函数与概率密度函数。
通过最小化实际观测值与拟合值之间的误差平方和,得到最佳的拟合结果。
3. 几何插值法几何插值法是一种通过在不同数据点之间插值来拟合分布函数与概率密度函数的方法。
通过在已有数据点之间绘制曲线,并根据曲线的形状进行插值,得到拟合结果。
四、拟合结果评估方法1. 拟合优度检验拟合优度检验可以用于评估拟合结果的好坏。
常用的拟合优度检验方法有卡方拟合优度检验和Kolmogorov-Smirnov检验,通过计算观测值与拟合值之间的差异,从而判断拟合效果。
(完整word版)《概率论与数理统计》期末考试试题及解答
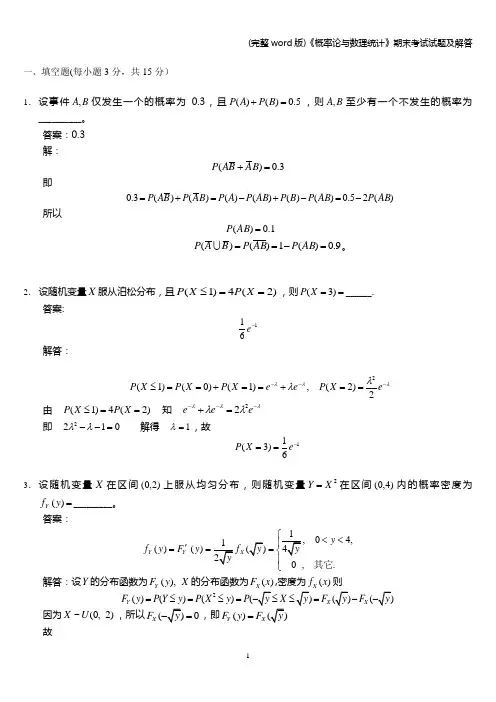
一、填空题(每小题3分,共15分)1. 设事件B A ,仅发生一个的概率为0.3,且5.0)()(=+B P A P ,则B A ,至少有一个不发生的概率为__________。
答案:0.3解:3.0)(=+B A B A P即)(25.0)()()()()()(3.0AB P AB P B P AB P A P B A P B A P -=-+-=+=所以1.0)(=AB P9.0)(1)()(=-==AB P AB P B A P 。
2. 设随机变量X 服从泊松分布,且)2(4)1(==≤X P X P ,则==)3(X P ______.答案:161-e解答:λλλλλ---==+==+==≤e X P e eX P X P X P 2)2(,)1()0()1(2由 )2(4)1(==≤X P X P 知 λλλλλ---=+e e e 22 即 0122=--λλ 解得 1=λ,故161)3(-==e X P3. 设随机变量X 在区间)2,0(上服从均匀分布,则随机变量2X Y =在区间)4,0(内的概率密度为=)(y f Y _________。
答案:04,()()0,.Y Y X y f y F y f <<'===⎩其它解答:设Y 的分布函数为(),Y F y X 的分布函数为()X F x ,密度为()X f x 则2()()()((Y X X F y P Y y P X y P X F F =≤=≤=≤≤=-因为~(0,2)X U,所以(0X F =,即()Y X F y F = 故04,()()0,.Y Y Xyf y F y f<<'===⎩其它另解在(0,2)上函数2y x=严格单调,反函数为()h y=所以04,()0,.Y Xyf y f<<==⎩其它4.设随机变量YX,相互独立,且均服从参数为λ的指数分布,2)1(-=>eXP,则=λ_________,}1),{min(≤YXP=_________。
数理统计茆诗松第二章自测题

0,
x , 其中参数?>0为未知,从 x ,
总体中抽取样本X1, X2, …, Xn,其样本观察值为 x1, x2, …, xn,
(1)求参数? 的最大似然估计 ;
(2)讨论 是否具有无偏性;
(3)若 不是? 的无偏估计量,修正它,并由此指出? 的一个无偏量估计 ?。
(4) 讨论 是否具有相合性;
。
2.设总体
X
的密度函数为
f
(x, )
e(x ) ,
0,
个简单随机样本,则参数 的矩估计量为
x x
,, ,
X
1,
X
2
,,
X
n
为来自该总体的一
。
3.已知ˆ1 ,ˆ2 为未知参数 的两个无偏估计,且ˆ1 与ˆ2 不相关, D(ˆ1) 4D(ˆ2) 。如果
ˆ3 aˆ1 bˆ2 也是 的无偏估计,且是ˆ1 ,ˆ2 的所有同类型线性组合中方差最小的,则
4
4
4. S2 是 的无偏估计,但 S 不是 的无偏估计; (n-1)/n S2 是 的最大似然估计,所以
只有当总体是正态分布时,才有 S 与 相互独立。
是 的最大似然估计;
6.
E 1 n
n i 1
(Xi
)2
1 n
n i 1
E( X i
)2
1 n
n
2
2。
7. E ˆ2 D ˆ E ˆ 2 D ˆ 2 2 。
的最大似然估计值为ˆ min(x1, x2, , xn) ,于是? 的最大似然估计量为
ˆ min(X1, X2, ,Xn ) 。
(2)设总体X的分布函数为 F(x)
x
1 e2(x ) , f (t)dt
数理统计教程课后重要答案习题

第一章:统计量及其分布19.设母体ξ服从正态分布N (),,2σμξ和2n S 分别为子样均值和子样方差,又设()21,~σμξN n +且与n ξξξ,,,21 独立, 试求统计量111+--+n n S nn ξξ的抽样分布. 解: 因为ξξ-+1n 服从⎪⎭⎫⎝⎛+21,0σn n N 分布. 所以()1,0~121N nn n σξξ+-+ 而()1~222-n nS nχσ且2n S 与ξξ-+1n 独立,, 所以()1~1111--÷+--+n t S n n n n S nnn σξξ分布. 即111+--+n n S nn εε服从()1-n t 分布. 20. (),,,1,,n i i i =ηξ是取自二元正态分布N ()ρσσμμ222121,,,的子样,设()∑∑∑===-===n i i i ni n i i n S n n 12111,1,1ξξηηξξξ2,()2121∑=-=n i i n S ηηη和 ()()()()∑∑∑===----=ni i ni ii ni ir 12211ηηξξηηξξ试求统计量()122221--+---n S rS S S ηξηξμμηξ的分布.解: 由于().21μμηξ-=-E ()()=-+=-ηξηξηξ,cov 2D D D nn nn2122212σσρσσ-+.所以()()n 212221212σρσσσμμηξ-+---服从()1,0N 分布 .()()()()()()()[]211212121222122ηξηξηηξξηηξξ---=----+-=-+∑∑∑∑====i ini i i ni i ni i ni S rS S S ni i ηξ-是正态变量,类似于一维正态变量的情况,可证ηξηξS rS S S 222-+与ηξ-相互独立.()()1~22221222122--+-+n S rS S S n χσρσσσηξηξ, 所以 统计量()122221--+---n S rS S S ηξηξμμηξ()()()()1)2(222122212221222121--+-+-+---=n S rS S S n nσρσσσσρσσσμμηξηξηξ服从()1-n t 分布.第二章:估计量1. 设n ξξ,,1 是来自二点分布的一个子样,试求成功概率p 的矩法估计量.解: p E =ξ ξ=∴pˆ 3. 对容量为n 的子样,求密度函数()()⎪⎩⎪⎨⎧<<-=其它,00,2;2ax x a a a x f 中参数a 的矩法估计3. 对容量为n 的子样,求密度函数 ()()⎪⎩⎪⎨⎧<<-=其它,00,2;2ax x a a a x f 中参数a 的矩法估计量. 解: ()322a dx x a ax E a=-=⎰ξ 令ξ=3a得ξ3ˆ=a . 4. 在密度函数 ()()10,1<<+=x x a x f a中参数a 的极大似然估计量是什么? 矩法估计量是什么? 解: (1) ()()()∏∏==+=+=ni i ni nni x x L 111ααααα ()i i x ∀<<10∴()().ln 1ln ln 1⎪⎪⎭⎫⎝⎛⋅++=∏=n i i x n L ααα令()0ln 1ln 1=++=∂∂∑=i ni x nL ααα, 得 ∑=--=ni iL xn1ln 1ˆα。
《数理统计》试题库填空题

数理统计试题库-----填空题(每题3分)第一章1. 设()211~,X N μσ,()222~,Y N μσ相互独立,样本容量分别为12,n n ,则()Var X Y -= 。
2. 设1234,,,X X X X 是来自正态总体2(0,2)N 的简单随机样本,221234(2)(34)X a X X b X X =-+-,则a = ,b = 时,统计量2~(2)X χ。
3.设1234,,,X X X X 是来自正态总体2(0,3)N 的简单随机样本,221234(2)()X a X X b X X =-+-,则a = ,b = 时,统计量2~(2)X χ。
4. 设总体()2Xk χ,12,,,n X X X 是取自该总体的一个样本,则1ni i X =∑服从2χ分布,且自由度为 。
5.设12345,,,,X X X X X 是来自正态总体(0,1)N 的简单随机样本,2212()X a X X =+,则a = 时,统计量X 服从2χ分布,其自由度为 。
6.设12345,,,,X X X X X 是来自正态总体(0,1)N 的简单随机样本,X =,则a = 时,统计量X 服从t 分布,其自由度为 。
7.X 服从正态分布,1-=EX ,25EX =,12,,,n X X X 是来自总体X 的一个样本,则11ni i X X n ==∑服从的分布为 。
8. 设随机变量 X 服从正态分布2(0,3)N , 而 129,,,X X X 是来自X 的样本,则统计量()22212919U X X X =+++服从 。
9. 设随机变量 X 和 Y 相互独立且都服从正态分布2(0,3)N , 而129,,,X X X 和 129,,,Y Y Y 分别是来自X 和Y 的样本,则统计量292221921YY Y X X X U ++++++=服从 。
10. 设12,,,n X X X 是来自总体X 的简单随机样本,已知(1,2,3,4)k k EX k α== 则当n 充分大时,随机变量211n n i i Z X n ==∑近似服从正态分布,其分布参数为____________11. 设12,,,n X X X 是来自总体X 的一个样本,X 服从参数为λ的指数分布,则∑=ni i X 12λ服从____________分布.12. 设在总体2(,)N μσ中抽取一个容量为16的样本,这里2,μσ均为未知, 则2.DS =____________ 13. 设11,,,,,n n n m X X X X ++是分布2(0,)N σ的容量为n m +的样本,统计量1n iX Y =__________。
新版注册可靠性工程师模拟考试-2

5.关于软件可靠性常见设计方法的说法,错误的是()。
(得分:0.0)您的解答正确答案备选答案有避错设计方法有直错设计方法有容错设计方法有定错设计方法6关于可靠性预计的不正确说法是()。
(得分:0.0)×您的解答正确答案备选笞案可靠性预计应与功能性能设计同步进行。
可幸性预计是一个由局部到整体,由下到上的综合过程。
区可靠性预计不能发现设计中的薄弱环节。
常用的可靠性预计方法有评分预计法、元器件计数法、应力分忻法和相似产品法等。
7.一个由4个部牛组成的串联系统,4个部件的故障率分别是:人1=0.0002h,A2=000081n,A3=0.0004/h,34=0.0006/h, 影响系统可靠性的量薄弱环节是()。
(得分:00)×您的解答正确答奉备谎等塞部件1区部件2部件3部件48某产品的寿命服从指故分布,对抽取的6个样品共试验到2400h,没有发生故障,则当置信度为0.9,可宗度为0.8时的可靠度寿命下限()。
提示:(得分:0.0)×怒的解菩正确答案备选菩军F1395.5h1495.5h1595.5h1695.5h9.以下()不属于常用的概率分布。
(得分:0.0)您的解答正确答案备选答案威布尔皮尔逊正态指数14. 预防性维修保障分析主要采用的方法是()。
(得分:0 .0)×您的解答正确答案备选答案FEMARCMALORAO&MTA15. 不属于保障性设计特性台同参数的是()。
(得分:0 .0)您的解答正确答宰备选答宰运输尺寸重量受油速率各维修级别拆卸零件数量16. 制定综合保障工作计划的是()。
(得分:0 .0)您的解答正确答宰备选答案订购方承制方使用方论证方17. 下列关于综合保障主要原则的说法错误的是()。
(得分:0 .0) 您的解答正确答案备选答案应将保障性要求作为性能要求的组成部分在寿命周期各阶段应注意综合保障要素的协调论证阶段由于数据不全,可以不考虎保障问题。
配分布曲线法在无失效数据可靠性分析中的应用
维普资讯
LS 00 72 轴 承 2 O SN 10 —3 6 O 6年 3 期
C 4 1 14 : 1 B I 2 O No 3 2 4 — 1 8 1- I e I g 0 6, .
2 0—2 2
.试验与分析 . I
配分布 曲线法在无失效数据可靠性分析 中的应用
相当普遍 , 对这种情形的可靠性评定是近些年来 遇到的一个新的迫切需要解决的问题。对无失效
效概率 P P{ T<t 的估计 f 中 为产品的 f } , 其
寿命。 () 2通过诸点处 (iP) i , , m) t ( =l2 …, 配一 ,i
数据的研究 已有很多方法 , 主要有最优置信限法、
今后研究工作 中两个还需要解决 的问题。
1 配分布 曲线 法
文献 [] 1提出了无失效数据 的可靠性分 析方
计, 关键是估计失效概率 ( =12 …, 。 i ,, m) 1 1 最 小二 乘估 计 .
应用配分布 曲线 法 , 需根据无失效数 据和在
诸点 t i 的失效概率 P =P{ T<t 的估计 f给出 i } ,
l o I a na岫 d l
w r s ad .
cm i dpata p b m o bn r i l r l o k咖 e cc o e f
pout i m d ; esgetm r vl tnme o r pto- r c s ae t ugao f a a o t da u f d s h i oe ui h e r
数理统计主要内容和复习重点
两类错误:H0 正确但拒绝 H0 为第一类错误,H0 错误但接受 H0 为第二类错误; 检验的 p 值:作出拒绝 H0 决策的最小显著水平。 二. 参数检验:单正态总体参数、双正态总体参数、其他分布参数、似然比检验 单正态总体参数检验:已知方差检验均值、未知方差检验均值、检验方差; 双正态总体参数检验:已知方差检验均值差、未知方差检验均值差、检验方差比; 其他分布参数检验:指数分布参数检验、比例 p 的检验、泊松分布参数检验,以
及对应的大样本情形。 似然比检验:分别求出一般情况与在 H0 成立条件下,似然函数的上确界之比。 三. 非参数检验:分类χ 2 拟合优度检验、列联表独立性检验、正态检验、其他非参数检验 分类χ 2 拟合优度检验:总体分布分成有限类的χ 2 检验法;
列联表独立性检验:χ 2 检验法; 正态性检验:正态概率纸,W 检验法,EP 检验; 其他非参数检验:游程检验、符号检验、秩和检验。 重点: 单与双正态总体参数检验的六种类型、其他分布参数检验、似然比检验、分类χ 2 拟合优度检 验与列联表独立性检验
估计方法:矩估计、最大似然估计; 评价标准:相合性、无偏性、有效性,以及均方误差; 最小方差无偏估计 UMVUE:充分性原则,UMVUE 判定定理,Fisher 信息量,
C-R 下界与有效估计; 贝叶斯估计:先验分布、后验分布,共轭先验分布。 二. 区间估计:枢轴量、单正态总体、双正态总体、比例 p、其他分布参数 枢轴量:概念以及与统计量的区别; 单正态总体置信区间:已知方差估计均值、未知方差估计均值、估计方差; 双正态总体置信区间:已知方差估计均值差、未知方差估计均值差、估计方差比; 比例 p 的置信区间:近似法、方程法、修正法; 其他分布参数的置信区间:指数分布、泊松分布等。 重点: 矩估计与最大似然估计、无偏性与有效性、Fisher 信息量与有效估计、单与双正态总体置信 区间的六种类型、比例 p 的置信区间(任一方法)。
模型参数的估计和推断方法
模型参数的估计和推断方法模型参数的估计和推断方法是统计学中的重要内容,它通过对样本数据进行分析,从而对总体模型的参数进行估计和推断。
在实际应用中,模型参数的估计和推断方法可以帮助我们更好地了解数据背后的规律,为决策和预测提供依据。
二、模型参数估计模型参数估计是指利用样本数据来估计总体模型参数的方法。
常用的估计方法有:1.点估计:用一个具体的数值来估计参数,如用样本均值来估计总体均值。
2.区间估计:给出参数估计的一个范围,如给出总体均值的95%置信区间。
三、模型参数推断模型参数推断是指利用样本数据对总体模型参数进行假设检验和置信区间的估计。
常用的推断方法有:1.假设检验:通过设定零假设和备择假设,利用样本数据判断总体参数是否显著不同于某个假设值。
2.置信区间:给出总体参数的一个估计范围,并计算出该估计的置信概率。
四、估计和推断方法的选择在进行模型参数的估计和推断时,需要根据具体问题、数据特点和需求来选择合适的估计和推断方法。
常用的方法有:1.最小二乘法:适用于线性回归模型参数的估计。
2.最大似然估计:适用于概率模型参数的估计。
3.贝叶斯估计:根据先验知识和样本数据来估计参数。
模型参数的估计和推断方法是统计学中的重要内容,通过对样本数据进行分析,可以对总体模型的参数进行估计和推断。
在实际应用中,需要根据具体问题、数据特点和需求来选择合适的估计和推断方法。
掌握这些方法可以帮助我们更好地了解数据背后的规律,为决策和预测提供依据。
习题及方法:1.习题:对于一个正态分布的总体,已知均值为10,标准差为2,从该总体中随机抽取一个容量为100的样本,样本均值为12,求样本标准差的最小二乘估计值。
解题方法:首先计算样本方差,样本方差 = (样本均值 - 总体均值)^2 / (样本容量 - 1) = (12 - 10)^2 / (100 - 1) = 4 / 99。
然后求样本标准差,样本标准差= √样本方差= √(4 / 99) ≈ 0.2。
bfgs算法例题
bfgs算法例题标题:BFBG算法例题在数学和统计学中,BFGS(BFGS算法)是一种广泛应用于优化问题的迭代算法。
这种方法尤其在求解非线性最小二乘问题时非常有效。
下面,我们将通过一个具体的例题来详细介绍BFGS算法的原理和应用。
例题:求解非线性最小二乘问题假设我们有一个非线性最小二乘问题,其目标函数是f(x)=x^TQx+u(x),其中x是我们要优化的参数向量,Q是x的协方差矩阵,u(x)是我们希望最小化的函数。
我们的任务是找到一组最优参数x,使得f(x)的值最小。
BFGS算法的基本步骤包括以下四个步骤:1.初始化:选择一个初始猜测值x_0。
2.迭代更新:对于每个迭代步骤k,计算一个新的x_k,通过以下公式得到:x_k=x_{k-1}-alpha_k*d_k,其中alpha_k是步长,d_k是最近的梯度估计。
3.梯度估计:在每个迭代步骤k,我们使用BFGS公式来估计梯度d_k=-Q^-1*g,其中g是目标函数的梯度。
4.判断终止条件:如果目标函数的值已经足够接近最优值,或者达到预设的最大迭代次数,就停止迭代并输出当前的参数值x_k。
应用实例考虑一个简单的例题,假设我们要找到一组参数(质量m和距离d),使得一维实验数据能够最好地拟合一条直线。
我们的数据集包含了大量的实验点,并且我们希望找到一条直线,使得这些点与这条直线的距离的平方和最小。
我们使用BFGS算法来解决这个问题。
首先,我们选择一个初始猜测值(例如(m,d)=(1,0)),然后开始迭代更新我们的参数。
在每次迭代中,我们都会使用BFGS公式来估计梯度,并根据这个梯度来更新我们的参数。
当目标函数的值足够接近最优值或者达到预设的最大迭代次数时,我们就停止迭代并输出当前的参数值。
代码实现下面是一个使用Python实现的简单BFGS算法示例代码:```pythonimportnumpyasnp#目标函数和梯度函数deff(x):m,d=xreturnm*d**2+np.exp(-d)#假设数据符合指数分布的直线模型defdf(x):m,d=xreturn2*m*d+np.exp(-d)/np.exp(-d)#假设数据的权重符合指数分布的线性模型defbfgs(data,initial_guess=(1,0)):m,d=initial_guessQ=np.eye(len(data))-np.sum(data,axis=0)/len(data)/data[:,np.newaxis]/data#协方差矩阵近似估计forkinrange(100):#最大迭代次数g=df(m,d)#最近的梯度估计alpha=np.linalg.norm(data-m*d-np.exp(-d)*np.arange(len(data)))/len(data)#步长计算m_new=(df(m+alpha*g)-g)/alpha#BFGS公式计算更新后的质量m' d_new=-Q.T@(Q@g+(m*df(m,d)-g))/alpha#BFGS公式计算更新后的距离d'ifabs(d_new)<1e-6:#判断是否接近最优值或达到最大迭代次数break#停止迭代并输出参数值else:#更新参数值并继续迭代m,d=m_new,d_new#m和d更新为新的参数值returnm,d#返回最优参数值(质量和距离)```这个代码示例展示了如何使用BFGS算法来解决非线性最小二乘问题。