
回归分析实验
实验5 回归分析实验一、实验目的复习回归分析的基本理论,熟练掌握sas系统绘制散点图,计算相关系数,拟合线性回归方程,拟合简单的非线性回归方程,利用回归方程进行预测。
二、实验准备常用的sas过程1、reg过程一般格式为:proc reg 选项;model 因变量=自变量/选项;weight 变量;print 选项;plot 纵轴变量*横轴变量=“符号”;proc reg语句的选项有data=输入数据集,simple给出简单统计数,corr给出简单相关系数等。
Model语句设定线性数学模型。
Weight语句给出权系数变量。
Print语句打印分析结果。
Plot语句作散点图。
2、corr过程一般格式为:proc corr 选项;var 变量;with 变量;partial 变量;proc corr语句的选项可设定相关系数,比如pearson,spearman等,缺省为pearson系数。
Var语句指明分析变量。
With语句设定放在左边的变量,此时var语句的变量之间和with语句的变量语句之间的相关系数不给出,只给出两组变量之间的相关系数。
Partial语句指明偏相关变量。
3、glm过程一般格式为:proc glm 选项;model 因变量=自变量/选项;model语句定义模型和需要输出的统计数。
另外,nlin过程可用于非线性回归分析,orthoreg过程可对病态数据进行比较精确的估计。
三、实验任务基础实验部分:数学软件sas命令操作1、变量x和y的观测值如下,x 0.10 0.30 0.40 0.55 0.70 0.80 0.95y 15 18 19 21 22.6 23.8 26绘制x和y的散点图。
2、变量x和y的观测值如下,x 820 780 720 867 690 787 934 679 639 820y 165 158 130 180 134 167 186 145 120 158试作直线回归。
3、变量x和y的观测值以及频数如下,1.5 4.5 31.6 4.55 21.8 4.82 42.5 5.5 13.2 6.18 2试作直线回归。
4、变量x和y的观测值如下,x 1.58 9.98 9.42 1.25 0.30 2.41 11.01 1.85 6.04 5.92y 180 28 25 117 165 175 40 160 120 80试作x和y之间的相关系数。
探索实验部分:5、下列数据是1957年美国旧轿车价格的调查资料,x表示轿车使用年数,y表示相应的平均价格,求y关于x的回归方程。
(提示:先绘制散点图)X 1 2 3 4 5 6 7 8 9 10Y 2651 1943 1494 1087 765 538 484 290 226 204应用实验部分:6、下列数据是18个5—8岁儿童的重量(这是容易测量的)和体积(这是难以测量的)。
重量x千克 17.1 10.5 13.8 15.7 11.9 10.4 15.0 16.0 17.8 15.8体积y立方分米 16.7 10.4 13.5 15.7 11.6 10.2 14.5 15.8 17.6 15.2重量15.1 12.1 18.4 17.1 16.7 16.5 15.1 15.1体积14.8 11.9 18.3 16.7 16.6 15.9 15.1 14.5试求重量和体积的线性回归方程。
四、实验过程1、data a1;input x y@@;cards;0.10 15 0.30 18 0.40 19 0.55 21 0.70 22.6 0.80 23.8 0.95 26;proc plot;plot y*x;run;输出散点图如下:2、data a2;input x y@@;cards;820 165 780 158 720 130 867 180 690 134 787 167 934 186 679 145 639 120 82 0 158;proc reg;model y=x;run;输出结果为:Model: MODEL1Dependent Variable: YAnalysis of VarianceSum of MeanSource DF Squares Square F Value Prob>FModel 1 3737.41063 3737.41063 60.197 0.0001Error 8 496.68937 62.08617C Total 9 4234.10000Root MSE 7.87948 R-square 0.8827Dep Mean 154.30000 Adj R-sq 0.8680C.V. 5.10660Parameter EstimatesParameter Standard T for H0:Variable DF Estimate Error Parameter=0 Prob > |T| INTERCEP 1 -17.357456 22.26443147 -0.780 0.4581 X 1 0.221894 0.02859949 7.759 0.0001上面对回归进行方差分析和t检验,概率为0.0001<0.05,说明回归系数b(y=a+bx)与0有显著差异。
回归方程为:y=-17.357456+0.221894x3、data a3;input x y w@@;cards;1.5 4.5 31.6 4.55 21.8 4.82 42.5 5.5 13.2 6.18 2porc reg;model y=x;weight w;run;上面程序中weight语句表示权系数变量,此处有可用freq代替。
程序的输出结果为:Model: MODEL1Dependent Variable: YAnalysis of VarianceSum of MeanSource DF Squares Square F Value Prob>FModel 1 4.30681 4.30681 1857.307 0.0001Error 3 0.00696 0.00232C Total 4 4.31377Root MSE 0.04815 R-square 0.9984Dep Mean 4.97833 Adj R-sq 0.9978C.V. 0.96728Parameter EstimatesParameter Standard T for H0:Variable DF Estimate Error Parameter=0 Prob > |T|INTERCEP 1 3.006381 0.04782167 62.867 0.0001X 1 0.994262 0.02307060 43.096 0.0001上面对回归进行方差分析和t检验,概率为0.0001<0.05,说明回归系数b(y=a+bx)与0有显著差异。
回归方程为:y=3.006381+0.994262x4、data a4;input x y@@;cards;1.58 180 9.98 28 9.42 25 1.25 117 0.30 1652.41 175 11.01 40 1.85 160 6.04 120 5.92 80;proc corr;var x y;run;输出结果为:Correlation Analysis2 'VAR' Variables: X YSimple StatisticsVariable N Mean Std Dev Sum Minimum MaximumX 10 4.9760 4.0395 49.7600 0.3000 11.0100Y 10 109.0 61.9480 1090.0 25.0000 180.0Pearson Correlation Coefficients / Prob > |R| under Ho: Rho=0 / N = 10X YX 1.00000 -0.920100.0 0.0002Y -0.92010 1.000000.0002 0.0结果表明,x和y的相关系数为-0.92010,两者之间是负相关。
相关系数下面的数据是对H0:ρ=0检验结果的概率值。
概率为0.0002,拒绝H0,认为该相关系数有统计意义。
5、先绘制散点图,data a5;input x y@@;cards;1 26512 1943 3 1494 4 10875 7656 5387 4848 2909 226 10 204;proc plot;plot y*x;run;得到x和y之间的散点图如下:从上图可以看出,y和x之间呈现出指数关系,于是我们可以采用指数回归模型,令,,则,化成了线性回归问题。
Data a52;Input x y@@;X1=x;Y1=log(y);Cards;1 26512 1943 3 1494 4 10875 7656 5387 4848 2909 226 10 204 ;proc reg;model y1=x1;run;上面程序输出结果为:Model: MODEL1Dependent Variable: Y1Analysis of VarianceSum of MeanSource DF Squares Square F Value Prob>FModel 1 7.31063 7.31063 1048.194 0.0001Error 8 0.05580 0.00697C Total 9 7.36642Root MSE 0.08351 R-square 0.9924Dep Mean 6.52734 Adj R-sq 0.9915C.V. 1.27944Parameter EstimatesParameter Standard T for H0:Variable DF Estimate Error Parameter=0 Prob > |T|INTERCEP 1 8.164585 0.05705055 143.111 0.0001X1 1 -0.297680 0.00919453 -32.376 0.0001得到y1和x1的回归方程为:y1=8.164585-0.29768x1,而且知道回归效果是高度显著的。
Y和x之间的回归方程为:Y=exp(y1)=3514.26exp(-0.29768x)6、(1)问题分析,体重看成是自变量,体积是因变量,利用回归分析过程求解。
(2)data a6;input x y@@;cards;17.1 16.7 10.5 10.4 13.8 13.5 15.7 15.7 11.9 11.6 10.4 10.2 15.0 14.5 16.0 15 .8 17.8 17.6 15.8 15.2 15.1 14.8 12.1 11.9 18.4 18.3 17.1 16.7 16.7 16.6 16.5 15.9 15.1 15.1 15.1 14.5;proc reg;model y=x;run;输出结果为:Model: MODEL1Dependent Variable: YAnalysis of VarianceSum of MeanSource DF Squares Square F Value Prob>FModel 1 94.09987 94.09987 2311.895 0.0001Error 16 0.65124 0.04070C Total 17 94.75111Root MSE 0.20175 R-square 0.9931Dep Mean 14.72222 Adj R-sq 0.9927C.V. 1.37037Parameter EstimatesParameter Standard T for H0:Variable DF Estimate Error Parameter=0 Prob > |T| INTERCEP 1 -0.104046 0.31199786 -0.333 0.7431 X 1 0.988052 0.02054924 48.082 0.0001得到回归方程为:y=-0.104046+0.988052x五、思考与提高1、如何由sas系统进行预测。
实验三回归分析
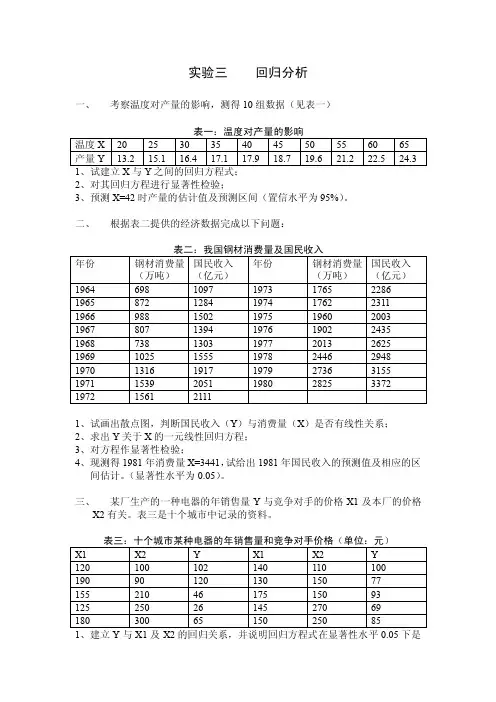
实验三回归分析一、考察温度对产量的影响,测得10组数据(见表一)2、对其回归方程进行显著性检验;3、预测X=42时产量的估计值及预测区间(置信水平为95%)。
二、根据表二提供的经济数据完成以下问题:1、试画出散点图,判断国民收入(Y)与消费量(X)是否有线性关系;2、求出Y关于X的一元线性回归方程;3、对方程作显著性检验;4、现测得1981年消费量X=3441,试给出1981年国民收入的预测值及相应的区间估计。
(显著性水平为0.05)。
三、某厂生产的一种电器的年销售量Y与竞争对手的价格X1及本厂的价格X2有关。
表三是十个城市中记录的资料。
否显著?并解释回归系数的含义;2、对回归模型进行初步诊断,并指出有无可疑点或异常点?3、已知某城市中本厂电器的售价X2=160元,竞争对手售价X1=170元,使用上述建立的回归模型预测该城市的年销售量;4、能否建立决定系数R2 >0.68,模型中所有回归系数在0.10水平上是显著的回归模型(提示:考虑二次项和交叉项,用逐步回归)。
四、某科学基金会的管理人员欲了解从事研究的工作人员中,高水平的数学家工资额Y与他们的研究成果(论文、著作等)的质量指标X1,从事研究工作的时间X2以及能成功获得资助的指标X3之间的关系,为此按一定的设计方案调查了24位此类型的数学家,数据见表四。
1、假设误差服从2N 分布,建立Y与X1,X2和X3之间的线性回归方程,(0,)并研究相应的统计推断问题,作相应的诊断和检验;2、假设某位数据数学家的关于X1,X2,X3的值为(5.1,20,7.2),试预测他的年工资额,并给出置信水平为95%的置信区间。
《应用回归分析》自相关性的诊断及处理实验报告

《应用回归分析》自相关性的诊断及处理实验报告
二、实验步骤:(只需关键步骤)
1、分析→回归→线性→保存→残差
2、转换→计算变量;分析→回归→线性。
3、转换→计算变量;分析→回归→线性
三、实验结果分析:(提供关键结果截图和分析)
1.用普通最小二乘法建立y与x1和x2的回归方程,用残差图和DW检验诊断序列的自相关性;
由图可知y与x1和x2的回归方程为:
Y=574062+191.098x1+2.045x2
从输出结果中可以看到DW=0.283,查DW表,n=23,k=2,显著性水平由DW<1.26,也说明残差序列存在正的自相关。
自相关系数,也说明误差存在高度的自相关。
分析:从输出结果中可以看到DW=0.745,查DW表,n=52,k=3,显著性水平 =0.05,dL=1.47,dU=1.64.由DW<1.47,也说明残差序列存在正的自相关。
α
625.0745.02
1121-1ˆ=⨯-=≈DW ρ 也说明误差项存在较高度的自相关。
2.用迭代法处理序列相关,并建立回归方程;
回归方程为:y=-178.775+211.110x1+1.436x2
从结果中看到新回归残差的DW=1.716,
查DW 表,n=52,k=3,显著性水平0.5 由此可知DW 落入无自相关性区
域,说明残差序列无自相关
3.用一阶差分法处理序列相关,并建立回归方程;
从结果中看到回归残差的DW=2.042,根据P 104表4-4的DW 的取值范围来诊断 ,误差项。
实用回归分析论文(SPSS实验结果)

实用回归分析论文(SPSS实验结果)由于没有具体的数据或研究题目,以下仅为回归分析论文的一般模板。
1. 研究背景和目的:介绍本次研究的背景和目的。
描述相关文献对该领域的研究情况,指出知识空白和研究的必要性。
例如:本研究旨在探讨X变量与Y变量之间的关系,并研究其他可能因素对此关系的影响。
回归分析被广泛应用于社会科学、经济学和医学等领域,但在某些情况下,该方法可能被错误地应用或解读。
因此,本研究旨在提供更多有关回归分析的实用性信息,以便更好地应用于实际研究中。
2. 变量选择和数据收集:介绍所选的独立变量、因变量以及可能的干扰因素。
描述数据收集的方法和样本的特点,阐述数据的统计学特征。
例如:本研究选择了X1、X2和X3作为独立变量,Y作为因变量。
在探究X和Y之间的关系时,本研究考虑了干扰因素A和B。
数据收集采用了问卷调查的方法,样本为100位大学生。
调查数据的统计学特征如下:均值、标准差、最大值和最小值。
3. 回归模型:描述所使用的回归模型及其假设。
根据假设,说明如何进行统计分析。
例如:本研究选择了多元线性回归模型。
假设独立变量与因变量之间存在线性关系,且同时考虑了干扰因素的影响。
在此假设下,通过进行多元线性回归分析,得出具体的回归方程。
使用SPSS软件进行统计分析,通过显著性检验和模型拟合程度来验证上述假设。
4. 实验结果:解释回归分析结果,如拟合程度、系数的显著性、变量的解释等。
根据结果,提供对研究目的的回答,对假说进行证明或推翻。
例如:本研究得到的回归方程为Y = a + b1*X1 + b2*X2 + b3*X3 +c1*A + c2*B。
通过F检验,得出回归模型的显著性水平P<0.01,表明回归模型解释了数据的一定程度。
通过系数显著性检验,得出X1、X3和B对Y变量具有显著影响,而其余变量影响不显著。
对于X1、X3和B,本研究解释了其对Y变量的具体贡献,分析了研究问题的深层含义。
5. 结论和建议:总结研究结论,说明其对实践和理论的贡献,并提出未来研究的方向。
spass回归分析实验报告
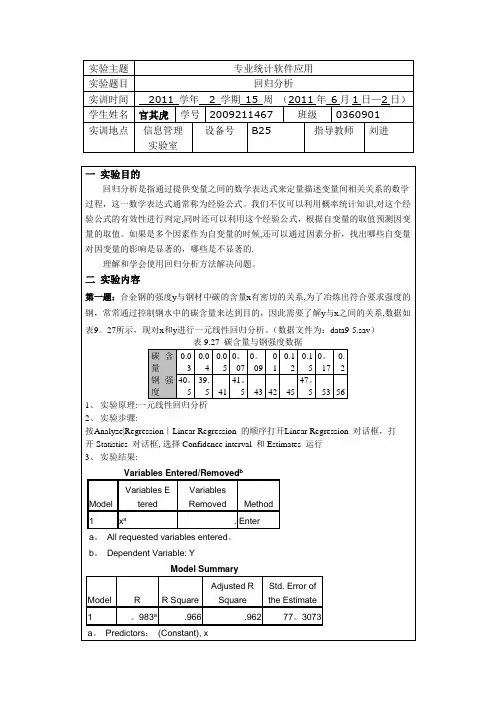
上,看哪种模型拟合效果更好从拟合优度(Rsq 即R2)来看,QUA,CUB,POW 效果较好(因为其Rsq 值较大),于是就选QUA,CUB,POW来进行。
重新进行上面的过程,只选以上三种模型。
3、实验结果:Model Summary and Parameter EstimatesDependent Variable:远视率EquationModel Summary Parameter EstimatesRSquare F df1 df2 Sig。
Constant b1 b2 b3Linear。
674 22。
7101 11 .001 74.006—4。
768Logarith mic .793 42.251 1 11 。
000 156。
773-57.574Inverse。
883 83.244 1 11 。
000 -40。
567 615.321Quadrati c .94382。
1142 10 .000 192.085-26.567。
908Cubic.959 69。
5383 9 .000 290.851—54。
7173.398 —。
069Compound。
794 42.445 1 11 .000 308。
120 .731Power.861 68.413 1 11 .000 49462.724—3。
638S .877 78.119 1 11 .000 -1。
502 37.175Growth.794 42。
4451 11 。
000 5。
730 —。
314Exponen tial .79442。
4451 11 。
000 308.120 -.314Logistic 。
794 42.445 1 11 。
000 .003 1。
369The independent variable is 年龄.分析:可以用Cubic拟合曲线图的拟合效果最好.第四题:棉花单株在不同时期的成铃数(y)与初花后天数(x)存在非线性的关系,假设这一非线性关系可用Gompertz模型表示:y=b1*exp(-b2*exp(—b3*x))。
SPSS回归分析实验报告
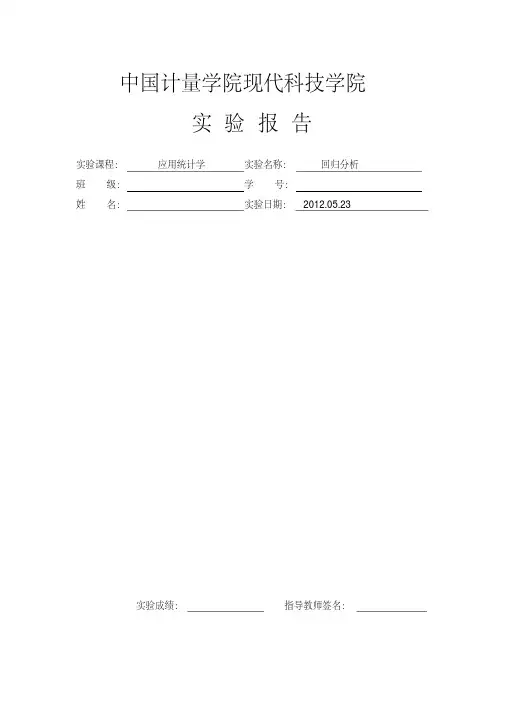
中国计量学院现代科技学院实验报告实验课程:应用统计学实验名称:回归分析班级:学号:姓名:实验日期: 2012.05.23 实验成绩:指导教师签名:一.实验目的一元线性回归简单地说是涉及一个自变量的回归分析,主要功能是处理两个变量之间的线性关系,建立线性数学模型并进行评价预测。
本实验要求掌握一元线性回归的求解和多元线性回归理论与方法。
二.实验环境中国计量学院现代科技学院机房310三.实验步骤与内容1打开应用统计学实验指导书,新建excel表地区供水管道长度(公里)全年供水总量(万平方米)北京15896 128823 天津6822 64537 河北10771.2 160132 山西5669.3 77525 内蒙古5635.5 59276 辽宁21999 280510 吉林6384.9 159570 黑龙江9065.9 153387 上海22098.8 308309 江苏36632.4 380395 浙江24126.9 235535 安徽7389.4 204128 福建6270.4 118512 江西5094.7 143240 山东26073.9 259782 河南11405.6 185092 湖北15668.6 257787 湖南9341.8 262691 广东35728.8 568949 广西6923.1 134412 海南1726.7 20241 重庆6082.7 71077 四川12251.3 165632 贵州3275.3 45198 云南5208.5 52742 西藏364.9 5363陕西4270 73580甘肃5010 62127青海893 14390宁夏1538.2 22921新疆3670.2 766852.打开SPSS,将数据导入3.打开分析,选择回归分析再选择线性因变量选全年供水总量,自变量选供水管道长度统计里回归系数选估计,再选择模型拟合按继续再按确定会出来分析的结果对以上结果进行分析:(1)回归方程为:y=28484.712+11.610X(X是自变量供水管道长度,Y是因变量全年供水总量)(2)检验1)拟合效果检验根据表2可知,R2=0.819,即拟合效果好,线性成立。
实验报告用EXCEL进行相关与回归分析
实验报告用EXCEL进行相关与回归分析
一、实验介绍
本实验通过用Excel进行相关和回归分析,以探讨两个变量之间的关系。
二、实验步骤
(1)首先,在Excel中收集数据,并将这些数据编入表格,表格中
的每一列分别表示变量,每一行表示一组观测数据;
(2)进行相关分析,首先,需要在Excel中计算出两个变量之间的
相关系数,然后判断相关系数的绝对值,确定变量之间的相关关系;
(3)接着,进行回归分析,在回归分析中,可以使用线性回归、非
线性回归等方法,用Excel中的函数计算出回归方程,以及回归系数r2,表示变量之间的回归关系;
(4)最后,根据实验结果,利用Excel拟合数据,画出变量之间的
拟合曲线,作出实验结果的图解;
三、实验结果
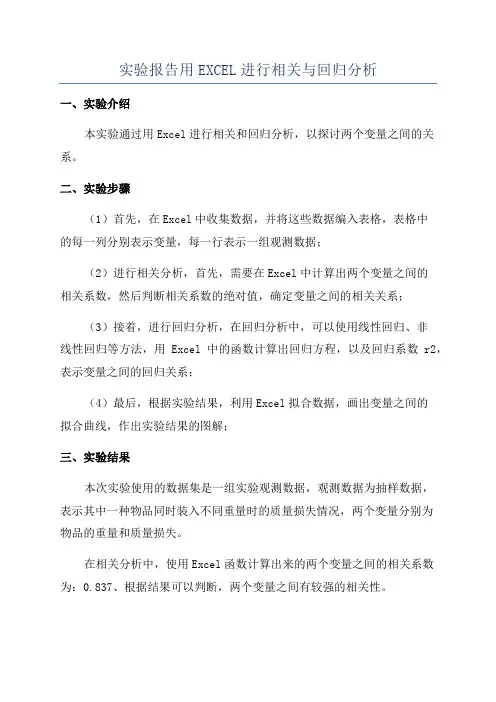
本次实验使用的数据集是一组实验观测数据,观测数据为抽样数据,
表示其中一种物品同时装入不同重量时的质量损失情况,两个变量分别为
物品的重量和质量损失。
在相关分析中,使用Excel函数计算出来的两个变量之间的相关系数为:0.837、根据结果可以判断,两个变量之间有较强的相关性。
而在回归分析中,使用Excel函数计算出来的线性回归方程为:
y=0.36x-1.27,回归系数r2为:0.701、由此可以看出,两个变量之间有较强的回归关系。
线性回归实验报告心得体会
线性回归实验报告心得体会在机器学习领域中,线性回归是基础算法之一。
通过建立数据间的线性函数关系,线性回归能够对未知数据进行预测。
在我的学习过程中,我通过线性回归实验掌握了这一算法的基本理论,并且从实验中也感受到了机器学习算法的强大威力。
首先,在线性回归的实验中,我们需要通过数据分析和建模,确定数据之间的线性关系并进行预测。
在此前提条件下,我们需要认真研究数据的分布和特性,合理构造出适合数据特性的模型。
在选择模型时,我们需要仔细考虑不同模型的优缺点,以及模型的适应性和实用性。
尤其是在探索贴近真实场景的数据建模时,模型的选择至关重要。
因为线性回归算法本身具有简单易懂和易实现的特性,所以我们更应当关注如何优化算法的性能。
首先,我们可以通过数据预处理和增强技术提高数据的分类精度。
这些技术包括对数据的清洗、去噪、归一化、降维等等。
针对不合适的模型和算法,我们可以通过调整参数或加入正则化等技巧,提高模型的拟合度和泛化能力。
在实验过程中,我还发现了很多有趣的问题。
例如,线性回归算法在处理一些非线性数据时会出现过拟合或欠拟合的问题。
这时我们就需要选择其它算法或构造复杂模型解决问题。
此外,线性回归算法也需要避免多重共线性和异常值等问题对模型拟合的干扰。
总的来说,线性回归实验为我提供了深入学习机器学习计算的机会,让我更好地了解了模型和算法的原理和实践。
我们不仅要认真研究单独算法的性能,更要关注算法在实际应用中的效果以及与其他算法的优劣比较。
我相信通过不断地学习和实践,我能够更好地掌握机器学习这一工具,并为更广泛的应用场景提供理论和技术支持。
利用回归分析预测实验结果的趋势
利用回归分析预测实验结果的趋势在科学研究和实验中,预测实验结果的趋势是一项重要的任务。
回归分析作为一种常用的统计方法,可以帮助我们探索变量之间的关系,并通过数学模型预测未来的结果。
本文将介绍回归分析的基本原理和应用,以及如何利用回归分析预测实验结果的趋势。
一、回归分析的基本原理回归分析是一种统计方法,用于研究自变量与因变量之间的关系。
在回归分析中,自变量是我们想要用来预测和解释因变量的变化的变量,因变量是我们想要预测的变量。
回归分析的目标是建立一个数学模型,可以通过自变量的取值预测因变量的取值。
回归分析的基本原理是最小二乘法。
最小二乘法通过将自变量与因变量的观测值代入数学模型,计算出预测值与观测值之间的差异(残差),然后调整模型参数,使得残差的平方和最小化。
最小二乘法可以得出最优的模型参数,并基于这个模型来预测未来的结果。
二、回归分析的应用回归分析广泛应用于各个领域的科学研究和实验中。
它可以帮助我们更好地理解变量之间的关系,预测未来的趋势,并作出更合理的决策。
以下是几个常见的应用领域:1. 经济学:回归分析可以用来研究经济变量之间的关系,如GDP与通货膨胀率、利率与投资额等。
通过回归分析,我们可以预测未来的经济趋势,评估政策的效果,并制定相应的经济政策。
2. 医学研究:回归分析可以用来研究生物医学的相关性,如药物剂量与疗效、生活方式与慢性疾病的关系等。
通过回归分析,我们可以预测治疗效果,指导临床决策,并优化治疗方案。
3. 社会科学:回归分析可以用来研究社会学、心理学、教育学等领域的问题,如家庭收入对子女学业成绩的影响、领导风格对员工满意度的影响等。
通过回归分析,我们可以预测社会现象的发展趋势,为政策制定和管理提供依据。
三、利用回归分析预测实验结果的趋势在科学研究和实验中,我们经常需要通过实验数据来预测未来的趋势。
回归分析可以帮助我们利用历史数据或实验结果,建立一个模型,并用这个模型来预测未来的结果。
SPSS实验回归分析
回归分析一.实验描述:中国民航客运量的回归模型。
为了研究我国民航客运量的变化趋势及其成因,我们以民航客运量作为因变量Y,以国民收入(X1)、消费额(X2)、铁路客运量(X3)、民航航线里程(X4)、来华旅游入境人数(X5)、为主要影响因素。
数据如下表。
试建立Y与X1--X5之间的多元线性回归模型。
二.实验过程描述及实验结果(1)该表格中输出了5个自变量和1个因变量的一般统计结果,包括各自变量与因变量的平均值,标准差和个案数16。
该表格中列出了各个变量之间的相关性,从该表格可以看出因变量Y和自变量X1之间的相关系数为0.989,相关性最大,。
因变量Y与自变量X3之间相关系数为0.227,相关性最小。
(3)该表格输出的是被引入或从回归方程中被剔出的各变量。
说明进行线性回归分析时所采用的方法是全部引入法Enter。
因变量为Y。
(4)该表格输出的是常用统计量。
从该表看出相关性系数R为0.999,判定系数R2为0.998,调整的判定系数为0.997,回归估计的标准误差为49.49240。
该表格输出的是方差分析表。
从这部分结果看出:统计量F为1.128E3;相伴概率值小于0.01,拒绝原假设说明多个自变量与因变量Y之间存在线性回归关系。
Sum of Squares一栏中分别代表回归平方和(1.382E7),残差平方和(24494.981)以及总平方和(1.384E7),df为自由度。
判定系数R2=0.99855。
该表格为回归系数分析。
其中Unstandardized Coefficients为非标准化系数,Standardized Coefficients为标准化系数,t为回归系数检验统计量,sig为相伴概率值。
由表知t检验的相伴概率值均小于0.01,拒绝原假设,说明个变量与因变量之间均有显著线性相关关系。
从表格中可以看出该多元线性回归方程为:y=450.909+0.354 X1-0.561 X2-0.007 X3+21.578 X4+0.435 X5该表格为残差统计结果表。
实验四回归分析SAS过程1
课时授课计课次序号:10、课题:实验四回归分析SAS过程(1)统计推断与预测二、课型:上机实验三、目的要求:1.掌握利用SAS建立多元回归方程的方法;2.能检验所建立回归方程的显著性与方程系数的显著性,能根据实际问题作预测与控制.四、教学重点:会对实际数据建立有效的多元回归模型;能对回归模型进行运用,对实际问题进行预测或控制.教学难点:多元回归模型的建立.五、教学方法及手段:传统教学与上机实验相结合.六、参考资料:《应用多元统计分析》,高惠璇编,北京大学出版社,2005;《使用统计方法与SAS系统》,高惠璇编,北京大学出版社, 2001;《多元统计分析》(二版),何晓群编,中国人民大学出版社, 2008;《应用回归分析》(二版),何晓群编,中国人民大学出版社, 2007;《统计建模与R软件》,薛毅编著,清华大学出版社,2007.七、作业:2.3 (单) 2.4八、授课记录:九、授课效果分析:实验四回归分析SAS过程(1)2学时、实验目的和要求掌握利用SAS建立多元回归方程的方法,掌握 PROC REG过程,并能检验所建立回归方程的显著性与方程系数的显著性,能根据实际问题作预测与控制.二、实验内容1.P ROC REG过程般格式:PROC REG <DATA=SAS data set>;MODEL 因变量=回归变量/ <选项部分>其它选择语句OUTPUT OUT=SAS 数据集名关键字名=输出数据集中的变量名;RUN;(1)PROC REG 语句此语句是PROC REG 过程的必需语句,指出要进行分析的数据集.省略此项,统对最新建立的数据集进行分析.SAS 系(2)MODEL 语句中的选项部分该语句定义建模用的因变量、回归变量(自变量)、模型的选择及拟合结果输出的选择.在关键词“ Model ”之后,应指明因变量,等号后依次列出回归变量,每个变量间用空格分开.此语句的选项部分提供了最优模型的选择方法和其他拟合结果的输出选项,其中包括:1)选择合适的建立模型方法:SELECTION=name其中“ n ame” 可以是FORWARD (或F)、BACKWARD (或 B )、STE PWISE、RSQUARE 、ADJRSQ 、CP 等之一.SELECTION=FORWARD SLENTRY= 显著性水平向前选择最优模型法(FORWARD ):从仅含常数项的回归模型开始,逐个加入自变量,对每一个尚不在方程内的自变量按一定显著性水平,根据其一旦进入模型后对模型的贡献大小逐步引入方程,直至再没有对模型有显著贡献的自变量.“SLENTRY= 显著性水平”为自变量进入模型的控制水平,写在选择方法语句之后.若省去此句,则SAS 系统默认的水平为SLENTRY=0.05 .SELECTION=BACKWARD SLSTAY=显著性水平向后删除法(BACKWARD ):先建立包含全部自变量的线性回归模型,然后按一定 的显著性水平从模型中逐步剔除变量.缺省SLSTAY =0.1SELECTION=STEPWISE SLENTRY = 入选水平 SLSTAY=易9除水平 逐步回归法(STE PWISE ):按向前选择法(前进法)进入变量,再对模型内所有变量检验,看是否有因新变量引入而对模型的贡献变得不显著,若有就剔除,若无则保留, 直至方程内所有变量均显著.逐步法有两个控制水平,即选入水平( SLENTRY=入选水平)和剔除水平(SLSTAY=剔除水平),而且剔除水平应低于选入水平.缺省 SLENTRY =0.15 SLSTAY =0.1 5SELECTION=RSQUARE在所有可能的回归方程中用 R p 准则选择最优模型 的方法.在每一个给定的自变量2个数的水平上,打印出使 R p 达到最大的那个回归模型的拟合结果.SELECTION=ADJRSQ :修订的R :准则选择最优模型法. SELECTION=CP : C p 准则选择最优模型法.注意:以上方法只可在选项部分写出其中一种,不可并用.2)对模型选取细节的选项DETAILS :对模型选取方法 FORW ARD 、BACKWARD 、STEPWISE ,若打印出每一步引入和删除自变量及相关信息选用此项.如一个自变量选入模型时的偏 型的R 2值和一个自变量被剔除时模型R 2值及有关参数估计的信息.NOINT :取消回归模型的常数项,即拟合过原点的回归方程. 3)对估计细节内容的选择:在选项部分,还可以选择一个或多个 (中间用空格分开) 参数估计和拟合残差等相关内 容,常用的有:CORRB :输出参数估计的 相关系数矩阵,第i 行第j 列为与时相关系数估计. COVB :输出估计参数的 协方差矩阵,即MSE (X TX )-1.P :输出因变量拟合值、观测值、拟合残差.若已选 CLI 、CLM 、R ,无需该选项. R :输出有关残差及用于影响性分析的各量,包括拟合值的标准差、残差、学生化残差(残差除以标准差)及 Cook 距离(度量了当删除某观测值后,参数估计的总变化量)T X 厂注意:以上选择内容可以和最优模型选择方法并用于BACKWARD 、FORWARD 、STEPWISE 的模型选择方法, 模型的相应结果;对 RSQUARE 准则,只给出全模型的相应结果;对于F 值、模I :输出矩阵(XTX )d .输出形式为「(XSSE 」Model 语句的“选项部分”.对 以上估计细节内容只是最终选择ADJRSQ 和 CP 方法,给出具有最大 R ;和C p 值的模型的相应结果.(3) OUT PUT 语句一一建立SAS 的输出结果数据集 此语句建立一个与估计内容有关的 SAS数据集.语句格式为:OUTPUT OUT=SAS 数据集名 关键字名=输出数据集中的变量名;关键字名为需要的统计量名,它们有PREDICTED (或P ) =name :因变量拟合值,指定名称为 name ; RESIDUAL (或R ) =name :残差及指定的名称; STUDENT=name :标准化(或学生化)残差;L95M=name :因变量期望值的95%的置信区间的置信下限; U95M=name :因变量期望值的95%的置信上限; L95=name :因变量值的95%置信区间的置信下限; U95=name :因变量值的95%的置信区间的置信上限;COOKD ( COOK 氏D 值)=name : Cooki 距离,用于影响性分析的统计量; H=name :杠杆量,即X i (X T X )」x T , i =1,2,…,n,X i 是设计矩阵X 的第i 行; PRESS=name : d i (p)值,用以估计第i 组观测值对拟合值的影响; DFFITS=name :用以估计第i 组观测值对参数估计的影响; STDP=name :期望值的标准误差 STDR=name :残差的标准误差; STD I =name :预测值的标准误差;其中等号前的部分为输出语句的关键词,后面的 以上介绍了一些常用的选项•无论选项如何, 的参数估计值及其标准差,检验参数是否为零的验回归关系显著性的 F 统计量和P 值,复相关系数及其平方值等.2. 示例例1 (书上例2.3 )某科学基金会的管理人员欲了解从事研究工作的中、高水平的数学家的年工资额丫与他们研究成果(论文、著作等)的质量指标X 1、从事研究工作时间 X 2、能 获得资助的指标 X 3 •为此按一定设计方案调查了24位此类型的数学家,得数据如书上表2.3所示.(1) 假设误差服从 N(0,b 2)分布,建立丫与X 1,X 2,X 3之间的线性回归方程并研究相 应的统计推断问题;name 飞等号前的变量指定一名称 PROC REG 过程总是自动输出相应模型t 统计量值及相应的 P 值•方差分析表、检(2)假设某位数学家的关于X i,X2,X3的值为(X oi,X o2,X o3)=(5.1,20,7.2),试预测他的年工资额并给出置信度为95%的置信区间.设丫与 X 1,X 2,X 3回归模型 丫 = * + P1X 1 +P 2X 2 + P 3X3+S 观测值满足 y i =p 0 + p 1 X i1 +p 2Xi2+ p3Xi3 +E i ,i =1,2,…,24(i =1,2"-,24)相互独立,且 S i ~ N(0,cr 2).£~ N(0, /1)SA 繇统回归分析的proc reg 过程进行统计推断程序:data exa mp2_3; input y x1-x3; cards33.2 3.5 9 6.1 40.35.3 206.438.7 5.1 18 7.4 46.8 5.8 33 6.7 41.44.2 31 7.537.5 6.0 13 5.9 39.0 6.8 25 6.0 40.75.5 30 4.030.1 3.1 5 5.8 52.9 7.2 47 8.3 38.2 4.5 25 5.0 31.8 4.9 11 6.4 43.38.0 23 7.644.1 6.5 35 7.0 42.86.6 39 5.033.6 3.7 21 4.434.2 6.2 7 5.5 48.0 7.0 40 7.0 38.0 4.0 35 6.0 35.9 4.5 23 3.5 40.45.9 33 4.936.8 5.6 27 4.3 45.24.8 34 8.0 35.1 3.9 15 5.0 run ;解:(1)建立回归模型进行统计推断其中1)proc reg data =exa mp 2 3; /*调用回归分析的reg 过程*/Sum of Mea nDF Squares SquareCorrected Total 23 SST=689.260001.75276 R-Square 0.9109 Depen de nt Mea n 39.50000Coeff Var 4.43735从方差分析表得出 c/2=MSE =3.0722 ;MSR H0真统计量F〜F (3, 20),其观测值F 0 =68.119MSEp = P H 0(F >F 0) =0.0001,拒绝H 0,认为Y 与X i ,X 2,X 3的线性回归关系是高度显著的.另外,由方差分析表给出宀磐二签勿9109,也表明线性回归关系高度显著・P arameter Estimates参数估计表model y=x1-x3/i; run ; /* 模型因变量 y,自变量x1、x2、 x3,输岀Hessian 矩阵*/ 2) 由方差分析表进行统计推断 An alysis of Varia nee方差分析表方差来源 自由度 平方和(SS ) Model Error 均方(MSp-1=3 SSR=627.81700 MSR=SSR/3=209.27233 F n-p=24-4=20 SSE=61.44300 MSE=SSE/20=3.072150=MSR/MSE检验 p 值 p 00=68.12 < 0001SourceF Value Pr > FRoot MSE Adj R-Sq 0.8975线性回归关系显著性检验:H 。