
关系数据库-范式
同时,由于数据冗余度的降低,数据没有重复存储,也 不会引起更新异常。
关系模式的存储异常问题
分解后的关系模式是一个好的关系数据库模 式。
一个好的关系模式应该具备以下四个条件:
后经许多专家学者对关系数据库理论作了深 入的研究和发展,形成了一整套有关关系数 据库设计的理论。
规范化理论内容
关系数据库的规范化理论主要包括三个方面 的内容:
函数信赖 范式(Normal Form) 模式设计
其中,函数信赖起着核心的作用,是模式分 解和模式设计的基础,范式是模式分解的标 准。
若X → Y,且Y X,则称X→Y是平凡的函数依赖 若X → Y,但Y X,则称X→Y是非平凡的函数依赖,若
不特别声明,总是讨论非平凡的函数依赖 当X→Y且Y→X时,则记作:X Y
例4.2.5:
解:X→Y为平凡函数依赖 X→W, W→Y为非平凡函数依赖
ห้องสมุดไป่ตู้
例:在关系SC(Sno, Cno, Grade)中 非平凡函数依赖: (Sno, Cno) → Grade 平凡函数依赖:
“包罗万象”,内容太杂了。 那么,怎样才能得到一个好的关系模式呢?
分解
我们把关系模式SCD分解为下面三个结构简单的关系 模式,如图所示。 学生关系S(SNO,SN,AGE,DEPT) 选课关系SC(SNO,CNO,SCORE) 系关系D(DEPT,MN)
S
SNO S1 S2 S3 S4
数据库原理与SQL Server2005 应用教程
苏州大学计算机科学与技术学院
关系数据库规范化
关系数据库规范化理论
如何设计一个适合的关系数据库系统,关键是关系数据库模 式的设计,一个好的关系数据库模式应该包括多少关系模式, 而每一个关系模式又应该包括哪些属性,又如何将这些相互 关联的关系模式组建一个适合的关系模型,这些工作属于数 据库设计的问题,确切地讲是数据库逻辑设计的问题,有关 数据库设计的全过程将在第4章详细讨论
所以函数依赖反映了一种语义完整性约束。
有关函数依赖的说明:
2.函数依赖与属性之间的联系类型有关。
(1)在一个关系模式中,如果属性X与Y有1:1联系时,则 存在函数依赖X→Y,Y→X,即X Y。
例如,当学生无重名时,SNO SN。
(2)如果属性X与Y有m:1的联系时,则只存在函数依赖 X→Y。
有关函数依赖的说明:
1.函数依赖是语义范畴的概念。
只能根据语义来确定一个函数依赖,而不能按照其 形式化定义来证明一个函数依赖是否成立。
例如,对于关系模式S,当学生不存在重名的情况 下,可以得到:
SN→AGE
SN→DEPT
这种函数依赖关系,必须是在没有重名的学生条件 下才成立的,否则就不存在函数依赖了。
函数依赖的定义及性质
关系模式中的各属性之间相互依赖、相互制 约的联系称为数据依赖。
一个关系内部属性与属性之间的约束关系 现实世界属性间相互联系的抽象 数据内在的性质 语义的体现
函数依赖的分类
函数依赖(Functional Dependency,FD) 多值依赖(Multivalued Dependency,简
关系模式的存储异常问题
4. 更新异常。
如果学生改名,则该学生的所有记录都要逐一修改SN; 又如某系更换系主任,则属于该系的学生记录都要修
改MN的内容,稍有不慎,就有可能漏改某些记录,这 就会造成数据的不一致性,破坏了数据的完整性。
关系模式的存储异常问题
SCD是一个不好的关系模式。 产生上述问题的原因,直观地说,是因为关系中
本章讲述关系数据库规范化理论,这是数据库逻辑设计的理 论依据。
要求了解规范化理论的研究动机及其在数据库设计中的作用, 掌握函数依赖的有关概念, 第一范式、第二范式、第三范式的定义, 重点掌握并能够灵活运用关系模式规范化的方法和关系模式分解的
方法,这也是本章的难点。
关系数据库规范化理论
关系数据库的规范化理论最早是由关系数据 库的创始人E.F.Codd提出的,
根据实际情况,这些数据有如下语义规定:
1. 一个系有若干个学生,但一个学生只属于一个系;
2. 一个系只有一名系主任,但一个系主任可以同时兼几 个系的系主任;
3. 一个学生可以选修多门功课,每门课程可有若干学生 选修;
4. 每个学生学习课程有一个成绩。
在此关系模式中填入一部分具体的数据,则可得到SCD关系模式
这类似于变量之间的单值函数关系。设单值函数 Y=F(X),自变量X的值可以决定一个唯一的函数 值Y。
在这里,我们说SNO决定函数(SN,AGE,DEPT), 或者说(SN,AGE,DEPT)函数依赖于SNO。
函数依赖的形式化定义
定义5 设关系模式R(U,F),U是属性全集,F是U 上的函数依赖集,X和Y是U的子集,如果对于R(U) 的任意一个可能的关系r,对于X的每一个具体值, Y都有唯一的具体值与之对应,则称X决定函数Y, 或Y函数依赖于X,记作X→Y。我们称X为决定因 素,Y为依赖因素。当Y不函数依赖于X时,记作: X Y。
S中存储学生基本信息,与所选课程及系主任无关;
D中存储系的有关信息,与学生无关;
SC中存储学生选课的信息,而与学生及系的有关信息无 关。
与SCD相比,分解为三个关系模式后,数据的冗余度 明显降低。
当新插入一个系时,只要在关系D中添加一条记录。
当某个学生尚未选课,只要在关系S中添加一条学生记录, 而与选课关系无关,这就避免了插入异常。
(Sno, Cno) → Sno (Sno, Cno) → Cno
说明:对于任一关系模式,平凡函数依赖都是 必然成立的,它不反映新的语义,因此若不 特别声明, 我们总是讨论非平凡函数依赖。
例如:
对于关系模式SCD
U={SNO,SN,AGE,DEPT,MN,CNO,SCORE} F={SNO→SN,SNO→AGE,SNO→DEPT}
可从属性间的联系类型来分析属性间的函数依赖
有关函数依赖的说明:
3.函数依赖关系的存在与时间无关。
因为函数依赖是指关系中的所有元组应该满足的约束条 件,而不是指关系中某个或某些元组所满足的约束条件。
当关系中的元组增加、删除或更新后都不能破坏这种函 数依赖。
因此,必须根据语义来确定属性之间的函数依赖,而不 能单凭某一时刻关系中的实际数据值来判断。
如何按照一定的规范设计关系模式,将结构 复杂的关系分解成结构简单的关系,降低或 消除数据库中冗余数据的过程,这就是关系 的规范化。
函数依赖
关系模式由五部分组成,即它是一个五元组: R(U, D, DOM, F)
R: 关系名 U: 组成该关系的属性名集合 D: 属性组U中属性所来自的域 DOM: 属性向域的映象集合 F: 属性间数据的依赖关系集合
例如,对于关系模式S,假设没有给出无重名的学生这种语义规 定,则即使当前关系中没有重名的记录,也只能存在函数依赖 SNO→SN,而不能存在函数依赖SN→SNO,因为如果新增加一 个重名的学生,函数依赖SN→SNO必然不成立。
设有关系 STUDENT(S#,SNAME,SDEPT,MNAME,CNAME, GRADE),S#,CNAME为候选码,设关系中有如 下函数依赖:
例 如 , SNO 与 AGE , DEPT 之 间 均 为 m:1 联 系 , 所 以 有
SNO→AGE,SNO→DEPT。
(3)如果属性X与Y有m: n的联系时,则X与Y之间不存在任 何函数依赖关系。
例如,一个学生可以选修多门课程,一门课程又可以
为多个学生选修,所以SNO与CNO之间不存在函数依赖关系
SN 赵亦 钱尔 孙珊 李思
AGE
DEPT
17
计算机
18
信息
20
信息
21
自动化
D
DEPT 计算机
信息 自动化
MN 刘伟 王平 刘向
SC
SNO
CNO
SCORE
S1
C1
90
S1
C2
85
S2
C5
57
S2
C6
80
S2
C7
S2
C5
70
S3
C1
0
S3
C2
70
S3
C4
85
S4
C1
93
分解后的关系模式
在以上三个关系模式中,实现了信息的某种程度的 分离,
一 个 SNO 有 多 个 SCORE 的 值 与 其 对 应 , 因 此 SCORE不能唯一地确定,即SCORE不能函数依 赖于SNO,所以有: SNO SCORE。
但是SCORE可以被(SNO,CNO)唯一地确定。 所以可表示为:(SNO,CNO)→SCORE。
函数依赖(续)
例: Student(Sno, Sname, Ssex, Sage, Sdept)
的实例,即一个教学管理数据库,如图所示。
SNO
SN
AGE
DEPT
MN
CNO
SCORE
S1
赵亦
17
计算机 刘伟
C1
90
S1
赵亦
17
计算机 刘伟
C2
85
S5
钱尔
18
信息
王平
C5
57
S2
钱尔
18
信息
王平
C6
80
S2
钱尔
18
信息
王平
C7
70
S2
钱尔
18
信息
王平
C5
70
S3
孙珊
20
信息
王平
C1
关系数据库 范式

关系数据库范式
关系数据库范式是一种用于设计关系数据库的规则和标准,以确保数据的一致性、完
整性和有效性。
主要目的是减少数据冗余和数据维护的复杂性,从而提高数据库的性能和
可靠性。
在关系数据库中,范式共有6个阶段,分别为第一范式(1NF)、第二范式(2NF)、
第三范式(3NF)、巴斯科范式(BCNF)、第四范式(4NF)和第五范式(5NF)。
第一范式(1NF):属性不可分
第一范式指任何一个关系模式的所有属性都是不可分的原子值,也就是属性的值都不
能再细分成更小的部分。
例如,一个表中的地址字段,可以将其拆分为街道、城市、州和邮政编码等多个部分,但是在1NF中,这些部分都必须被当做单独的属性来存储。
第二范式(2NF):满足1NF的基础上,消除部分依赖
第二范式指任何非主键属性都必须完全依赖于主键,也就是非主键属性不能只依赖于
主键的一部分。
例如,一个订单表中的商品名称、商品价格和商品数量,都必须依赖于唯一的订单编
号(主键),而不能只依赖于日期等其他属性。
如果存在部分依赖,需要对表进行拆分。
例如,一个客户和订单表中,一个客户可以下多个订单,但是每个订单只能对应一个
客户。
如果将客户的联系方式和收货地址存储在订单表中,就会出现多值依赖的问题。
因此,需要对表进行拆分。
第五范式(5NF):尽量避免冗余
第五范式指关系模式中的数据不能通过拆分为更小的关系模式来避免冗余数据。
例如,一个图书馆书籍表中,如果将每个书籍作者的个人信息存储在作者表中,就会
出现多次重复的数据。
因此,需要将重复的数据存储在单独的表中,并通过关联方式进行
连接。
范式理论

一是重复存储职工号和姓名。这样,关键字只能是电话号码。
二是职工号为关键字,电话号码分为单位电话和住宅电话两个属性
三是职工号为关键字,但强制每条记录只能有一个电话号码。
以上三个方法,第一种方法最不可取,按实际情况选取后两种情况。
第二范式(2NF):如果关系模式R(U,F)中的所有非主属性都完全依赖于任意一个候选关键字,则称关系R 是属于第二范式的。
方法:将关系模式投影分解成两个或两个以上的关系模式。
要求:分解后的关系模式集合应当与原关系模式等价,即经过自然联接可以恢复原关系而不丢失信息,并保持属性间合理的联系。
注意:一个关系模式结这分解可以得到不同关系模式集合,也就是说分解方法不是唯一的。最小冗余的要求必须以分解后的数据库能够表达原来数据库所有信息为前提来实现。其根本目标是节省存储空间,避免数据不一致性,提高对关系的操作效率,同时满足应用需求。实际上,并不一定要求全部模式都达到BCNF不可。有时故意保留部分冗余可能更方便数据查询。尤其对于那些更新频度不高,查询频度极高的数据库系统更是如此。
关系数据库设计之时是要遵守一定的规则的。尤其是数据库设计范式 现简单介绍1NF(第一范式),2NF(第二范式),3NF(第三范式)和BCNF,另有第四范式和第五范式留到以后再介绍。 在你设计数据库之时,若能符合这几个范式,你就是数据库设计的高手。
数据库范式与关系模式示例
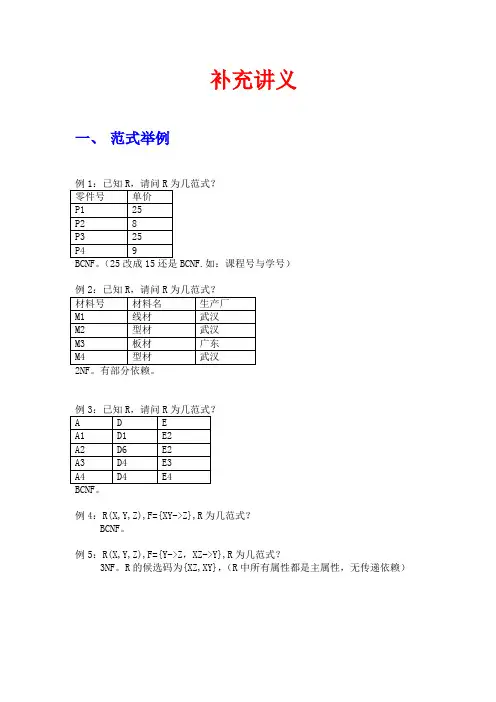
补充讲义一、范式举例BCNF.如:课程号与学号)例4:R(X,Y,Z),F={XY->Z},R为几范式?BCNF。
例5:R(X,Y,Z),F={Y->Z,XZ->Y},R为几范式?3NF。
R的候选码为{XZ,XY},(R中所有属性都是主属性,无传递依赖)二、求闭包数据库设计人员在对实际应用问题调查中,得到的结论往往是零散的、不规范的(直观问题好办,复杂问题难办了),所以,这对分析数据模型,达到规范化设计要求,还有差距,为此,从规范数据依赖集合的角度入手,找到正确分析数据模型的方法,以确定关系模式的规范化程度。
例1.已知关系模式R(U、F),其中,U={A,B,C,D,E}; F={AB→ C, B→ D, EC → B , AC→B} ,求(AB)+F.解:设X(0)=AB○1计算X(1),在F中找出左边为AB子集的FD,其结果是:AB→C,B→D∴X(1)=X(0)UB=ABUCD=ABCD 显然,X(1)≠X(0)○2计算X(2),在F中找出左边为ABCD子集的FD,其结果是:C→E,AC→B∴X(2)=X(1)UB=ABCDUBE=ABCDE 显然,X(2)=U所以,(AB)+ F=ABCDE.(等于U,所以AB是唯一候选关键字)例2.设有关系模式R(U、F),其中U={A,B,C,D,E,I};F={A→D,AB→E,B→E,CD→I,E→C},计算(AE)+解:令X={AE},X(0)=AE○1在F中找出左边是AE子集的FD,其结果是:A→D,E→C∴X(1)=X(0)UB=X(0)UDC=ACDE 显然,X(1)≠X(0)○2在F中找出左边是ACDE子集的FD,其结果是:CD→I∴X(2)=X(1)UI=ACDEI显然,X(2)≠X(1),但F中未用过的函数依赖的左边属性已含有X(2)的子集,所以不必再计算下去,即(AE)+=ACDEI.因为,X(3)=X(2),所以,算法结束。
关系数据库范式

关系数据库范式关系数据库范式是指在关系数据库中,为了避免数据冗余和数据不一致性而设计的一种规范化方法。
范式分为一般范式和高级范式,一般范式包括第一范式、第二范式和第三范式,高级范式包括BC 范式和第四范式。
第一范式(1NF)第一范式是指关系模式中的所有属性都是原子性的,即不可再分解。
例如,一个学生的信息包括姓名、性别、年龄、地址等,这些属性都是原子性的,不可再分解。
如果将地址拆分成省、市、区、街道等多个属性,则不符合第一范式。
第二范式(2NF)第二范式是指关系模式中的非主属性必须完全依赖于主键,而不是依赖于主键的一部分。
例如,一个订单的信息包括订单号、商品编号、商品名称、商品单价、商品数量等,其中商品名称、商品单价、商品数量都依赖于商品编号,而不是订单号。
因此,应该将商品编号作为主键,将商品名称、商品单价、商品数量作为非主属性。
第三范式(3NF)第三范式是指关系模式中的非主属性不应该存在传递依赖关系。
传递依赖关系是指非主属性依赖于其他非主属性,而不是直接依赖于主键。
例如,一个学生的信息包括学号、姓名、班级、学院、学院地址等,其中学院地址依赖于学院,而不是直接依赖于学号。
因此,应该将学院作为一个独立的关系,与学生信息关系进行关联。
BC范式BC范式是指关系模式中的所有非主属性都必须依赖于候选键,而不是依赖于主键。
候选键是指可以唯一标识一个元组的属性集合。
例如,一个订单的信息包括订单号、商品编号、商品名称、商品单价、商品数量等,其中商品名称、商品单价、商品数量都依赖于商品编号,而商品编号不是主键,而是候选键。
因此,应该将商品编号作为主键,将商品名称、商品单价、商品数量作为非主属性。
第四范式(4NF)第四范式是指关系模式中的多值依赖关系必须被消除。
多值依赖关系是指一个关系模式中的某些属性可以有多个取值,而这些属性之间存在依赖关系。
例如,一个学生的信息包括学号、姓名、选修课程、成绩等,其中选修课程和成绩之间存在多值依赖关系,即一个学生可以选修多门课程,每门课程有一个成绩。
关系数据库设计理论(关系模式、函数依赖、范式)
函数依赖关系是属性间的一种多对一的关系。 函数依赖关系是属性间的一种多对一的关系。 如果X →Y, X←Y, 是一对一关系。 如果X →Y,且X←Y,则X和Y是一对一关系。
如学号与身份证号。 如学号与身份证号。
7.2
函数依赖
SQL Server 2000
三、函数依赖的几种特例
1、平凡函数依赖与非平凡函数依赖 、 如果X→Y, 如果X→Y,且Y X→Y 若Y 由于Y 由于Y 称为非平凡函数依赖。 X,则X→Y 称为非平凡函数依赖。
7.1
关系模式的评价
SQL Server 2000
教学(学号,姓名,年龄,系名,系主任,课程名,成绩) 教学(学号,姓名,年龄,系名,系主任,课程名,成绩)
学号 98001 98001 98002 98002 98003 98003 99001 姓名 李华 李华 张平 张平 陈兵 陈兵 陆莉 年龄 21 21 22 22 21 21 23 系名 计算机 计算机 计算机 计算机 数学 数学 物理 系主任 王民 王民 王民 王民 赵敏 赵敏 王珊 课程名 C语言 高等数学 C语言 高等数学 高等数学 离散数学 普通物理 成绩 90 80 65 70 95 75 85
7.1
关系模式的评价
SQL Server 2000
对于有问题的关系模式, 对于有问题的关系模式,可以通过模式分解的方法使之 规范化, 规范化,上述关系模式如果分解为如下三个关系则可以克服 以上出现的问题。 以上出现的问题。 学生(学号,姓名,年龄,系名) 学生(学号,姓名,年龄,系名) 系(系名,系主任) 系名,系主任) 选课(学号,课程名,成绩) 选课(学号,课程名,成绩) 如何分解关系模式,分解的依据是什么? 如何分解关系模式,分解的依据是什么?下二节将讨论 这些问题。 这些问题。
数据库范式(1NF2NF3NFBCNF)详解
数据库的设计范式是数据库设计所需要满足的规范,满足这些规范的数据库是简洁的、结构明晰的,同时,不会发生插入(insert)、删除(delete)和更新(update)操作异常。
反之则是乱七八糟,不仅给数据库的编程人员制造麻烦,而且面目可憎,可能存储了大量不需要的冗余信息。
范式说明第一范式(1NF)无重复的列所谓第一范式(1NF)是指数据库表的每一列都是不可分割的基本数据项,同一列中不能有多个值,即实体中的某个属性不能有多个值或者不能有重复的属性。
如果出现重复的属性,就可能需要定义一个新的实体,新的实体由重复的属性构成,新实体与原实体之间为一对多关系。
在第一范式(1NF)中表的每一行只包含一个实例的信息。
简而言之,第一范式就是无重复的列。
说明:在任何一个关系数据库中,第一范式(1NF)是对关系模式的基本要求,不满足第一范式(1NF)的数据库就不是关系数据库。
例如,如下的数据库表是符合第一范式的:字段1 字段2 字段3 字段4而这样的数据库表是不符合第一范式的:字段1 字段2 字段3 字段4字段字段数据库表中的字段都是单一属性的,不可再分。
这个单一属性由基本类型构成,包括整型、实数、字符型、逻辑型、日期型等。
很显然,在当前的任何关系数据库管理系统(DBMS)中,傻瓜也不可能做出不符合第一范式的数据库,因为这些DBMS不允许你把数据库表的一列再分成二列或多列。
因此,你想在现有的DBMS中设计出不符合第一范式的数据库都是不可能的。
第二范式(2NF)属性完全依赖于主键[ 消除部分子函数依赖]如果关系模式R为第一范式,并且R中每一个非主属性完全函数依赖于R的某个候选键,则称为第二范式模式。
第二范式(2NF)是在第一范式(1NF)的基础上建立起来的,即满足第二范式(2NF)必须先满足第一范式(1NF)。
第二范式(2NF)要求数据库表中的每个实例或行必须可以被惟一地区分。
为实现区分通常需要为表加上一个列,以存储各个实例的惟一标识。
第一、二、三范式
设计范式简介(范式,数据库设计范式,数据库的设计范式)是符合某一种级别的关系模式的集合。
构造数据库必须遵循一定的规则。
在关系数据库中,这种规则就是范式。
关系数据库中的关系必须满足一定的要求,即满足不同的范式。
目前关系数据库有六种范式:第一范式(1NF)、第二范式(2NF)、第三范式(3NF)、第四范式(4NF)、第五范式(5NF)和第六范式(6NF)。
满足最低要求的范式是第一范式(1NF)。
在第一范式的基础上进一步满足更多要求的称为第二范式(2NF),其余范式以次类推。
一般说来,数据库只需满足第三范式(3NF)就行了。
下面我们举例介绍第一范式(1NF)、第二范式(2NF)和第三范式(3NF)。
在创建一个数据库的过程中,范化是将其转化为一些表的过程,这种方法可以使从数据库得到的结果更加明确。
这样可能使数据库产生重复数据,从而导致创建多余的表。
范化是在识别数据库中的数据元素、关系,以及定义所需的表和各表中的项目这些初始工作之后的一个细化的过程。
下面是范化的一个例子Customer Item purchased Purchase price------------------------------------------------------------------------Thomas Shirt $40Maria Tennis shoes $35Evelyn Shirt $40Pajaro Trousers $25如果上面这个表用于保存物品的价格,而你想要删除其中的一个顾客,这时你就必须同时删除一个价格。
范化就是要解决这个问题,你可以将这个表化为两个表,一个用于存储每个顾客和他所买物品的信息,另一个用于存储每件产品和其价格的信息,这样对其中一个表做添加或删除操作就不会影响另一个表。
关系数据库的几种设计范式介绍第一范式(1NF)在任何一个关系数据库中,第一范式(1NF)是对关系模式的基本要求,不满足第一范式(1NF)的数据库就不是关系数据库。
数据库三大范式通俗解释
数据库三⼤范式通俗解释⼀、三⼤范式通俗解释:(1)简单归纳: 第⼀范式(1NF):字段不可分; 第⼆范式(2NF):有主键,⾮主键字段依赖主键; 第三范式(3NF):⾮主键字段不能相互依赖。
(2)解释: 1NF:原⼦性。
字段不可再分,否则就不是关系数据库;; 2NF:唯⼀性。
⼀个表只说明⼀个事物; 3NF:每列都与主键有直接关系,不存在传递依赖。
⼆、例⼦说明 (1)不符合第⼀字段的例⼦表:字段1,字段2(字段2.1,字段2.2),字段3字段2可以拆分成字段2.1和字段2.2,不符合第⼀范式。
(2)不符合第⼆范式的例⼦表:学号,姓名,年龄,课程名称,成绩,学分这个表明显说明了两个事务:学⽣信息,课程信息。
1)存在以下问题:a、数据冗余:每条记录都含有相同信息;b、删除异常:删除所有学⽣成绩,就把课程信息全删除了;c、插⼊异常:学⽣未选课,⽆法记录进数据库;d、更新异常:调整课程学分,所有⾏都调整。
2)修正:学⽣表:学号,姓名,年龄课程表:课程名称,学分选课关系表:学号,课程名称,成绩 (3)不符合第⼆范式的例⼦表:学号,姓名,年龄,所在学院,学院联系电话其中关键字为单⼀关键字"学号"。
存在依赖传递::(学号) → (所在学院) → (学院联系电话) 。
1)存在问题:: a、数据冗余:有重复值; b、更新异常:有重复的冗余信息,修改时需要同时修改多条记录,否则会出现数据不⼀致的情况 c、删除异常 2)修正:学⽣表:学号,姓名,年龄,所在学院;学院表:学院,电话⼀范式就是属性不可分割。
属性是什么?就是表中的字段。
不可分割的意思就按字⾯理解就是最⼩单位,不能再分成更⼩单位了。
这个字段只能是⼀个值,不能被拆分成多个字段,否则的话,它就是可分割的,就不符合⼀范式。
不过能不能分割并没有绝对的答案,看需求,也就是看你的设计⽬标⽽定。
举例:学⽣信息组成学⽣信息表,有姓名、年龄、性别、学号等信息组成。
范式理论
构造数据库必须遵循一定的规则。
在关系数据库中,这种规则就是范式。
范式是符合某一种级别的关系模式的集合。
关系数据库中的关系必须满足一定的要求,即满足不同的范式。
目前关系数据库有六种范式:第一范式(1NF)、第二范式(2NF)、第三范式(3NF)、第四范式(4NF)、第五范式(5NF)和第六范式(6NF)。
满足最低要求的范式是第一范式(1NF)。
在第一范式的基础上进一步满足更多要求的称为第二范式(2NF),其余范式以次类推。
一般说来,数据库只需满足第三范式(3 NF)就行了。
下面我们举例介绍第一范式(1NF)、第二范式(2NF)和第三范式(3 NF)。
3.4.1 第一范式(1NF)在任何一个关系数据库中,第一范式(1NF)是对关系模式的基本要求,不满足第一范式(1NF)的数据库就不是关系数据库。
所谓第一范式(1NF)是指数据库表的每一列都是不可分割的基本数据项,同一列中不能有多个值,即实体中的某个属性不能有多个值或者不能有重复的属性。
如果出现重复的属性,就可能需要定义一个新的实体,新的实体由重复的属性构成,新实体与原实体之间为一对多关系。
在第一范式(1NF)中表的每一行只包含一个实例的信息。
例如,对于图3-2 中的员工信息表,不能将员工信息都放在一列中显示,也不能将其中的两列或多列在一列中显示;员工信息表的每一行只表示一个员工的信息,一个员工的信息在表中只出现一次。
简而言之,第一范式就是无重复的列。
3.4.2 第二范式(2NF)第二范式(2NF)是在第一范式(1NF)的基础上建立起来的,即满足第二范式(2NF)必须先满足第一范式(1NF)。
第二范式(2NF)要求数据库表中的每个实例或行必须可以被唯一地区分。
为实现区分通常需要为表加上一个列,以存储各个实例的唯一标识。
如图3-2 员工信息表中加上了员工编号(emp_id)列,因为每个员工的员工编号是唯一的,因此每个员工可以被唯一区分。
这个唯一属性列被称为主关键字或主键、主码。
123范式
在创建一个数据库的过程中,必须依照一定的准则,这些准则被称为范式,从第一到第六共六个范式,一般数据库设计只要遵循第一范式,第二范式,和第三范式就足够了。
满足这些规范的数据库是简洁的、结构明晰的,同时,不会发生插入(insert)、删除(delete)和更新(update)操作异常。
反之则是乱七八糟,不仅给数据库的编程人员制造麻烦,而且面目可憎,可能存储了大量不需要的冗余信息。
阅读对象最好了解关系数据库的基本知识想从事软件开发的人员I、关系数据库设计范式介绍1.1 第一范式(1NF)无重复的列所谓第一范式(1NF)是指数据库表的每一列都是不可分割的基本数据项,同一列中不能有多个值,即实体中的某个属性不能有多个值或者不能有重复的属性。
如果出现重复的属性,就可能需要定义一个新的实体,新的实体由重复的属性构成,新实体与原实体之间为一对多关系。
在第一范式(1NF)中表的每一行只包含一个实例的信息。
简而言之,第一范式就是无重复的列。
说明:在任何一个关系数据库中,第一范式(1NF)是对关系模式的基本要求,不满足第一范式(1NF)的数据库就不是关系数据库。
1.2 第二范式(2NF)属性完全依赖于主键第二范式(2NF)是在第一范式(1NF)的基础上建立起来的,即满足第二范式(2NF)必须先满足第一范式(1NF)。
第二范式(2NF)要求数据库表中的每个实例或行必须可以被惟一地区分。
为实现区分通常需要为表加上一个列,以存储各个实例的惟一标识。
例如员工信息表中加上了员工编号(emp_id)列,因为每个员工的员工编号是惟一的,因此每个员工可以被惟一区分。
这个惟一属性列被称为主关键字或主键、主码。
第二范式(2NF)要求实体的属性完全依赖于主关键字。
所谓完全依赖是指不能存在仅依赖主关键字一部分的属性,如果存在,那么这个属性和主关键字的这一部分应该分离出来形成一个新的实体,新实体与原实体之间是一对多的关系。
为实现区分通常需要为表加上一个列,以存储各个实例的惟一标识。