
编译原理-递归下降分析法的实现-内附源码
编
译
原
理
实
验
报
告
姓名:关海超
学号:200807010209
专业:计算机科学与技术
班级:08—02班
递归下降分析法的实现
实验要求
递归下降分析法是确定的自上而下分析法,这种分析法要求文法是LL(1)文法。
它的基本思想是,对文法中的每个非终结符编写一个函数(或子程序),每个函数(或子程序)的功能是识别由该非终结符所表示的语法成分。
由于描述语言的文法通常是递归定义的,因此相应的这组函数(或子程序)必然一相互递归的方式进行调用,所以将此种分析方法称为递归下降分析法。
本实验要求构造下述文法的递归下降分析程序:
文法G[S]:
S —> a | ^ | (T)
T —> T,S | S
实验内容
首先,消去该文法左递归,得到文法G’[S]:
S —> a | ^ | (T)
T —> ST’
T’—> ,ST’ | 空串
然后,根据LL(1)文法的判断条件,对非终结符S和T’的不同产生式的SSELECT集进行考察,经验证改进后的文法已经是LL(1)文法。
最后构造递归下降分析程序。
每个函数名是相应的非终结符,函数体则是根据规则右部符号串的结构编写。
(1)当遇到终结符a时,则编写语句
if (当前读来的输入符号== a) 读下一个输入符号
(2)当遇到非终结符A时,则编写语句调用A()。
(3)当遇到A —> 空串规则时,则编写语句
if (当前读来的输入字符不属于FOLLOW(A) ) error()
(4)当某个非终结符的规则有很多个候选式是,按LL(1)文法的条件能唯一地选择一个候选式进行推导。
实验结果
实验总结
这次实验内容比较简单。
由于有固定的模式来构造程序,因此即使对于其他LL(1)文法也很容易构造其相应的递归下降分析程序。
这次实验我学习了如何将递归下降分析思想具体转化为程序来实现,同时也加深了产生式的Follow集在递归下降分析法中的应用,练习了通过SELECT集判断文法是否为LL(1)文法。
附录(源代码)
#include <stdio.h>
#include <windows.h>
#include <string.h>
char token[20];
char sym;
int p;
void S();
void T();
void U();
void Scaner();
void Error();
void S()
{
if (sym == 'a' || sym == '^')
Scaner();
else
if (sym == '(')
{
Scaner();
T();
if (sym == ')')
Scaner();
else
Error(); }
else
Error(); }
void T()
{
S();
U();
}
void U()
{
if (sym == ',')
{
Scaner();
S();
U();
}
else
if (sym != ')')
Error(); }
void Scaner()
{
sym = token[p++]; }
void Error()
{
printf("Error!\n");
exit(0);
}
int main()
{
printf("Please input : \n");
gets(token);
p = 0;
Scaner();
S();
if (sym == '#')
printf("Success!\n");
else
printf("Fail!\n");
return 0;
}。
编译原理实验报告——实验二 递归下降分析
printf("T'->*FT'\t"); printf("#E'T'F*\t\t"); print(); } else { printf("T'->/FT'\t"); printf("#E'T'F/\t\t"); print(); }
7
myAdvance(); printf("\t\t"); printf("#E'T'F\t\t"); print(); myF(); } if( sym!='*'||sym!='/') { printf("T'->^\t\t"); printf("#E'\t\t"); print(); } return(1); } else return(0); } /*判断是否是表达式或者括号*/ int myF() { int p; if (sym >= 'A' && sym <= 'Z' || sym >= 'a' && sym <= 'z' ) { printf("F->i\t\t"); printf("#E'T'i\t\t"); print(); myAdvance(); printf("\t\t"); printf("#E'T'\t\t"); print(); return(1); } else{
编译原理 递归下降词法分析
编译原理实验报告—递归下降分析法程序实验2.1 递归下降分析法一、实验目的1. 根据某一文法编制递归下降分析程序,以便对任意输入的符号串进行分析。
2. 本次实验的目的是加深对递归下降分析法的理解。
二、实验平台Windows + VC++6.0范例程序: “递归下降分析法.cpp ”三、实验内容对下列文法,用递归下降分析法对任意输入的符号串进行分析:(1)E→TG(2)G→+TG|-TG(3)G→ε(4)T→FS(5)S→*FS|/FS(6)S→ε(7)F→(E)(8)F→i1.程序功能:输入: 一个以# 结束的符号串(包括+ - * / ()i # ):例如:i+i*i-i/i#输出:(1) 详细的分析步骤,每一步使用的产生式、已分析过的串、当前分析字符、剩余串,第一步, 产生式E->TG的第一个为非终结字符,所以不输出分析串,此时分析字符为i,剩余字符i+i*i-i/i#;第二步,由第一步的E->TG的第一个为非终结字符T,可进行对产生式T->FS 分析,此时第一个仍为非终结字符F,所以不输出分析串,分析字符仍为i, 剩余字符i+i*i-i/i#;第三步,使用产生式F->i,此时的分析串为i,,分析字符为i,匹配成功,剩余字符串+i*i-i/i#;第四步,因为使用了产生式T->FS,F->i,第一个字符i匹配成功,接着分析字符+,使用产生式S->ε,进行下步;第五步,使用产生式G->+TG,此时的分析串包含i+,分析字符为+,剩余字符串+i*i-i/i#;第六步,重复对产生式T->FS,F->i的使用,对第二个i进行匹配,此时分析串i+i,分析字符为i,剩余串*i-i/i#;第七步,分析字符*,使用产生式S->*FS, 分析串i+i*,剩余串i-i/i#;第八步,字符*匹配成功后,使用产生式F->i,匹配第三个字符i,,此时剩余串-i/i#;第九步,分析字符-,只有产生式G->-TG可以产生字符-。
实验二 递归下降分析法的实现
实验二递归下降分析法的实现一、实验目的实现一个递归下降语法分析程序,识别用户输入的算术表达式。
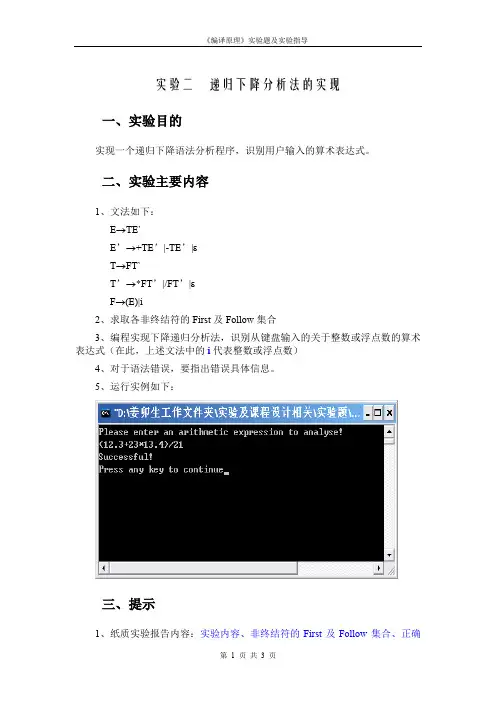
二、实验主要内容1、文法如下:E→TE`E’→+TE’|-TE’|εT→FT`T’→*FT’|/FT’|εF→(E)|i2、求取各非终结符的First及Follow集合3、编程实现下降递归分析法,识别从键盘输入的关于整数或浮点数的算术表达式(在此,上述文法中的i代表整数或浮点数)4、对于语法错误,要指出错误具体信息。
5、运行实例如下:三、提示1、纸质实验报告内容:实验内容、非终结符的First及Follow集合、正确表达式与错误表达式各举一例进行测试并给出结果、核心源代码。
2、将本次实验代码(.c、.cpp、.java等代码文件,删除编译产生的所有其他文件,不要打包)在规定时间内以作业附件(不可在线编辑、粘贴代码)的形式提交至网站,自己保存以备课程设计(本部有毕业设计要求的学生)参考。
3、纸质实验报告提交时间:临时要求。
实验指导(参考)一、实验步骤1、求取各非终结符的First及Follow集合;2、设计几个函数E(); Ep(); T(); Tp(); F();运用First集合进行递归函数选择,运用Follow集合进行出错情况判断;3、设计主函数:从键盘接受一个算术表达式串;在串尾添加尾部标志’#’;调用函数E()进行递归下降分析。
二、如何识别整数与浮点数在函数F()中要涉及到如何识别整数与浮点数。
识别的方法是:只要碰到‘0’~‘9’之间的字符就一直循环,循环到不是数字字符与小数点字符’.’为止,其间要运用一个标志变量来保证最多只能出现一个小数点,否则应该报错。
上述循环结束即表示识别了一个数,也即表达式文法中的i。
编译原理实验语法器递归下降子程序实现解析
编译原理程序设计实验报告——表达式语法分析器的设计班级:计算机1306班姓名:张涛学号:20133967 实验目标:用递归下降子程序设计实现表达式语法分析器实验内容:⑴概要设计:通过对实验一的此法分析器的程序稍加改造,使其能够输出正确的表达式的token序列。
然后利用LL(1)分析法实现语法分析。
⑵数据结构:int op=0; //当前判断进度char ch; //当前字符char nowword[10]=""; //当前单词char operate[4]={'+','-','*','/'}; //运算符char bound[2]={'(',')'}; //界符struct Token{int code;char ch[10];}; //Token定义struct Token tokenlist[50]; //Token数组struct Token tokentemp; //临时Token变量⑶流程图:⑷关键函数:int IsLetter(char ch) //判断ch是否为字母int IsDigit(char ch) //判断ch是否为数字int Iskey(char *string) //判断是否为关键字int Isbound(char ch) //判断是否为界符int Isboundnum(char ch) //给出界符所在token值void T(); //分析子程序void F(); //分析子程序void E1(); //分析子程序void E(); //分析子程序void T1(); //分析子程序源程序代码:(加入注释)#include<stdio.h>#include<string.h>#include<ctype.h>#include<windows.h>int op=0; //当前判断进度char ch; //当前字符char nowword[10]=""; //当前单词char operate[4]={'+','-','*','/'};char bound[2]={'(',')'};struct Token{int code;char ch[10];};struct Token tokenlist[50];struct Token tokentemp;void T();void F();void E1();void E();void T1();int IsLetter(char ch) //判断ch是否为字母{int i;for(i=0;i<=45;i++)if ((ch>='a'&&ch<='z')||(ch>='A'&&ch<='Z'))return 1;return 0;}int IsDigit(char ch) //判断ch是否为数字{int i;for(i=0;i<=10;i++)if (ch>='0'&&ch<='9')return 1;return 0;}int Isbound(char ch){int i;for(i=0;i<2;i++){if(ch==bound[i]){return i+1;}}return 0;}int Isoperate(char ch){int i;for(i=0;i<4;i++){if(ch==operate[i]){return i+3;}}return 0;}int main(){FILE *fp;int q=0,m=0;char sour[200]=" ";printf("请将源文件置于以下位置并按以下方式命名:F:\\2.txt\n");if((fp=fopen("F:\\2.txt","r"))==NULL){printf("文件未找到!\n");}else{while(!feof(fp)){if(isspace(ch=fgetc(fp)));else{sour[q]=ch;q++;}}}int p=0;printf("输入句子为:\n");for(p;p<=q;p++){printf("%c",sour[p]);}printf("\n");int state=0,nowlen=0;BOOLEAN OK=TRUE,ERR=FALSE;int i,flagpoint=0;for(i=0;i<q;i++){switch(state){case 0:ch=sour[i];if(Isbound(ch)){if(ERR){printf("无法识别\n");ERR=FALSE;OK=TRUE;}else if(!OK){printf("<10,%s>标识符\n",nowword);tokentemp.code=10;tokentemp.ch[10]=nowword[10];tokenlist[m]=tokentemp;m++;OK=TRUE;}state=4;}else if(IsDigit(ch)){if(OK){memset(nowword,0,strlen(nowword));nowlen=0;nowword[nowlen]=ch;nowlen++;state=3;OK=FALSE;break;}else{nowword[nowlen]=ch;nowlen++;}}else if(IsLetter(ch)){if(OK){memset(nowword,0,strlen(nowword));nowlen=0;nowword[nowlen]=ch;nowlen++;OK=FALSE;if(sour[i+1]=='#'){printf("<10,%s>标识符\n",nowword);struct Token tokentemp;tokentemp.code=10;int i=0;for(i;i<=nowlen;i++)tokentemp.ch[i]=nowword[i];tokenlist[m]=tokentemp;}}else{nowword[nowlen]=ch;nowlen++;}}else if(Isoperate(ch)){if(!OK){printf("<10,%s>标识符\n",nowword);tokentemp.code=10;tokentemp.ch[10]=nowword[10];tokenlist[m]=tokentemp;m++;OK=TRUE;}printf("<%d,%c>运算符\n",Isoperate(ch),ch);tokentemp.code=Isoperate(ch);tokentemp.ch[10]=ch;tokenlist[m]=tokentemp;m++;}break;case 3:if(IsLetter(ch)){printf("错误\n");nowword[nowlen]=ch;nowlen++;ERR=FALSE;state=0;break;}if(IsDigit(ch=sour[i])){nowword[nowlen]=ch;nowlen++;}else if(sour[i]=='.'&&flagpoint==0){flagpoint=1;nowword[nowlen]=ch;nowlen++;}else{printf("<20,%s>数字\n",nowword);i--;state=0;OK=TRUE;tokentemp.code=20;tokentemp.ch[10]=nowword[10];tokenlist[m]=tokentemp;m++;}break;case 4:i--;printf("<%d,%c>界符\n",Isbound(ch),ch);tokentemp.code=Isbound(ch);tokentemp.ch[10]=ch;tokenlist[m]=tokentemp;m++;state=0;OK=TRUE;break;}}int io=0;for(io;io<=m;io++){printf("tokenlist%d.code值为%d\n",io,tokenlist[io].code);}E();if(op==m)printf("OK!!!");elseprintf("WRONG!!!");return 0;}void E(){T();E1();}void E1(){if(tokenlist[op].code==3||tokenlist[op].code==4){tokenlist[op++];T();E1();}}void T1(){if(tokenlist[op].code==5||tokenlist[op].code==6){tokenlist[op++];F();T1();}}void T(){F();T1();}void F(){if(tokenlist[op].code==10||tokenlist[op].code==20) {tokenlist[op++];}else{if(tokenlist[op].code==1){tokenlist[op++];E();if(tokenlist[op].code==2){tokenlist[op++];}else{printf("WRONG!!!!!!");//exit(1);}}else{printf("WRONG!!!!!!");//exit(1);}}}程序运行结果:(截屏)输入:((Aa+Bb)*(88.2/3))#注:如需运行请将文件放置F盘,并命名为:2.txt 输出:思考问题回答:在递归下降子程序中要注意对于错误情况的处理,以防程序无限循环,无法结束。
编译原理实验报告:实验二编写递归下降语法分析程序

编译原理实验报告实验名称:实验二编写递归下降语法分析器实验类型:验证型实验指导教师:何中胜专业班级:13软件四姓名:丁越学号:13030504电子邮箱:862245792@实验地点:秋白楼B720实验成绩:日期:2016年4 月1 日一、实验目的通过设计、编制、调试一个递归下降语法分析程序,实现对词法分析程序所提供的单词序列进行语法检查和结构分析,掌握常用的语法分析方法。
通过本实验,应达到以下目标:1、掌握从源程序文件中读取有效字符的方法和产生源程序的内部表示文件的方法。
2、掌握词法分析的实现方法。
3、上机调试编出的语法分析程序。
二、实验过程1、分析对象分析算术表达式的 BNF 定义如下:〈算术表达式〉→〈项〉|〈算术表达式〉+〈项〉|〈算术表达式〉-〈项〉〈项〉→〈因式〉|〈项〉*〈因式〉|〈项〉/〈因式〉〈因式〉→〈变量〉│(〈算术表达式〉)〈变量〉→i用符号表示如下:E→T|E+T|E-TT→F|T*F|T/FF→i│(E)递归下降分析程序实现思想简单易懂。
程序结构和语法产生式有直接的对应关系。
因为每个过程表示一个非终结符号的处理,添加语义加工工作比较方便。
递归下降分析程序的实现思想是:识别程序由一组子程序组成。
每个子程序对应于一个非终结符号。
每一个子程序的功能是:选择正确的右部,扫描完相应的字。
在右部中有非终结符号时,调用该非终结符号对应的子程序来完成。
自上向下分析过程中,如果带回溯,则分析过程是穷举所有可能的推导,看是否能推导出待检查的符号串。
分析速度慢。
而无回溯的自上向下分析技术,当选择某非终结符的产生时,可根据输入串的当前符号以及各产生式右部首符号而进行,效率高,且不易出错。
无回溯的自上向下分析技术可用的先决条件是:无左递归和无回溯。
无左递归:既没有直接左递归,也没有间接左递归。
无回溯:对于任一非终结符号 U 的产生式右部x1|x2|…|xn,其对应的字的首终结符号两两不相交。
2. 递归下降语法分析流程图实验分为五个模块,分别是:E( )函数,E1( )函数,T( )函数,T1( )函数,F( )函数。
编译原理语法分析递归下降子程序实验报告

编译原理语法分析递归下降子程序实验报告编译课程设计-递归下降语法分析课程名称编译原理设计题目递归下降语法分析一、设计目的通过设计、编制、调试一个具体的语法分析程序,加深对语法分析原理的理解,加深对语法及语义分析原理的理解,并实现对文法的判断,是算符优先文法的对其进行FirstVT集及LastVT集的分析,并对输入的字符串进行规约输出规约结果成功或失败。
二、设计内容及步骤内容:在C++ 6.0中编写程序代码实现语法分析功能,调试得到相应文法的判断结果:是算符优先或不是。
若是,则输出各非终结符的FirstVT与LastVT集的结果,还可进行字符串的规约,输出详细的规约步骤,程序自动判别规约成功与失败。
步骤:1.看书,找资料,了解语法分析器的工作过程与原理2.分析题目,列出基本的设计思路1定义栈,进栈,出栈函数○2栈为空时的处理○3构造函数判断文法是否是算符文法,算符优先文法○4构造FirstVT和LastVT函数对文法的非终结符进行分析○5是算符优先文法时,构造函数对其可以进行输入待规约○串,输出规约结果○6构造主函数,对过程进行分析3.上机实践编码,将设计的思路转换成C++语言编码,编译运行4.测试,输入不同的文法,观察运行结果详细的算法描述详细设计伪代码如下:首先要声明变量,然后定义各个函数1.void Initstack(charstack &s){//定义栈s.base=new charLode[20];s.top=-1; }2. void push(charstack&s,charLode w){//字符进栈s.top++;s.base[s.top].E=w.E;s.base[s.top].e=w.e;}3. void pop(charstack&s,charLode &w){//字符出栈w.E=s.base[s.top].E; 三、w.e=s.base[s.top].e;s.top--;}4. int IsEmpty(charstack s){//判断栈是否为空if(s.top==-1)return 1;else return 0;}5.int IsLetter(char ch){//判断是否为非终结符if(ch='A'&&ch= 'Z')return 1;else return 0;}6.int judge1(int n){ //judge1是判断是否是算符文法:若产生式中含有两个相继的非终结符则不是算符文法}7. void judge2(int n){//judge2是判断文法G是否为算符优先文法:若不是算符文法或若文法中含空字或终结符的优先级不唯一则不是算符优先文法8.int search1(char r[],int kk,char a){ //search1是查看存放终结符的数组r中是否含有重复的终结符}9.void createF(int n){ //createF函数是用F数组存放每个终结符与非终结符和组合,并且值每队的标志位为0;F数组是一个结构体}10.void search(charLode w){ //search函数是将在F数组中寻找到的终结符与非终结符对的标志位值为1 }分情况讨论://产生式的后选式的第一个字符就是终结符的情况//产生式的后选式的第一个字符是非终结符的情况11.void LastVT(int n){//求LastVT}12.void FirstVT(int n){//求FirstVT}13.void createYXB(int n){//构造优先表分情况讨论://优先级等于的情况,用1值表示等于}//优先级小于的情况,用2值表示小于//优先级大于的情况,用3值表示大于}14.int judge3(char s,char a){//judge3是用来返回在归约过程中两个非终结符相比较的值}15.void print(char s[],charSTR[][20],int q,int u,int ii,int k){//打印归约的过程}16. void process(char STR[][20],int ii){//对输入的字符串进行归约的过程}四、设计结果分两大类,四种不同的情况第一类情况:产生式的候选式以终结符开始候选式以终结符开始经过存在递归式的非终结符后再以终结符结束篇二:编译原理递归下降子程序北华航天工业学院《编译原理》课程实验报告课程实验题目:递归下降子程序实验作者所在系部:计算机科学与工程系作者所在专业:计算机科学与技术作者所在班级:xxxx作者学号:xxxxx_作者姓名:xxxx指导教师姓名:xxxxx完成时间:2011年3月28日一、实验目的通过本实验,了解递归下降预测分析的原理和过程以及可能存在的回溯问题,探讨解决方法,为预测分析表方法的学习奠定基础。
编译原理实验递归下降分析器的设计含源代码和运行结果
FIRST(exp)= FIRST(term)= FIRST(factor)={id, number, ( }
FIRST(texp)={ ε,+, - }
FIRST(Addop)={+, - }
FIRST(tterm)={ ε,*, / }
FIRST(mulop)={*, / }
由于分析的文件中可能出现非法字符,而一旦发现非法字符就无需再接着分析,所以在每次读取一个字符时调用islegal函数判断是否是合法字符,并返回0或1.
在main()函数中,while((lookahead=='\n'||lookahead==' ')&&lookahead!=EOF)ﻩfscanf(resource,"%c",&lookahead);
void match(chart)//写入result文件,打印输出,并读取下一个
{
fprintf(result,"%c",lookahead);//向result写入
printf("%c",lookahead);
fscanf(resource,"%c",&lookahead);//读数据
}
number()//识别数字,如果遇到数字就一直接着读直到不是数字
{
while('0'<=lookahead&&lookahead<='9')
ﻩ{
ﻩfprintf(result,"%c",lookahead);//写入
printf("%c",lookahead);
编译原理之递归下降语法分析程序(实验)
编译原理之递归下降语法分析程序(实验)⼀、实验⽬的利⽤C语⾔编制递归下降分析程序,并对简单语⾔进⾏语法分析。
编制⼀个递归下降分析程序,实现对词法分析程序所提供的单词序列的语法检查和结构分析。
⼆、实验原理每个⾮终结符都对应⼀个⼦程序。
该⼦程序根据下⼀个输⼊符号(SELECT集)来确定按照哪⼀个产⽣式进⾏处理,再根据该产⽣式的右端:每遇到⼀个终结符,则判断当前读⼊的单词是否与该终结符相匹配,若匹配,再读取下⼀个单词继续分析;不匹配,则进⾏出错处理每遇到⼀个⾮终结符,则调⽤相应的⼦程序三、实验要求说明输⼊单词串,以“#”结束,如果是⽂法正确的句⼦,则输出成功信息,打印“success”,否则输出“error”,并指出语法错误的类型及位置。
例如:输⼊begin a:=9;b:=2;c:=a+b;b:=a+c end #输出success输⼊a:=9;b:=2;c:=a+b;b:=a+c end #输出‘end' error四、实验步骤1.待分析的语⾔的语法(参考P90)2.将其改为⽂法表⽰,⾄少包含–语句–条件–表达式E -> E+T | TT -> T*F | FF -> (E) | i3. 消除其左递归E -> TE'E' -> +TE' | εT -> FT'T' -> *FT' | εF -> (E) | i4. 提取公共左因⼦5. SELECT集计算SELECT(E->TE) =FIRST(TE')=FIRSI(T)-FIRST(F)U{*}={(, i, *}SELECT(E'->+TE')=FIRST(+TE')={+}SELECT(E'->ε)=follow(E')=follow(E)={#, )}SELECT(T -> FT')=FRIST(FT')=FIRST(F)={(, i}SELECT(T'->*FT')=FRIST(*FT')={*}SELECT(T'->ε)=follow(T')=follow(T)={#, ), +}SELECT(F->(E))=FRIST((E)) ={(}SELECT(F->i)=FRIST(i) ={i}6. LL(1)⽂法判断 其中SELECT(E'->+TE')与SELECT(E'->ε)互不相交,SELECT(T'->*FT')与SELECT(T'->ε)互不相交,SELECT(F->(E))与SELECT(F->i)互不相交,故原⽂法为LL(1)⽂法。
编译原理---递归下降分析法
编译原理---递归下降分析法所谓递归下降法 (recursive descent method),是指对⽂法的每⼀⾮终结符号,都根据相应产⽣式各候选式的结构,为其编写⼀个⼦程序 (或函数),⽤来识别该⾮终结符号所表⽰的语法范畴。
例如,对于产⽣式E′→+TE′,可写出相应的⼦程序如下:exprprime( ){if (match (PLUS)){advance( );term( );exprprime( );}}其中:函数match()的功能是,以其实参与当前正扫视的符号 (单词)进⾏匹配,若成功则回送true,否则回送false;函数advance()是⼀个读单词⼦程序,其功能是从输⼊单词串中读取下⼀个单词,并将它赋给变量Lookahead;term则是与⾮终结符号T相对应的⼦程序。
诸如上述这类⼦程序的全体,便组成了所需的⾃顶向下的语法分析程序。
应当指出,由于⼀个语⾔的各个语法范畴 (⾮终结符号)常常是按某种递归⽅式来定义的,此种特点也就决定了这组⼦程序必然以相互递归的⽅式进⾏调⽤,因此,在实现递归下降分析法时,应使⽤⽀持递归调⽤的语⾔来编写程序。
所以,通常也将上述⽅法称为递归⼦程序法。
例4 2对于如下的⽂法G[statements]:statements→expression; statements |εexpression→term expression′expression′→+term expression′ |εterm→factor term′term′→*factor term′ |εfactor→numorid | (expression)通过对其中各⾮终结符号求出相应的FIRST集和FOLLOW集 (计算FIRST集和FOLLOW集的⽅法后⾯再做介绍),可以验证,此⽂法为⼀LL(1)⽂法,故可写出递归下降语法分析程序如程序41所⽰(其中,在⽂件lex.h⾥,将分号、加号、乘号、左括号、右括号、输⼊结束符及运算对象分别命名为SEMI,PLUS,TIMES,LP,RP,EOI及NUMORID,并指定了它们的内部码;此外,还对外部变量yytext,yyleng及yylineno进⾏了说明)。
编译原理实验报告二递归下降语法分析程序 (1)
编译原理实验报告实验名称:编写递归下降语法分析程序实验类型:验证型实验指导教师:专业班级:姓名:学号:电子邮件:实验地点:实验成绩:日期:201 年 5 月 25 日一、实验目的通过设计、调试递归下降语法分析程序,实现用词法分析从源程序中分出各种单词并对词法分析程序提供的单词序列进行语法检查和结构分析,熟悉并掌握常用的语法分析方法。
明确语法分析器的功能,在词法分析的基础上进一步分析程序;加深对课堂教学的理解;提高语法分析方法的实践能力;通过本实验,应达到以下目标:1、掌握递归下降的结构模型。
2、掌握语法分析的实现方法。
3、上机调试编出的语法分析程序。
二、实验过程有了第一次的经验,这次还是先画出流程图。
流程图如下:三、实验结果语法分析实验成功。
赋值时少写数字:缺少括号时:附(txt文档内容):程序运行后写入的:四、讨论与分析这个程序是在实验一的基础上写的,用的递归下降的方法。
不止能识别,还能判断一些语法的正误。
刚看书上附录的代码时,头都大了,觉得自己完成不了。
但是真正一步一步看下去,画出了流程图,就很清晰明白了。
一个函数嵌套一个函数,一步一步往细处走,刚开始是大体轮廓,然后就深入,直到最低层的判断。
书上的程序还是有一些漏洞,比如要写多个语句时,if,for,while在语句内不能加括号,不然只能分析至第一个,遇到“}”就结束了,所以在txt文件里写程序代码的时候要注意不能加{},这样才可以全部printf出来。
五、附录:关键代码(给出适当注释,可读性高)全部代码附vc++,这里粘贴主程序,以及各类函数。
int TESTparse();int TESTscan();int program();int compound_stat();int statement();int expression_stat();int expression();int bool_expr();int additive_expr();int term();int factor();int if_stat();int while_stat();int for_stat();int write_stat();int read_stat();int declaration_stat();int declaration_list();int statement_list();int compound_stat();#include<stdio.h>#include<ctype.h>int TESTscan();int TESTparse();FILE *fin,*fout;void main(){int es=0;es=TESTscan();if(es>0)printf("词法分析有错!编译停止!\n");else{printf("词法分析成功!\n");}if(es==0){es=TESTparse();if(es==0)printf("语法分析成功!\n");elseprintf("语法分析错误!\n");}}六、实验者自评这个实验比第一个有难度,是在第一个完成的基础上进行的。