
AMOS做验证性因子分析报告材料
实用标准文案
精彩文档
Amos模型设定操作
在使用AMOS进行模型设定之前,建议事先在纸上绘制出基本理论模型和变量影响关系路径图,
并确定潜变量与可测变量的名称,以避免不必要的返工。
1. 绘制潜变量
使用建模区域绘制模型中的潜变量,在潜变量上点击右键选择Object Properties,为潜变量
命名。
2. 为潜变量设置可测变量及相应的残差变量
使用绘制。在可测变量上点击右键选择Object Properties为可测变量命名。其中Variable
Name对应的是数据的变量名,在残差变量上右键选择Object Properties为残差变量命名。
实用标准文案
精彩文档
3. 配置数据文件,读入数据
File——Data Files——File Name——OK。
4. 模型拟合
View——Analysis Properties——Estimation——Maximum Likelihood。
5. 标准化系数
实用标准文案
精彩文档
Analysis Properties——Output——Standardized Estimates——因子载荷标准化系数。
6. 参数估计结果
Analyze——Calculate Estimates。红色框架部分是模型运算基本结果信息,点击View the
Output Path Diagram查看参数估计结果图。
7. 模型评价
点击查看AMOS路径系数或载荷系数以及拟合指标评价。
路径系数/载荷系数的显著性
模型评价首先需要对路径系数或载荷系数进行统计显著性检验。
实用标准文案
精彩文档
模型拟合指数
模型拟合指数是考察理论结构模型对数据拟合程度的统计指标。拟合指数的作用是考察理论模型
与数据的适配程度,并不能作为判断模型是否成立的唯一依据。拟合优度高的模型只能作为参考,还
需要根据所研究问题的背景知识进行模型合理性讨论。
指数名称 评价标准1
绝对拟合指数
2
(卡方) 越小越好
GFI 大于0.9
RMR 、SRMR、 RMSEA 小于0.05,越小越好
相对拟合指数 NFI 、TLI、CFI 大于0.9,越接近1越好
信息指数 AIC、 CAIC 越小越好
结构方程模型与AMOS使用
二、路径分析的数学模型
x
y1
y2
变量之间的关系:直接、间接、全部(直接和间接) 模型中的变量: 有的变量不受模型内任何变量的影响,只影响其他变量 有的变量既受其它变量影响,又影响其它变量
02
非递归式模型:
A B:A可能影响B,B也可能影响A
独立变量与非独立变量之间的关系,回归系数用 表示(只有箭头出)。 非独立变量之间的关系,回归系数用 表示(箭头有进,或有进有出)。
11
21
x1
31
21
31
32
y1
y2
y3
2
1
3
11
21
x1
2. 变量之间的关系分为两类
i,ij和j是待估的回归系数 i 是残差,表示了变量 yi 的随机误差或模型外的其它变量对 yi 的总体影响。
要求可测变量为连续变量且服从多元正态分布。在大样本(n>200)情况下,该估计的分布近似正态分布。 该估计不受量纲影响。
(2)广义最小二乘法
要求可测变量服从正态分布 大样本情况下,与最大似然估计法的结果很接近。 不受量纲影响
(3)非加权最小二乘法
不要求可测变量总体服从正态分布。 试图使∑中的每个元素与S中对应的元素差距最小。 受量纲影响 不能对参数进行假设检验
假设条件
三、验证性因子分析模型的 基本要素
01.
因子载荷矩阵;
添加标题
02.
潜在变量之间的方差协方差矩阵;
添加标题
03.
误差项的方差协方差矩阵
添加标题
验证性因子分析

k
k
k
12
模型拟合优度检验
n n 1 ln( LF ) [ln S tr( SS )] [ln S p] 2 2
n ln( LR ) ln tr S 1 2
H0: Reduced model is indifferent from full model Ha: two models are significantly different Set α=0.2
11
模型的评价
• 一个好的模型就是参数的估计值使得模型隐含的方差协方 差矩阵 (k ) 与样本导出的方差协方差矩阵S充分地接近, 或满足事先给定的标准。 • 令F=F(S, ( ) ) • 它是一个非负函数。F=0,当且仅当S= ( ) ,即模型完全 拟合数据。F被称为拟合函数,它的具体公式取决于方法。 • 验证性因子分析的总体拟合优度的统计假设是: H0:S= ( ) ,即数据完全拟合。 H1:S ( ) ,即数据不完全拟合。
均方根
GFI拟合优度指数 不受样本大小影响, >0.95:good level (goodness of fit index) 可用于不同模型之 >0.90:acceptable level 间的比较。 AGFI 调整后拟合优 度指数 >0.90:good level >0.80:acceptable level
10
模型的参数估计
• 1、估计因子载荷
逐步迭代: k g (k ), k 1,2,... 直到 ( k ) 与S充分的接近。 最后得到的估计为模型的一个非标准参数估计
• 2、 计算标准因子载荷
标准因子载荷消除了纲量的影响,可以用来比较指标对潜在因 子的相对重要性。绝对值越大,指标对潜在因子的贡献越大。 1) 令每个因子的方差为1; 2) 将每个因子与因子载荷在之上的变量间的λ值任选一个, 并固定为1
AMOS输出解读汇报和分析报告
AMOS输出解读惠顿研究惠顿数据文件在各种结构方程模型中被当作经典案例,包括AMOS和LISREL。
本文以惠顿的社会疏离感追踪研究为例详细解释AMOS的输出结果。
AMOS同样能处理与时间有关的自相关回归。
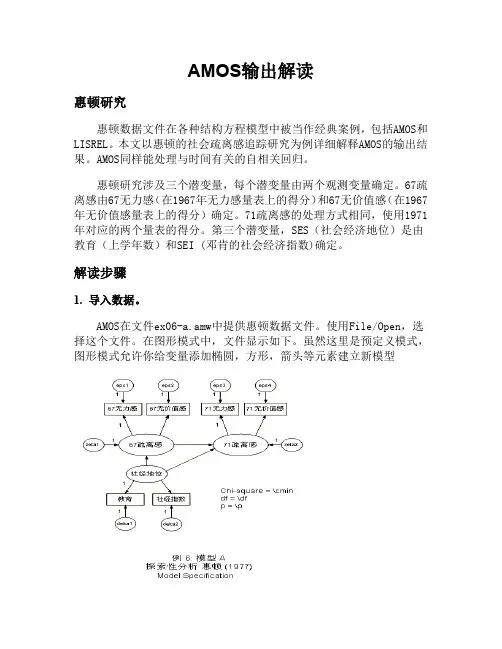
惠顿研究涉及三个潜变量,每个潜变量由两个观测变量确定。
67疏离感由67无力感(在1967年无力感量表上的得分)和67无价值感(在1967年无价值感量表上的得分)确定。
71疏离感的处理方式相同,使用1971年对应的两个量表的得分。
第三个潜变量,SES(社会经济地位)是由教育(上学年数)和SEI (邓肯的社会经济指数)确定。
解读步骤1.导入数据。
AMOS在文件ex06-a.amw中提供惠顿数据文件。
使用File/Open,选择这个文件。
在图形模式中,文件显示如下。
虽然这里是预定义模式,图形模式允许你给变量添加椭圆,方形,箭头等元素建立新模型2.模型识别。
潜变量的方差和与它关联的回归系数取决于变量的测量单位,但刚开始谁知道呢。
比如说要估计误差的回归系数同时也估计误差的方差,就好像说“我买了10块钱的黄瓜,然后你就推测有几根黄瓜,每根黄瓜多少钱”,这是不可能实现的,因为没有足够的信息。
如何告诉你“我买了10块钱的黄瓜,有5根”,你便可以推出每根黄瓜2块钱。
对潜变量,必须给它们指定一个数值,要么是与潜变量有关的回归系数,要么是它的方差。
对误差项的处理也是一样。
一旦做完这些处理,其它系数在模型中就可以被估计。
在这里我们把与误差项关联的路径设为1,再从潜变量指向观测变量的路径中选一条把它设为1。
这样就给每个潜变量设置了测量尺度,如果没有这个测量尺度,模型是不确定的。
有了这些约束,模型就可以识别了。
注释:设置的数值可以是1,也可以是其它数,这些数对回归系数没有影响,但对误差有影响,在标准化的情况下,误差项的路径系数平方等于它的测量方差。
3.解释模型。
模型设置完毕后,在图形模式中点击工具栏中计算估计按钮运行分析。
AMOS输出解读汇报和分析报告
AMOS输出解读惠顿研究惠顿数据文件在各种结构方程模型中被当作经典案例,包括AMOS和LISREL。
本文以惠顿的社会疏离感追踪研究为例详细解释AMOS的输出结果。
AMOS同样能处理与时间有关的自相关回归。
惠顿研究涉及三个潜变量,每个潜变量由两个观测变量确定。
67疏离感由67无力感(在1967年无力感量表上的得分)和67无价值感(在1967年无价值感量表上的得分)确定。
71疏离感的处理方式相同,使用1971年对应的两个量表的得分。
第三个潜变量,SES(社会经济地位)是由教育(上学年数)和SEI (邓肯的社会经济指数)确定。
解读步骤1.导入数据。
AMOS在文件ex06-a.amw中提供惠顿数据文件。
使用File/Open,选择这个文件。
在图形模式中,文件显示如下。
虽然这里是预定义模式,图形模式允许你给变量添加椭圆,方形,箭头等元素建立新模型2.模型识别。
潜变量的方差和与它关联的回归系数取决于变量的测量单位,但刚开始谁知道呢。
比如说要估计误差的回归系数同时也估计误差的方差,就好像说“我买了10块钱的黄瓜,然后你就推测有几根黄瓜,每根黄瓜多少钱”,这是不可能实现的,因为没有足够的信息。
如何告诉你“我买了10块钱的黄瓜,有5根”,你便可以推出每根黄瓜2块钱。
对潜变量,必须给它们指定一个数值,要么是与潜变量有关的回归系数,要么是它的方差。
对误差项的处理也是一样。
一旦做完这些处理,其它系数在模型中就可以被估计。
在这里我们把与误差项关联的路径设为1,再从潜变量指向观测变量的路径中选一条把它设为1。
这样就给每个潜变量设置了测量尺度,如果没有这个测量尺度,模型是不确定的。
有了这些约束,模型就可以识别了。
注释:设置的数值可以是1,也可以是其它数,这些数对回归系数没有影响,但对误差有影响,在标准化的情况下,误差项的路径系数平方等于它的测量方差。
3.解释模型。
模型设置完毕后,在图形模式中点击工具栏中计算估计按钮运行分析。
验证性因素分析范文
验证性因素分析范文验证性因素分析是一种统计分析方法,主要用于评估和验证一个已经建立的理论模型是否与实际数据相吻合。
它基于因子分析的基本原理,并且通过拟合度指标和参数估计等统计量来评估模型拟合好坏,从而判断模型是否有效。
验证性因素分析常用于心理学、社会科学、市场研究等领域,用于测量和验证潜在的观测变量之间的关系。
其基本步骤包括:确定研究目的、建立理论模型、选择合适的变量、采集数据、运行验证性因素分析模型以及分析结果。
在进行验证性因素分析之前,需要明确研究目的和假设。
研究目的通常是通过数据分析验证或者修正一个已经建立的理论模型。
在建立模型时,需要定义潜在的观测变量以及它们之间的关系,形成一系列假设。
根据这些假设,选择适当的测量工具和样本进行数据采集。
数据采集完成后,可以运行验证性因素分析模型。
这里常用的模型包括结构方程模型(SEM)和对应分析模型(CFA)。
这些模型可以通过最大似然估计法来估计参数。
通过分析结果,可以得到各个观测变量的测量值以及它们对应的因子负荷量。
同时通过拟合度指标如卡方统计量、均方根误差逼近度(RMSEA)、标准化均方差残差(χ2/df)等对模型进行评估。
除了拟合度指标,还可以通过参数估计来评估模型拟合的好坏。
参数估计包括路径系数、因子间相关系数、因子负荷量以及测量误差。
通常认为,路径系数和因子间相关系数应该显著不为零,而因子负荷量应该大于0.4、此外,还可以通过测量误差的估计来检验观测变量的可靠性。
最后,根据验证性因素分析的结果,可以得到一系列结论。
如果拟合度较好,那么可以认为建立的理论模型与实际数据较好符合,模型是有效的。
如果拟合度较差,就需要对模型进行修改和改进,以更好地与实际数据相吻合。
总之,验证性因素分析是一种重要的数据分析方法,它可以用于评估和验证一个已经建立的理论模型是否与实际数据相吻合。
通过分析结果,可以得到各个观测变量的测量值以及它们对应的因子负荷量,以及拟合度指标和参数估计等统计量,从而判断模型是否有效。
AMOS使用指南

文档
AMOS手册是由James Arbuckle 和 Werner Wothke撰写的AMOS 4.0 User's Guide 。包含20多个例子,有许多调查得 到的典型模型。这些样本数据的例子在学生版和商业版的AMOS中都有,所以能容易地在AMOS中拟合,修改描述模 型。
AMOS 4.0 User's Guide 手册在UT Austin 的职员,学生,教师经检验合格后在 PCL 获得。也可以直接从Smallwaters Corporation Web site网站定购。 Barbara Byrne 也写了一本使用AMOS的书。 书名是《AMOS的SEM:基本概念,应 用和编程》。这本书由Lawrence Erlbaum Associates, Inc出版。 Lawrence Erlbaum Associates有限公司也出版SEM杂 志(季刊)。杂志包含软件回顾,经验文章,理论文章以及教师部分和书评。
相反,我们声称 F1 引起测量变量I1 和 I2上的观测得分。因果效应在路径图中由单箭头表示。F1 和 F2 被两个指示因 子共享的方差概念化(例如,两个指示因子共有什么。)至今为止正如所猜测的那样, F1 和 F2 是潜因子; I1 到I4 是观 测变量。也许它们是调查项。E1 到 E4 是I1到 I4中引起响应方差的残差或误差方差 。路径图告诉我们1到4的得分或调 查响应项是由两个相关因子及每项的唯一方差引起的。部分唯一方差或许是由于测量误差。
AMOS
结构方程模型——测量模型的检验与修订
CFA——验证性因子分析
工具:AMOS
6
结构方程模型Leabharlann —测量模型的检验与修订CFA——验证性因子分析
工具:AMOS
绘制模型
7
结构方程模型——测量模型的检验与修订
CFA——验证性因子分析
潜变量+观测变量+误差
选择数据文件
观测变量 潜变量 绘制路径 相关关系 增加误差变量
观察变量—→问卷或量表中的题目 潜在变量—→无法直接测量,可以通过多个题目表示的变量 误差变量—→用显变量解释潜变量时出现的误差,不可实际测量,在模型中反反 映为误差变量
一个完整的结构方程模型包括两个方面:测量模型(观察变量和潜在变量之间的 关系)和结构模型(潜在变量之间的关系)
2
结构方程模型
3
结构方程模型——研究步骤
[文献] 王辞晓, 张必兰, 王晶心. 网络教学接受度与教师TPACK水平
的相关研究[J]. 现代远距离教育, 2017(05):13-22.. [其他资源] 《结构方程模型:AMOS的操作与应用》作者:吴明隆
39 39
数据收集
结构模型 的验证与
修订
观念性 架构
测量模型 的检验与
修订
研究结论
基于理论和已有研 究提出潜在变量关 系的假设
因子分析:检验观察变量与潜在 变量之间的因果模型是否与观察 数据契合
29
结构方程模型——结构模型的验证与修订
路径分析
某人在研究成年人生活满意度时,将“薪资所得”、“身体健康”、“社会参 与”作为自变量,“家庭幸福”作为中介变量,“生活满意”为因变量,建立 生活满意度模型。 内因变量:生活满意、家庭幸福 外因变量:薪资所得、身体健康、社会参与、家庭幸福
因子分析实验报告范本
因子分析实验报告范本一、实验目的本次因子分析实验旨在探究多个变量之间的潜在结构关系,通过降维的方法提取出主要的公共因子,以更简洁、有效地解释数据中的信息。
二、实验数据来源及描述实验数据来源于_____调查,共收集了_____个样本,涉及_____个变量。
这些变量包括但不限于:1、变量 1:_____,用于衡量_____。
2、变量 2:_____,反映了_____。
3、变量 3:_____,其代表的含义是_____。
三、实验方法1、数据预处理对缺失值进行处理,采用_____方法进行填充。
对数据进行标准化处理,以消除量纲的影响。
2、因子提取方法选用主成分分析法提取公共因子。
根据特征根大于 1 的原则确定因子个数。
3、因子旋转方法采用方差最大化正交旋转,以使因子更具有可解释性。
四、实验步骤1、导入数据使用统计软件(如 SPSS)将数据文件导入。
2、数据预处理按照上述预处理方法进行操作。
3、因子分析在软件中选择因子分析模块,设置相应的参数进行分析。
4、结果解读观察公因子方差表,了解每个变量被公共因子解释的程度。
查看总方差解释表,确定提取的公共因子个数及解释的总方差比例。
分析旋转后的成分矩阵,解读公共因子的含义。
五、实验结果1、公因子方差变量 1 的公因子方差为_____,表明公共因子能够解释其_____%的方差。
变量 2 的公因子方差为_____,意味着公共因子对其的解释程度为_____%。
2、总方差解释提取了_____个公共因子,其特征根分别为_____、_____、_____。
这_____个公共因子累计解释了总方差的_____%。
3、旋转后的成分矩阵公共因子 1 在变量 1、变量 2 上有较高的载荷,分别为_____、_____,可以将其解释为_____因素。
公共因子 2 在变量 3、变量 4 上的载荷较大,分别为_____、_____,代表了_____方面。
六、结果讨论1、因子的可解释性提取的公共因子在实际意义上具有一定的合理性和可解释性,能够较好地概括原始变量所包含的信息。
SPSS验证性因子怎么做?附案例讲解一文搞懂
验证性因子分析1、作用验证性因子分析(confirmatory factor analysis, CFA)是用于测试一个因子与相对应的测度项之间的关系是否符合研究者所设计的理论关系的一种研究方法,可用于调查问卷的量表分析。
2、输入输出描述输入:至少两项或以上的定量变量或有序的定类变量。
输出:测量因子与变量之间的对应关系是否符合研究者所设计的理论关系。
3、案例示例案例:理科班的 100 名同学的语文、数学、英语、物理、生物、化学成绩,然后研究者想要验证他们的语文、英语成绩是否可以反映理科班的文科成绩水平,他们的数学、物理、生物、化学成绩是否可以反映理科班的理科成绩水平。
4、案例数据验证性因子分析案例数据模型要求为至少两项或以上的定量变量或有序的定类变量,其中数学、物理、化学、生物为一个因子,语文和英语为一个因子。
5、案例操作Step1:新建分析;Step2:上传数据;Step3:选择对应数据打开后进行预览,确认无误后点击开始分析;Step4:选择【验证性因子分析】;Step5:查看对应的数据数据格式,【验证性因子分析】要求特征序列至少两项或以上的定量变量或有序的定类变量。
在因子 1 拖入需验证的变量。
Step6:当涉及到多个因子时,点击【创建因子】.Step7:在因子 2 拖入需验证的变量。
Step8: 点击【开始分析】,完成全部操作6、输出结果分析输出结果 1:因子基本汇总表图表说明: 上表展示了样本频数的统计情况,包括样本中各个因子的字段频数、总计、总样本频数,CFA分析要求总样本数据最少要是因子内个别量表的5倍以上,且一般情况下至少需要200个样本。
结果分析:样本数据集共有因子数量 2 个,变量数 6 个,样本数 200 满足验证性因子分析基本数据要求。
输出结果 2:因子载荷系数表图表说明:上表为模型的因子载荷系数表格,包括潜变量、分析项、非标准载荷系数、z检验结果等。
测量关系时第一项会被作为参照项,因此不会呈现P值等统计量。
因子分析资料报告实验资料报告材料
电子科技大学政治与公共管理学院本科教学实验报告(实验)课程名称:数据分析技术系列实验电子科技大学教务处制表电子科技大学实验报告学生:晨飞学号:27指导教师:高天鹏一、实验室名称:电子政务可视化实验室二、实验项目名称:因子分析三、实验原理使用SPSS软件的因子分析对数据样本进行分析相关分析的原理:步骤一:将原始数据标准化。
因子分析的第一步是主成分分析,将总量较多的因素通过线性组合的方式组合成几个因素,且这些因素之间相互独立。
步骤二:建立变量的相关系数矩阵RAnalyse->Dimention Ruduction-> Fctor ->Extraction->勾选Correlation matrix 可以输出相关系数矩阵,相关系数矩阵计算了变量之间两两的pearson相关系数。
步骤三:适用性检验使用Bartlett球形检验或者KMO球形检验来检验样本是否适合进行因子分析。
评价标准:KMO检验用于检验变量间的偏相关系数是否过小,一般情况下,当KMO大于0.9时效果最佳,小于0.5时不适宜做因子分析。
Bartlett球形检验用于检验相关系数矩阵是否是单位阵,如果结论是不拒绝该假设,则表示各个变量都是各自独立的。
步骤四:根据因子贡献率选取因子,特征值和特征向量构建因子载荷矩阵A。
处于简化和抽取核心的思想,一般会按照某种标准选取前几个对观测结果影响较大的因素构建因子载荷矩阵,一般的标准是选取特征根大于1的因子。
并要求累积贡献率达到90%以上。
步骤五:对A进行因子旋转因子旋转的目的是使因子载荷矩阵的结构发生变化,使每个变量仅在一个因子上有较大载荷。
是将因子矩阵在一个空间里投影,使单个向量的投影在仅在一个变量的方向有较大的值,这样做可以简化分析。
步骤六:计算因子得分:计算因子得分是计算在不同样本水平下观测指标的水平的方式。
计算因子得分需要用到因子得分计算函数,这个计算的结果是无量纲的,仅表示各因子在这个水平下观测指标的值,这也是因子分析的目标,将不可观测的目标观测量用一个函数与可以观测的变量联系起来。