
R语言函数——精选推荐
R语⾔函数
函数是⼀个组织在⼀起的⼀组以执⾏特定任务的语句。R语⾔有⼤量的内置函数,⽤户也可以创建⾃⼰的函数。
在R语⾔中的函数是⼀个对象,所以R语⾔解释器为能够通过控制到该函数,带有参数可能是函数必要完成的操作。
反过来函数执⾏其任务,并将控制返回到其可以被存储在其它的⽬的解释器以及任何结果。
函数定义
R函数是通过使⽤关键字 function 来创建。R函数的定义基本语法如下:
function_name <- function(arg_1, arg_2, ...) {
Function body
}
函数组件函数的不同部分是:
函数名称: 这是函数的实际名称。它被存⼊R环境作为⼀个对象使⽤此名称。
参数: 参数是⼀个占位符。当调⽤⼀个函数,传递⼀个值到参数。参数是可选的; 也就是说,⼀个函数可以含有任何参数。此外参数可以有默认值。
函数体: 函数体包含定义函数是使⽤来做什么的语句集合。
返回值: ⼀个函数的返回值是在函数体中评估计算最后⼀个表达式的值。
⽰例
R具有许多内置函数可直接在程序中调⽤⽽不先定义它们。我们也可以创建和使⽤称为⽤户⾃定义函数,如那些我们⾃⼰定义的函数。
内置函数
内建函数的简单例⼦如:seq(), mean(), max(), sum(x) 和 paste(...) 等等. 它们被直接由⽤户编写的程序调⽤。可以参考最⼴泛⽤ 。
# Create a sequence of numbers from 32 to 44.
print(seq(32,44))
# Find mean of numbers from 25 to 82.
print(mean(25:82))
# Find sum of numbers frm 41 to 68.
print(sum(41:68))
当我们上⾯的代码执⾏时,它产⽣以下结果:
[1] 32 33 34 35 36 37 38 39 40 41 42 43 44
[1] 53.5
[1] 1526
⽤户定义函数
我们可以在R语⾔中创建⽤户定义的函数,它们是特定于⽤户想要实现什么功能,⼀旦创建了它们可以像内置函数⼀样使⽤。下⾯是函数如
何创建和使⽤的⼀个例⼦。
# Create a function to print squares of numbers in sequence.
new.function <- function(a) {
for(i in 1:a) {
b <- i^2
print(b)
}
}
调⽤函数
# Create a function to print squares of numbers in sequence.
new.function <- function(a) {
for(i in 1:a) {
b <- i^2
print(b)
}
}# Call the function new.function supplying 6 as an argument.
new.function(6)
当我们上⾯的代码执⾏时,它产⽣以下结果:
[1] 1
[1] 4
[1] 9
[1] 16
[1] 25
[1] 36
调⽤函数不带参数
# Create a function without an argument.
new.function <- function() {
for(i in 1:5) {
print(i^2)
}
}
# Call the function without supplying an argument.
new.function()
当我们上⾯的代码执⾏时,它产⽣以下结果:
[1] 1
[1] 4
[1] 9
[1] 16
[1] 25
调⽤函数带有参数值(按位置和名称)
参数在传到函数调⽤可以以相同的顺序如提供在函数定义的顺序⼀样,或者它们可以以不同的顺序提供(按参数名称)。
# Create a function with arguments.
new.function <- function(a,b,c) {
result <- a*b+c
print(result)
}
# Call the function by position of arguments.
new.function(5,3,11)
# Call the function by names of the arguments.
new.function(a=11,b=5,c=3)
当我们上⾯的代码执⾏时,它产⽣以下结果:
[1] 26
[1] 58
带有调⽤默认参数的函数
我们可以在函数定义中定义的参数的值并调⽤该函数,⽽不提供任何参数来获取默认参数的结果。但是,我们也可以通过提供参数的新值调
⽤来这些函数,并得到⾮默认的结果。
# Create a function with arguments.
new.function <- function(a = 3,b =6) {
result <- a*b
print(result)
}
# Call the function without giving any argument.
new.function()
# Call the function with giving new values of the argument.
new.function(9,5)
当我们上⾯的代码执⾏时,它产⽣以下结果:
[1] 18
[1] 45
函数延迟计算
函数的参数在延迟⽅式计算,这意味着只有在需要函数体时,它们才会进⾏评估计算。# Create a function with arguments.
new.function <- function(a, b) {
print(a^2)
print(a)
print(b)
}
# Evaluate the function without supplying one of the arguments.
new.function(6)
当我们上⾯的代码执⾏时,它产⽣以下结果:
[1] 36
[1] 6
Error in print(b) : argument "b" is missing, with no default
R语言的loess函数
R语言的loess函数
当我们想研究不同sample的某个变量A之间的差异时,往往会因为其它一些变量B对该变量的固有影响,而影响不同sample变量A的比较,这个时候需要对sample变量A进行标准化之后才能进行比较。标准化的方法是对sample 的 A变量和B变量进行loess回归,拟合变量A关于变量B的函数 f(b),f(b)则表示在B的影响下A的理论取值,A-f(B)(A对f(b)残差)就可以去掉B变量对A变量的影响,此时残差值就可以作为标准化的A值在不同sample之间进行比较。
Loess局部加权多项式回归###
LOWESS最初由Cleveland 提出,后又被Cleveland&Devlin及其他许多人发展。在R中loess 函数是以lowess函数为基础的更复杂功能更强大的函数。主要思想为:在数据集合的每一点用低维多项式拟合数据点的一个子集,并估计该点附近自变量数据点所对应的因变量值,该多项式是用加权最小二乘法来拟合;离该点越远,权重越小,该点的回归函数值就是这个局部多项式来得到,而用于加权最小二乘回归的数据子集是由最近邻方法确定。
最大优点:不需要事先设定一个函数来对所有数据拟合一个模型。并且可以对同一数据进行多次不同的拟合,先对某个变量进行拟合,再对另一变量进行拟合,以探索数据中可能存在的某种关系,这是普通的回归拟合无法做到的。
LOESS平滑方法####
1. 以x0为中心确定一个区间,区间的宽度可以灵活掌握。具体来说,区间的宽度取决于q=fn。其中q是参与局部回归观察值的个数,f是参加局部回归观察值的个数占观察值个数的比例,n是观察值的个数。在实际应用中,往往先选定f值,再根据f和n确定q的取值,一般情况下f的取值在1/3到2/3之间。q与f的取值一般没有确定的准则。增大q值或f值,会导致平滑值平滑程度增加,对于数据中前在的细微变化模式则分辨率低,但噪声小,而对数据中大的变化模式的表现则比较好;小的q值或f值,曲线粗糙,分辨率高,但噪声大。没有一个标准的f值,比较明智的做法是不断的调试比较。
【R笔记】R语言中的字符串处理函数
【R笔记】R语⾔中的字符串处理函数
尽管R是⼀门以数值向量和矩阵为核⼼的统计语⾔,但字符串同样极为重要。从医疗研究数据⾥的出⽣⽇期到⽂本挖掘的应⽤,字符串数据在R程序中使⽤的频率⾮常⾼。R语⾔提供了很多字符串操作函数,本⽂仅简要以下⼏种常⽤的字符串函数。
字符串分割函数:strsplit( )
字符串连接函数:paste( )
计算字符串长度:nchar( )
字符串截取函数:substr( )及substring( )
字符串替换函数:chartr( )
⼤⼩写转换函数:toupper( )、tolower( )及casefold( )
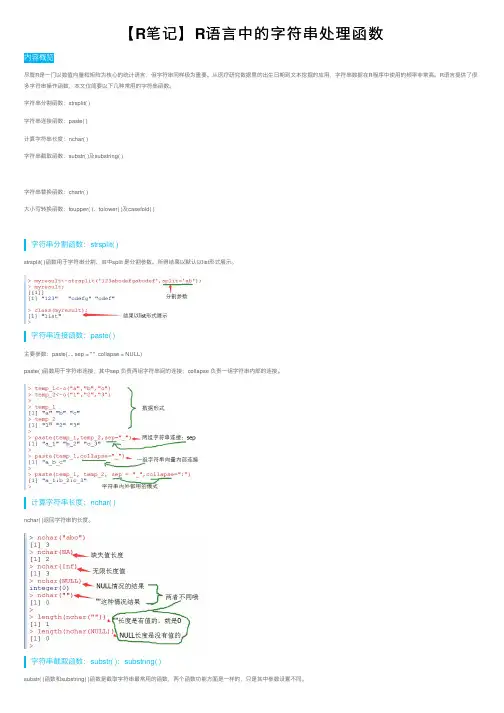
strsplit( )函数⽤于字符串分割,其中split 是分割参数。所得结果以默认以list形式展⽰。
主要参数:paste(..., sep = " ", collapse = NULL)
paste( )函数⽤于字符串连接,其中sep 负责两组字符串间的连接;collapse 负责⼀组字符串内部的连接。
nchar( )返回字符串的长度。
substr( )函数和substring( )
函数是截取字符串最常⽤的函数,两个函数功能⽅⾯是⼀样的,只是其中参数设置不同。字符串分割函数:strsplit( )
字符串连接函数:paste( )
计算字符串长度:nchar( )
字符串截取函数:substr( );substring( )substr( )函数:必须设置参数start和stop,如果缺少将出错。
substring( )函数:可以只设置first参数,last参数若不设置,则默认为1000000L,通常是指字符串的最⼤长度。例⼦如下:
chartr( )函数:将原有字符串中特定字符替换成所需要的字符。
其中参数old 表⽰原有字符串中内容;new 表⽰替换后的字符内容。
toupper( )函数:将字符串统⼀转换为⼤写。
tolower( )函数:将字符串统⼀转换为⼩写。
casefold( )函数:根据参数转换⼤⼩写。 温馨提⽰
R语言中矩阵运算的函数
1 创建一个向量
在R中可以用函数c()来创建一个向量,例如:
> x=c(1,2,3,4)
> x
[1] 1 2 3 4
2 创建一个矩阵
在R中可以用函数matrix()来创建一个矩阵,应用该函数时需要输入必要的参数值。
> args(matrix)
function (data = NA, nrow = 1, ncol = 1, byrow = FALSE, dimnames = NULL)
data项为必要的矩阵元素,nrow为行数,ncol为列数,注意nrow与ncol的乘积应为矩阵元素个数,byrow项控制排列元素时是否按行进行,dimnames给定行和列的名称。例如:
> matrix(1:12,nrow=3,ncol=4)
[,1] [,2] [,3] [,4]
[1,] 1 4 7 10
[2,] 2 5 8 11
[3,] 3 6 9 12
> matrix(1:12,nrow=4,ncol=3)
[,1] [,2] [,3]
[1,] 1 5 9
[2,] 2 6 10
[3,] 3 7 11
[4,] 4 8 12
> matrix(1:12,nrow=4,ncol=3,byrow=T)
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
[3,] 7 8 9
[4,] 10 11 12
> rowname
[1] "r1" "r2" "r3"
> colname=c("c1","c2","c3","c4")
> colname
[1] "c1" "c2" "c3" "c4"
> matrix(1:12,nrow=3,ncol=4,dimnames=list(rowname,colname))
c1 c2 c3 c4
r1 1 4 7 10
r2 2 5 8 11
3 矩阵转置
A为m×n矩阵,求A'在R中可用函数t(),例如:
> A=matrix(1:12,nrow=3,ncol=4)
R语言常用函数

R语言常用函数
数学函数:
1、round() #四舍五入
例:x <- c(3.1416, 15.377, 269.7)
round(x, 0) #保留整数位
round(x, 2) #保留两位小数
round(x, -1) #保留到十位
2、signif() #取有效数字(跟学过的有效数字不是一个意思)
例:略
3、trunc() #取整
floor() #向下取整
ceiling() #向上取整
例:xx <- c(3.60, 12.47, -3.60, -12.47)
trunc(xx)
floor(xx)
ceiling(xx)
4、logb(a, b) #以b为底的对数,省略b表示自然对数
log() #自然对数
log10() #以10为底的常用对数
例:logb(8, 2)
log(8); logb(8)
log10(100); logb(100, 10) 5、sqrt() #平方根
exp() #指数
6、sin() #正弦
cos() #余弦
tan() #正切
asin() #反正弦
acos() #反余弦
atan() #反正切
sinh() #双曲正弦
tanh() #双曲正切
7、nchar() #字符长度
例:xx <- 'China is a great country'
nchar(xx)
8、substring() #取子字符串
例:substring(xx, 1, 5)
9、paste() #连接字符
语法是:paste(..., sep = " ", collapse = NULL)
例1:x <- 'I'; y <- 'am'; z <- 'a'; d <- 'student'
paste(x, y, z, d)
例2:paste(c('x', 'y'), 1:4, sep = '')
R语言常用函数汇总

R语言常用函数汇总
一般数学函数,统计函数,概率函数,字符处理函数,以及一些其他函数;
1.
数学函数
函数 作用
abs() 绝对值
sqrt() 平方根
ceiling(x) 不小于x的最小整数
floor(x) 不大于x的最大整数
round(x, digits=n) 将x舍入为指定位的小数
signif(x, digits=n) 将X舍入为指定的有效数字位数
2. 统计函数
函数 作用
mean(x) 平均值
median(x) 中位数
sd(x) 标准差
var(x) 方差
quantile(x, probs) 求分位数,x为待求分位数的数值型向量,probs是一个由[0,1]的概率值组成的数值型向量
range(x) 求值域
sum(x) 求和
min(x) 求最小值 max(x) 求最大值
scale(x, center=TRUE,scale=TRUE) 以数据对象x按列进行中心化或标准化,center=TRUE表示数据中心化,scale=TRUE表示数据标准化
diff(x, lag=n) 滞后差分,lag用以指定滞后几项,默认为1
difftime(time1,time2,units=c(“auto”,”secs”,”mins”,”hours”,”days”,”weeks”)) 计算时间间隔,并以星期,天,时,分,秒来表示
3. 概率函数
分布名称 缩写
beta分布 beta
二项分布 binom
柯西分布 Cauchy
卡方分布 chisp
指数分布 exp
F分布 f
gamma分布 gamma
几何分布 geom
超几何分布 hyper
对数正态分布 lnorm
logistics分布 logis
多项分布 multinom
负二项分布 nbinom 正态分布 norm
泊松分布 pois
Wilcoxon分布 signrank
t分布 t
均匀分布 unif
R语言常用函数_2 (2)
R语言:常用函数
数据结构
一、数据管理
vector:向量
numeric:数值型向量
logical:逻辑型向量
character;字符型向量
list:列表
data.frame:数据框
c:连接为向量或列表
length:求长度
subset:求子集
seq,from:to,sequence:等差序列
rep:重复
NA:缺失值
NULL:空对象
sort,order,unique,rev:排序
unlist:展平列表
attr,attributes:对象属性
mode,typeof:对象存储模式与类型
names:对象的名字属性
二、字符串处理
character:字符型向量
nchar:字符数
substr:取子串
format,formatC:把对象用格式转换为字符串
paste,strsplit:连接或拆分
charmatch,pmatch:字符串匹配
grep,sub,gsub:模式匹配与替换
三、复数
complex,Re,Im,Mod,Arg,Conj:复数函数
四、因子
factor:因子
codes:因子的编码
levels:因子的各水平的名字
nlevels:因子的水平个数
cut:把数值型对象分区间转换为因子
table:交叉频数表
split:按因子分组aggregate:计算各数据子集的概括统计量
tapply:对“不规则”数组应用函数
数学相关计算
一、计算
+,-,*,/,^,%%,%/%:四则运算
ceiling,floor,round,signif,trunc,zapsmall:舍入
max,min,pmax,pmin:最大最小值
range:最大值和最小值
sum,prod:向量元素和积
cumsum,cumprod,cummax,cummin:累加、累乘
sort:排序
approx和approxfun:插值
diff:差分
sign:符号函数
二、数学函数
abs,sqrt:绝对值,平方根
log,exp,log10,log2:对数与指数函数
sin,cos,tan,asin,acos,atan,atan2:三角函数
R语言基本函数集合
R 语言基本函数集合
基本
一、数据管理
vector:向量
numeric:数值型向量
logical:逻辑型向量
character;字符型向量
list:列表
data.frame:数据框
c:连接为向量或列表
length:求长度
subset:求子集
seq,from:to,sequence:等差序列rep:重复
NA:缺失值
NULL:空对象
sort,order,unique,rev:排序unlist:展平列表
attr,attributes:对象属性
mode,typeof:对象存储模式与类型
names:对象的名字属性
二、字符串处理
character:字符型向量
nchar:字符数 substr:取子串
format,formatC:把对象用格式转换为字符串
paste,strsplit:连接或拆分
charmatch,pmatch:字符串匹配
grep,sub,gsub:模式匹配与替换
三、复数
complex,Re,Im,Mod,Arg,Conj:复数函数
四、因子
factor:因子
codes:因子的编码
levels:因子的各水平的名字
nlevels:因子的水平个数
cut:把数值型对象分区间转换为因子
table:交叉频数表
split:按因子分组
aggregate:计算各数据子集的概括统计量
tapply:对“不规则”数组应用函数
数学
一、计算
+, -, *, /, ^, %%, %/%:四则运算
ceiling,floor,round,signif,trunc,zapsmall:舍入
max,min,pmax,pmin:最大最小值
range:最大值和最小值
sum,prod:向量元素和,积
cumsum,cumprod,cummax,cummin:累加、累乘
sort:排序
approx 和 approx fun:插值
diff:差分
sign:符号函数
R语言基本函数集合 2
----------------------- Page 1-----------------------
R 语言基本函数集合
基本
一、数据管理
vector :向量
numeric :数值型向量
logical :逻辑型向量
character ;字符型向量
list :列表
data.frame:数据框
c :连接为向量或列表
length :求长度
subset :求子集
seq,from:to,sequence :等差序列
rep :重复
NA :缺失值
NULL :空对象
sort ,order ,unique ,rev :排序
unlist:展平列表
attr,attributes :对象属性
mode ,typeof:对象存储模式与类型
names :对象的名字属性
二、字符串处理
character :字符型向量
nchar:字符数
----------------------- Page 2-----------------------
substr:取子串
format ,formatC:把对象用格式转换为字符串
paste ,strsplit:连接或拆分
charmatch,pmatch:字符串匹配
grep,sub ,gsub:模式匹配与替换
三、复数
complex ,Re ,Im,Mod ,Arg,Conj:复数函数
四、因子
factor :因子
codes :因子的编码
levels :因子的各水平的名字
nlevels:因子的水平个数
cut :把数值型对象分区间转换为因子
table :交叉频数表
split :按因子分组
aggregate :计算各数据子集的概括统计量
tapply:对“不规则”数组应用函数
数学
一、计算
+, -, *, /, ^, %%, %/% :四则运算
R语言常用函数 2
R语言常用函数
基本
一、数据管理
vector:向量 numeric:数值型向量 logical:逻辑型向量character;字符型向量 list:列表 data.frame:数据框c:连接为向量或列表 length:求长度 subset:求子集seq,from:to,sequence:等差序列rep:重复 NA:缺失值 NULL:空对象sort,order,unique,rev:排序unlist:展平列表attr,attributes:对象属性 mode,typeof:对象存储模式与类型names:对象的名字属性
二、字符串处理
character:字符型向量 nchar:字符数 substr:取子串format,formatC:把对象用格式转换为字符串paste,strsplit:连接或拆分charmatch,pmatch:字符串匹配grep,sub,gsub:模式匹配与替换
三、复数
complex,Re,Im,Mod,Arg,Conj:复数函数
四、因子
factor:因子 codes:因子的编码 levels:因子的各水平的名字nlevels:因子的水平个数 cut:把数值型对象分区间转换为因子table:交叉频数表 split:按因子分组aggregate:计算各数据子集的概括统计量tapply:对“不规则”数组应用函数
数学
一、计算
+, -, *, /, ^, %%, %/%:四则运算ceiling,floor,round,signif,trunc,zapsmall:舍入max,min,pmax,pmin:最大最小值 range:最大值和最小值sum,prod:向量元素和,积cumsum,cumprod,cummax,cummin:累加、累乘sort:排序 approx和approx fun:插值diff:差分sign:符号函数
二、数学函数
abs,sqrt:绝对值,平方根log, exp, log10, log2:对数与指数函数sin,cos,tan,asin,acos,atan,atan2:三角函数sinh,cosh,tanh,asinh,acosh,atanh:双曲函数
R语言常用函数R语言其他
R语⾔常⽤函数R语⾔其他
操作数据库(RODBC)
odbcConnect(dsn, uid="", pwd="") 建⽴⼀个到ODBC数据库的连接
sqlFetch(channel, sqltable) 读取ODBC数据库中的某个表到⼀个数据框中
sqlQuery(channel, query) 向ODBC提交⼀个查询并返回结果
sqlSave(channel, dataframe, tablename=table, append=FALSE, rowname=TRUE) 将数据框写⼊或更新到ODBC数据库的某个表中
sqlUpdate(channel, dataframe, tablename=table, append=FALSE, rowname=TRUE, index="")
sqlDrop(channel, table) 删除某个表(物理删除)
sqlClear(channel, table) 删除某个表的数据
close(channel) 关闭连接
length(object)
语句variable[condition] <- expression将仅在condition的值为TRUE时执⾏赋值。
eg: leadership$agecat[leadership$age > 75] <- "Elder"
重命名 rename(dataframe, c(oldname="newname", oldname="newname", ...)) (reshape包)
排序 order(object)
rank(object) 返回排序后的序号
使⽤sql语句操作数据框(sqldf) : sqldf(sql) : 只能使⽤select语句
NA(not available) : 不可⽤
NaN(not a number) : ⾮数值
判断是否为NA : is.na(object)
去掉NA值 : na.omit(object)