
MySQL循环语句
MySQL循环语句
MySQL 循环
1.while循环
delimiter $$ // 定义结束符为 $$
drop procedure if exists wk; // 删除 已有的 存储过程
create procedure wk() // 创建新的存储过程
begin
declare i int; // 变量声明
set i = 1;
while i < 11 do // 循环体
INSERT INTO user(id,name,pwd) VALUES('',i,i); // 往user表添加数据
set i = i +1;
end while;
end
$$ // 结束定义语句
delimiter ; // 结束符定义为;
call wk(); // 调⽤
2.repeat循环
DELIMITER // // 定义结束符为 //
DROP PROCEDURE IF EXISTS test; // 删除 已有的 存储过程
CREATE PROCEDURE test() // 创建新的存储过程
BEGIN
DECLARE i INT; // 变量声明
SET i = 0;
REPEAT
INSERT INTO user(id,name,pwd) VALUES('',i,i); // 往user表添加数据
SET i = i + 1; // 循环⼀次,i加⼀
UNTIL i > 10 END REPEAT; // 结束循环的条件: 当i⼤于10时跳出repeat循环
END
// // 结束定义语句
DELIMITER ; // 定义结束符为 ;
CALL test(); //调⽤
3.loop循环
DELIMITER ** // 定义结束符为 **DROP PROCEDURE IF EXISTS demo;// 删除 已有的 存储过程
CREATE PROCEDURE demo() // 创建新的存储过程
BEGIN
DECLARE i INT;
SET i = 0;
lp : LOOP // lp为循环体名,可随意 loop为关键字
INSERT INTO user(id,name,pwd) VALUES('',i,i); // 往user表添加数据
SET i = i + 1; // 循环⼀次,i加⼀
IF i > 10 THEN // 结束循环的条件: 当i⼤于10时跳出loop循环
LEAVE lp;
END IF;
END LOOP;
END
** // 结束定义语句
DELIMITER ; // 定义结束符为 ;
CALL demo(); //调⽤
mysql存储过程
mysql存储过程
MySQL存储过程
1. 存储过程简介
我们常用的操作数据库语言SQL语句在执行的时候需要要先编译,然后执行,而存储过程(StoredProcedure)是一组为了完成特定功能的SQL语句集,经编译后存储在数据库中,用户通过指定存储过程的名字并给定参数(如果该存储过程带有参数)来调用执行它。
一个存储过程是一个可编程的函数,它在数据库中创建并保存。它可以有SQL语句和一些特殊的控制结构组成。当希望在不同的应用程序或平台上执行相同的函数,或者封装特定功能时,存储过程是非常有用的。数据库中的存储过程可以看做是对编程中面向对象方法的模拟。它允许控制数据的访问方式。
存储过程通常有以下优点:
(1).存储过程增强了SQL语言的功能和灵活性。存储过程可以用流控制语句编写,有很强的灵活性,可以完成复杂的判断和较复杂的运算。
(2).存储过程允许标准组件是编程。存储过程被创建后,可以在程序中被多次调用,而不必重新编写该存储过程的SQL语句。而且数据库专业人员可以随时对存储过程进行修改,对应用程序源代码毫无影响。
(3).存储过程能实现较快的执行速度。如果某一操作包含大量的Transaction-SQL代码或分别被多次执行,那么存储过程要比批处理的执行速度快很多。因为存储过程是预编译的。在首次运行一个存储过程时查询,优化器对其进行分析优化,并且给出最终被存储在系统表中的执行计划。而批处理的Transaction-SQL语句在每次运行时都要进行编译和优化,速度相对要慢一些。
(4).存储过程能过减少网络流量。针对同一个数据库对象的操作(如查询、修改),如果这一操作所涉及的Transaction-SQL语句被组织程存储过程,那么当在客户计算机上调用该存储过程时,网络中传送的只是该调用语句,从而大大增加了网络流量并降低了网络负载。
(5).存储过程可被作为一种安全机制来充分利用。系统管理员通过执行某一存储过程的权限进行限制,能够实现对相应的数据的访问权限的限制,避免了非授权用户对数据的访问,保证了数据的安全。
全国计算机二级MySQL选择题

1套
1.栈的初始状态为空。现将元素1、2、3、4、5、A、B、C、D、E依次入栈,然后再依次出栈,则元素出栈的顺序是(B )。
A) 12345ABCDE
B) EDCBA54321
C) ABCDE12345
D) 54321EDCBA
【解析】栈是先进后出的原则组织数据,所以入栈最早的最后出栈,所以选择B)。
2.叙述中正确的是(D )。
A) 循环队列有队头和队尾两个指针,因此,循环队列是非线性结构
B) 在循环队列中,只需要队头指针就能反映队列中元素的动态变化情况
C) 在循环队列中,只需要队尾指针就能反映队列中元素的动态变化情况
D) 循环队列中元素的个数是由队头指针和队尾指针共同决定
【解析】循环队列有队头和队尾两个指针,但是循环队列仍是线性结构的,所以A)错误;在循环队列中只需要队头指针与队尾两个指针来共同反映队列中元素的动态变化情况,所以B)与C)错误。
3.度为n的有序线性表中进行二分查找,最坏情况下需要比较的次数是(C)。
A)
B)
C)
D)
【解析】当有序线性表为顺序存储时才能用二分法查找。可以证明的是对于长度为的有序线性表,在最坏下列叙述中正确的是( )。
A) 顺序存储结构的存储一定是连续的,链式存储结构的存储空间不一定是连续的
B) 顺序存储结构只针对线性结构,链式存储结构只针对非线性结构
C) 顺序存储结构能存储有序表,链式存储结构不能存储有序表
D) 链式存储结构比顺序存储结构节省存储空间
在软件开发中,需求分析阶段产生的主要文档是( )。
A) 可行性分析报告
B) 软件需求规格说明书
C) 概要设计说明书
D) 集成测试计划
4. 在软件开发中,需求分析阶段产生的主要文档是(B )。
A) 可行性分析报告
B) 软件需求规格说明书
C) 概要设计说明书
D) 集成测试计划
【解析】A)错误,可行性分析阶段产生可行性分析报告。C)错误,概要设计说明书是总体设计阶段产生的文档。D)错误,集成测试计划是在概要设计阶段编写的文档。B)正确,需求规格说明书是后续工作如设计、编码等需要的重要参考文档
计算机二级wps题库及答案
计算机二级wps题库及答案
1 下列叙述中正确的是( )。 [单选题] *
一个算法的空间复杂度大,则其时间复杂度也必定大
一个算法的空间复杂度大,则其时间复杂度必定小
一个算法的时间复杂度大,则其空间复杂度必定小
算法的时间复杂度与空间复杂度没有直接关系(正确答案)
2 下列叙述中正确的是( )。 [单选题] *
循环队列中的元素个数随队头指针与队尾指针的变化而动态变化(正确答案)
循环队列中的元素个数随队头指针的变化而动态变化
循环队列中的元素个数随队尾指针的变化而动态变化
以上说法都不对
3 一棵二叉树中共有80个叶子结点与70个度为1的结点,则该二叉树中的总结点数为( )。 [单选题]
A.219
B.229(正确答案)
C.230
D.231
4 对长度为10的线性表进行冒泡排序,最坏情况下需要比较的次数为( )。 [单选题]
*
A.9
B.10
C.45(正确答案) D.90
5 构成计算机软件的是( )。 [单选题] *
源代码
程序和数据
程序和文档
程序、数据及相关文档(正确答案)
6 软件生命周期可分为定义阶段、开发阶段和维护阶段,下面不属于开发阶段任务的是( )。 [单选题] *
测试
设计
可行性研究(正确答案)
实现
7 下面不能作为结构化方法软件需求分析工具的是( )。 [单选题] *
系统结构图(正确答案)
数据字典(DD)
数据流程图(DFD图)
判定表
8 在关系模型中,每一个二维表称为一个( )。 [单选题]
*
关系(正确答案)
属性
元组
主码(键)
9 若实体A和B是一对多的联系,实体B和C是一对一的联系,则实体A和C的联系是( )。 [单选题] *
一对一
一对多(正确答案)
多对一
多对多
10 有三个关系R、S和T如下:
则由关系R和S得到关系T的操作是( )。 [单选题] *
选择
投影
交
并(正确答案)
11 以下关于数据库的特点中,描述正确的是( )。 [单选题] *
mysql 存储过程 into用法

mysql 存储过程 into用法
MySQL是一种流行的数据库管理系统,它支持存储过程,这是一种执行特定任务的程序。存储过程可以将SQL语句、控制结构和循环等组合在一起,形成一个可以在需要时多次使用的一条命令。而into是存储过程中一个非常重要的用法,它用于将查询结果写入一个变量或表中,使其可以在后续的代码中使用。本文将详细介绍mysql存储过程into用法,分为以下几个步骤:
第一步:创建存储过程
在MySQL中创建存储过程十分简单,只需使用CREATE PROCEDURE语句即可。下面是一个简单的例子:
CREATE PROCEDURE GetUsers()
BEGIN
SELECT * FROM users;
END;
这个存储过程名为GetUsers,它使用SELECT语句查询一个名为users的表中的所有数据。在这个例子中,存储过程没有使用into用法。现在我们将添加into用法以将结果写入一个变量中。
第二步:使用into将查询结果写入变量中
我们可以使用into将上述查询结果写入一个变量中,如下所示:
CREATE PROCEDURE GetUsersCount()
BEGIN
SELECT COUNT(*) INTO @userCount FROM users;
END;
这个存储过程使用COUNT函数计算users表中的行数,并将结果存储在名为@userCount的变量中。现在我们可以使用这个变量在后续的代码中进行计算或输出。
第三步:将查询结果写入表中
在一些情况下,我们可能希望将查询结果写入一个临时表中,以便在后续的代码中使用。这可以通过into用法轻松实现。下面是一个例子:
CREATE PROCEDURE GetAdminUsers()
BEGIN
CREATE TABLE tmpAdminUsers (
username VARCHAR(255),
case语句,循环语句

case语句,循环语句
case语句,循环语句
vim 名字也不能乱写 ⽐如
vim rsync.sh
应为后⾯需要pkill rsync 会把⽂件⼀起删掉
1.case流程控制语句
case 变量名4 in
模式匹配1)
命令的集合
;;
模式匹配2)
命令的集合
;;
模式匹配3)
命令的集合
;;
*) *的下⼀⾏不需要有;;
echo USAGE[$0 1|2|3]
esac
[root@shell /server/scripts]# cat case.sh
#!/bin/bash
##############################################################
# File Name: case.sh
# Time: 2019-11-04-09:43:18
# Author: msy
##############################################################
case $1 in
Linux)
echo linux...
;;
Shell)
echo shell...
;;
MySql)
echo mysql...
;;
*)
echo "USAGE $0 [Linux|Shell|MySql]"
esac
[root@shell /server/scripts]# sh case.sh Linux
linux...
case 批量删除⽤户
[root@shell /server/scripts]# cat casedel.sh
#!/bin/bash
##############################################################
# File Name: casedel.sh
# Time: 2019-11-04-10:22:07
# Author: msy
##############################################################
mysql语句:批量更新多条记录的不同值
mysql语句:批量更新多条记录的不同值
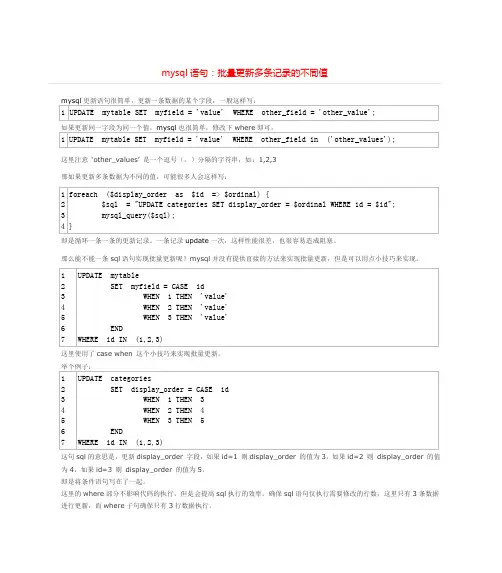
mysql更新语句很简单,更新一条数据的某个字段,一般这样写:
1 UPDATE mytable SET myfield = 'value' WHERE
other_field = 'other_value';
如果更新同一字段为同一个值,mysql也很简单,修改下where即可:
1 UPDATE mytable SET myfield = 'value' WHERE other_field in
('other_values');
这里注意 ‘other_values’ 是一个逗号(,)分隔的字符串,如:1,2,3
那如果更新多条数据为不同的值,可能很多人会这样写:
1
2
3
4 foreach ($display_order as $id => $ordinal) {
$sql = "UPDATE categories SET display_order = $ordinal WHERE id = $id";
mysql_query($sql);
}
即是循环一条一条的更新记录。一条记录update一次,这样性能很差,也很容易造成阻塞。
那么能不能一条sql语句实现批量更新呢?mysql并没有提供直接的方法来实现批量更新,但是可以用点小技巧来实现。
1
2
3
4
5
6
7 UPDATE mytable
SET myfield = CASE id
WHEN 1 THEN 'value'
WHEN 2 THEN 'value'
WHEN 3 THEN 'value'
END
WHERE id IN (1,2,3)
这里使用了case when 这个小技巧来实现批量更新。
举个例子:
1
2
3
4
5
6
7 UPDATE categories
SET display_order = CASE id
mysql创建函数语法
mysql创建函数语法
MySQL是一个常用的关系型数据库管理系统,它支持通过创建用户自定义函数(User Defined Function,简称UDF)来扩展其功能。创建函数是一种自定义函数的过程,它可以在数据库中创建一个或多个函数来执行特定的任务。
下面是MySQL创建函数的语法:
```MySQL
CREATE FUNCTION function_name ([parameters])
RETURNS data_type
[DETERMINISTIC]
[COMMENT 'string']
BEGIN
-- 函数的逻辑代码
END;
```
- `CREATE FUNCTION`:关键字,用于创建函数。
- `function_name`:函数的名称,可以根据需要自定义。
- `parameters`:函数的参数列表,可以包含零个或多个参数,每个参数由参数名称和参数类型组成,多个参数之间用逗号分隔。
- `RETURNS`:关键字,指定函数的返回值类型。
- `data_type`:函数的返回值类型,可以是MySQL支持的任何数据类型。
- `DETERMINISTIC`:可选的关键字,用于指定函数是否是确定性的,即是否每次调用都返回相同的结果。如果确定函数是确定性的,可以提高查询的性能。
- `COMMENT`:可选的关键字,用于为函数提供注释。
- `'string'`:注释的内容,由单引号包围的字符串。
- `BEGIN`:关键字,表示函数定义的开始。
- `END`:关键字,表示函数定义的结束。 在`BEGIN`和`END`之间是函数的逻辑代码,用于实现函数的具体功能。在函数中可以使用多种SQL语句、控制流语句和变量来完成相应的任务。函数可以包含任意数量的SQL语句,可以嵌套使用控制流语句和循环语句,可以使用变量进行计算和存储临时数据。
Mysql中用exists代替in
Mysql中⽤exists代替in
exists对外表⽤loop逐条查询,每次查询都会查看exists的条件语句,当 exists⾥的条件语句能够返回记录⾏时(⽆论记录⾏是的多少,只要能返回),条件就为真,返回当前loop到的这条记录,反之如果exists⾥的条 件语句不能返回记录⾏,则当前loop到的这条记录被丢弃,exists的条件就像⼀个bool条件,当能返回结果集则为true,不能返回结果集则为 false如下:select * from user where exists (select 1);
对user表的记录逐条取出,由于⼦条件中的select 1永远能返回记录⾏,那么user表的所有记录都将被加⼊结果集,所以与 select * fromuser;是⼀样的
⼜如下select * from user where exists (select * from user where userId = 0);
可以知道对user表进⾏loop时,检查条件语句(select * from user where userId = 0),由于userId永远不为0,所以条件语句永远返回空集,条件永远为false,那么user表的所有记录都将被丢弃not exists与exists相反,也就是当exists条件有结果集返回时,loop到的记录将被丢弃,否则将loop到的记录加⼊结果集
总的来说,如果A表有n条记录,那么exists查询就是将这n条记录逐条取出,然后判断n遍exists条件 in查询相当于多个or条件的叠加,这个⽐较好理解,⽐如下⾯的查询select * from user where userId in (1, 2, 3);
等效于select * from user where userId = 1 or userId = 2 or userId = 3;not in与in相反,如下select * from user where userId not in (1, 2, 3);
《MySQL数据库开发》期末复习题1
MySQL数据库开发》期末复习题1
考试题型
一、单选题(每小题2分,共40分)
二、判断题(每小题1分,打”V”或”某”,共10分)三、问答题(共15分,每小题5分)四、综合题(共35分,每小题5分)
一、填空
1、用来表示数据库中行之间的关系的机制称为外键_约束。
2、字符集___是一套符号与编码,它包括编码规则以定义字符
如何被编码为数字。3、MySQL程序选项有两种通用形式:长选项
__和__短选项。
4、MySQL数据类型分为四大主要类别:数值___、__字符
、__二进制、时间。
5、存储程序是保存在服务器里的一组SQL语句的集合。6、
锁_是一种用来防止多个客户端时访问数据而产生问题的机制。
7、事务_是将一个数据处理执行步骤的集合作为一个单一单元
来处理。8、innoDB引擎是目前唯一可提供外键实现支持的引
擎。9、CREATE—temporaryTABLE创建临时表。
10、union—关键字能够将两个或多个SELECT语句的结果连接
起来。
选择题主要在认证复习题中。
二、选择(单选) 每小题2分,共40分
(A) et(B)end(C)delimiter4、设置MySQL提示符的命令是(B)
(A) tip
(B) prompt
5、导入ql脚本文件的命令是(A)(A)ource(B)cript(C)file
(D)finih
(D)meage
(C) popup
(D) ql
6、关于SELECT语句以下哪一个描述是错误的(C)(A)SELECT语句用于查询一个表或多个表的数据。
(B) SELECT语句属于数据操作语言(DML)。
(C) SELECT语句的列必需是基于表的列的。
(D) SELECT语句表示数据库中一组特定的数据记录。7、ENUM类型的字段level定义为(LOW、MIDDLE、HIGH),ORDERBYlevelac的顺序是
(B)
(A) HIGH、LOW、MIDDLE
mysql--exists替换in
mysql--exists替换in
exists对外表⽤loop逐条查询,每次查询都会查看exists的条件语句,当 exists⾥的条件语句能够返回记录⾏时(⽆论记录⾏是的多少,只要能返回),条件就为真,返回当前loop到的这条记录,反之如果exists⾥的条 件语句不能返回记录⾏,则当前loop到的这条记录被丢弃,exists的条件就像⼀个boolean条件,当能返回结果集则为true,不能返回结果集则为 false
如下:
select * from user where exists (select 1);
对user表的记录逐条取出,由于⼦条件中的select 1永远能返回记录⾏,那么user表的所有记录都将被加⼊结果集,所以与 select * fromuser;是⼀样的
⼜如下
select * from user where exists (select * from user where userId = 0);
可以知道对user表进⾏loop时,检查条件语句(select * from user where userId = 0),由于userId永远不为0,所以条件语句永远返回空集,条件永远为false,那么user表的所有记录都将被丢弃
not exists与exists相反,也就是当exists条件有结果集返回时,loop到的记录将被丢弃,否则将loop到的记录加⼊结果集
总的来说,如果A表有n条记录,那么exists查询就是将这n条记录逐条取出,然后判断n遍exists条件
in查询相当于多个or条件的叠加,这个⽐较好理解,⽐如下⾯的查询
select * from user where userId in (1, 2, 3);
等效于
select * from user where userId = 1 or userId = 2 or userId = 3;
not in与in相反,如下