
oracle分析函数
Oracle从8.1.6开始提供分析函数,分析函数用于计算基于组的某种聚合值,它和聚合函数的不同之处是对于每个组返回多行,而聚合函数对于每个组只返回一行。
下面例子中使用的表来自Oracle自带的HR用户下的表,如果没有安装该用户,可以在SYS用户下运行$ORACLE_HOME/demo/schema/human_resources/hr_main.sql来创建。
少数几个例子需要访问SH用户下的表,如果没有安装该用户,可以在SYS用户下运行$ORACLE_HOME/demo/schema/sales_history/sh_main.sql来创建。
如果未指明缺省是在HR用户下运行例子。
开窗函数的的理解:开窗函数指定了分析函数工作的数据窗口大小,这个数据窗口大小可能会随着行的变化而变化,举例如下:over(order by salary)按照salary排序进行累计,order by是个默认的开窗函数,over(partition by deptno)按照部门分区,over(order by salary range between 50 preceding and 150 following)每行对应的数据窗口是之前行幅度值不超过50,之后行幅度值不超过150,over(order by salary rows between 50 preceding and 150 following)每行对应的数据窗口是之前50行,之后150行over(order by salary rows between unbounded preceding and unbounded following)每行对应的数据窗口是从第一行到最后一行,等效:over(order by salary range between unbounded preceding and unbounded following)主要参考资料:《expert one-on-one》Tom Kyte 《Oracle9i SQL Reference》第6章AVG 功能描述:用于计算一个组和数据窗口内表达式的平均值。
SAMPLE:下面的例子中列c_mavg计算员工表中每个员工的平均薪水报告,该平均值由当前员工和与之具有相同经理的前一个和后一个三者的平均数得来;SELECT manager_id, last_name, hire_date, salary, AVG(salary) OVER (PARTITION BY manager_id ORDER BY hire_date ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING) AS c_mavg FROM employees;MANAGER_ID LAST_NAME HIRE_DATE SALARY C_MAVG---------- ------------------------- --------- ---------- ---------- 100 Kochhar 21-SEP-89 17000 17000 100 De Haan 13-JAN-93 17000 15000 100 Raphaely 07-DEC-94 11000 11966.6667 100 Kaufling 01-MAY-95 7900 10633.3333 100 Hartstein 17-FEB-96 13000 9633.33333 100 Weiss 18-JUL-96 8000 11666.6667 100 Russell 01-OCT-96 14000 11833.3333...CORR 功能描述:返回一对表达式的相关系数,它是如下的缩写:COVAR_POP(expr1,expr2)/STDDEV_POP(expr1)*STDDEV_POP(expr2))从统计上讲,相关性是变量之间关联的强度,变量之间的关联意味着在某种程度上一个变量的值可由其它的值进行预测。
通过返回一个-1~1之间的一个数, 相关系数给出了关联的强度,0表示不相关。
SAMPLE:下例返回1998年月销售收入和月单位销售的关系的累积系数(本例在SH用户下运行)SELECT t.calendar_month_number, CORR (SUM(s.amount_sold), SUM(s.quantity_sold)) OVER (ORDER BY t.calendar_month_number) as CUM_CORR FROM sales s, times tWHERE s.time_id = t.time_id AND calendar_year = 1998GROUP BY t.calendar_month_numberORDER BY t.calendar_month_number;CALENDAR_MONTH_NUMBER CUM_CORR-------------------------------1 2 1 3 .994309382 4 .8520408755 .8466522046 .8712506287 .9100298038 .917556399 9 .920154356 10 .8672025111 .844864765 12 .903542662COVAR_POP 功能描述:返回一对表达式的总体协方差。
SAMPLE:下例CUM_COVP返回定价和最小产品价格的累积总体协方差SELECT product_id, supplier_id, COVAR_POP(list_price, min_price) OVER (ORDER BY product_id, supplier_id) AS CUM_COVP, COVAR_SAMP(list_price, min_price) OVER (ORDER BY product_id, supplier_id) AS CUM_COVS FROM product_information pWHERE category_id = 29ORDER BY product_id, supplier_id;PRODUCT_ID SUPPLIER_ID CUM_COVP CUM_COVS---------- ----------- ---------- ---------- 1774 103088 0 1775 103087 1473.25 2946.5 1 794 103096 1702.77778 2554.16667 1825 103093 1926.25 2568.33333 2004 103086 1591.4 1989.25 2005 103086 1512.5 1815 2416 103088 1475.97959 1721.97619..COVAR_SAMP 功能描述:返回一对表达式的样本协方差。
SAMPLE:下例CUM_COVS返回定价和最小产品价格的累积样本协方差SELECT product_id, supplier_id, COVAR_POP(list_price, min_price) OVER (ORDER BY product_id, supplier_id) AS CUM_COVP, COVAR_SAMP(list_price, min_price) OVER (ORDER BY product_id, supplier_id) AS CUM_COVS FROM product_information pWHERE category_id = 29ORDER BY product_id, supplier_id;PRODUCT_ID SUPPLIER_ID CUM_COVP CUM_COVS---------- ----------- ---------- ---------- 1774 103088 0 1775 103087 1473.25 2946.5 1 794 103096 1702.77778 2554.16667 1825 103093 1926.25 2568.33333 2004 103086 1591.4 1989.25 2005 103086 1512.5 1815 2416 103088 1475.97959 1721.97619..COUNT 功能描述:对一组内发生的事情进行累积计数,如果指定*或一些非空常数,count将对所有行计数,如果指定一个表达式,count返回表达式非空赋值的计数,当有相同值出现时,这些相等的值都会被纳入被计算的值;可以使用DISTINCT来记录去掉一组中完全相同的数据后出现的行数。
SAMPLE:下面例子中计算每个员工在按薪水排序中当前行附近薪水在[n-50,n+150]之间的行数,n 表示当前行的薪水例如,Philtanker的薪水2200,排在他之前的行中薪水大于等于2200-50的有1行,排在他之后的行中薪水小于等于2200+150的行没有,所以count计数值cnt3为2(包括自己当前行);cnt2值相当于小于等于当前行的SALARY值的所有行数SELECT last_name, salary, COUNT(*) OVER () AS cnt1, COUNT(*) OVER (ORDER BY salary)AS cnt2, COUNT(*) OVER (ORDER BY salary RANGE BETWEEN 50 PRECEDING AND 150 FOLLOWING) AS cnt3 FROM employees;LAST_NAME SALARY CNT1 CNT2 CNT3------------------------- ---------- ---------- ---------- ----------Olson 2100 107 1 3Markle 2200 107 3 2Philtanker 2200 107 3 2Landry 2400 107 5 8Gee 2400 107 5 8Colmenares 2500 10711 10Patel 2500 107 11 10..CUME_DIST 功能描述:计算一行在组中的相对位置,CUME_DIST总是返回大于0、小于或等于1的数,该数表示该行在N行中的位置。
例如,在一个3行的组中,返回的累计分布值为1/3、2/3、3/3 SAMPLE:下例中计算每个工种的员工按薪水排序依次累积出现的分布百分比SELECT job_id, last_name, salary, CUME_DIST() OVER (PARTITION BY job_id ORDER BY salary) AS cume_dist FROM employees WHERE job_id LIKE @#PU%@#;JOB_ID LAST_NAME SALARY CUME_DIST---------- ------------------------- ---------- ----------PU_CLERK Colmenares 2500 .2PU_CLERK Himuro 2600 .4PU_CLERK Tobias 2800 .6PU_CLE RK Baida 2900 .8PU_CLERK Khoo 310 0 1PU_MAN Raphaely 11000 1DENSE_RANK 功能描述:根据ORDER BY子句中表达式的值,从查询返回的每一行,计算它们与其它行的相对位置。
ORACLE_分析函数大全

ORACLE_分析函数大全Oracle分析函数是一种高级SQL函数,它可以在查询中实现一系列复杂的分析操作。
这些函数可以帮助我们在数据库中执行各种数据分析和报表生成任务。
本文将介绍Oracle数据库中的一些常用分析函数。
1.ROW_NUMBER函数:该函数为查询结果中的每一行分配一个唯一的数字。
可以用它对结果进行排序或分组。
例如,可以使用ROW_NUMBER函数在结果集中为每个员工计算唯一的编号。
2.RANK和DENSE_RANK函数:这两个函数用于计算结果集中每个行的排名。
RANK函数返回相同值的行具有相同的排名,并且下一个排名值将被跳过。
DENSE_RANK函数类似,但是下一个排名值不会被跳过。
G和LEAD函数:LAG函数返回结果集中指定列的前一个(上一个)行的值,而LEAD函数返回后一个(下一个)行的值。
这些函数通常用于计算增长率或发现趋势。
4.FIRST和LAST函数:这两个函数用于返回结果集中分组的第一个和最后一个行的值。
可以与GROUPBY子句一起使用。
5.CUME_DIST函数:该函数用于计算给定值的累积分布。
它返回值的累积分布在结果集中的位置(百分比)。
6.PERCENT_RANK函数:该函数用于计算结果集中每个行的百分位数排名。
它返回值的百分位数排名(0到1之间的小数)。
7. NTILE函数:该函数用于将结果集分成指定数量的桶(Bucket),并为每个行分配一个桶号。
通常用于将数据分组为更小的块。
8.LISTAGG函数:该函数将指定列的值连接成一个字符串,并使用指定的分隔符分隔每个值。
可以用它将多个值合并在一起形成一个字符串。
9.AVG、SUM、COUNT和MAX/MIN函数:这些是常见的聚合函数,可以在分析函数中使用。
它们用于计算结果集中的平均值、总和、计数和最大/最小值。
以上只是Oracle数据库中的一些常用分析函数。
还有其他一些分析函数,如PERCENTILE_CONT、PERCENTILE_DISC等可以用于更高级的分析计算。
ORACLE中的ROW_NUMBEROVER分析函数的用法

ORACLE中的ROW_NUMBEROVER分析函数的用法ROW_NUMBER(OVER(是ORACLE数据库中的一个分析函数,用来为结果集中的每一行分配一个唯一的序号。
ROW_NUMBER(OVER(的语法是:ROW_NUMBER( OVER ( [ PARTITION BY expr1 [, expr2, ...] ]ORDER BY clause )其中,PARTITIONBY子句可选,用来指定分区依据的列或表达式;ORDERBY子句用来指定排序的列或表达式。
ROW_NUMBER(OVER(常用在查询结果需要进行分页或者进行排序后获取前几行的场景中。
以下是ROW_NUMBER(OVER(的用法示例:示例1:查询员工表中每个部门的员工数,并按照员工数降序排序。
SELECT department_id, count(*) as employee_count,ROW_NUMBER( OVER (ORDER BY count(*) DESC) as rankFROM employeesGROUP BY department_idORDER BY count(*) DESC;在这个示例中,ROW_NUMBER(OVER(函数根据部门中的员工数进行降序排序,并为每个部门分配一个唯一的序号。
示例2:查询员工表中每个部门的员工数,并按照员工数降序排序,并且只返回前三名。
SELECT department_id, count(*) as employee_count,ROW_NUMBER( OVER (ORDER BY count(*) DESC) as rankFROM employeesGROUP BY department_idWHERE rank <= 3ORDER BY count(*) DESC;在这个示例中,ROW_NUMBER(OVER(函数的结果用于限制查询结果只返回前三名。
示例3:查询员工表中每个部门的员工信息,并按照部门和薪水进行排序。
Oracle分析函数的使用(主要是rollup用法)

Oracle分析函数的使⽤(主要是rollup⽤法)分析函数是oracle 8.1.6中就引⼊的⼀个全新的概念,为我们分析数据提供了⼀种简单⾼效的处理⽅式.在分析函数出现以前,我们必须使⽤⾃联查询,⼦查询或者内联视图,甚⾄复杂的存储过程实现的语句,现在只要⼀条简单的sql语句就可以实现了,⽽且在执⾏效率⽅⾯也有相当⼤的提⾼.分析函数的使⽤⽅法1. ⾃动汇总函数rollup,cube,2. rank 函数, rank,dense_rank,row_number3. lag,lead函数4. sum,avg,的移动增加,移动平均数5. ratio_to_report报表处理函数6. first,last取基数的分析函数本⼈在项⽬中由于⽤到⼩计、合计的统计,前⾯想到⽤union all,但这样有点⿇烦并且效率也不⾼,就从⽹上查到资料说是oracle 8i、oracl 9i、oracle 10g 中已经分析函数对数据统计的处理,于是就顺便学习了⼀下这些函数的⽤法,拿出来分享给⼤家共同学习。
1、Oracle ROLLUP和CUBE ⽤法Oracle的GROUP BY语句除了最基本的语法外,还⽀持ROLLUP和CUBE语句。
如果是Group by ROLLUP(A, B, C)的话,⾸先会对(A、B、C)进⾏GROUP BY,然后对(A、B)进⾏GROUP BY,然后是(A)进⾏GROUP BY,最后对全表进⾏GROUP BY操作。
如果是GROUP BY CUBE(A, B, C),则⾸先会对(A、B、C)进⾏GROUP BY,然后依次是(A、B),(A、C),(A),(B、C),(B),(C),最后对全表进⾏GROUP BY操作。
grouping_id()可以美化效果。
除了使⽤GROUPING函数,还可以使⽤GROUPING_ID来标识GROUP BY的结果。
也可以 Group by Rollup(A,(B,C)) ,Group by A Rollup(B,C),…… 这样任意按⾃⼰想要的形式结合统计数据,⾮常⽅便。
Oracle分析函数使用总结
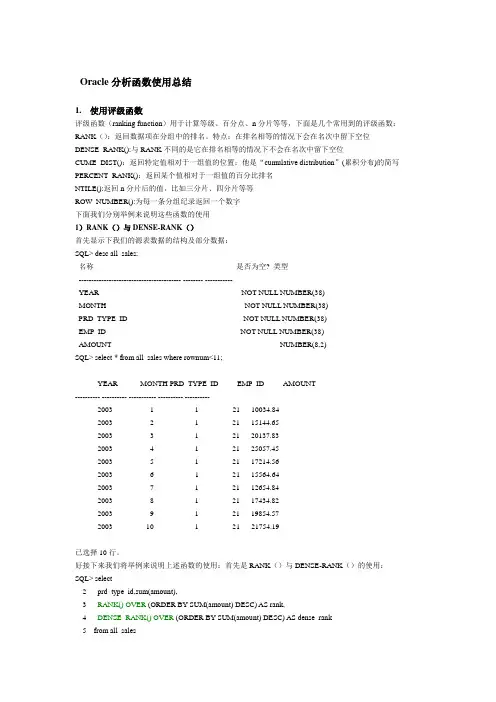
Oracle分析函数使用总结1.使用评级函数评级函数(ranking function)用于计算等级、百分点、n分片等等,下面是几个常用到的评级函数:RANK():返回数据项在分组中的排名。
特点:在排名相等的情况下会在名次中留下空位DENSE_RANK():与RANK不同的是它在排名相等的情况下不会在名次中留下空位CUME_DIST():返回特定值相对于一组值的位置:他是“cumulative distribution”(累积分布)的简写PERCENT_RANK():返回某个值相对于一组值的百分比排名NTILE():返回n分片后的值,比如三分片、四分片等等ROW_NUMBER():为每一条分组纪录返回一个数字下面我们分别举例来说明这些函数的使用1)RANK()与DENSE-RANK()首先显示下我们的源表数据的结构及部分数据:SQL> desc all_sales;名称是否为空? 类型----------------------------------------- -------- -----------YEAR NOT NULL NUMBER(38)MONTH NOT NULL NUMBER(38)PRD_TYPE_ID NOT NULL NUMBER(38)EMP_ID NOT NULL NUMBER(38)AMOUNT NUMBER(8,2)SQL> select * from all_sales where rownum<11;YEAR MONTH PRD_TYPE_ID EMP_ID AMOUNT---------- ---------- ----------- ---------- ----------2003 1 1 21 10034.842003 2 1 21 15144.652003 3 1 21 20137.832003 4 1 21 25057.452003 5 1 21 17214.562003 6 1 21 15564.642003 7 1 21 12654.842003 8 1 21 17434.822003 9 1 21 19854.572003 10 1 21 21754.19已选择10行。
oracle常用的分析函数

oracle常⽤的分析函数常⽤的分析函数如下所列:row_number() over(partition by ... order by ...)rank() over(partition by ... order by ...)dense_rank() over(partition by ... order by ...)count() over(partition by ... order by ...)max() over(partition by ... order by ...)min() over(partition by ... order by ...)sum() over(partition by ... order by ...)avg() over(partition by ... order by ...)first_value() over(partition by ... order by ...)last_value() over(partition by ... order by ...)lag() over(partition by ... order by ...)lead() over(partition by ... order by ...)⼀、Oracle分析函数简介:在⽇常的⽣产环境中,我们接触得⽐较多的是OLTP系统(即Online Transaction Process),这些系统的特点是具备实时要求,或者⾄少说对响应的时间多长有⼀定的要求;其次这些系统的业务逻辑⼀般⽐较复杂,可能需要经过多次的运算。
⽐如我们经常接触到的电⼦商城。
在这些系统之外,还有⼀种称之为OLAP的系统(即Online Aanalyse Process),这些系统⼀般⽤于系统决策使⽤。
通常和数据仓库、数据分析、数据挖掘等概念联系在⼀起。
这些系统的特点是数据量⼤,对实时响应的要求不⾼或者根本不关注这⽅⾯的要求,以查询、统计操作为主。
oracle max over partition by用法

oracle max over partition by用法全文共四篇示例,供读者参考第一篇示例:Oracle数据库是一种关系数据库管理系统,提供了丰富的功能和语法来处理数据。
在处理数据的时候,我们经常需要使用分析函数来进行复杂的计算和分析,max over partition by是一种常用的功能之一。
本文将介绍max over partition by的用法以及它在实际应用中的作用。
在Oracle数据库中,max over partition by是一种分析函数,它可以在一组数据中查找指定列的最大值,并返回结果。
它的语法如下:```max(column) over (partition by column_name)```column是要查找最大值的列,而column_name则是根据哪个列进行分区。
通过在max后面加上over partition by关键字,我们可以在指定的分区内查找最大值。
举个例子来说明max over partition by的用法:假设有一个销售订单表orders,包含了订单号(order_id)、商品编号(product_id)和销售额(amount)三个字段,我们现在想要查找每个商品的销售额最大值。
我们可以使用max over partition by来实现:```select order_id, product_id, amount,max(amount) over (partition by product_id) asmax_amountfrom orders```在实际应用中,max over partition by有很多用途。
我们可以使用它来查找每个员工的最高工资、每个部门的最大利润等等。
通过对数据进行分区并利用分析函数,我们可以更方便地对数据进行深入分析和计算。
除了max over partition by之外,Oracle还提供了其他一些强大的分析函数,如min over partition by、sum over partition by等等,它们都可以帮助我们更加高效地处理复杂的数据分析任务。
Oracle分析函数-排序排列(rank、dense_rank、row_number、ntile)
Oracle分析函数-排序排列(rank、dense_rank、row_number、ntile)(1)rank函数返回⼀个唯⼀的值,除⾮遇到相同的数据时,此时所有相同数据的排名是⼀样的,同时会在最后⼀条相同记录和下⼀条不同记录的排名之间空出排名。
(2)dense_rank函数返回⼀个唯⼀的值,除⾮当碰到相同数据时,此时所有相同数据的排名都是⼀样的。
(3)row_number函数返回⼀个唯⼀的值,当碰到相同数据时,排名按照记录集中记录的顺序依次递增。
(4)ntile是要把查询得到的结果平均分为⼏组,如果不平均则分给第⼀组。
例如:create table s_score( s_id number(6),score number(4,2));insert into s_score values(001,98);insert into s_score values(002,66.5);insert into s_score values(003,99);insert into s_score values(004,98);insert into s_score values(005,98);insert into s_score values(006,80);selects_id,score,rank() over(order by score desc) rank --按照成绩排名,纯排名,dense_rank() over(order by score desc) dense_rank --按照成绩排名,相同成绩排名⼀致,row_number() over(order by score desc) row_number --按照成绩依次排名,ntile(3) over (order by score desc) group_s --按照分数划分成绩梯队from s_score;排名/排序的时候,有时候,我们会想到利⽤伪列row_num,利⽤row_num确实可以解决某些场景下的问题(但是相对也⽐较复杂),⽽且有些场景下的问题却很难解决。
Oracle之分析函数
Oracle之分析函数⼀、分析函数 1、分析函数 分析函数是Oracle专门⽤于解决复杂报表统计需求的功能强⼤的函数,它可以在数据中进⾏分组然后计算基于组的某种统计值,并且每⼀组的每⼀⾏都可以返回⼀个统计值。
2、分析函数和聚合函数的区别 普通的聚合函数⽤group by分组,每个分组返回⼀个统计值,⽽分析函数采⽤partition by分组,并且每组每⾏都可以返回⼀个统计值。
3、分析函数的形式 分析函数带有⼀个开窗函数over(),包含分析⼦句。
分析⼦句⼜由下⾯三部分组成: partition by :分组⼦句,表⽰分析函数的计算范围,不同的组互不相⼲; ORDER BY:排序⼦句,表⽰分组后,组内的排序⽅式; ROWS/RANGE:窗⼝⼦句,是在分组(PARTITION BY)后,组内的⼦分组(也称窗⼝),此时分析函数的计算范围窗⼝,⽽不是PARTITON。
窗⼝有两种,ROWS和RANGE; 使⽤形式如下:OVER(PARTITION BY xxx PORDER BY yyy ROWS BETWEEN rowStart AND rowEnd) 注:窗⼝⼦句在这⾥我只说rows⽅式的窗⼝,range⽅式和滑动窗⼝也不提。
⼆、OVER() 函数 1、sql 查询语句的 order by 和 OVER() 函数中的 ORDER BY 的执⾏顺序 分析函数是在整个sql查询结束后(sql语句中的order by的执⾏⽐较特殊)再进⾏的操作, 也就是说sql语句中的order by也会影响分析函数的执⾏结果: [1] 两者⼀致:如果sql语句中的order by满⾜分析函数分析时要求的排序,那么sql语句中的排序将先执⾏,分析函数在分析时就不必再排序; [2] 两者不⼀致:如果sql语句中的order by不满⾜分析函数分析时要求的排序,那么sql语句中的排序将最后在分析函数分析结束后执⾏排序。
2、分析函数中的分组/排序/窗⼝分析函数包含三个分析⼦句:分组(partition by),排序(order by),窗⼝(rows/range)窗⼝就是分析函数分析时要处理的数据范围,就拿sum来说,它是sum窗⼝中的记录⽽不是整个分组中的记录,因此我们在想得到某个栏位的累计值时,我们需要把窗⼝指定到该分组中的第⼀⾏数据到当前⾏, 如果你指定该窗⼝从该分组中的第⼀⾏到最后⼀⾏,那么该组中的每⼀个sum值都会⼀样,即整个组的总和。
Oracle分析函数sumover介绍
Oracle分析函数sumover介绍其中,sum over函数是一种常用的分析函数,它用于对指定列进行求和计算,并返回每一行的累计总和。
以下是sum over函数的基本语法:```SUM(expression) OVER (PARTITION BY col1 [, col2, ...] ORDER BY col3 [, col4, ...] [ROWS <frame specification>])```其中,expression是要进行求和的列或表达式,col1、col2等是用于分组的列,col3、col4等是用于排序的列,frame specification是用于定义计算总和的范围。
sum over函数的作用可以通过一个简单的示例来说明。
假设我们有一个包含销售订单的表,其中包含订单号、产品名称和销售量等列。
我们想要计算每个产品的累计销售量,可以使用sum over函数来实现:```sqlSELECT order_id, product_name, sales_quantity,SUM(sales_quantity) OVER (PARTITION BY product_name ORDER BYorder_id) AS cumulative_salesFROM sales_orders;```在上述示例中,我们使用了PARTITION BY子句来按照产品名称进行分组,然后使用ORDER BY子句按照订单号进行排序。
通过在SUM函数中使用over子句,我们可以计算每个产品的累计销售量,并将结果作为新的列返回。
除了基本的用法之外,sum over函数还可以与其他函数组合使用,进一步扩展其功能。
例如,我们可以使用sum over函数来计算百分比:```sqlSELECT order_id, product_name, sales_quantity,sales_quantity / SUM(sales_quantity) OVER (PARTITION BY product_name) * 100 AS percentageFROM sales_orders;```在上述示例中,我们使用SUM函数计算每个产品的总销售量,并将结果作为分母,然后将每个销售数量除以总销售量并乘以100,得到每个产品的销售百分比。
Oracle分析函数Over()
Oracle分析函数Over()阅读⽬录⼀、Over()分析函数1、rank()/dense_rank over(partition by ... order by ...)2、min()/max() over(partition by ...)3、lead()/lag() over(partition by ... order by ...) 取前⾯/后⾯第n⾏记录4、FIRST_VALUE/LAST_VALUE() OVER(PARTITION BY ...) 取⾸尾记录5、ROW_NUMBER() OVER(PARTITION BY.. ORDER BY ..) 排序(应⽤:分页)6、sum/avg/count() over(partition by ..)7、 rows/range between … preceding and … following 上下范围内求值rows between … preceding and … following⼆、其他1、NULLS FIRST/LAST 将空值字段记录放到最前或最后显⽰2、NTILE(n)3、keep(dense_rank first/last)回到顶部⼀、Over()分析函数说明:聚合函数(如sum()、max()等)可以计算基于组的某种聚合值,但是聚合函数对于某个组只能返回⼀⾏记录。
若想对于某组返回多⾏记录,则需要使⽤分析函数。
1、rank()/dense_rank over(partition by ... order by ...)说明:over()在什么条件之上; partition by 按哪个字段划分组; order by 按哪个字段排序;注意: (1)使⽤rank()/dense_rank() 时,必须要带order by否则⾮法 (2)rank()/dense_rank()分级的区别: rank(): 跳跃排序,如果有两个第⼀级时,接下来就是第三级。