
oracle中start with的用法
oracle中start with的用法
Oracle中的START WITH是一种查询语句,它用于在层次结构(树型结构)中查询特定的节点或节点组。在层次结构中,通过使用连接查询,可以轻松地查找父节点和子节点,并查询特定节点的所有子级。而START WITH语句则允许我们从树型结构的特定节点开始查询,以查找它的下一级或其他级别的节点。
START WITH语句的语法如下:
SELECT [column_name(s)]
FROM table_name
WHERE condition
START WITH condition;
其中,column_name是所需的列的名称,table_name是要查询的表的名称,condition是查询条件,帮助我们筛选结果。START WITH子句用于指定要从哪个节点开始查询。如果没有提供START WITH子句,将从所有根节点中进行查询。
举个例子,假设我们有一个表EMPLOYEE,其中包含每个人的ID、姓名和经理ID。我们想要从经理开始查询其下属的信息。我们可以使用以下查询语句:
SELECT emp.ID, , emp.MANAGER_ID
FROM EMPLOYEE emp
WHERE emp.MANAGER_ID='
START WITH emp.ID='
在上述查询语句中,我们使用WHERE子句来指定我们希望查询的经理ID。然后,我们使用START WITH子句来指定我们希望从其下属开始查询,因为我们希望查询指定经理下面的子级,所以使用的条件是‘emp.ID='
还可以使用多个START WITH子句,这样我们就可以按照我们需要的方式遍历整个层次结构。例如,如果我们想要查询从一个特定节点到另一个特定节点的所有子节点,则可以使用如下查询语句:
SELECT emp.ID, , emp.MANAGER_ID
FROM EMPLOYEE emp
WHERE emp.MANAGER_ID='
START WITH emp.ID='
CONNECT BY PRIOR emp.ID=emp.MANAGER_ID
START WITH emp.ID='
在上述查询语句中,我们使用CONNECT BY子句来添加树型结构中的节点。我们使用PRIOR关键字将前一个子查询的emp.ID作为emp.MANAGER_ID的参数进一步查询我们需要的节点。因为我们希望查询从一个特定节点到另一个特定节点的所有子节点,所以我们使用多个START WITH子句,它们连接在一起,指定我们希望在这些节点之间遍历。
总之,START WITH语句可以帮助我们轻松地查询树形结构中的节点。我们可以使用WHERE和CONNECT BY子句进一步筛选和连接结果,以得到我们需要的数据。如果我们使用得当,这个功能将为我们提供很大的灵活性和查询效率。
startwith.....connectbyprior......递归查询
startwith.....connectbyprior......递归查询
Oracle⾃带的递归查询,部分国产数据库也⽀持(如达梦)
start with ...connect by prior ..
start with 后⾯跟的为起始⾏,从哪⾥开始,如果省略表⽰所有的都匹配
connect by 链接的条件
prior 和谁在⼀起谁⽜逼 ⼀般都是表⾥有⽗⼦关系的列,prior和⼦列在⼀起表⽰向下递归查询(包括⾃⼰)
prior 和⽗列在⼀起表⽰从⽗节点⽹上查找⽗节点(包括⾃⼰)
例如:start with childId = 10 connect by prior childId = parentId
表⽰从⼦节点的10开始,包括10向下查找start with childId = 10 connect by childId = prior parentId
表⽰从⼦节点10开始,⽹上查询各个⽗节点
oracle connect by level用法

oracle connect by level用法
Oracle的CONNECT BY LEVEL是一个非常强大的特性,它允许在查询中生成一个层次结构的结果集。这个功能通常用于处理树形数据,例如组织结构、产品分类等等。在本文中,我们将介绍CONNECT BY LEVEL的用法以及一些相关的参考内容。
CONNECT BY LEVEL的语法如下:
SELECT 列名
FROM 表名
START WITH 条件
CONNECT BY PRIOR 列名 = 列名;
其中,“列名”是你想要查询的列,可以是任何列;“表名”是你想要查询的表;“条件”是你想要查询的条件,可以是任何有效的WHERE子句;“PRIOR 列名”是用来连接每个层级的列。
下面是一个实际的例子,我们将使用EMP表来演示CONNECT BY LEVEL的用法。EMP表是一个包含有关员工的信息的表,其中包括员工的ID、姓名、领导的ID等。
首先,我们将创建一个例子表EMP,并向其中插入一些示例数据:
CREATE TABLE EMP (
EMP_ID NUMBER, EMP_NAME VARCHAR2(50),
LEADER_ID NUMBER);
INSERT INTO EMP (EMP_ID, EMP_NAME, LEADER_ID)
VALUES (1, 'John', NULL);
INSERT INTO EMP (EMP_ID, EMP_NAME, LEADER_ID)
VALUES (2, 'Tom', 1);
INSERT INTO EMP (EMP_ID, EMP_NAME, LEADER_ID)
VALUES (3, 'Jerry', 1);
INSERT INTO EMP (EMP_ID, EMP_NAME, LEADER_ID)
VALUES (4, 'Mike', 2);
INSERT INTO EMP (EMP_ID, EMP_NAME, LEADER_ID)
oracle树形结构层级查询之startwith....connectbyprior、le。。。
oracle树形结构层级查询之startwith....connectbyprior、le。。
。
浅谈oracle树状结构层级查询
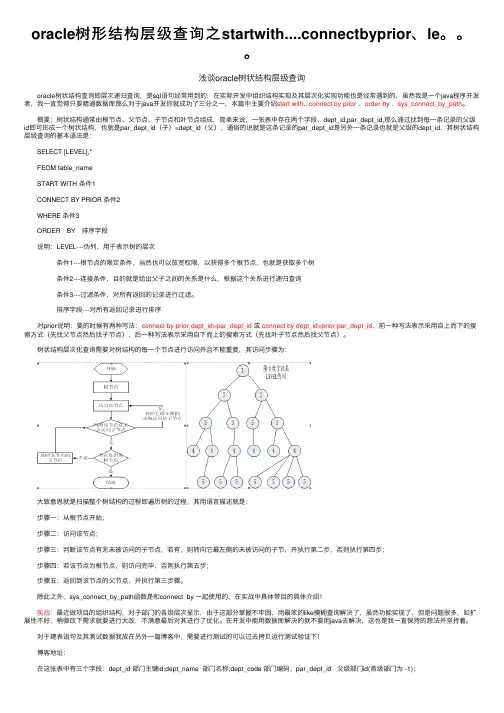
oracle树状结构查询即层次递归查询,是sql语句经常⽤到的,在实际开发中组织结构实现及其层次化实现功能也是经常遇到的,虽然我是⼀个java程序开发者,我⼀直觉得只要精通数据库那么对于java开发你就成功了三分之⼀,本篇中主要介绍start with...connect by prior 、order by 、sys_connect_by_path。
概要:树状结构通常由根节点、⽗节点、⼦节点和叶节点组成,简单来说,⼀张表中存在两个字段,dept_id,par_dept_id,那么通过找到每⼀条记录的⽗级id即可形成⼀个树状结构,也就是par_dept_id(⼦)=dept_id(⽗),通俗的说就是这条记录的par_dept_id是另外⼀条记录也就是⽗级的dept_id,其树状结构层级查询的基本语法是:
SELECT [LEVEL],*
FEOM table_name
START WITH 条件1
CONNECT BY PRIOR 条件2
WHERE 条件3
ORDER BY 排序字段
说明:LEVEL---伪列,⽤于表⽰树的层次
条件1---根节点的限定条件,当然也可以放宽权限,以获得多个根节点,也就是获取多个树
条件2---连接条件,⽬的就是给出⽗⼦之间的关系是什么,根据这个关系进⾏递归查询
条件3---过滤条件,对所有返回的记录进⾏过滤。
排序字段---对所有返回记录进⾏排序
对prior说明:要的时候有两种写法:connect by prior dept_id=par_dept_id 或 connect by dept_id=prior par_dept_id,前⼀种写法表⽰采⽤⾃上⽽下的搜索⽅式(先找⽗节点然后找⼦节点),后⼀种写法表⽰采⽤⾃下⽽上的搜索⽅式(先找叶⼦节点然后找⽗节点)。
oracle 树形排序语句

oracle 树形排序语句
树形排序是一种常用的排序方法,它可以将数据按照树的结构进行排列,使得数据之间的层次关系更加清晰。在Oracle数据库中,我们可以使用CONNECT BY子句和START WITH子句来实现树形排序。
1. 使用CONNECT BY子句和START WITH子句实现树形排序的语句如下:
```sql
SELECT *
FROM table_name
START WITH parent_id IS NULL
CONNECT BY PRIOR id = parent_id;
```
这段代码中,table_name是要进行排序的表名,parent_id是表示父节点的字段名,id是表示当前节点的字段名。通过START
WITH子句指定根节点,然后使用CONNECT BY子句指定节点之间的关系。
2. 如果要按照多个字段进行树形排序,可以在CONNECT BY子句中使用多个条件,并使用AND连接。
```sql
SELECT *
FROM table_name
START WITH parent_id IS NULL
CONNECT BY PRIOR id = parent_id AND PRIOR name =
parent_name;
```
这段代码中,name是表示当前节点的字段名,parent_name是表示父节点的字段名。通过多个条件进行排序,可以更加准确地表达节点之间的关系。
3. 使用LEVEL关键字可以获取当前节点在树中的层级。
```sql
SELECT id, name, LEVEL
FROM table_name
START WITH parent_id IS NULL
CONNECT BY PRIOR id = parent_id;
h2oracle模式startwith函数替换
h2oracle模式startwith函数替换
在Oracle数据库中,START WITH是一种在查询中使用的连接条件,它用于定义树结构中的起始节点。通常,START WITH函数用于在以层次结构组织的数据中找到一些节点的父节点或祖先节点。换句话说,通过使用START WITH,我们可以从给定的树结构中的特定节点开始,并通过连接条件追溯到根节点。
然而,在一些情况下,我们可能希望在查询中使用其他方法来替代STARTWITH函数。这可能是因为STARTWITH函数的性能不佳,或者因为我们希望使用不同的查询技术来实现相同的功能。以下是两种可替代STARTWITH函数的方法:
1. 使用递归查询(Recursive Query):
递归查询是一种能够自我引用的查询类型。它允许我们在查询中使用递归调用来遍历树结构,并在每个迭代步骤中连接到父节点。使用递归查询,我们可以模拟START WITH函数的功能,但是性能更好。下面是一个使用递归查询实现startwith函数的示例:
WITH recursive_tree (id, parent_id, name, level) AS
SELECT id, parent_id, name, 0
FROM tree
WHERE id = :start_node
UNIONALL
SELECT t.id, t.parent_id, , rt.level + 1 FROM tree t
INNER JOIN recursive_tree rt ON rt.parent_id = t.id
SELECT*
FROM recursive_tree;
2.使用CONNECTBY语句和PRIOR运算符:
CONNECT BY语句是Oracle数据库中一种用于遍历层次结构数据的特殊查询语句。在CONNECT BY语句中,我们可以使用PRIOR运算符来访问先前迭代步骤的行。这使得我们能够模拟START WITH函数的行为,并在每个迭代步骤中连接到父节点。以下是一个使用CONNECT BY和PRIOR运算符实现startwith函数的示例:
start with connect by prior快速简单理解 -回复

start with connect by prior快速简单理解 -回复
Connect by prior 是 Oracle 数据库中使用的一种递归查询方法,主要用于创建层次结构的查询。
在数据库中,数据可以以层次结构的形式组织,每个节点可以与一个或多个子节点相关联。使用 Connect by prior,我们可以根据父节点和子节点之间的关联关系快速查询出这种层次结构。在本文中,我将逐步解释
Connect by prior 的用法及其在数据库查询中的应用。
首先,让我们来了解一下 Connect by prior 的语法。它的基本形式如下:
SELECT columns
FROM table
WHERE condition
CONNECT BY PRIOR parent_column = child_column;
其中,columns 表示要查询的列,table 是要查询的表,condition 是查询的条件,parent_column 是父节点列,child_column 是子节点列。
在开始之前,我们需要创建一个示例表来演示 Connect by prior 的用法。假设我们有一个名为 employees 的表,其中包含员工的 ID 和上级的
ID。我们可以使用以下语句创建这个表:
CREATE TABLE employees (
employee_id NUMBER,
manager_id NUMBER,
employee_name VARCHAR2(100)
);
接下来,我们插入一些示例数据:
INSERT INTO employees VALUES (1, NULL, 'John');
INSERT INTO employees VALUES (2, 1, 'Tom');
INSERT INTO employees VALUES (3, 1, 'Jane');
INSERT INTO employees VALUES (4, 2, 'Bob');
Oracle序列的创建和使用
Oracle序列的创建和使⽤
1.创建序列
语法:
create sequence 序列名 [可选参数]
(序列名常定义为‘seq_XXX’的形式,创建序列不能使⽤replace)
可选参数说明:
increment by:序列每次增加的值,负数表⽰递减,缺省值为1;
start with:序列的初始值,缺省值为1;
maxvalue:序列可⽣成的最⼤值,缺省值为nomaxvalue,即不设置最⼤值;系统能产⽣的最⼤值为10的27次⽅;
minvalue:序列可⽣成的最⼩值,缺省值为nominvalue,即不设置最⼩值;
cycle:定义当序列达到最⼤/⼩值后是否循环,缺省值为不循环;nocycle:不循环;cycle:循环;如果不使⽤循环达到限制值后继续产
⽣新值就会出错;使⽤循环达到最⼤值后的下⼀个值为1,和start with设置的值⽆关,递增还是increment by设置的值;
cache:定义缓存序列的个数,缺省值为20,nocache表⽰不设置缓存;使⽤缓存可以提⾼序列的性能,但数据库出错时会造成数据丢失
使序列不连续;
例:创建⼀个循环不使⽤cache的序列
create sequence seq_userid
increment by 1
start with 1
maxvalue 99999
cycle
nocache;
2.序列的使⽤
语法:
序列名.[currval/nextval]
currval:表⽰当前值,新序列若没使⽤过nextval不能直接使⽤当前值,会报错;
nextval:表⽰序列的下⼀个值
例:查询序列的值
select seq_name.nextval from dual; --序列seq_name的下⼀个值
例:SQL语句中使⽤序列
insert into 表名 value(seq_name.currval)
3.删除修改序列
语法:
drop sequence [⽤户名.]序列名
alert sequence [⽤户名.]序列名 [可选参数]
oracle递归层级的写法
oracle递归层级的写法
在Oracle中,要实现递归层级查询,可以使用`CONNECT BY`子句。`CONNECT BY`子句用于执行递归查询,它允许您指定如何沿着表中的外键关系遍历树形结构。下面是一个简单的例子,假设我们有一个名为`employee`的表,其中包含员工的ID和上级员工的ID。我们想要查询员工及其所有下属的层级关系,可以使用`CONNECT
BY`子句来实现:
sql.
SELECT employee_id, employee_name, manager_id.
FROM employee.
START WITH manager_id = 100 -从顶层员工开始。
CONNECT BY PRIOR employee_id = manager_id; -沿着上级员工ID进行连接。
在这个例子中,`START WITH`指定了起始条件,即顶层员工的`manager_id`为100。`CONNECT BY PRIOR`指定了如何连接表中的行,即`employee_id`等于上级员工的`manager_id`。这样就可以查询出员工及其所有下属的层级关系。
需要注意的是,递归查询可能会导致性能问题,特别是在处理大量数据时。为了避免这种情况,可以使用递归查询的优化方法,例如使用`CONNECT_BY_ROOT`来获取根节点信息,或者使用`LEVEL`伪列来限制递归的层级深度。
总之,在Oracle中实现递归层级查询,可以使用`CONNECT BY`子句来指定递归条件,但需要注意性能和优化的问题。
oracle 递归查询逻辑
oracle 递归查询逻辑
Oracle是一种关系型数据库管理系统,它提供了一种强大的递归查询功能,可以在查询语句中使用递归查询逻辑来实现复杂的数据查询和处理操作。本文将详细介绍Oracle中递归查询的原理和使用方法。
递归查询是一种通过重复应用查询语句来解决复杂问题的方法。在Oracle中,递归查询可以通过使用WITH语句和CONNECT BY子句来实现。WITH语句用于定义一个或多个临时表,而CONNECT BY子句则用于指定递归查询的条件和连接关系。
我们先来了解一下WITH语句的使用方法。WITH语句可以将一个或多个查询块定义为一个临时表,这些查询块可以在后续的查询语句中引用。使用WITH语句可以提高查询语句的可读性和维护性,同时还可以避免重复执行相同的子查询。
WITH语句的语法如下:
```
WITH 表名 (列名1, 列名2, ...) AS (
查询语句1
UNION ALL
查询语句2
UNION ALL
... 查询语句n
)
```
其中,表名是临时表的名称,列名1、列名2等是临时表的列名,查询语句1、查询语句2等是定义临时表的查询语句。
接下来,我们来看一下CONNECT BY子句的使用方法。CONNECT BY子句用于指定递归查询的条件和连接关系。在递归查询中,每个查询块都必须包含一个起始条件和一个递归条件,起始条件用于指定递归查询的起始节点,而递归条件则用于指定递归查询的连接关系。
CONNECT BY子句的语法如下:
```
SELECT 列名1, 列名2, ...
FROM 表名
START WITH 起始条件
CONNECT BY 递归条件
```
其中,列名1、列名2等是要查询的列名,表名是要查询的表名,起始条件用于指定递归查询的起始节点,递归条件用于指定递归查询的连接关系。
在使用递归查询时,我们需要注意一些重要的事项。首先,递归查询必须包含一个终止条件,以避免无限递归。其次,递归查询可能会导致性能问题,特别是在处理大量数据时。因此,在使用递归查询时,我们应该谨慎选择查询语句和优化查询性能。
oracle递归函数
oracle递归函数
oracle start with connect by 使⽤⽅法
oracle中 connect by prior 递归算法
Oracle中start with...connect by prior⼦句使⽤⽅法 connect by 是结构化查询中⽤到的,其基本的语法是:
select ... from tablename start with 条件1
connect by 条件2
where 条件3;
例: select * from table
start with org_id = 'HBHqfWGWPy'
connect by prior org_id = parent_id;
简单说来是将⼀个树状结构存储在⼀张表⾥,⽐⽅⼀个表中存在两个字段:
org_id,parent_id那么通过表⽰每⼀条记录的parent是谁,就能够形成⼀个树状结构。
⽤上述语法的查询能够取得这棵树的全部记录。
当中:
条件1 是根结点的限定语句,当然能够放宽限定条件,以取得多个根结点,实际就是多棵树。
条件2 是连接条件,当中⽤PRIOR表⽰上⼀条记录,⽐⽅ CONNECT BY PRIOR org_id = parent_id就是说上⼀条记录的org_id 是本条记
录的parent_id,即本记录的⽗亲是上⼀条记录。 条件3 是过滤条件,⽤于对返回的全部记录进⾏过滤。
简介例如以下:
早扫描树结构表时,须要依此訪问树结构的每⼀个节点,⼀个节点仅仅能訪问⼀次,其訪问的过程例如以下:
第⼀步:从根节点開始;
第⼆步:訪问该节点;
第三步:推断该节点有⽆未被訪问的⼦节点,若有,则转向它最左側的未被訪问的⼦节,并运⾏第⼆步,否则运⾏第四步;
第四步:若该节点为根节点,则訪问完成,否则运⾏第五步;
第五步:返回到该节点的⽗节点,并运⾏第三步骤。
总之:扫描整个树结构的过程也即是中序遍历树的过程。