
perl正则表达式
一常规表达式中,/pattern/常用到的语法
除了换行字符\n外,找寻只有一个字符的字符串
x? 找寻0个或是1个x字符
x* 找寻0个或是0个以上的x字符
.* 找寻0个或是0个以上的任何字符
x+ 找寻0个或是1个以上的x字符
.+ 找寻1个或是1个以上的任何字符
{m} 找寻刚好是m个个数指定的字符
{m,n} 找寻在m个数个数以上,n个个数以下指定的字符
{m,} 找寻m个个数以上指定的字符
[] 找寻符合[]内的字符
[^] 找寻不符合[]内的字符
[0-9] 找寻符合0到9的任何一个字符
[a-z] 找寻符合a到z的任何一个字符
[^0-9] 找寻不符合0到9的任何一个字符
[^a-z] 找寻不符合a到z的任何一个字符
^ 找寻字符开头的字符
$ 找寻字符结尾的字符
\d 找寻一个digit(数字)的字符,和[0-9]语法一样
\d+ 找寻一个digit(数字)以上的字符串,和[0-9]+语法一样
\D 找寻一个non-digit(非数字)的字符,和[^0-9]语法一样
\D+ 找寻一个non-digit(非数字)以上的字符,和[^0-9]+语法一样\w 找寻一个英文字母或是数值的字符,和[a-zA-Z0-9]语法一样
\w+ 找寻一个以上英文字母或是数值的字符,和[a-zA-Z0-9]+语法一样
\W 找寻一个非英文字母,数值的字符,和[^a-zA-Z0-9]语法一样
\W+ 找寻一个以上非英文字母,数值的字符,和[^a-zA-Z0-9]+语法一样
\s 找寻一个空白的字符,和[\n\t\r\f]一样
\s+ 找寻一个以上空白的字符,和[\n\t\r\f]+一样
\S 找寻一个非空白的字符,和[^\n\t\r\f]一样
\S+ 找寻一个以上非空白的字符,和[^\n\t\r\f]+一样
\b 找寻一个不以英文字母,数值为边界的字符串
\B 找寻一个以英文字母,数值为边界的字符串
a|b|c 找到符合a字符或是b字符或是c字符的字符串
abc 找到一个含有abc的字符串
(pattern) ()这个符号是会记忆所找寻到的字符,是一个很实用的语法第一个()内所找到的字符串变成$1这个变量或是\1变量
第二个()内所找到的字符串变成$2这个变量或是\2变量
以此类推,笔者会在下一小节中详细介绍它的用法
/pattern/i i这个参数是代表忽略英文大小写的意思,也就是在找寻字符串的时候,不会去考虑英文的大小写
\ 如果要在pattern模式中找寻一个有特殊的意义的字符,要在这个字符前加上\这个符号,这样才会让这个特殊字符失效
二常规表达式(Regular Expression)的简单范例
看了上一小节文字处理模(Regular Expression)之的,初学者对于这个语法的应用可能还不是很清楚,所以笔者会在这一小节中,举出一些在常规表达式中常用的范例给大家看看:
/perl/ 找到含有perl的字符串
/^perl/ 找到开头是perl的字符串
/perl$/ 找到结尾是perl的字符串
/c|g|i/ 找到含有c或g或i的字符串
/cg{2,4}i/ 找到c后面跟着2个到4个g,再跟着i的字符串
/cg{2,}i/ 找到c后面跟着2个以上g,再跟着i的字符串
/cg{2}i/ 找到c后面跟着2个g,再跟着i的字符串
/cg*i/ 找到c后面跟着0个或多个g,再跟着i的字符串,如同
/cg{0,1}i/
/cg+i/ 找到c后面跟着一个以上g,再跟着c的字符串,如同/cg{1,}i/ /cg?i/ 找到c后面跟着0个或是一个g,再跟着c的字符串,如同
/cg{0,1}i/
/c.i/ 找到c后面跟着一个任意字符,再跟着i的字符串
/c..i/ 找到c后面跟着二个任意字符,再跟着i的字符串
/[cgi]/ 找到符合有这三个字符任意一个的字符串
/[^cgi]/ 找到没有这三个字符中任意一个的字符串
/\d/ 找寻符合数值的字符串
可以使用/\d+/来表示一个或是多个数值的字符串
/\D/ 找寻符合不是数值的字符串
可以使用/\D+/来表示一个或是更多个非数值的字符串
/\w/ 找寻符合英文字母,数值的字符串
可以使用/\w+/来表示一个或是更多个英文字母,数值的字符串/\W/ 找寻符合非英文字母,数值字符的字符串
可以使用/\W+/来表示一个或是更多个非英文字母,数值的字符
串
/\s/ 找寻符合空白的字符串
可以使用/\s+/来表示一个或是更多个空白字符的字符串
/\S/ 找寻符合不是空白的字符串
可以使用/\S+/来表示一个或是更多不是空白的字符的字符串/\*/ 找寻符合*这个符号的字符串,因为*在常规表达式中有它的特殊意思,所以要在这个特殊符号前加上\这个符号,这样才会让
这个特殊字符失效。
perl gtf正则表达式 匹配和提取

perl gtf正则表达式匹配和提取GTF文件(Gene Transfer Format)是一种常见的基因注释格式,用于描述基因的结构和功能信息。
在生物信息学中,对GTF文件进行正则表达式匹配和提取是常见的操作,可用于从GTF文件中提取感兴趣的基因信息。
在本文中,我们将一步一步回答如何使用Perl正则表达式匹配和提取GTF文件中的基因信息。
第一步:理解GTF文件的格式和内容在开始编写正则表达式之前,首先需要了解GTF文件的格式和内容。
GTF文件通常包含基因的注释信息,如基因的起始位置、终止位置、外显子和内含子的位置等。
每行记录表示一个基因的注释信息,使用制表符或空格对信息进行分隔。
以下是一个典型的GTF文件示例:chr1 hg38 gene 11869 14409 . + .gene_id "ENSG00000223972"; gene_name "DDX11L1";chr1 hg38 transcript 11869 14409 . + . gene_id "ENSG00000223972"; transcript_id "NR_046018";chr1 hg38 exon 11869 12227 . + .gene_id "ENSG00000223972"; transcript_id "NR_046018";chr1 hg38 exon 12613 12721 . + .gene_id "ENSG00000223972"; transcript_id "NR_046018";chr1 hg38 exon 13221 14409 . + .gene_id "ENSG00000223972"; transcript_id "NR_046018";在这个示例中,每行记录包含了一个基因或转录本的注释信息。
perl正则表达式详解(超详细)

9.3.1原则1正则表达式有三种形式:匹配、替换和转换。
在表 9-1 中列有三种正则表达式运算符。
接下来对每一个表达式给出详尽解释。
匹配:m/<regexp>/这种形式表明在//内部的正则表达将用于匹配 = ~或 !~左边的标量。
为了语法上的简化用/<regexp>/,略去m。
替换:s/<regexp>/<substituteText>/这种形式表明正则表达式<regexp>将被文本 <substituteText>替换,为了语法的简化用/<regexp>/<substituteText>略去s。
·转换:tr/<charClass>/<substituteClass>/这种形式包含一系列的字符—/<charClass>—同时把它们替换为<substituteClass>。
注意转换<tr>并不真正是一个正则表达式,但是对于用正则表达式难于处理的数据常使用它来进行操纵。
因此,tr/[0-9]/9876543210.组成1223456789,987654321等字符串。
通过使用=~(用英语讲:does,与“进行匹配”同)和!~(英语:doesn't,与“不匹配”同)把这些表达式捆绑到标量上。
作为这种类型的例子,下面我们给出六个示例正则表达式及相应的定义:$scalarName =~ s/a/b; # substitute the character a for b, and return true if this can happern$scalarName =~ m/a; # does the scalar $scalarName have an a in it? $scalarName =~ tr/A-Z/a-z/; # translate all capital letter with lower case ones, and return ture if this happens$scalarName !~ s/a/b/; # substitute the character a for b, and return false if this indeed happens.$scalarName !~ m/a/; # does the scalar $scalarName match the character a? Return false if it does.$scalarName !~ tr/0-9/a-j/; # translate the digits for the letters a thru j, and return false if this happens.如果我们输入像 horned toad =~ m/toad/ 这样的代码,则出现图 9-1 所示情况:另外,如果读者正在对特定变量 $_ 进行匹配(读者可能在while循环,map或grep中使用),则可以不用!~和=~。
perl 兼容的正则表达式

perl 兼容的正则表达式Perl 兼容的正则表达式是一种强大的模式匹配工具,它在许多编程语言和工具中得到了广泛的应用。
Perl 兼容的正则表达式支持许多高级特性,包括捕获组、零宽断言、反向引用等。
它还提供了丰富的元字符和修饰符,以便于对文本进行更加灵活和精确的匹配。
在 Perl 兼容的正则表达式中,可以使用元字符来表示特定的字符或字符集合,比如使用 `\d` 表示数字字符,`\w` 表示字母数字字符,`\s` 表示空白字符等。
此外,还可以使用方括号来表示字符范围,比如 `[a-z]` 表示小写字母,`[0-9]` 表示数字等。
Perl 兼容的正则表达式还支持捕获组,可以使用小括号来将匹配的部分进行分组,并在后续的操作中引用这些分组。
例如,可以使用 `(\d{3})-(\d{4})` 来匹配电话号码,并通过 `$1` 和 `$2`来引用区号和电话号码。
此外,Perl 兼容的正则表达式还支持零宽断言,包括正向零宽断言和负向零宽断言,用来指定匹配位置的条件,但不包括这些条件在匹配结果中。
比如 `(?<=\d{3})\d{4}` 可以匹配后面跟着三位数字的四位数字。
在修饰符方面,Perl 兼容的正则表达式也提供了丰富的选项,比如 `i` 用来表示不区分大小写,`s` 用来表示 `.` 匹配包括换行符在内的所有字符,`m` 用来表示多行模式等。
总之,Perl 兼容的正则表达式提供了丰富的功能和选项,能够满足复杂的模式匹配需求,并在诸多编程语言和工具中得到了广泛的应用。
希望这些信息能够帮助你更好地理解和应用 Perl 兼容的正则表达式。
perl 正则表达式例题

perl 正则表达式例题当然可以!以下是一些使用 Perl 正则表达式的例题:1. 匹配数字:```perl$string = "我有100个苹果和20个香蕉";if ($string =~ /(\d+)/) {print "匹配到的数字是: $1\n";}```输出:```匹配到的数字是: 100```2. 匹配邮箱地址:```perl$email = "";if ($email =~ /([a-zA-Z0-9_-]+[a-zA-Z0-9_-]+\.[a-zA-Z]{2,})/) { print "匹配到的邮箱地址是: $1\n";}```输出:```匹配到的邮箱地址是:```3. 匹配日期格式:YYYY-MM-DD```perl$date = "今天是";if ($date =~ /(\d{4})-(\d{2})-(\d{2})/) {print "匹配到的年份是: $1, 月份是: $2, 日期是: $3\n";}输出:```yaml匹配到的年份是: 2023, 月份是: 07, 日期是: 19```4. 替换字符串中的内容:```perl$text = "我喜欢吃苹果和香蕉";$new_text = $text =~ s/苹果/桃子/;print $new_text; 输出: 我喜欢吃桃子和香蕉```这些例题可以帮助你理解 Perl 正则表达式的使用方法和功能。
当然,Perl 正则表达式还有更多高级的用法和技巧,你可以查阅相关资料或参考 Perl 的官方文档来深入学习。
perl 正则 转换
perl 正则转换English Answer:## Perl Regular Expressions.Perl regular expressions are a powerful tool for searching and manipulating text. They are based on the syntax of the POSIX standard for regular expressions, but they have been extended to include many additional features.Perl regular expressions are used in a variety of ways, including:Searching for text.Replacing text.Extracting data from text.Validating input.Generating text.Perl regular expressions are made up of a series of patterns. Each pattern matches a specific sequence of characters. Patterns can be combined together using operators to create more complex expressions.The following are some of the most commonly used Perl regular expression operators:+ Matches one or more occurrences of the preceding pattern.Matches zero or one occurrences of the preceding pattern.| Matches either the preceding pattern or the following pattern.() Groups patterns together.[] Matches any character within the brackets.[^] Matches any character not within the brackets.Perl regular expressions can be used to perform a wide variety of tasks. Here are a few examples:Search for a specific word:perl.my $pattern = qr/Perl/;my $text = "Perl is a powerful programming language.";if ($text =~ $pattern) {。
正则表达式的基本用法
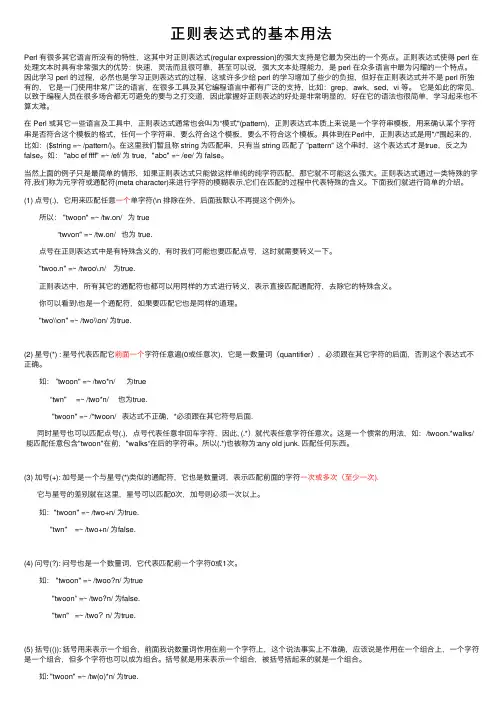
正则表达式的基本⽤法Perl 有很多其它语⾔所没有的特性,这其中对正则表达式(regular expression)的强⼤⽀持是它最为突出的⼀个亮点。
正则表达式使得 perl 在处理⽂本时具有⾮常强⼤的优势:快速,灵活⽽且很可靠,甚⾄可以说,强⼤⽂本处理能⼒,是 perl 在众多语⾔中最为闪耀的⼀个特点。
因此学习 perl 的过程,必然也是学习正则表达式的过程,这或许多少给 perl 的学习增加了些少的负担,但好在正则表达式并不是 perl 所独有的,它是⼀门使⽤⾮常⼴泛的语⾔,在很多⼯具及其它编程语⾔中都有⼴泛的⽀持,⽐如:grep,awk,sed,vi 等。
它是如此的常见,以致于编程⼈员在很多场合都⽆可避免的要与之打交道,因此掌握好正则表达的好处是⾮常明显的,好在它的语法也很简单,学习起来也不算太难。
在 Perl 或其它⼀些语⾔及⼯具中,正则表达式通常也会叫为“模式"(pattern),正则表达式本质上来说是⼀个字符串模板,⽤来确认某个字符串是否符合这个模板的格式,任何⼀个字符串,要么符合这个模板,要么不符合这个模板。
具体到在Perl中,正则表达式是⽤"/"围起来的,⽐如:($string =~ /pattern/)。
在这⾥我们暂且称 string 为匹配串,只有当 string 匹配了 ”pattern" 这个串时,这个表达式才是true,反之为false。
如: "abc ef ffff" =~ /ef/ 为 true,"abc" =~ /ee/ 为 false。
当然上⾯的例⼦只是最简单的情形,如果正则表达式只能做这样单纯的纯字符匹配,那它就不可能这么强⼤。
正则表达式通过⼀类特殊的字符,我们称为元字符或通配符(meta character)来进⾏字符的模糊表⽰,它们在匹配的过程中代表特殊的含义。
下⾯我们就进⾏简单的介绍。
正则表达式之任意字符
正则表达式之任意字符注:元字符包括\ | ( ) [ ] { } ^ $ * + ? . )•匹配中文字符的正则表达式: [\u4e00-\u9fa5]评注:匹配中文还真是个头疼的事,有了这个表达式就好办了•匹配双字节字符(包括汉字在内):[^\x00-\xff]评注:可以用来计算字符串的长度(一个双字节字符长度计2,ASCII字符计1)•匹配空白行的正则表达式:\n\s*\r评注:可以用来删除空白行•匹配HTML标记的正则表达式:<(\S*?)[^>]*>.*?</>|<.*? />评注:网上流传的版本太糟糕,上面这个也仅仅能匹配部分,对于复杂的嵌套标记依旧无能为力•匹配首尾空白字符的正则表达式:^\s*|\s*$评注:可以用来删除行首行尾的空白字符(包括空格、制表符、换页符等等),非常有用的表达式•匹配Email地址的正则表达式:\w+([-+.]\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)*评注:表单验证时很实用•匹配网址URL的正则表达式:[a-zA-z]+://[^\s]*评注:网上流传的版本功能很有限,上面这个基本可以满足需求•匹配帐号是否合法(字母开头,允许5-16字节,允许字母数字下划线):^[a-zA-Z][a-zA-Z0-9_]$评注:表单验证时很实用•匹配国内电话号码:\d-\d|\d-\d评注:匹配形式如或021-•匹配腾讯QQ号:[1-9][0-9]评注:腾讯QQ号从10000开始•匹配中国邮政编码:[1-9]\d(?!\d)评注:中国邮政编码为6位数字•匹配身份证:\d|\d评注:中国的身份证为15位或18位•匹配ip地址:\d+\.\d+\.\d+\.\d+评注:提取ip地址时有用•匹配特定数字:^[1-9]\d*$ //匹配正整数^-[1-9]\d*$ //匹配负整数^-?[1-9]\d*$ //匹配整数^[1-9]\d*|0$ //匹配非负整数(正整数 + 0)^-[1-9]\d*|0$ //匹配非正整数(负整数 + 0)^[1-9]\d*\.\d*|0\.\d*[1-9]\d*$ //匹配正浮点数^-([1-9]\d*\.\d*|0\.\d*[1-9]\d*)$ //匹配负浮点数^-?([1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0)$ //匹配浮点数^[1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0$ //匹配非负浮点数(正浮点数 +0)^(-([1-9]\d*\.\d*|0\.\d*[1-9]\d*))|0?\.0+|0$ //匹配非正浮点数(负浮点数 + 0)评注:处理大量数据时有用,具体应用时注意修正•匹配特定字符串:^[A-Za-z]+$ //匹配由26个英文字母组成的字符串^[A-Z]+$ //匹配由26个英文字母的大写组成的字符串^[a-z]+$ //匹配由26个英文字母的小写组成的字符串^[A-Za-z0-9]+$ //匹配由数字和26个英文字母组成的字符串^\w+$ //匹配由数字、26个英文字母或者下划线组成的字符串评注:最基本也是最常用的一些表达式今天在Java中想使用正则表达式来获取一段文本中的任意字符。
模式匹配(正则表达式)
替换操作符的选项如下表: 选项 g i e m o s x 描述 改变模式中的所有匹配 忽略模式中的大小写 替换字符串作为表达式 将待匹配串视为多行 仅赋值一次 将待匹配串视为单行 忽略模式中的空白
注:e选项把替换部分的字符串看作表达式,在替换之前先计算其值,如: $string = "0abc1"; $string =~ s/[a-zA-Z]+/$& x 2/e; # now $string = "0abcabc1"
=~:检验匹配是否成功:$result = $var =~ /abc/;若在该字符串中找到了该 模式,则返回非零值,即true,不匹配 则返回0,即false。 !~:则相反。
这两个操作符适于条件控制中,如: if ($question =~ /please/) { print ("Thank you for being polite!\n"); } else { print ("That was not very polite!\n"); }
注:split函数每次遇到分割模式,总是开始 一个新单词。 (1)若$line以空格打头,则@array的第 一个元素即为空元素。但其可以区分是否真 有单词。 (2)若$line中只有空格,则@array则为 空数组。且上例中TAB字符被当作一个单词。 注意修正。
2、字符 [ ]和[^] [ ]:意味着匹配一组字符中的一个,如 /a[0123456789]c/将匹配a加数字加c的字符 串。与+联合使用例:/d[eE]+f/匹配def、dEf、 deef、dEf、dEEEeeeEef等。 ^:表示除其之外的所有字符,如: /d[^eE]f/匹配d加非e字符加f的字符串。 3、字符 *和? 它们与+类似,区别在于 *:匹配0个、1 个或多个相同字符,?:匹配0个或1个该字 符。如/de*f/匹配df、def、deeeef等; /de?f/匹配df或def。
Perl+正则表达式讲解
Perl正则表达式讲解摘自《Perl编程详解》目录:9.3.1原则1正则表达式有三种形式:匹配、替换和转换。
在表 9-1 中列有三种正则表达式运算符。
接下来对每一个表达式给出详尽解释。
匹配:m/<regexp>/这种形式表明在//内部的正则表达将用于匹配 = ~或 !~左边的标量。
为了语法上的简化用/<regexp>/,略去m 。
替换:s/<regexp>/<substituteText>/这种形式表明正则表达式<regexp>将被文本<substituteText>替换,为了语法的简化用/<regexp>/<substituteText>略去s 。
·转换:tr/<charClass>/<substituteClass>/这种形式包含一系列的字符—/<charClass>—同时把它们替换为<substituteClass>。
注意转换<tr>并不真正是一个正则表达式,但是对于用正则表达式难于处理的数据常使用它来进行操纵。
因此,tr/[0-9]/9876543210.组成1223456789,987654321等字符串。
通过使用=~(用英语讲:does ,与“进行匹配”同)和!~(英语:doesn't ,与“不匹配”同)把这些表达式捆绑到标量上。
作为这种类型的例子,下面我们给出六个示例正则表达式及相应的定义:$scalar $scalarName =~ s/a/b;Name =~ s/a/b;Name =~ s/a/b; # substitute the character a for b, and return true if this can happern # substitute the character a for b, and return true if this can happern $scalarName =~ m/a;$scalarName =~ m/a; # does the scalar $scalarName have an a in it? # does the scalar $scalarName have an a in it?~ tr/A $scalarName =~ tr/A--Z/a Z/a--# translate all capital letter with lower case ones, and retur z/; # translate all capital letter with lower case ones, and return ture n ture if this happens if this happens$scalarName !~ s/a/b/;$scalarName !~ s/a/b/;# substitute the character a for b, and return false if this indeed happens.happens.$scalarName !~ m/a/;$scalarName !~ m/a/; # does the scalar $scalarName match the character a? Return false if it does.if it does.$scalarName !~ tr/0$scalarName !~ tr/0--9/a 9/a--j/;j/; # translate the digits for the letters a thru j, and return false if this happens.if this happens.如果我们输入像 horned toad =~ m/toad/ 这样的代码,则出现图 9-1 所示情况: 另外,如果读者正在对特定变量 $_ 进行匹配(读者可能在while 循环,map 或grep 中使用),则可以不用!~和=~。
perl正则表达式基础
perl正则表达式基础Perl正则表达式是一种高级文本模式匹配工具,它可以帮助我们在字符流中搜索、提取和替换特定的文本模式。
中括号在正则表达式中扮演着非常重要的角色,它可以用于定义一个字符集或字符范围,从而更灵活地匹配想要的字符。
本文将介绍正则表达式中的中括号以及相关的用法和技巧。
首先,让我们了解一下中括号在正则表达式中的基本用法。
中括号中包含想要匹配的字符集,它可以匹配其中任意一个字符。
例如,正则表达式`[abc]`将匹配字符'a'或'b'或'c'。
方括号内的字符集不区分大小写,因此`[abc]`也可以匹配'ABC'中的任意一个字母。
中括号还可以用于定义字符范围。
例如,正则表达式`[a-z]`将匹配任意小写字母,而`[A-Z]`将匹配任意大写字母。
同样地,我们也可以使用多个字符范围,例如`[a-zA-Z]`将匹配任意字母。
除了匹配单个字符或字符范围外,中括号还可以用于排除特定字符。
在中括号的首位添加一个脱字符(^)可以实现这个功能。
例如,正则表达式`[^0-9]`将匹配除了数字之外的任意字符。
中括号还可以用于匹配常见的字符类型。
例如,我们可以使用`\d`匹配任意数字字符,`\w`匹配任意字母、数字或下划线字符,`\s`匹配任意空白字符(包括空格、制表符、换行符等)。
这些字符类型可以与中括号一起使用,例如,正则表达式`[\d\s]`将匹配任意数字字符或空白字符。
在中括号内,我们还可以使用特殊字符来表示一些常见的字符集。
例如,正则表达式`[.]`将匹配点号字符(`.`),正则表达式`[+]`将匹配加号字符(`+`)。
如果想要匹配字符`[`,`(`,我们可以使用转义字符(`\`)来实现,即正则表达式`\[ \(`。
除了上述基本用法外,中括号还可以用于定义更复杂的字符集。
例如,我们可以在中括号内连续使用字符范围。
例如,正则表达式`[a-zA-Z0-9]`将匹配任意字母或数字字符。