
二叉树遍历和应用
1 if (!T) return;
2 Postorder(T->lchild, visit); // 遍历左子树 3 Postorder(T->rchild, visit);// 遍历右子树 4 visit(T->data); } // 访问结点
三种遍历的比较
A
先序序列:
B
C D
E F G
AB C DE FGH K
问题的提出
线性结构的遍历:因为每个结点均只有一个后 继,所以只有一条搜索路径。 二叉树的遍历:二叉树是非线性结构,每个结 点有两个后继,则存在如何遍历即按什么样的 搜索路径进行遍历的问题。
问题的提出
二叉树存在下述三条搜索路径:
1.先上后下的按层次遍历;
2.先左(子树)后右(子树)的遍历;
A p D F G i P->D P->A 访问:C B
F
G
(5)
(6)
A
A
i B P->E P->D P->A 访问:C B C E p G D i P->D P->A 访问:C B E (8)
B
C p (7) D
E
G
F
F
A
A
i B P->G P->D P->A 访问:C B E (9) p A C E G D F i P->D P->A 访问:C B E G (10)
根
左 子树
右 子树
作;否则, (1)后序遍历左子树; (2)后序遍历右子树; (3)访问根结点。
后序(根)遍历
A B C
E
F G H K
DCB HKGFE A
D
后序遍历
void Postorder (BiTree T, void( *visit)(TElemType& e))
{ // 后序遍历二叉树
二叉树的遍历和应用
复习 二叉树的遍历
问题的提出 递归遍历算法 非递归遍历算法
二叉树遍历算法的应用
小结和作业
复习
在二叉树的第 i 层上至多有2i-1 个结点。(i≥1) 深度为 k 的二叉树上至多含2k-1 个结点(k≥1) 对任何一棵二叉树,若它含有n0 个叶子结点、n2 个 度为 2 的结点,则必存在关系式:n0 = n2+1 具有 n 个结点的完全二叉树的深度为 log2n +1
复习
若对含 n 个结点的完全二叉树从上到下且从左至右进 行 1 至 n 的编号,则对完全二叉树中任意一个编号为
i 的结点:
(1) 若 i=1,则该结点是二叉树的根,无双亲, 否则,
编号为 i/2 的结点为其双亲结点;
(2) 若 2i>n,则该结点无左孩子, 否则,编号为 2i 的结点为其左孩子结点;
D
根 E
链式存储—双亲链表
typedef struct BPTNode { // 结点结构 TElemType data; int parent; // 指向双亲的指针 char LRTag; // 左、右孩子标志域 } BPTNode
链式存储—双亲链表
typedef struct BPTree{ // 树结构 BPTNode nodes[MAX_TREE_SIZE]; int num_node; // 结点数目 int root; // 根结点的位置 } BPTree
结点结构:
parent
lchild
data
rchild
链式存储—双亲链表
结点结构: data parent LRTag
数据域 双亲域,存储当 前结点双亲结点 的存储位置 左右孩子标志, 如果是其双亲 的左孩子,则 填写“L”;如果 是右孩子,则 填写“R”
链式存储—双亲链表
A B C F
0 B 1 D 2 C 3 E 4 A 5 F 6 4 4 0 1 -1 3 L R R R L
(3) 若 2i+1>n,则该结点无右孩子结点,
否则,编号为2i+1 的结点为其右孩子结点。
二叉树的顺序存储
完全二叉树:从上到下,从左往右依次编号
1
A
2 4
B
5
3
C
7
D I
9
E J
6
F
G
H
8
10
0
1
2
3 4 5
6 7
8
9 10 J
A B C D E F
G H I
二叉树的顺序存储
一般的二叉树:想象成一个完全二叉树 A B C E D F A B 0 D 0 0 C
中序序列:
BDCAEHGKF
后序序列:
H
K
DCBHKGFEA
三种遍历的比较
1、如果不考虑visit,三种遍历的算法在结构 上是一样的,因此,压栈和出栈的过程相同。 2、三种遍历的执行过程是不一样的(visit的 位置不一样)。
3、由前序序列和中序序列,或者后序和中序
序列可以唯一确定一颗二叉树
中序遍历-执行过程
D 5
1
E 6 7
0 1
F 8
0
3 4
1 0
9 10 11 12 13 14
0 0
0 0 0 1
二叉树的顺序存储
#define MAX_TREE_SIZE 100 // 二叉树的最大结点数 typedef TElemType SqBiTree[MAX_TREE_SIZE]; // 1号单元存储根结点 SqBiTree bt; 适合完全二叉树(书上的定义0号单元?)
{ // 中序遍历二叉树 1 if (!T) return; 2 Inorder(T->lchild, visit); // 遍历左子树 3 visit(T->data); } // 访问结点
4 Inorder(T->rchild, visit);// 遍历右子树
后序(根)遍历
若二叉树为空树,则空操
A
B
E
C
D
Null Null
Null
Null
Null
Null
NULL C1 C1 B1 A1
C2 B1 A1
NULL B1 A1 B2 A1 D1 A1
B1 A1 A1
B1 A1
中序遍历-算法6.2
Status InOrder(BiTree T, Status(*visit)(TElemType e){ InitStack(S); Push(S, T); while(!StackEmpty(S)){ while(GetTop(S, p) && p) {//栈顶不是空指针 push(S, p->lchild ); Pop(S, p); if(!StackEmpty(S)){ Pop(S, p); visit(p); Push(S, p->rchild;} }//while }
0 0
0 0 F
E
0
二叉树的顺序存储
1
A
2 4
B
5
3
C
7
0 0
8
D 0
11
6
0 0
12
E
0
9
0
10
0
13
F
14
二叉树的顺序存储
1
A
2
B
3
C
7
D
5
E
F
14
二叉树的顺序存储
1
2
B
D
5
A
3
C
7
E
如何知道有无数据?
F
14
0
1 2
3 4
5
6
7
8
9 10 11 12 13 14
A B C 0 1 2
1 1
问题的提出
在实际应用中,经常需要在二叉树 中查找具有某些特征的结点,或者对树 中的全部结点逐一进行某种处理,这就 提出了二叉树的遍历的问题。
问题的提出
定义:顺着某一条搜索路径巡访二叉树中的结 点,使得每个结点均被访问一次,而且仅被访 问一次。 作用: 遍历的目的是线性化,使二叉树中的 结点能够按照某种次序排列在一个线性队列上, 便于处理。
算法6.3
p A B
非递归算法 p
B A
C
D
C
D E G A
i
i
F
E
G A
P->A
(1)
F
P->B P->A (2)
p
C
B D E F
i P->C P->B P->A (3) C
B D F G 访问:C i
p=NULL E (4)
P->B P->A
G
p B C E
A B
D i C P->A 访问:C B E
DLR,LDR,LRD DRL,RDL,RLD
3.先右(子树)后左(子树)的遍历。
先左后右的遍历算法
先(根)序的遍历算法
根
中(根)序的遍历算法
左 子树 右 子树
后(根)序的遍历算法
先序(根)遍历
若二叉树为空树,则空操作;
根
否则, (1)访问根结点 (2)先序遍历左子树
左 子树
右 子树
(3)先序遍历右子树
B
C D
E
G P=NULL A B
F
p D
C
B D E F p i P->F P->A 访问:C B E G D
C
E (11)
i
汇编二叉树的遍历
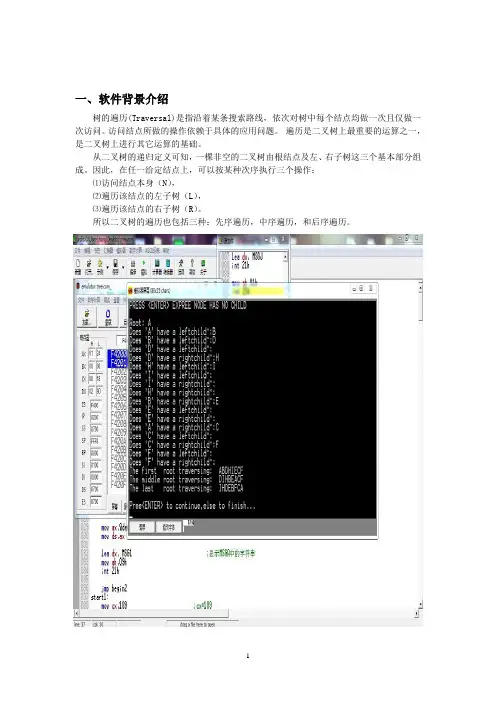
一、软件背景介绍树的遍历(Traversal)是指沿着某条搜索路线,依次对树中每个结点均做一次且仅做一次访问。
访问结点所做的操作依赖于具体的应用问题。
遍历是二叉树上最重要的运算之一,是二叉树上进行其它运算的基础。
从二叉树的递归定义可知,一棵非空的二叉树由根结点及左、右子树这三个基本部分组成。
因此,在任一给定结点上,可以按某种次序执行三个操作:⑴访问结点本身(N),⑵遍历该结点的左子树(L),⑶遍历该结点的右子树(R)。
所以二叉树的遍历也包括三种:先序遍历,中序遍历,和后序遍历。
图1:程序显示结果二、核心算法思想二叉树的存储:在内存中为数组binary分配一个大小为63(0,0,0)的存储空间,所有数组元素初始化为0,用来存放二叉树。
每三个连续的数组地址存放一个节点:第一个地址存放节点的值;第二个地址存放有无左孩子的信息,如果有则将其置为1,否则为0;第三个地址存放有无右孩子的信息,如果有则将其置为1,否则为0。
将binary的首址偏移赋给si,cx初始化为0用来计数,用回车代表输入的为空,即没有输入。
按先根存储的方式来存二叉树,首先输入一个字符,若为回车则退出程序,否则cx+3且调用函数root。
然后该结点若有左孩子,调用leftchild函数,置该结点标志即第二个地址中的0为1,该结点进栈,再存储左孩子结点,递归调用左右,若没有左孩子,看有没有右孩子,若有,则调用rightchild置该结点标志位即上第三个地址中的0为1,然后该结点进栈,再存储右孩子结点,递归调用左右,整个用cx计数,数组binary中每多一个节点,cx加3。
此存储方式正好符合先序遍历思想。
遍历二叉树的执行踪迹:三种递归遍历算法的搜索路线相同,具体线路为:从根结点出发,逆时针沿着二叉树外缘移动,对每个结点均途径三次,最后回到根结点。
二叉树的遍历有常用的三种方法,分别是:先根次序、中根次序、后根次序。
为了验证这几种遍历算法的区别,本次的实验将会实现所有的算法。
二叉树的遍历和应用
内蒙古科技大学本科生课程设计说明书题目:数据结构课程设计——二叉树的遍历和应用学生姓名:学号:专业:班级:指导教师:2013年5月29日内蒙古科技大学课程设计说明书内蒙古科技大学课程设计任务书I内蒙古科技大学课程设计说明书目录内蒙古科技大学课程设计任务书..............................................................错误!未定义书签。
目录 (II)第一章需求分析 (3)1.1课程设计目的 (3)1.2任务概述 (3)1.3课程设计内容 (3)第二章概要设计 (5)2.1设计思想 (5)2.2二叉树的遍历 (5)2.3运行界面设计 (6)第三章详细设计 (7)3.1二叉树的生成 (7)3.2二叉树的先序遍历 (7)3.3 二叉树的中序遍历 (8)3.4二叉树的后续遍历 (8)3.5主程序的设计 (8)第四章测试分析 (11)4.1二叉树的建立 (11)4.2二叉树的先序、中序、后序遍历 (11)第五章课程设计总结 (12)附录:程序代码 (13)致谢 ···········································································································错误!未定义书签。
二叉树遍历算法的应用

二叉树遍历算法的应用二叉树是一种常用的数据结构,它由节点和节点之间的链接组成。
每个节点最多有两个子节点,分别称为左子节点和右子节点。
二叉树遍历算法是指按照一定的顺序访问二叉树中的所有节点,经典的二叉树遍历算法有前序遍历、中序遍历和后序遍历。
这些遍历算法在计算机科学中有广泛的应用。
一、前序遍历前序遍历算法的访问顺序是先访问根节点,然后依次访问左子树和右子树。
在实际应用中,前序遍历算法十分常见,具有以下几个应用:1.树的复制:如果需要复制一棵二叉树,可以使用前序遍历算法遍历原树,然后按照递归或迭代的方式创建新节点,并复制原节点的值。
2.表达式求值:对于一个二叉树表示的数学表达式,前序遍历算法可以用来计算表达式的值。
遍历到运算符节点时,先计算左子表达式的值,然后计算右子表达式的值,最后根据运算符进行计算。
3.文件系统遍历:文件系统可以被视为一个树状结构,前序遍历算法可以按照前序的顺序遍历文件系统中的所有文件和文件夹。
二、中序遍历中序遍历算法的访问顺序是先访问左子树,然后访问根节点,最后访问右子树。
中序遍历算法也有多个应用:1.二叉树的中序遍历得到的节点值是按照从小到大的顺序排列的。
因此,可以使用中序遍历算法验证一个二叉树是否为二叉树。
2.二叉树中序遍历的结果可以用来实现按照升序排列的有序集合的功能。
例如,在数据库中存储的数据可以通过中序遍历的结果进行排序。
3.中序遍历算法可以将一个二叉树转换为一个有序的双向链表。
在遍历过程中,维护一个前驱节点和一个后继节点,并进行链接操作。
三、后序遍历后序遍历算法的访问顺序是先访问左子树,然后访问右子树,最后访问根节点。
后序遍历算法也有多个应用:1.后序遍历算法可以用来计算二叉树的深度。
在遍历过程中,可以维护一个全局变量来记录最大深度。
2.后序遍历算法可以用来判断一个二叉树是否为平衡二叉树。
在遍历过程中,可以比较左右子树的高度差,判断是否满足平衡二叉树的定义。
3.后序遍历算法可以用来释放二叉树的内存。
二叉树的遍历及常用算法
⼆叉树的遍历及常⽤算法⼆叉树的遍历及常⽤算法遍历的定义:按照某种次序访问⼆叉树上的所有结点,且每个节点仅被访问⼀次;遍历的重要性:当我们需要对⼀颗⼆叉树进⾏,插⼊,删除,查找等操作时,通常都需要先遍历⼆叉树,所有说:遍历是⼆叉树的基本操作;遍历思路:⼆叉树的数据结构是递归定义(每个节点都可能包含相同结构的⼦节点),所以遍历也可以使⽤递归,即结点不为空则继续递归调⽤每个节点都有三个域,数据与,左孩⼦指针和右孩⼦之指针,每次遍历只需要读取数据,递归左⼦树,递归右⼦树,这三个操作三种遍历次序:根据访问三个域的不同顺序,可以有多种不同的遍历次序,⽽通常对于⼦树的访问都按照从左往右的顺序;设:L为遍历左⼦树,D为访问根结点,R为遍历右⼦树,且L必须位于R的前⾯可以得出以下三种不同的遍历次序:先序遍历操作次序为DLR,⾸先访问根结点,其次遍历根的左⼦树,最后遍历根右⼦树,对每棵⼦树同样按这三步(先根、后左、再右)进⾏中序遍历操作次序为LDR,⾸先遍历根的左⼦树,其次访问根结点,最后遍历根右⼦树,对每棵⼦树同样按这三步(先左、后根、再右)进⾏后序遍历操作次序为LRD,⾸先遍历根的左⼦树,其次遍历根的右⼦树,最后访问根结点,对每棵⼦树同样按这三步(先左、后右、最后根)进⾏层次遍历层次遍历即按照从上到下从左到右的顺序依次遍历所有节点,实现层次遍历通常需要借助⼀个队列,将接下来要遍历的结点依次加⼊队列中;遍历的应⽤“遍历”是⼆叉树各种操作的基础,可以在遍历过程中对结点进⾏各种操作,如:对于⼀棵已知⼆叉树求⼆叉树中结点的个数求⼆叉树中叶⼦结点的个数;求⼆叉树中度为1的结点个数求⼆叉树中度为2的结点个数5求⼆叉树中⾮终端结点个数交换结点左右孩⼦判定结点所在层次等等...C语⾔实现:#include <stdio.h>//⼆叉链表数据结构定义typedef struct TNode {char data;struct TNode *lchild;struct TNode *rchild;} *BinTree, BinNode;//初始化//传⼊⼀个指针令指针指向NULLvoid initiate(BinTree *tree) {*tree = NULL;}//创建树void create(BinTree *BT) {printf("输⼊当前结点值: (0则创建空节点)\n");char data;scanf(" %c", &data);//连续输⼊整形和字符时.字符变量会接受到换⾏,所以加空格if (data == 48) {*BT = NULL;return;} else {//创建根结点//注意开辟的空间⼤⼩是结构体的⼤⼩⽽不是结构体指针⼤⼩,写错了不会⽴马产⽣问题,但是后续在其中存储数据时极有可能出现内存访问异常(飙泪....) *BT = malloc(sizeof(struct TNode));//数据域赋值(*BT)->data = data;printf("输⼊节点 %c 的左孩⼦ \n", data);create(&((*BT)->lchild));//递归创建左⼦树printf("输⼊节点 %c 的右孩⼦ \n", data);create(&((*BT)->rchild));//递归创建右⼦树}}//求双亲结点(⽗结点)BinNode *Parent(BinTree tree, char x) {if (tree == NULL)return NULL;else if ((tree->lchild != NULL && tree->lchild->data == x) || (tree->rchild != NULL && tree->rchild->data == x))return tree;else{BinNode *node1 = Parent(tree->lchild, x);BinNode *node2 = Parent(tree->rchild, x);return node1 != NULL ? node1 : node2;}}//先序遍历void PreOrder(BinTree tree) {if (tree) {//输出数据printf("%c ", tree->data);//不为空则按顺序继续递归判断该节点的两个⼦节点PreOrder(tree->lchild);PreOrder(tree->rchild);}}//中序void InOrder(BinTree tree) {if (tree) {InOrder(tree->lchild);printf("%c ", tree->data);InOrder(tree->rchild);}}//后序void PostOrder(BinTree tree) {if (tree) {PostOrder(tree->lchild);PostOrder(tree->rchild);printf("%c ", tree->data);}}//销毁结点递归free所有节点void DestroyTree(BinTree *tree) {if (*tree != NULL) {printf("free %c \n", (*tree)->data);if ((*tree)->lchild) {DestroyTree(&((*tree)->lchild));}if ((*tree)->rchild) {DestroyTree(&((*tree)->rchild));}free(*tree);*tree = NULL;}}// 查找元素为X的结点使⽤的是层次遍历BinNode *FindNode(BinTree tree, char x) {if (tree == NULL) {return NULL;}//队列BinNode *nodes[1000] = {};//队列头尾位置int front = 0, real = 0;//将根节点插⼊到队列尾nodes[real] = tree;real += 1;//若队列不为空则继续while (front != real) {//取出队列头结点输出数据BinNode *current = nodes[front];if (current->data == x) {return current;}front++;//若当前节点还有⼦(左/右)节点则将结点加⼊队列if (current->lchild != NULL) {nodes[real] = current->lchild;real++;}if (current->rchild != NULL) {nodes[real] = current->rchild;real++;}}return NULL;}//层次遍历// 查找元素为X的结点使⽤的是层次遍历void LevelOrder(BinTree tree) {if (tree == NULL) {return;}//队列BinNode *nodes[1000] = {};//队列头尾位置int front = 0, real = 0;//将根节点插⼊到队列尾nodes[real] = tree;real += 1;//若队列不为空则继续while (front != real) {//取出队列头结点输出数据BinNode *current = nodes[front];printf("%2c", current->data);front++;//若当前节点还有⼦(左/右)节点则将结点加⼊队列if (current->lchild != NULL) {nodes[real] = current->lchild;real++;}if (current->rchild != NULL) {nodes[real] = current->rchild;real++;}}}//查找x的左孩⼦BinNode *Lchild(BinTree tree, char x) {BinTree node = FindNode(tree, x);if (node != NULL) {return node->lchild;}return NULL;}//查找x的右孩⼦BinNode *Rchild(BinTree tree, char x) {BinTree node = FindNode(tree, x);if (node != NULL) {return node->rchild;}return NULL;}//求叶⼦结点数量int leafCount(BinTree *tree) {if (*tree == NULL)return 0;//若左右⼦树都为空则该节点为叶⼦,且后续不⽤接续递归了else if (!(*tree)->lchild && !(*tree)->rchild)return 1;else//若当前结点存在⼦树,则递归左右⼦树, 结果相加return leafCount(&((*tree)->lchild)) + leafCount(&((*tree)->rchild));}//求⾮叶⼦结点数量int NotLeafCount(BinTree *tree) {if (*tree == NULL)return 0;//若该结点左右⼦树均为空,则是叶⼦,且不⽤继续递归else if (!(*tree)->lchild && !(*tree)->rchild)return 0;else//若当前结点存在左右⼦树,则是⾮叶⼦结点(数量+1),在递归获取左右⼦树中的⾮叶⼦结点,结果相加 return NotLeafCount(&((*tree)->lchild)) + NotLeafCount(&((*tree)->rchild)) + 1;}//求树的⾼度(深度)int DepthCount(BinTree *tree) {if (*tree == NULL)return 0;else{//当前节点不为空则深度+1 在加上⼦树的⾼度,int lc = DepthCount(&((*tree)->lchild)) + 1;int rc = DepthCount(&((*tree)->rchild)) + 1;return lc > rc?lc:rc;// 取两⼦树深度的最⼤值 }}//删除左⼦树void RemoveLeft(BinNode *node){if (!node)return;if (node->lchild)DestroyTree(&(node->lchild));node->lchild = NULL;}//删除右⼦树void RemoveRight(BinNode *node){if (!node)return;if (node->rchild)DestroyTree(&(node->rchild));node->rchild = NULL;}int main() {BinTree tree;create(&tree);BinNode *node = Parent(tree, 'G');printf("G的⽗结点为%c\n",node->data);BinNode *node2 = Lchild(tree, 'D');printf("D的左孩⼦结点为%c\n",node2->data);BinNode *node3 = Rchild(tree, 'D');printf("D的右孩⼦结点为%c\n",node3->data);printf("先序遍历为:");PreOrder(tree);printf("\n");printf("中序遍历为:");InOrder(tree);printf("\n");printf("后序遍历为:");PostOrder(tree);printf("\n");printf("层次遍历为:");LevelOrder(tree);printf("\n");int a = leafCount(&tree);printf("叶⼦结点数为%d\n",a);int b = NotLeafCount(&tree);printf("⾮叶⼦结点数为%d\n",b);int c = DepthCount(&tree);printf("深度为%d\n",c);//查找F节点BinNode *node4 = FindNode(tree,'C');RemoveLeft(node4);printf("删除C的左孩⼦后遍历:");LevelOrder(tree);printf("\n");RemoveRight(node4);printf("删除C的右孩⼦后遍历:");LevelOrder(tree);printf("\n");//销毁树printf("销毁树 \n");DestroyTree(&tree);printf("销毁后后遍历:");LevelOrder(tree);printf("\n");printf("Hello, World!\n");return 0;}测试:测试数据为下列⼆叉树:运⾏程序复制粘贴下列内容:ABDGHECKFIJ特别感谢:iammomo。
二叉树遍历操作的基本应用(复制、求深度、求叶子数、求节点数等)
二叉树遍历操作的基本应用(复制、求深度、求叶子数、求节点数等)1. 引言1.1 概述二叉树是计算机科学领域中常用的数据结构之一,具有广泛的应用场景。
在二叉树的操作中,遍历是其中最基本和常见的操作之一。
通过遍历,我们可以按照特定规则依次访问二叉树中的所有节点。
本文将探讨二叉树遍历操作的基本应用,包括复制、求深度、求叶子数、求节点数等。
这些操作不仅在实际开发中有重要意义,而且对于理解和掌握二叉树数据结构及其相关算法也具有重要作用。
1.2 文章结构本文将分为五个部分进行论述。
首先,在引言部分(第1节)我们将概述文章的主题和目标。
紧接着,在第2节中,我们将介绍二叉树遍历的基本应用,包括复制、求深度、求叶子数和求节点数等。
在第3节中,我们将详细解析这些基本应用,并给出相应算法和实例分析。
接下来,在第4节中,我们将通过实际案例应用来验证并讨论这些基本应用的性能与适用范围。
最后,在第5节中总结全文内容,并对未来研究方向进行展望。
1.3 目的本文的目的是通过对二叉树遍历操作的基本应用进行详细剖析,帮助读者深入理解和掌握二叉树数据结构及其相关算法。
同时,我们希望通过实际案例应用与讨论,探讨如何优化算法性能、提高效率以及适应大规模二叉树遍历问题。
通过本文的阅读,读者将能够全面了解并应用二叉树遍历操作的基本方法,在实际开发中解决相关问题,并为进一步研究和探索提供思路与参考。
该部分主要介绍了文章的概述、结构和目的,引导读者了解全文并明确阅读目标。
2. 二叉树遍历的基本应用:二叉树是一种常见的数据结构,其遍历操作可以应用于多种实际问题中。
本节将介绍四个基本的二叉树遍历应用:复制二叉树、求二叉树的深度、求二叉树的叶子数和求二叉树的节点数。
2.1 复制二叉树:复制一个二叉树意味着创建一个与原始二叉树结构完全相同的新二叉树。
该应用场景在涉及对原始数据进行修改或者对数据进行独立操作时非常有用。
复制操作可以以递归方式实现,通过先复制左子树,再复制右子树,最后创建一个与当前节点值相等的新节点来完成。
二叉树,树,森林遍历之间的对应关系

二叉树,树,森林遍历之间的对应关系一、引言在计算机科学中,数据结构是非常重要的知识点之一。
而树这一数据结构,作为基础的数据结构之一,在软件开发中有着广泛的应用。
本文将重点探讨二叉树、树和森林遍历之间的对应关系,帮助读者更加全面地理解这些概念。
二、二叉树1. 二叉树的定义二叉树是一种特殊的树结构,每个节点最多有两个子节点,分别称为左子节点和右子节点。
二叉树可以为空,也可以是一棵空树。
2. 二叉树的遍历在二叉树中,有三种常见的遍历方式,分别是前序遍历、中序遍历和后序遍历。
在前序遍历中,节点的访问顺序是根节点、左子树、右子树;在中序遍历中,节点的访问顺序是左子树、根节点、右子树;在后序遍历中,节点的访问顺序是左子树、右子树、根节点。
3. 二叉树的应用二叉树在计算机科学领域有着广泛的应用,例如用于构建文件系统、在数据库中存储有序数据、实现算法中的搜索和排序等。
掌握二叉树的遍历方式对于理解这些应用场景非常重要。
三、树1. 树的定义树是一种抽象数据类型,由n(n>0)个节点组成一个具有层次关系的集合。
树的特点是每个节点都有零个或多个子节点,而这些子节点又构成了一颗子树。
树中最顶层的节点称为根节点。
2. 树的遍历树的遍历方式有先根遍历、后根遍历和层次遍历。
在先根遍历中,节点的访问顺序是根节点、子树1、子树2...;在后根遍历中,节点的访问顺序是子树1、子树2...,根节点;在层次遍历中,节点的访问顺序是从上到下、从左到右依次访问每个节点。
3. 树的应用树广泛用于分层数据的表示和操作,例如在计算机网络中的路由算法、在操作系统中的文件系统、在程序设计中的树形结构等。
树的遍历方式对于处理这些应用来说至关重要。
四、森林1. 森林的定义森林是n(n>=0)棵互不相交的树的集合。
每棵树都是一颗独立的树,不存在交集。
2. 森林的遍历森林的遍历方式是树的遍历方式的超集,对森林进行遍历就是对每棵树进行遍历的集合。
3. 森林的应用森林在实际编程中经常用于解决多个独立树结构的问题,例如在数据库中对多个表进行操作、在图像处理中对多个图形进行处理等。
数据结构之二叉树(BinaryTree)
数据结构之⼆叉树(BinaryTree)⽬录导读 ⼆叉树是⼀种很常见的数据结构,但要注意的是,⼆叉树并不是树的特殊情况,⼆叉树与树是两种不⼀样的数据结构。
⽬录 ⼀、⼆叉树的定义 ⼆、⼆叉树为何不是特殊的树 三、⼆叉树的五种基本形态 四、⼆叉树相关术语 五、⼆叉树的主要性质(6个) 六、⼆叉树的存储结构(2种) 七、⼆叉树的遍历算法(4种) ⼋、⼆叉树的基本应⽤:⼆叉排序树、平衡⼆叉树、赫夫曼树及赫夫曼编码⼀、⼆叉树的定义 如果你知道树的定义(有限个结点组成的具有层次关系的集合),那么就很好理解⼆叉树了。
定义:⼆叉树是n(n≥0)个结点的有限集,⼆叉树是每个结点最多有两个⼦树的树结构,它由⼀个根结点及左⼦树和右⼦树组成。
(这⾥的左⼦树和右⼦树也是⼆叉树)。
值得注意的是,⼆叉树和“度⾄多为2的有序树”⼏乎⼀样,但,⼆叉树不是树的特殊情形。
具体分析如下⼆、⼆叉树为何不是特殊的树 1、⼆叉树与⽆序树不同 ⼆叉树的⼦树有左右之分,不能颠倒。
⽆序树的⼦树⽆左右之分。
2、⼆叉树与有序树也不同(关键) 当有序树有两个⼦树时,确实可以看做⼀颗⼆叉树,但当只有⼀个⼦树时,就没有了左右之分,如图所⽰:三、⼆叉树的五种基本状态四、⼆叉树相关术语是满⼆叉树;⽽国际定义为,不存在度为1的结点,即结点的度要么为2要么为0,这样的⼆叉树就称为满⼆叉树。
这两种概念完全不同,既然在国内,我们就默认第⼀种定义就好)。
完全⼆叉树:如果将⼀颗深度为K的⼆叉树按从上到下、从左到右的顺序进⾏编号,如果各结点的编号与深度为K的满⼆叉树相同位置的编号完全对应,那么这就是⼀颗完全⼆叉树。
如图所⽰:五、⼆叉树的主要性质 ⼆叉树的性质是基于它的结构⽽得来的,这些性质不必死记,使⽤到再查询或者⾃⼰根据⼆叉树结构进⾏推理即可。
性质1:⾮空⼆叉树的叶⼦结点数等于双分⽀结点数加1。
证明:设⼆叉树的叶⼦结点数为X,单分⽀结点数为Y,双分⽀结点数为Z。
平衡二叉树用途
平衡二叉树用途平衡二叉树是一种特殊的二叉树结构,它具有良好的平衡性,能够提高二叉树的查找、插入和删除操作的效率。
平衡二叉树在计算机科学领域中广泛应用,特别是在数据结构和算法中。
下面将详细介绍平衡二叉树的用途。
1. 提高查找效率平衡二叉树的一个重要应用是提高查找效率。
在平衡二叉树中,每个节点的左子树和右子树的高度差不超过1,这保证了树的高度相对较低。
相比于普通的二叉搜索树,平衡二叉树的查找操作更加高效。
在平衡二叉树中查找一个元素的平均时间复杂度为O(log n),而在普通二叉搜索树中,最坏情况下的时间复杂度为O(n)。
因此,平衡二叉树适用于需要频繁进行查找操作的场景,如数据库索引、字典等。
2. 支持有序遍历平衡二叉树具有有序性的特点,可以支持有序遍历。
有序遍历是指按照节点的值从小到大或从大到小的顺序遍历二叉树。
平衡二叉树可以通过中序遍历实现有序遍历,这对于需要按照顺序获取数据的应用场景非常有用,比如按照字母顺序输出单词列表、按照时间顺序输出事件列表等。
3. 实现高效的插入和删除操作平衡二叉树对于插入和删除操作也具有很好的效率。
在普通的二叉搜索树中,如果插入或删除一个节点后导致树的不平衡,就需要通过旋转操作来重新调整树的结构,以保持平衡。
而平衡二叉树在插入和删除操作时会自动进行平衡调整,不需要额外的旋转操作。
这使得平衡二叉树在插入和删除操作上具有更好的性能表现。
4. 提供高效的范围查询平衡二叉树支持范围查询,即根据给定的范围查找满足条件的元素。
通过中序遍历平衡二叉树,可以按照节点值的顺序获取元素,然后根据范围进行筛选。
这对于需要根据范围查询数据的应用场景非常有用,比如查找某个时间段内的日程安排、查找某个价格区间内的商品等。
5. 实现高效的集合操作平衡二叉树可以用来实现高效的集合操作,如并集、交集、差集等。
通过遍历两个平衡二叉树,可以将它们的元素按照一定的规则进行合并或筛选,从而实现集合操作。
这对于需要对大量数据进行集合操作的应用场景非常有用,比如数据去重、数据合并等。
《二叉树的概念》课件
05
二叉树的应用
Chapter
在数据结构中的应用
二叉搜索树
二叉搜索树是一种特殊的二叉树,它的每个节点的左子树上的所有元素都小于 该节点,右子树上的所有元素都大于该节点。这种数据结构可以用于快速查找 、插入和删除操作。
AVL树和红黑树
这两种二叉树都是自平衡二叉搜索树,它们通过调整节点的左右子树的高度来 保持树的平衡,从而在插入、删除等操作时具有较好的性能。
VS
详细描述
平衡二叉树的特点是,它的左右子树的高 度差不会超过1,且左右子树都是平衡二 叉树。平衡二叉树的性质还包括,它的所 有叶节点的层数相等,且所有非叶节点的 左右子树的高度差不超过1。平衡二叉树 的查找、插入和删除操作的时间复杂度为 O(log n),其中n为节点数。
04
二叉树的遍历
Chapter
决策树
在机器学习和人工智能领域,决策树 是一种重要的分类和回归方法。其基 础结构就是二叉树,通过构建决策树 ,可以解决分类和回归问题。
THANKS
感谢观看
代码表示法
总结词:严谨规范
详细描述:使用编程语言的语法结构来表示二叉树,每个节点用对象或结构体表示,节点间的关系通 过指针或引用表示,严谨规范,易于编写和调试。
03
二叉树的性质
Chapter
深度最大的二叉树
总结词
深度最大的二叉树是指具有最大 可能深度的二叉树。
详细描述
在二叉树中,深度最大的二叉树 是满二叉树,即每个层级都完全 填满,没有空缺的节点。满二叉 树的深度等于其节点总数减一。
02
二叉树的表示方法
Chapter
图形表示法
总结词:直观明了
详细描述:通过图形的方式展示二叉树的结构,每个节点用圆圈或方框表示,节 点间的关系用线段表示,直观易懂,易于理解。
二叉树的遍历及其应用
0引言
所谓遍历,是指沿着某条搜索路线,依次对树中每个结点均做一次 且仅做一次访问。访问结点所做的操作依赖于具体的应用问题。 遍历 在二叉树上最重要的运算之一,是二叉树上进行其它运算之基础。二叉 树作为一种重要的数据结构是工农业应用与开发的重要工具。遍历是二 叉树算法设计中经典且永恒的话题。经典的算法大多采用递归搜索。递 归算法具有简练、清晰等优点,但因其执行过程涉及到大量的堆栈使 用,难于应用到一些严格限制堆栈使用的系统,也无法应用到一些不支 持递归的语言环境[9]。
由先序序列和中序序列来还原二叉树的过程算法思想[7]: (1)若二叉树空,返回空; (2)若不空,取先序序列第一个元素,建立根节点; (3)在中序序列中查找根节点,以此来确定左右子树的先序序列和中 序序列; (4)递归调用自己,建左子树; (5)递归调用自己,建右子树。
4二叉树的遍历的应用
根据二叉树的遍历算法, 可得出如下规律: 规律1: 前序序列遍历第一个为根结点, 后序遍历的最后一个结点为 根结点。 规律2: 前序序列遍历最后一个为根结点右子树的最右叶子结点, 中 序遍历的最后一个结点为根结点右子树的最右叶子结点。 规律3: 中序序列遍历第一个结点为根结点左子树的最左叶子结点,
1遍历二叉树的概念
所谓遍历二叉树,就是遵从某种次序,访问二叉树中的所有结点, 使得每个结点仅被访问一次。这里提到的“访问”是指对结点施行某种 操作,操作可以是输出结点信息,修改结点的数据值等,但要求这种访
问不破坏它原来的数据结构。在本文中,我们规定访问是输出结点信息 data,且以二叉链表作为二叉树的存贮结构。由于二叉树是一种非线性 结构,每个结点可能有一个以上的直接后继,因此,必须规定遍历的规 则,并按此规则遍历二叉树,最后得到二叉树所有结点的一个线性序 列[1]。