
正则表达式的汉字匹配
正则表达式的汉字匹配
这⾥是⼏个主要⾮英⽂语系字符范围2E80~33FFh:中⽇韩符号区。收容康熙字典部⾸、中⽇韩辅助部⾸、注⾳符号、⽇本假名、韩⽂⾳符,中⽇韩的符号、标点、带圈或带括符⽂数字、⽉份,以及⽇本的假名组合、单位、年号、⽉份、⽇期、时间等。3400~4DFFh:中⽇韩认同表意⽂字扩充A区,总计收容6,582个中⽇韩汉字。
4E00~9FFFh:中⽇韩认同表意⽂字区,总计收容20,902个中⽇韩汉字。
A000~A4FFh:彝族⽂字区,收容中国南⽅彝族⽂字和字根。
AC00~D7FFh:韩⽂拼⾳组合字区,收容以韩⽂⾳符拼成的⽂字。
F900~FAFFh:中⽇韩兼容表意⽂字区,总计收容302个中⽇韩汉字。
FB00~FFFDh:⽂字表现形式区,收容组合拉丁⽂字、希伯来⽂、阿拉伯⽂、中⽇韩直式标点、⼩符号、半⾓符号、全⾓符号等。
⽐如需要匹配所有中⽇韩⾮符号字符,那么正则表达式应该是^[\u3400-\u9FFF]+$ 理论上没错, 可是我到msn.co.ko随便复制了个韩⽂下来, 发现根本不对, 诡异 再到msn.co.jp复制了个'お', 也不得⾏..
然后把范围扩⼤到^[\u2E80-\u9FFF]+$, 这样倒是都通过了, 这个应该就是匹配中⽇韩⽂字的正则表达式了, 包括我們臺灣省還在盲⽬使⽤的繁體中⽂
⽽关于中⽂的正则表达式, 应该是^[\u4E00-\u9FFF]+$, 和论坛⾥常被⼈提起的^[\u4E00-\u9FA5]+$很接近
需要注意的是论坛⾥说的^[\u4E00-\u9FA5]+$这是专门⽤于匹配简体中⽂的正则表达式, 实际上繁体字也在⾥⾯, 我⽤测试器测试了下'中華⼈民共和國', 也通过了, 当然, ^[\u4E00-\u9FFF]+$也是⼀样的结果
字符需⼤写,不能随意
大于五个汉字正则 -回复

大于五个汉字正则 -回复
大于五个汉字正则表达式在正则表达式中是一种非常有用的工具,可以用于匹配大于五个汉字的文本。在本文中,我将详细介绍大于五个汉字正则表达式的构造过程,并提供一些示例和实际应用场景。
首先,让我们来看一下大于五个汉字的正则表达式是如何构造的。正则表达式是一种用于匹配文本模式的工具,它由特定的字符和符号组成。在构造大于五个汉字的正则表达式时,我们需要考虑汉字的编码和长度。
汉字的编码通常使用Unicode编码表示,每个汉字占用三个字节。在正则表达式中,我们可以使用`\u`加上四位十六进制数表示一个汉字。因此,我们可以将一个汉字表示为`\u[0-9a-fA-F]{4}`。为了匹配大于五个汉字的文本,我们可以使用量词符号`{6,}`表示大于等于六个字符。综合起来,我们可以构造出大于五个汉字的正则表达式:`\u[0-9a-fA-F]{4}{6,}`。
下面让我们来通过示例来说明如何使用大于五个汉字正则表达式。
示例一:匹配大于五个汉字的姓名
假设我们要匹配一段文本中的姓名,要求姓名必须是大于五个汉字。假设我们的文本如下:
张三,是一位善良的青年。
我们可以使用以下代码来实现匹配:
import re
text = "张三,是一位善良的青年。"
pattern = "\u[0-9a-fA-F]{4}{6,}"
results = re.findall(pattern, text) print(results)
运行上述代码后,输出结果为`['张三']`。这是因为"张三"是大于五个汉字的姓名,而其他文本不满足条件。
示例二:匹配包含大于五个汉字的句子
假设我们要匹配一段文本中的句子,要求句子中包含大于五个汉字。假设我们的文本如下:
今天是个好日子,大家都很开心。晚上一起去吃饭,我们都很期待。
我们可以使用以下代码来实现匹配:
import re
text = "今天是个好日子,大家都很开心。晚上一起去吃饭,我们都很期待。"
正则表达式(基本编码)

正则表达式(基本编码)
---恢复内容开始---
常⽤正则表达式⼤全!(例如:匹配中⽂、匹配html)
匹配中⽂字符的正则表达式: [u4e00-u9fa5]
评注:匹配中⽂还真是个头疼的事,有了这个表达式就好办了
匹配双字节字符(包括汉字在内):[^x00-xff]
评注:可以⽤来计算字符串的长度(⼀个双字节字符长度计2,ASCII字符计1)
匹配空⽩⾏的正则表达式:ns*r
评注:可以⽤来删除空⽩⾏
匹配HTML标记的正则表达式:<(S*?)[^>]*>.*?|<.*? />
评注:⽹上流传的版本太糟糕,上⾯这个也仅仅能匹配部分,对于复杂的嵌套标记依旧⽆能为⼒
匹配⾸尾空⽩字符的正则表达式:^s*|s*$
评注:可以⽤来删除⾏⾸⾏尾的空⽩字符(包括空格、制表符、换页符等等),⾮常有⽤的表达式
匹配Email地址的正则表达式:w+([-+.]w+)*@w+([-.]w+)*.w+([-.]w+)*
评注:表单验证时很实⽤
匹配⽹址URL的正则表达式:[a-zA-z]+://[^s]*
评注:⽹上流传的版本功能很有限,上⾯这个基本可以满⾜需求
匹配帐号是否合法(字母开头,允许5-16字节,允许字母数字下划线):^[a-zA-Z][a-zA-Z0-9_]{4,15}$
评注:表单验证时很实⽤
匹配国内电话号码:d{3}-d{8}|d{4}-d{7}
评注:匹配形式如 0511-4405222 或 021-87888822
匹配腾讯QQ号:[1-9][0-9]{4,}
评注:腾讯QQ号从10000开始
匹配中国邮政编码:[1-9]d{5}(?!d)
评注:中国邮政编码为6位数字
匹配⾝份证:d{15}|d{18}
评注:中国的⾝份证为15位或18位
匹配ip地址:d+.d+.d+.d+
评注:提取ip地址时有⽤
匹配特定数字:
^[1-9]d*$ //匹配正整数
正则表达式语法大全
正则表达式语法⼤全
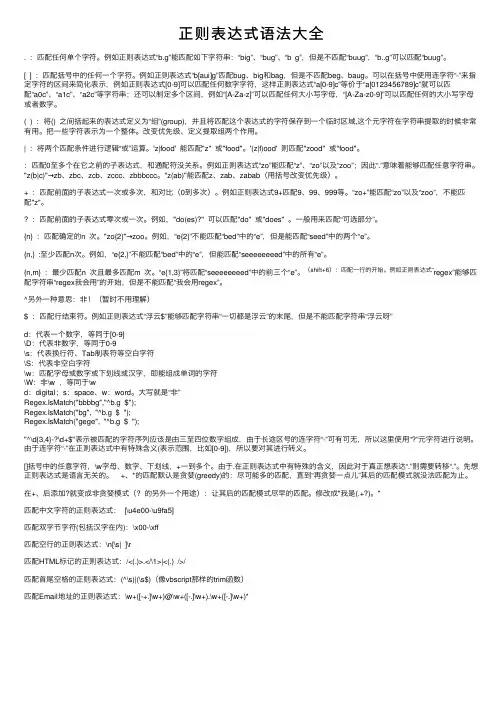
. :匹配任何单个字符。例如正则表达式“b.g”能匹配如下字符串:“big”、“bug”、“b g”,但是不匹配“buug”,“b..g”可以匹配“buug”。
[ ] :匹配括号中的任何⼀个字符。例如正则表达式“b[aui]g”匹配bug、big和bag,但是不匹配beg、baug。可以在括号中使⽤连字符“-”来指定字符的区间来简化表⽰,例如正则表达式[0-9]可以匹配任何数字字符,这样正则表达式“a[0-9]c”等价于“a[0123456789]c”就可以匹配“a0c”、“a1c”、“a2c”等字符串;还可以制定多个区间,例如“[A-Za-z]”可以匹配任何⼤⼩写字母,“[A-Za-z0-9]”可以匹配任何的⼤⼩写字母或者数字。( ) :将() 之间括起来的表达式定义为“组”(group),并且将匹配这个表达式的字符保存到⼀个临时区域,这个元字符在字符串提取的时候⾮常有⽤。把⼀些字符表⽰为⼀个整体。改变优先级、定义提取组两个作⽤。| :将两个匹配条件进⾏逻辑“或”运算。'z|food' 能匹配"z" 或"food"。'(z|f)ood' 则匹配"zood" 或"food"。
:匹配0⾄多个在它之前的⼦表达式,和通配符没关系。例如正则表达式“zo”能匹配“z”、“zo”以及“zoo”;因此“.”意味着能够匹配任意字符串。"z(b|c)"→zb、zbc、zcb、zccc、zbbbccc。"z(ab)"能匹配z、zab、zabab(⽤括号改变优先级)。
+ :匹配前⾯的⼦表达式⼀次或多次,和对⽐(0到多次)。例如正则表达式9+匹配9、99、999等。“zo+”能匹配“zo”以及“zoo”,不能匹配"z"。 :匹配前⾯的⼦表达式零次或⼀次。例如,"do(es)?" 可以匹配"do" 或"does" 。⼀般⽤来匹配“可选部分”。
{n} :匹配确定的n 次。"zo{2}"→zoo。例如,“e{2}”不能匹配“bed”中的“e”,但是能匹配“seed”中的两个“e”。
汉字、英文、数字、下划线、括号_正则表达式
汉字、英文、数字、下划线、括号 正则表达式
1. 引言
概述:
本文将详细介绍汉字、英文、数字、下划线和括号正则表达式的基本知识和应用。正则表达式是一种强大的文本模式匹配工具,可以有效地检索、替换和验证字符串。通过学习各种类型的正则表达式,读者将能够在实际的编程和文本处理任务中更加灵活地使用它们。
文章结构:
本文共分为五个部分,分别介绍汉字、英文、数字、下划线和括号的正则表达式。每个部分都包含基础知识的介绍、匹配方法的讲解以及实例与案例分析,以帮助读者更加深入地理解和应用这些正则表达式。
目的:
通过阅读本文,读者将了解如何使用正则表达式来针对不同类型的字符进行匹配,并能够根据自己的需求设计相应的模式。同时,读者还将通过实例与案例分析掌握如何在实际问题中应用不同类型的正则表达式,提高编程效率。
接下来,在第二部分“2. 汉字正则表达式”中,我们将深入探讨汉字正则表达式的基本介绍、匹配方法以及示例与应用。
2. 汉字正则表达式
2.1 基本介绍
汉字是中文的基本字符,它们在许多应用和场景中都是必不可少的。为了有效地处理和匹配汉字,我们可以使用正则表达式。
2.2 匹配方法
在正则表达式中,我们可以使用一些特殊的字符来匹配汉字。以下是一些常用的匹配规则:
- [\u4e00-\u9fa5]:这个匹配规则可以用于匹配所有的汉字。它使用了Unicode编码范围来表示汉字的范围,从\u4e00到\u9fa5。
- [一-龥]:这个匹配规则也可以用于匹配所有的汉字。它使用了Unicode编码点来表示汉字的范围,从一到龥。
具体来说,这些规则可以用在正则表达式的字符集合([...])中作为一个选项。例如,要查找一个字符串中是否包含任意一个汉字,我们可以使用类似于/[一-龥]/的正则表达式模式来实现。
2.3 示例与应用 下面是一些示例和应用场景,展示了如何使用汉字正则表达式进行匹配:
- 验证汉字:如果你想验证一个字符串是否只包含汉字,并且没有其他字符,可以使用/^[一-龥]+$/的正则表达式。这个正则表达式可以匹配一个或多个汉字,并且只能包含汉字。
vue 中文正则

vue 中文正则
Vue中文正则
Vue是一种流行的用于构建用户界面的JavaScript框架。它具有简单易学的语法和丰富的生态系统,被广泛用于开发单页应用和大型前端项目。在Vue中,我们经常需要使用正则表达式来进行字符串的匹配和处理。本文将介绍在Vue中使用中文正则表达式的方法。
一、中文正则表达式的定义
正则表达式是一种用于匹配和处理字符串的强大工具,它使用特定的语法规则来描述想要匹配的字符串模式。在中文正则表达式中,我们可以使用Unicode编码来表示中文字符。
例如,要匹配一个包含中文字符的字符串,可以使用`\p{Script=Han}`来表示中文字符。\p表示Unicode属性,Script=Han表示字符的脚本属性为汉字。因此,`\p{Script=Han}`可以匹配任意一个中文字符。
二、在Vue中使用中文正则表达式
在Vue中,我们可以通过RegExp对象来创建和使用正则表达式。Vue将正则表达式作为字符串传递给RegExp构造函数,然后将其转换为实际的正则表达式对象,以便用于字符串的匹配和处理。
以下是在Vue中使用中文正则表达式的示例:
```javascript // 定义一个包含中文字符的正则表达式
const chineseRegex = new RegExp('\\p{Script=Han}');
// 使用正则表达式匹配字符串
const result = chineseRegex.test('Hello 你好');
console.log(result); // true
```
在上述示例中,我们首先通过RegExp构造函数创建了一个中文正则表达式对象。注意,在字符串中使用中文正则表达式时,需要使用双反斜杠来转义Unicode属性的写法。
然后,我们使用test()方法来对字符串进行匹配。该方法返回一个布尔值,表示字符串是否匹配正则表达式。在本例中,由于字符串中包含中文字符,所以匹配成功,返回true。
正则判断他国语言的方法
正则判断他国语言的方法
摘要:
一、正则表达式的基本概念
二、判断他国语言的常用正则表达式
三、具体实例及解析
四、总结与建议
正文:
在国际交流日益频繁的今天,熟练掌握判断他国语言的方法显得尤为重要。正则表达式作为一种强大的文本处理工具,可以帮助我们快速识别不同的语言。本文将详细介绍如何利用正则表达式判断他国语言,并通过具体实例进行解析。
一、正则表达式的基本概念
正则表达式(Regular Expression,简称regex)是一种强大的文本搜索和匹配工具。它通过对字符串进行模式匹配,可以快速找到符合特定规则的文本。在判断他国语言的过程中,正则表达式可以帮助我们区分不同语言的特性,从而实现自动识别。
二、判断他国语言的常用正则表达式
要判断他国语言,我们需要了解各种语言的正则表达式规则。以下是一些常用语言的正则表达式:
1.汉字:`[u4e00-u9fa5]`
2.英语:`[a-zA-Z]` 3.法语:`[a-zA-Z0-9]`
4.德语:`[a-zA-Z0-9ü]`
5.西班牙语:`[a-zA-Z0-9]`
这些正则表达式分别涵盖了汉字、英文字母、法语、德语和西班牙语的特点。在实际应用中,可以根据需要添加更多语言的正则表达式。
三、具体实例及解析
以下是一个使用Python编写的判断语言的示例代码:
```python
import re
def detect_language(text):
pattern = pile(r"[u4e00-u9fa5]|[a-zA-Z]|[]|[ü]|[]")
matches = pattern.findall(text)
if len(matches) > 0:
return "Chinese"
elif len(re.findall(r"[a-zA-Z]", text)) > 0:
return "English"
提取一段话中的文字正则
提取一段话中的文字正则
全文共四篇示例,供读者参考
第一篇示例:
正则表达式是一种强大的工具,可以帮助我们在一段文本中提取特定的信息。在这个前提下,我们要提取一段话中的文字,就需要用到正则表达式。正则表达式是一种描述字符模式的符号表达式,可以在文本中进行查找、替换和匹配的操作。
在使用正则表达式提取一段话中的文字时,我们首先需要确定要提取的文字的模式。如果要提取一段话中所有的汉字,就可以使用如下的正则表达式:
[\u4e00-\u9fa5]
这个正则表达式表示匹配所有的汉字。\u4e00代表第一个汉字“一”,\u9fa5代表最后一个汉字“龥”。通过这个正则表达式,我们就可以提取一段话中的所有汉字。
[A-Za-z]+
\d+
除了这些基本的提取模式外,还可以根据实际需求编写更复杂的正则表达式。要提取一段话中所有的邮箱地址,可以使用如下正则表达式: [A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,}
第二篇示例:
正则表达式是一种强大的工具,用于在文本中查找特定模式的字符串。通过使用正则表达式,我们可以轻松地从一段文本中提取所需的信息。在本文中,我们将介绍如何编写正则表达式来提取一段话中的文字。
让我们来看一个简单的例子。假设我们有一段话如下:
"在这个世界上,最重要的事情就是做一个好人,善良待人,助人为乐。"
[\u4e00-\u9fa5]
这个正则表达式的含义是匹配所有的汉字字符。在这里,\u4e00表示汉字的开始范围,\u9fa5表示汉字的结束范围。通过使用这个正则表达式,我们可以轻松地提取出我们想要的汉字字符。
"John的手机号码是************,Mary的手机号码是************。"
我们想要提取这段话中的所有手机号码,即*************"和*************"。为了实现这个目标,我们可以编写以下正则表达式:
正则表达式用法详解
正则表达式⽤法详解
正则表达式之基本概念
在我们写页⾯时,往往需要对表单的数据⽐如账号、⾝份证号等进⾏验证,⽽最有效的、⽤的最多的便是使⽤正则表达式来验证。那什么是正则表达式呢?
正则表达式(Regular Expression)是⽤于描述⼀组字符串特征的模式,⽤来匹配特定的字符串。 它的应⽤⾮常⼴泛,特别是在字符串处理⽅⾯。其常见的应⽤如下:
验证字符串,即验证给定的字符串或⼦字符串是否符合指定的特征,例如,验证是否是合法的邮件地址、验证是否是合法的HTTP地址等等。查找字符串,从给定的⽂本当中查找符合指定特征的字符串,这样⽐查找固定字符串更加灵活。替换字符串,即查找到符合某特征的字符串之后将之替换。
提取字符串,即从给定的字符串中提取符合指定特征的⼦字符串。
第⼀部分:正则表达式之⼯具
正所谓⼯欲善其事必先利其器! 所以我们需要知道下⾯⼏个主要的⼯具:
第⼆部分:正则表达式之元字符
正则表达式中元字符恐怕是我们听得最多的了。元字符(Metacharacter)是⼀类⾮常特殊的字符,它能够匹配⼀个位置或者字符集合中的⼀个字符。 如.、\w等都是元字符。
刚刚说到,元字符既可以匹配位置,也可以匹配字符,那么我们就可以通过此来将元字符分为匹配位置的元字符和匹配字符的元字符。
A匹配位置的元字符---^、$、\b
即匹配位置的元字符只有^(脱字符号)、$(美元符号)和\b这三个字符。分别匹配⾏的开始、⾏的结尾以及单词的开始或结尾。它们匹配的都只是位置。
1.^匹配⾏的开始位置
如^zzw匹配的是以"zzw"为⾏开头的"zzw"(注意:我这⾥想要表达的是:尽管加了⼀个^,它匹配的仍是字符串,⽽不是⼀整⾏!),如果zzw不是作为⾏开头的字符串,则它不会被匹配。
2.$匹配⾏的结尾位置
如zzw$匹配的是以"zzw"为⾏结尾的"zzw"(同样,这⾥$只是匹配的⼀个位置,那个位置是零宽度,⽽不是⼀整⾏),如果zzw不是作为⾏的结尾,那么它不会被匹配。
正则表达式中w不能识别中文
正则表达式中w不能识别中⽂
正则表达式⽤于字符串处理,表单验证等场合,实⽤⾼效,但⽤到时总是不太把握,以致往往要上⽹查⼀番。我将⼀些常⽤的
表达式收藏在这⾥,作备忘之⽤。本贴随时会更新。
匹配中⽂字符的正则表达式: [\u4e00-\u9fa5]
匹配双字节字符(包括汉字在内):[^ 00- ff]
应⽤:计算字符串的长度(⼀个双字节字符长度计2,ASCII字符计1) String.prototype.len=function(){return this.replace([^ 00- ff]/g,"aa").length;}
匹配空⾏的正则表达式:\n[\s| ]*\r
匹配HTML标记的正则表达式:/<(.*)>.*<\/\1>|<(.*) \/>/
匹配⾸尾空格的正则表达式:(^\s*)|(\s*$) String.prototype.trim = function()
{
return this.replace(/(^\s*)|(\s*$)/g, "");
}
利⽤正则表达式分解和转换IP地址:
下⾯是利⽤正则表达式匹配IP地址,并将IP地址转换成对应数值的Javascript程序: function IP2V(ip)
{
re=/(\d+)\.(\d+)\.(\d+)\.(\d+)/g //匹配IP地址的正则表达式
if(re.test(ip))
{
return RegExp.$1*Math.pow(255,3))+RegExp.$2*Math.pow(255,2))+RegExp.$3*255+RegExp.$4*1
}
else
{
throw new Error("Not a valid IP address!")
}
}
不过上⾯的程序如果不⽤正则表达式,⽽直接⽤split函数来分解可能更简单,程序如下: var ip="10.100.20.168"
ip=ip.split(".")
汉字正则表达式[u4E00-u9FFF]原因
汉字正则表达式[u4E00-u9FFF]原因
转载
这⾥是⼏个主要⾮英⽂语系字符范围2E80~33FFh:中⽇韩符号区。收容康熙字典部⾸、中⽇韩辅助部⾸、注⾳符号、⽇本假名、韩⽂⾳符,中⽇韩的符号、标点、带圈或带括符⽂数字、⽉份,以及⽇本的假名组合、单位、年号、⽉份、⽇期、时间等。3400~4DFFh:中⽇韩认同表意⽂字扩充A区,总计收容6,582个中⽇韩汉字。
4E00~9FFFh:中⽇韩认同表意⽂字区,总计收容20,902个中⽇韩汉字。
A000~A4FFh:彝族⽂字区,收容中国南⽅彝族⽂字和字根。
AC00~D7FFh:韩⽂拼⾳组合字区,收容以韩⽂⾳符拼成的⽂字。
F900~FAFFh:中⽇韩兼容表意⽂字区,总计收容302个中⽇韩汉字。
FB00~FFFDh:⽂字表现形式区,收容组合拉丁⽂字、希伯来⽂、阿拉伯⽂、中⽇韩直式标点、⼩符号、半⾓符号、全⾓符号等。
⽐如需要匹配所有中⽇韩⾮符号字符,那么正则表达式应该是^[\u3400-\u9FFF]+$ 理论上没错, 可是我到msn.co.ko随便复制了个韩⽂下来, 发现根本不对, 诡异 再到msn.co.jp复制了个'お', 也不得⾏..
然后把范围扩⼤到^[\u2E80-\u9FFF]+$, 这样倒是都通过了, 这个应该就是匹配中⽇韩⽂字的正则表达式了, 包括我們臺灣省還在盲⽬使⽤的繁體中⽂\u 应该代表为Unicode编码。即在Unicode编码中4E00-9FFF为中⽂字符编码区
⽽关于中⽂的正则表达式, 应该是^[\u4E00-\u9FFF]+$, 和论坛⾥常被⼈提起的^[\u4E00-\u9FA5]+$很接近
需要注意的是论坛⾥说的^[\u4E00-\u9FA5]+$这是专门⽤于匹配简体中⽂的正则表达式, 实际上繁体字也在⾥⾯, 我⽤测试器测试了下'中華⼈民共和國', 也通过了, 当然, ^[\u4E00-\u9FFF]+$也是⼀样的结果