
中文、字母和数字的组合 正则表达式
中文、字母和数字的组合正则表达式
随着信息技术的不断发展,我们在日常生活和工作中常常会遇到需要处理中文、字母和数字的组合的情况。在处理这些文本信息时,经常需要使用正则表达式来匹配和处理特定的文本模式。本文将介绍如何使用正则表达式来匹配中文、字母和数字的组合。
一、匹配中文字符
在正则表达式中,要匹配中文字符,我们可以使用Unicode编码范围来进行匹配。中文字符的Unicode编码范围是[\u4e00-\u9fa5],所以我们可以使用[\u4e00-\u9fa5]来匹配中文字符。
要匹配一个字符串中是否包含中文字符,可以使用正则表达式:[\u4e00-\u9fa5]
二、匹配字母和数字
对于字母和数字的匹配,我们可以使用预定义的元字符来进行匹配。其中,\w可以匹配字母、数字和下划线,\d可以匹配数字。
要匹配一个字符串中包含至少一个字母和一个数字,可以使用正则表达式:\w+\d+ 或者 [a-zA-Z]+[0-9]+
三、匹配中文、字母和数字的组合 要匹配中文、字母和数字的组合,我们可以将上面介绍的中文字符的匹配和字母、数字的匹配进行组合使用。如果我们需要匹配一个字符串中是否同时包含中文、字母和数字,可以使用如下的正则表达式:
[\u4e00-\u9fa5]+\w+\d+ 或者 [\u4e00-\u9fa5a-zA-Z0-9]+
这样就可以匹配同时包含中文、字母和数字的组合。
四、其他匹配规则
在实际应用中,我们可能还需要考虑一些特殊情况,比如中文、字母和数字的组合可能出现在字符串的任意位置,也可能不是连续的。这时,我们可以使用更灵活的正则表达式来进行匹配,比如使用*来代表0个或多个字符的出现,使用+来代表1个或多个字符的出现,使用?来代表0个或1个字符的出现等。
总结
在处理中文、字母和数字的组合时,我们可以通过使用合适的正则表达式来进行匹配和处理。在实际应用中,可以根据具体的需求和情况来选择合适的正则表达式,从而更加方便地处理文本信息。
在使用正则表达式时,还需要注意不同编程语言或工具对正则表达式的支持和语法规则可能略有不同,因此在具体的应用中需要结合具体的环对中文、字母和数字的组合进行正则表达式匹配的需求在实际的信息处理中经常出现。在文本处理、数据提取、搜索引擎的关键词匹配、信息过滤等方面都有可能涉及到这一问题。正则表达式(regular
expression)是一种强大的文本匹配工具,它可以帮助我们快速、准确地实现对特定文本模式的匹配和处理。
那么对于中文、字母和数字的组合,我们究竟如何使用正则表达式来进行匹配呢?下面我们将结合具体的示例来具体分析。
1. 匹配中文、字母和数字的组合
我们需要明确我们的需求,比如我们要匹配一个字符串中是否包含同时包含中文、字母和数字的组合。我们可以使用以下的正则表达式:
[\u4e00-\u9fa5]+\w+\d+
这个正则表达式的意思是:首先匹配至少一个中文字符,然后匹配至少一个字母,最后匹配至少一个数字,这样就可以实现中文、字母和数字的组合的匹配。
2. 针对特殊情况的处理
在实际的使用中,我们可能会遇到一些特殊情况,比如中文、字母和数字的组合可能出现在字符串的任意位置,也可能不是连续的。这时,我们可以使用更灵活的正则表达式来进行匹配。我们可以使用*来代表0个或多个字符的出现,使用+来代表1个或多个字符的出现,使用?来代表0个或1个字符的出现等。如果我们要匹配的中文、字母和数字可能是任意顺序组合,则可以使用如下的正则表达式:
[\u4e00-\u9fa5]*\w*\d*
这个正则表达式意味着:匹配0个或多个中文字符,0个或多个字母,0个或多个数字,这样就可以匹配中文、字母和数字的任意组合。
3. 实际应用举例
为了更好地理解如何使用正则表达式来匹配中文、字母和数字的组合,在这里我们举一个简单的实际应用例子。假设我们需要从一段包含中文、英文和数字混合的文本中提取出所有的中文、英文和数字的组合。我们可以使用以下的正则表达式来实现这一目的:
([\u4e00-\u9fa5]+|[a-zA-Z]+|\d+)
这个正则表达式的意思是:匹配至少一个中文字符或者至少一个英文字符或者至少一个数字字符,这样就可以实现提取中文、英文和数字的组合的目的。
在实际应用中,我们可以根据具体的需求来选择合适的正则表达式,并结合具体的编程语言或工具来进行相应的处理。不同的编程语言或工具对于正则表达式的支持和语法规则有所不同,因此在具体的应用时需要结合具体的环境和要求来进行处理。
总结:正则表达式是一种强大的文本匹配工具,对中文、字母和数字的组合进行匹配时,我们可以根据具体的需求和情况选择合适的正则表达式,并结合具体的编程语言或工具进行相应的处理。希望本文的介绍能够对读者在实际的应用中有所帮助。
正则表达式:密码必须至少包含八个字符、至少包含一个数字、小写和大写的字母以及特殊字符

正则表达式:密码必须⾄少包含⼋个字符、⾄少包含⼀个数字、
⼩写和⼤写的字母以及特殊字符
密码的正则表达式如何来写?
我需要⼀个正则表达式来检查密码:
密码⾄少包含⼋个字符、⾄少包含⼀个数字、同时包含⼩写字母和⼤写字母以及特殊字符,例如#,?,!)
不能是旧密码或包含⽤户名,"password"或"websitename"这⾥是我的验证表达式,⽤于限制:⼋个字符,包括⼀个⼤写字母,⼀个⼩写字母和⼀个数字或特殊字符。(?=^.{8,}$)((?=.*\d)|(?=.*\W+))(?![.\n])(?=.*[A-Z])(?=.*[a-z]).*$"那么,如何写⼀个正则,限制密码必须是⼋个字符,包括⼀个⼤写字母,⼀个特殊字符和字母数字字符?
最佳解决思路
⾄少⼋个字符,⾄少⼀个字母和⼀个数字:"^(?=.*[A-Za-z])(?=.*\d)[A-Za-z\d]{8,}$"⾄少⼋个字符,⾄少⼀个字母,⼀个数字和⼀个特殊字符:"^(?=.*[A-Za-z])(?=.*\d)(?=.*[$@$!%*#?&])[A-Za-z\d$@$!%*#?&]{8,}$"最少⼋个字符,⾄少⼀个⼤写字母,⼀个⼩写字母和⼀个数字:"^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)[a-zA-Z\d]{8,}$"⾄少⼋个字符,⾄少⼀个⼤写字母,⼀个⼩写字母,⼀个数字和⼀个特殊字符:"^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[$@$!%*?&])[A-Za-z\d$@$!%*?&]{8,}"最少⼋个最多⼗个字符,⾄少⼀个⼤写字母,⼀个⼩写字母,⼀个数字和⼀个特殊字符:"^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[$@$!%*?&])[A-Za-z\d$@$!%*?&]{8,10}"
次佳解决思路
可以使⽤这个正则表达式:^(?=.*?[A-Z])(?=.*?[a-z])(?=.*?[0-9])(?=.*?[#?!@$%^&*-]).{8,}$这个正则表达式将强制执⾏这些规则:
excel提取汉字字母和数字混合字符中的数字函数

标题:Excel中提取汉字、字母和数字混合字符中的数字的函数应用
1. 概述
在日常工作和学习中,我们经常会遇到需要从字符串中提取数字的情况。在Excel中,有很多函数可以帮助我们实现这一目的,提高工作效率。本文将介绍如何利用Excel函数提取汉字、字母和数字混合字符中的数字,帮助大家更加高效地处理数据。
2. 使用LEFT、RIGHT和MID函数提取数字
如果要提取混合字符中的数字,可以使用LEFT、RIGHT和MID函数。这些函数分别用于提取字符串的前几个字符、最后几个字符和中间的字符,结合使用可以轻松实现提取数字的功能。
2.1 使用LEFT函数提取数字
LEFT函数用于提取字符串的前几个字符,其语法为:``LEFT(文本, 字符数)``。要提取字符串A1中的前3个字符,可以使用如下公式:``=LEFT(A1, 3)``。
2.2 使用RIGHT函数提取数字
RIGHT函数用于提取字符串的最后几个字符,其语法为:``RIGHT(文本, 字符数)``。要提取字符串A1中的后3个字符,可以使用如下公式:``=RIGHT(A1, 3)``。
2.3 使用MID函数提取数字
MID函数用于提取字符串的中间字符,其语法为:``MID(文本,
起始位置, 字符数)``。要提取字符串A1中从第2个字符开始的3个字符,可以使用如下公式:``=MID(A1, 2, 3)``。
3. 使用正则表达式提取数字
除了以上介绍的函数外,还可以使用正则表达式提取数字。Excel中并没有直接支持正则表达式的函数,但可以通过自定义函数的方式实现正则表达式的功能。
3.1 编写自定义函数
可以使用VBA编写自定义函数,通过正则表达式匹配字符串中的数字并进行提取。下面是一个使用正则表达式提取数字的VBA函数:
JS只能输入数字,数字和字母等的正则表达式

JS只能输⼊数字,数字和字母等的正则表达式
1.只能输⼊英⽂
2.只能输⼊中⽂、英⽂、数字、@符号和.符号
3.只能输⼊字母和汉字
4.只能输⼊英⽂字母和数字,不能输⼊中⽂
5.只能输⼊英⽂字母和数字,不能输⼊中⽂
正则表达式:英文、中文、数字、下划线
正则表达式:英⽂、中⽂、数字、下划线
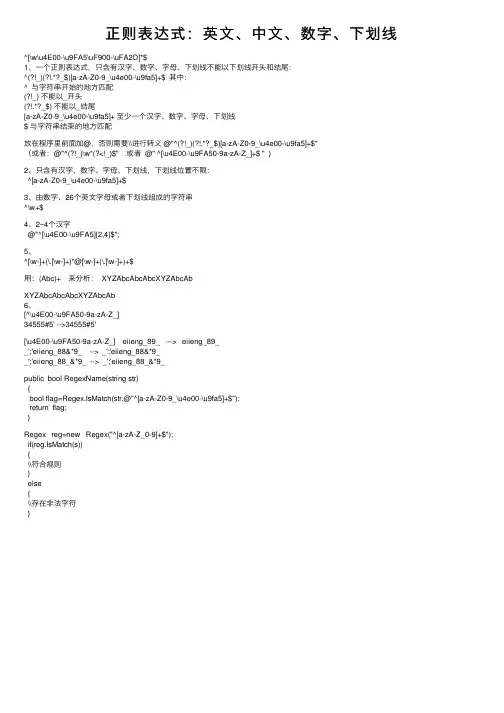
^[\w\u4E00-\u9FA5\uF900-\uFA2D]*$
1、⼀个正则表达式,只含有汉字、数字、字母、下划线不能以下划线开头和结尾:
^(?!_)(?!.*?_$)[a-zA-Z0-9_\u4e00-\u9fa5]+$ 其中:
^ 与字符串开始的地⽅匹配
(?!_) 不能以_开头
(?!.*?_$) 不能以_结尾
[a-zA-Z0-9_\u4e00-\u9fa5]+ ⾄少⼀个汉字、数字、字母、下划线
$ 与字符串结束的地⽅匹配
放在程序⾥前⾯加@,否则需要\\进⾏转义 @"^(?!_)(?!.*?_$)[a-zA-Z0-9_\u4e00-\u9fa5]+$"
(或者:@"^(?!_)\w*(?
2、只含有汉字、数字、字母、下划线,下划线位置不限:
^[a-zA-Z0-9_\u4e00-\u9fa5]+$
3、由数字、26个英⽂字母或者下划线组成的字符串
^\w+$
4、2~4个汉字
@"^[\u4E00-\u9FA5]{2,4}$";
5、
^[\w-]+(\.[\w-]+)*@[\w-]+(\.[\w-]+)+$
⽤:(Abc)+ 来分析: XYZAbcAbcAbcXYZAbcAb
XYZAbcAbcAbcXYZAbcAb
6、
[^\u4E00-\u9FA50-9a-zA-Z_]
34555#5' -->34555#5'
[\u4E00-\u9FA50-9a-zA-Z_] eiieng_89_ ---> eiieng_89_
_';'eiieng_88&*9_ --> _';'eiieng_88&*9_
_';'eiieng_88_&*9_ --> _';'eiieng_88_&*9_
public bool RegexName(string str)
{
bool flag=Regex.IsMatch(str,@"^[a-zA-Z0-9_\u4e00-\u9fa5]+$");
字母数字下划线常用正则表达式
字母数字下划线常⽤正则表达式
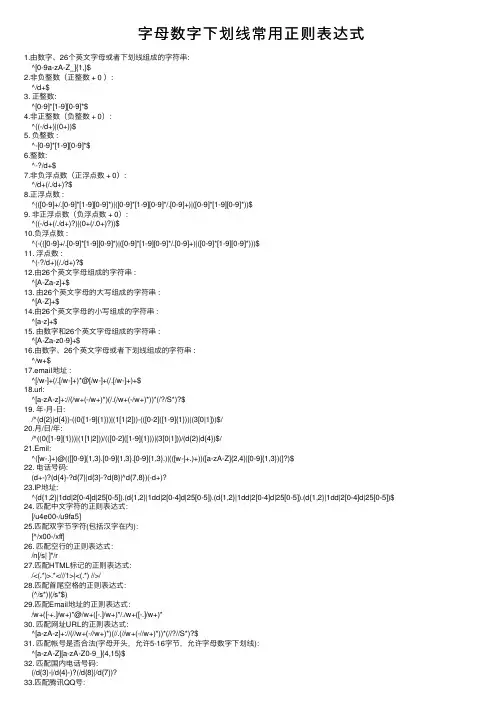
1.由数字、26个英⽂字母或者下划线组成的字符串:
^[0-9a-zA-Z_]{1,}$
2.⾮负整数(正整数 + 0 ):
^/d+$
3. 正整数:
^[0-9]*[1-9][0-9]*$
4.⾮正整数(负整数 + 0):
^((-/d+)|(0+))$
5. 负整数 :
^-[0-9]*[1-9][0-9]*$
6.整数:
^-?/d+$
7.⾮负浮点数(正浮点数 + 0):
^/d+(/./d+)?$
8.正浮点数 :
^(([0-9]+/.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*/.[0-9]+)|([0-9]*[1-9][0-9]*))$
9. ⾮正浮点数(负浮点数 + 0):
^((-/d+(/./d+)?)|(0+(/.0+)?))$
10.负浮点数 :
^(-(([0-9]+/.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*/.[0-9]+)|([0-9]*[1-9][0-9]*)))$
11. 浮点数 :
^(-?/d+)(/./d+)?$
12.由26个英⽂字母组成的字符串 :
^[A-Za-z]+$
13. 由26个英⽂字母的⼤写组成的字符串 :
^[A-Z]+$
14.由26个英⽂字母的⼩写组成的字符串 :
^[a-z]+$
15. 由数字和26个英⽂字母组成的字符串 :
^[A-Za-z0-9]+$
16.由数字、26个英⽂字母或者下划线组成的字符串 :
^/w+$
17.email地址 :
^[/w-]+(/.[/w-]+)*@[/w-]+(/.[/w-]+)+$
18.url:
^[a-zA-z]+://(/w+(-/w+)*)(/.(/w+(-/w+)*))*(/?/S*)?$
19. 年-⽉-⽇:
/^(d{2}|d{4})-((0([1-9]{1}))|(1[1|2]))-(([0-2]([1-9]{1}))|(3[0|1]))$/
【正则表达式】-匹配中文字符
【正则表达式】-匹配中⽂字符
\w匹配的仅仅是中⽂,数字,字母,对于国⼈来讲,仅匹配中⽂时常会⽤到,见下
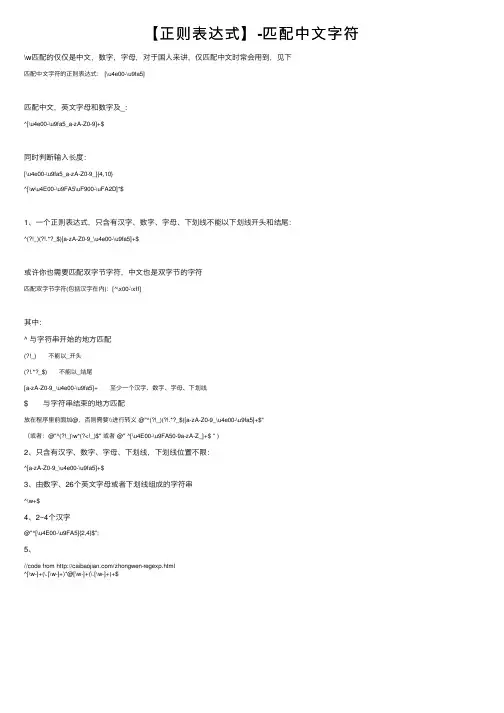
匹配中⽂字符的正则表达式: [\u4e00-\u9fa5]
匹配中⽂,英⽂字母和数字及_:
^[\u4e00-\u9fa5_a-zA-Z0-9]+$
同时判断输⼊长度:
[\u4e00-\u9fa5_a-zA-Z0-9_]{4,10}
^[\w\u4E00-\u9FA5\uF900-\uFA2D]*$
1、⼀个正则表达式,只含有汉字、数字、字母、下划线不能以下划线开头和结尾:
^(?!_)(?!.*?_$)[a-zA-Z0-9_\u4e00-\u9fa5]+$
或许你也需要匹配双字节字符,中⽂也是双字节的字符
匹配双字节字符(包括汉字在内):[^\x00-\xff]
其中:
^ 与字符串开始的地⽅匹配
(?!_) 不能以_开头
(?!.*?_$) 不能以_结尾
[a-zA-Z0-9_\u4e00-\u9fa5]+ ⾄少⼀个汉字、数字、字母、下划线
$ 与字符串结束的地⽅匹配
放在程序⾥前⾯加@,否则需要\\进⾏转义 @"^(?!_)(?!.*?_$)[a-zA-Z0-9_\u4e00-\u9fa5]+$"
(或者:@"^(?!_)\w*(?
^[a-zA-Z0-9_\u4e00-\u9fa5]+$
3、由数字、26个英⽂字母或者下划线组成的字符串
^\w+$
4、2~4个汉字
@"^[\u4E00-\u9FA5]{2,4}$";
5、
//code from /zhongwen-regexp.html^[\w-]+(\.[\w-]+)*@[\w-]+(\.[\w-]+)+$
数字和字母,特殊字符的正则
- 1 - 数字和字母,特殊字符的正则
正则表达式是一种文本模式匹配的工具,它可以用来匹配字符串中的数字、字母和特殊字符。以下是一些常用的正则表达式:
1. 匹配数字:d
d可以匹配任何一个数字。例如,正则表达式d+可以匹配一个或多个数字。如果要匹配一个特定的数字,可以使用d{n},其中n是数字的数量。
2. 匹配字母:[a-zA-Z]
[a-zA-Z]可以匹配任何一个字母,不区分大小写。例如,正则表达式[a-zA-Z]+可以匹配一个或多个字母。如果要匹配一个特定的字母,可以使用[a-zA-Z]{n},其中n是字母的数量。
3. 匹配特殊字符:W
W可以匹配任何一个非字母和非数字的字符。例如,正则表达式W+可以匹配一个或多个特殊字符。如果要匹配一个特定的特殊字符,可以使用W{n},其中n是特殊字符的数量。
综上所述,使用正则表达式可以方便地匹配字符串中的数字、字母和特殊字符,使得文本处理更加高效。
6到20位的数字或者大小写字母或者数字的正则表达式
6到20位的数字或者大小写字母或者数字的正则表达式
摘要:
1.引言:介绍正则表达式的概念
2.正则表达式的组成:数字、字母、字符类
3.示例:编写一个匹配 6 到 20 位的数字或者大小写字母或者数字的正则表达式
4.结论:总结正则表达式的应用场景和注意事项
正文:
正则表达式是一种强大的文本处理工具,可以用来检查和处理文本数据。它可以用来查找特定的文本模式、验证输入的数据格式等。正则表达式主要由三类字符组成:数字、字母和字符类。
数字表示匹配数字,字母表示匹配字母,而字符类则表示匹配一组字符。常见的字符类包括 [a-zA-Z] 表示匹配所有英文字母,[0-9] 表示匹配所有数字,等等。
现在,让我们编写一个匹配 6 到 20 位的数字或者大小写字母或者数字的正则表达式。可以使用以下表达式:
```
^(?=.*[a-zA-Z])(?=.*d)[a-zA-Zd]{6,20}$
```
这个正则表达式的含义是:
- `^`表示匹配字符串的开头 - `(?=.*[a-zA-Z])`表示必须至少包含一个大写字母
- `(?=.*d)`表示必须至少包含一个数字
- `[a-zA-Zd]{6,20}`表示匹配 6 到 20 位的数字或者大小写字母或者数字
- `$`表示匹配字符串的结尾
正则表达式在许多编程语言和文本编辑器中都有应用,如 Python、Java、JavaScript 等。使用正则表达式时,需要注意避免一些常见的错误,如贪婪匹配、不匹配的字符等。
总之,正则表达式是一种强大的文本处理工具,可以用来检查和处理文本数据。
最全常用正则表达式大全
最全常⽤正则表达式⼤全
⼀、校验数字的表达式
1. 数字:^[0-9]*$
2. n位的数字:^\d{n}$
3. ⾄少n位的数字:^\d{n,}$
4. m-n位的数字:^\d{m,n}$
5. 零和⾮零开头的数字:^(0|[1-9][0-9]*)$
6. ⾮零开头的最多带两位⼩数的数字:^([1-9][0-9]*)+(.[0-9]{1,2})?$
7. 带1-2位⼩数的正数或负数:^(\-)?\d+(\.\d{1,2})?$
8. 正数、负数、和⼩数:^(\-|\+)?\d+(\.\d+)?$
9. 有两位⼩数的正实数:^[0-9]+(.[0-9]{2})?$
10. 有1~3位⼩数的正实数:^[0-9]+(.[0-9]{1,3})?$
11. ⾮零的正整数:^[1-9]\d*$ 或 ^([1-9][0-9]*){1,3}$ 或 ^\+?[1-9][0-9]*$
12. ⾮零的负整数:^\-[1-9][]0-9"*$ 或 ^-[1-9]\d*$
13. ⾮负整数:^\d+$ 或 ^[1-9]\d*|0$
14. ⾮正整数:^-[1-9]\d*|0$ 或 ^((-\d+)|(0+))$
15. ⾮负浮点数:^\d+(\.\d+)?$ 或 ^[1-9]\d*\.\d*|0\.\d*[1-9]\d*|0?\.0+|0$
16. ⾮正浮点数:^((-\d+(\.\d+)?)|(0+(\.0+)?))$ 或 ^(-([1-9]\d*\.\d*|0\.\d*[1-9]\d*))|0?\.0+|0$
17. 正浮点数:^[1-9]\d*\.\d*|0\.\d*[1-9]\d*$ 或 ^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$
18. 负浮点数:^-([1-9]\d*\.\d*|0\.\d*[1-9]\d*)$ 或 ^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*)))$
包含数字、字母、下划线、点和减号的正则表达式
包含数字、字母、下划线、点和减号的正则表达式
在本文中,我将为您深入探讨包含数字、字母、下划线、点和减号的正则表达式。正则表达式是一种强大的工具,用于在文本中进行模式匹配和搜索。它可以帮助我们查找特定的字符串模式,从而能够在数据处理、文本搜索和匹配等方面发挥重要作用。
1. 正则表达式的概念和作用
正则表达式是一种由字符和操作符组成的字符串,它描述了一种字符串匹配的模式。通过使用正则表达式,我们可以在文本中查找、替换和提取特定的字符串模式。它可以用来验证输入的格式、搜索文本中的特定模式以及进行字符串的替换等操作。在正则表达式中,包含数字、字母、下划线、点和减号等特定字符的匹配,可以帮助我们进行更精确的模式匹配。
2. 了解数字、字母、下划线、点和减号的正则表达式模式
在正则表达式中,我们可以使用一些特定的元字符来匹配数字、字母、下划线、点和减号等字符。使用\d来匹配数字,\w来匹配字母和下划线,\.来匹配点,-来匹配减号等。通过组合这些元字符和其他正则表达式操作符,我们可以构建出包含数字、字母、下划线、点和减号的复杂匹配模式。
3. 在实际应用中如何使用包含数字、字母、下划线、点和减号的正则表达式
在实际的数据处理和文本搜索中,我们经常会遇到需要匹配包含数字、字母、下划线、点和减号的字符串模式。比如在验证用户的输入格式时,我们可以使用包含数字、字母、下划线、点和减号的正则表达式来确认输入是否符合我们的要求。在处理数据时,如果我们需要从文本中提取特定格式的信息,也可以通过包含数字、字母、下划线、点和减号的正则表达式来实现精确的匹配和提取。
4. 个人观点和总结
正则表达式作为一种强大的模式匹配工具,在数据处理和文本搜索中具有不可替代的作用。包含数字、字母、下划线、点和减号的正则表达式可以帮助我们实现对特定字符串模式的精确匹配和处理。在实际应用中,我们可以根据具体的需求,灵活运用正则表达式来实现数据验证、信息提取等操作。这种灵活、精确的匹配方式,能够极大地提高我们的工作效率和数据处理准确性。我个人认为掌握正则表达式,并深入理解包含数字、字母、下划线、点和减号的正则表达式模式,是非常重要和有益的。