
union all在sqlserver中的用法
union all在sqlserver中的用法
UNION ALL 是 SQL Server 中的一个操作符,用于合并两个或多个 SELECT 语句的结果集。它与 UNION 操作符类似,但不会去重。
UNION ALL 的语法如下:
SELECT column1, column2, ...
FROM table_name1
UNION ALL
SELECT column1, column2, ...
FROM table_name2
...
UNION ALL
SELECT column1, column2, ...
FROM table_nameN;
其中,column1、column2 等表示要查询的列名,table_name1、table_name2 等表示要查询的表名或视图名。
使用 UNION ALL 操作符时,结果集将会返回两个或多个
SELECT 语句的结果的并集,包括重复的行。它会保留所有的行,不会去重。
注意事项:
- UNION ALL 要求 SELECT 语句的列数必须相同,且相应的列的数据类型必须兼容。
- UNION ALL 的优先级比 UNION 更低,如果同时使用 UNION 和 UNION ALL,应使用括号来明确操作的顺序。
- UNION ALL 是一个比较高效的操作符,因为它不会进行去重操作,但同时也会返回重复的结果行。
SQL常用语句,子查询整理

SQL常用语句,子查询整理
一、SQL子查询语句
1、单行子查询
select ename,deptno,sal
from emp
where deptno=(select deptno from dept where loc='NEW YORK');
2、多行子查询
SELECT ename,job,sal
FROM EMP
WHERE deptno in ( SELECT deptno FROM dept WHERE dname LIKE 'A%');
3、多列子查询
SELECT deptno,ename,job,sal
FROM EMP
WHERE (deptno,sal) IN (SELECT deptno,MAX(sal) FROM EMP GROUP BY
deptno);
4、内联视图子查询
(1)SELECT ename,job,sal,rownum
FROM (SELECT ename,job,sal FROM EMP ORDER BY sal);
(2)SELECT ename,job,sal,rownum
FROM ( SELECT ename,job,sal FROM EMP ORDER BY sal)
WHERE rownum<=5;
5、在HAVING子句中使用子查询
SELECT deptno,job,AVG(sal) FROM EMP GROUP BY deptno,job HAVING
AVG(sal)>(SELECT sal FROM EMP WHERE ename='MARTIN');
SQLServer中WithAS语句的用法及注意事项

SQL Server中With AS语句的用法及注意事项
做数据库程序几年了,居然今天才发现有这么好一个语句:with as,实在惭愧。
所谓with as你可以把他看做一个语句片段,也可以看做一个临时表(我是这么
认为的)。我们可以利用with as语句对查询出的结果进行二次处理,比如汇总、
分类、求平均数等,实在是太方便了。
with as语法:with 数据表别名 as (select * from ...)
实际应用实例:
with t as (select * from emp where depno=10)
select * from t where empno=xxx
union all sum(col1) as colsum from t
看到了吧?可以很方便的对这个临时表t进行过滤、汇总等操作。而且这种方法
比其它的sql语句效率要高很多!
需要注意的是,with as(CTE)属于sql server2005及以上版本才拥有的功能,
如果在sql server 2000上执行,会提示错误“WITH附近有语法错误”。
SQL2

SQL操作全集
下列语句部分是Mssql语句,不可以在access中使用。
SQL分类:
DDL—数据定义语言(CREATE,ALTER,DROP,DECLARE)
DML—数据操纵语言(SELECT,DELETE,UPDATE,INSERT)
DCL—数据控制语言(GRANT,REVOKE,COMMIT,ROLLBACK)
首先,简要介绍基础语句:
1、说明:创建数据库
CREATE DATABASE database-name
2、说明:删除数据库
drop database dbname
3、说明:备份sql server
--- 创建 备份数据的 device
USE master
EXEC sp_addumpdevice 'disk', 'testBack', 'c:\mssql7backup\MyNwind_1.dat'
--- 开始 备份
BACKUP DATABASE pubs TO testBack
4、说明:创建新表
create table tabname(col1 type1 [not null] [primary key],col2 type2 [not null],..)
根据已有的表创建新表:
A:create table tab_new like tab_old (使用旧表创建新表)
B:create table tab_new as select col1,col2… from tab_old definition only
5、说明:删除新表drop table tabname
6、说明:增加一个列
Alter table tabname add column col type
注:列增加后将不能删除。DB2中列加上后数据类型也不能改变,唯一能改变的是增加varchar类型的长度。
7、说明:添加主键: Alter table tabname add primary key(col)
SQL 命令大全
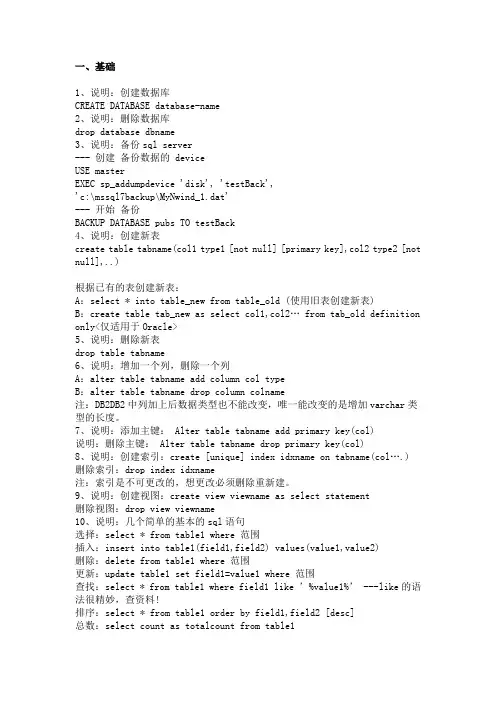
一、基础
1、说明:创建数据库
CREATE DATABASE database-name
2、说明:删除数据库
drop database dbname
3、说明:备份sql server
--- 创建 备份数据的 device
USE master
EXEC sp_addumpdevice 'disk', 'testBack',
'c:\mssql7backup\MyNwind_1.dat'
--- 开始 备份
BACKUP DATABASE pubs TO testBack
4、说明:创建新表
create table tabname(col1 type1 [not null] [primary key],col2 type2 [not
null],..)
根据已有的表创建新表:
A:select * into table_new from table_old (使用旧表创建新表)
B:create table tab_new as select col1,col2„ from tab_old definition
only
5、说明:删除新表
drop table tabname
6、说明:增加一个列,删除一个列
A:alter table tabname add column col type
B:alter table tabname drop column colname
注:DB2DB2中列加上后数据类型也不能改变,唯一能改变的是增加varchar类型的长度。
7、说明:添加主键: Alter table tabname add primary key(col)
说明:删除主键: Alter table tabname drop primary key(col)
8、说明:创建索引:create [unique] index idxname on tabname(col„.)
SQL命令大全

下列语句部分是Mssql语句,不可以在access中使用。
SQL分类:
DDL类型包括数据库、表的创建,修改,删除,声明—数据定义语言(CREATE,ALTER,DROP,DECLARE)
DML类型包括数据表中记录的查询,删除,修改,插入—数据操纵语言(SELECT,DELETE,UPDATE,INSERT)
DCL类型包括数据库用户赋权,废除用户访问权限, 提交当前事务,中止当前事务—数据控制语言(GRANT,REVOKE,COMMIT,ROLLBACK)
首先,简要介绍基础语句:
1、说明:创建数据库
CREATE DATABASE db1(db1代表数据库表,可自命名)
2、说明:删除数据库
drop database db1(db1代表数据库表,可自命名)
3、说明:备份sql server
--- 创建 备份数据的 device
USE master
EXEC sp_addumpdevice 'disk', 'testBack', 'c:\mssql7backup\MyNwind_1.dat'
--- 开始 备份
BACKUP DATABASE pubs TO testBack
4、说明:创建新表 create table tb1(Id int not null primary key,name varchar,..)(tb1为数据表名,ID为字段,int为数据类型整型,not null为数据是否可为空,Primary Key为主键设置,其中not null,primary key为可选项,字段,数据类型自定义。)
根据已有的表创建新表:
A:create table tab_new like tab_old (使用旧表创建新表)
B:create table tab_new as select col1,col2… from tab_old definition only
5、说明:
SQL进阶教程1-7用SQL进行集合运算:比较两个表是否相等、用差集实现关系除法运算、寻找。。。

SQL进阶教程1-7⽤SQL进⾏集合运算:⽐较两个表是否相等、
⽤差集实现关系除法运算、寻找。。。
集合运算符的参数是集合,从数据库实现层⾯上来说就是表或者视图。
注意事项:
1.SQL能够操作具有重复⾏的集合,可以通过可选项ALL来⽀持。
⼀般的集合论是不允许集合⾥⾯存在重复元素的,因此集合{1,1,2,3,3}和集合{1,2,3}被视为相同的集合,但是关系数据库的表允许存在重复的⾏,称为多重集合。 ALL的作⽤和SELECT⼦句⾥⾯的DISTINCT可选项刚好相反。
1.SQL集合运算符也提供了允许重复和不允许重复的两种⽤法,如果直接使⽤UNION或者INTERSECT,结果⾥就不会出现重复的⾏。
如果想在结果⾥⾯留下重复⾏,可以加上可选项ALL。写作UNION ALL。
2. 集合运算符为了排除掉重复⾏,默认地会发⽣排序,⽽加上可选项ALL之后,就不再排序,所以性能会有提升。这是常⽤的⾮常有效地⽤于优化查询性能的⽅法,
所以如果不关⼼是否存在重复⾏,或者确定结果⾥⾯不会产⽣重复⾏,加上可选项ALL会更好些。
2.集合运算符有优先级
标准SQL规定,INTERSECT⽐UNION和EXCEPT优先级更⾼,因此,当同事使⽤UNION和INTERSECT,⼜想让UNION优先执⾏时,必须⽤括号明确地指定运算顺序。
3.各个DBMS提供商在集合运算的实现程度上参差不齐。
早期的SQL对集合运算的⽀持程度不是很⾼,受到这⼀影响,各个数据库提供商的实现程度也参差不齐。
SQL Server从2005版开始⽀持INTERSECT 和EXCEPT,⽽MySQL还都不⽀持。 还有像Oracle这样,实现了EXCEPT功能但是却命名为MINUS的数据库。
4.除法运算没有标准定义。
四则运算⾥⾯的 和(UNION) 差(EXCEPT) 积(CROSS JOIN) 商都被引⼊了标准的SQL,但是商并没有标准化,需要⾃⼰写SQL实现。 5.⽐较表和表
SQLServer2008数据库查看死锁、堵塞的SQL语句
SQLServer2008数据库查看死锁、堵塞的SQL语句
死锁和堵塞⼀直是性能测试执⾏中关注的重点。
下⾯是我整理的监控sql server数据库,在性能测试过程中是否出现死锁、堵塞的SQL语句,还算⽐较准备,留下来备⽤。
--每秒死锁数量
SELECT * FROM sys.dm_os_performance_counters WHERE counter_name LIKE 'Number of Deadlocksc%';
--查询当前阻塞
WITH CTE_SID ( BSID, SID, sql_handle )
AS ( SELECT blocking_session_id ,
session_id ,
sql_handle
FROM sys.dm_exec_requests
WHERE blocking_session_id <> 0
UNION ALL
SELECT A.blocking_session_id ,
A.session_id ,
A.sql_handle
FROM sys.dm_exec_requests A
JOIN CTE_SID B ON A.SESSION_ID = B.BSID
)
SELECT C.BSID ,
C.SID ,
S.login_name ,
S.host_name ,
S.status ,
S.cpu_time ,
S.memory_usage ,
st_request_start_time ,
st_request_end_time ,
S.logical_reads ,
S.row_count ,
q.text
FROM CTE_SID C
JOIN sys.dm_exec_sessions S ON C.sid = s.session_id
CROSS APPLY sys.dm_exec_sql_text(C.sql_handle) Q
ORDER BY sid
在压⼒测试过程中,不间断的按F5键执⾏上⾯的SQL语句,如果出现死锁或者堵塞现象,就会在执⾏结果中罗列出来。如果每次连续执⾏SQL,都有死锁或者堵塞出现,说明死锁或者堵塞的⽐较严重。
经典SQL语句大全(超全)
1 一、基础
1、说明:创建数据库
CREATE DATABASE database-name
2、说明:删除数据库
drop database dbname
3、说明:备份sql server
--- 创建 备份数据的 device
USE master
EXEC sp_addumpdevice 'disk', 'testBack', 'c:\mssql7backup\MyNwind_1.dat'
--- 开始 备份
BACKUP DATABASE pubs TO testBack
4、说明:创建新表
create table tabname(col1 type1 [not null] [primary key],col2 type2
[not null],..)
根据已有的表创建新表:
A:create table tab_new like tab_old (使用旧表创建新表)
B:create table tab_new as select col1,col2„ from tab_old definition only
5、说明:删除新表
drop table tabname
6、说明:增加一个列
Alter table tabname add column col type
注:列增加后将不能删除。DB2中列加上后数据类型也不能改变,唯一能改变的是增加varchar类型的长度。
7、说明:添加主键: Alter table tabname add primary key(col)
说明:删除主键: Alter table tabname drop primary key(col)
8、说明:创建索引:create [unique] index idxname on tabname(col„.)
删除索引:drop index idxname
注:索引是不可更改的,想更改必须删除重新建。
oracle语法
oracle语法
1、说明:创建数据库
CREATE DATABASE database-name
2、说明:删除数据库
drop database dbname
3、说明:备份sql server
--- 创建 备份数据的 device
USE master
EEC sp_addumpdevice 'disk', 'testBack',
'c:\mssql7backup\MyNwind_1.dat'
---开始备份
BACKUP DATABASE pubs TO testBack
4、说明:创建新表
create table tabname(col1 type1 [not null] [primary
key],col2 type2 [not null],..)
根据已有的表创建新表:
A:select into table_new from table_old (使⽤旧表创建新表)
B:create table tab_new as select col1,col2… from tab_old
definition only<;仅适⽤于Oracle> 5、说明:删除新表
drop table tabname
6、说明:增加⽤个列,删除⽤个列
A:alter table tabname add column col type
B:alter table tabname drop column colname
注:DB2DB2中列加上后数据类型也不能改变,唯⽤能改变的是增加varchar类型的长度。
7、说明:添加主键: Alter table tabname add primary key(col)
说明:删除主键: Alter table tabname drop primary key(col)
8、说明:创建索引:create [unique] index idxname on
tabname(col….)
SQLSERVER-WITHAS用法
SQLSERVER-WITHAS⽤法
⼀.WITH AS的含义 WITH AS短语,也叫做⼦查询部分(subquery factoring),可以让你做很多事情,定义⼀个SQL⽚断,该SQL⽚断会被整个SQL语句所⽤到。有的时候,是为了让SQL
语句的可读性更⾼些,也有可能是在UNION ALL的不同部分,作为提供数据的部分。
特别对于UNION ALL⽐较有⽤。因为UNION ALL的每个部分可能相同,但是如果每个部分都去执⾏⼀遍的话,则成本太⾼,所以可以使⽤WITH AS短语,则只要执⾏⼀遍
即可。如果WITH AS短语所定义的表名被调⽤两次以上,则优化器会⾃动将WITH AS短语所获取的数据放⼊⼀个TEMP表⾥,如果只是被调⽤⼀次,则不会。⽽提⽰materialize则是强制将WITH AS短语⾥的数据放⼊⼀个全局临时表⾥。很多查询通过这种⽅法都可以提⾼速度。
⼆.使⽤⽅法
先看下⾯⼀个嵌套的查询语句:
select * from person.StateProvince where CountryRegionCode in
(select CountryRegionCode from person.CountryRegion where Name like 'C%')
上⾯的查询语句使⽤了⼀个⼦查询。虽然这条SQL语句并不复杂,但如果嵌套的层次过多,会使SQL语句⾮常难以阅读和维护。因此,也可以使⽤表变量的⽅式来解决这
个问题,SQL语句如下:
declare @t table(CountryRegionCode nvarchar(3))
insert into @t(CountryRegionCode) (select CountryRegionCode from person.CountryRegion where Name like 'C%')
select * from person.StateProvince where CountryRegionCode