
字模生成原理
字模生成原理
本设计中因为使用汉字的点阵显示,需要提取汉字字模,因此我们首先来了解汉字点阵字模的提取方法。
汉字的点阵字模是从点阵字库文件中提取出来的。
例如常用的16×16点阵HZK16文件,12×12点阵HZK12文件等等,这些文件包括了GB 2312字符集中的所有汉字。
现在只要弄清汉字点阵在字库文件中的格式,就可以按照自己的意愿去显示汉字了。
下面以HZK16文件为例,分析取得汉字点阵字模的方法。
HZK16文件是按照GB 2312-80标准,也就是通常所说的国标码或区位码的标准排列的。
国标码分为94 个区(Section),每个区94 个位(Position),所以也称为区位码。
其中01~09 区为符号、数字区,16~87 区为汉字区。
而10~15 区、88~94 区是空白区域。
如何取得汉字的区位码呢?在计算机处理汉字和ASCII字符时,使每个ASCII字符占用1个字节,而一个汉字占用两个字节,其值称为汉字的内码。
其中第一个字节的值为区号加上32(20H),第二个字节的值为位号加上32(20H)。
为了与ASCII字符区别开,表示汉字的两个字节的最高位都是1,也就是两个字节的值都又加上了128(80H)。
这样,通过汉字的内码,就可以计算出汉字的区位码。
具体算式如下:
qh=c1-32-128=c1-160 wh=c2-32-128=c2-160
或
qh=c1-0xa0 wh=c2-0xa0
qh,wh为汉字的区号和位号,c1,c2为汉字的第一字节和第二字节。
根据区号和位号可以得到汉字字模在文件中的位置:
location=(94*(qh-1)+(wh-1))*一个点阵字模的字节数。
那么一个点阵字模究竟占用多少字节数呢?我们来分析一下汉字字模的具体排列方式。
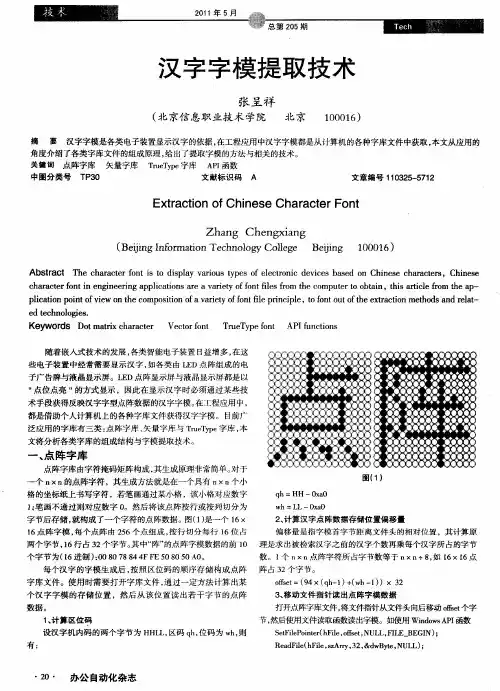
例如下图中显示的“汉”字,使用16×16点阵。
字模中每一点使用一个二进制位(Bit)表示,如果是1,则说明此处有点,若是0,则说明没有。
这样,一个16×16点阵的汉字总共需要16*16/8=32个字节表示。
字模的表示顺序为:先从左到右,再从上到下,也就是先画左上方的8个点,再是右上方的8个点,然后是第二行左边8个点,右边8个点,依此类推,画满16×16个点。
对于其它点阵字库文件,则也是使用类似的方法进行显示。
例如HZK12,但是HZK12文件的格式有些特别,如果你将它的字模当作12*12位计算的话,根本无法正常显示汉字。
因为字库设计者为了使用的方便,字模每行的位数均补齐为8的整数倍,于是实际该字库的位长度是16*12,每个字模大小为24字节,虽然每行都多出了4位,但这4位都是0(不显示),并不影响显示效果。
还有UCDOS下的HZK24S(宋体)、HZK24K(楷体)或HZK24H(黑体)这些打印字库文件,每个字模占用24*24/8=72字节,不过这类大字模汉字库为了打印的方便,将字模都放倒了,所以在显示时要注意把横纵方向颠倒过来就可以了。
这样我们就完全清楚了如何得到汉字的点阵字模,这样就可以在程序中随意的显示汉字了。
5.7.2 字模提取程序
如果在程序中使用的汉字数目不多,也可以不必总是在程序里带上几百K的字库文件,也
许你的程序才只有几十K。
这样可以事先将所需要显示的汉字字模提取出来,放在另一个文件里,按照自己的顺序读取文件就可以了。
下面的程序说明了具体显示汉字的方法,以16×16汉字为例,使用HZK16文件。
#include<stdio.h>
#include<graphics.h>
/* x,y为显示坐标,s为显示字符串,colour为颜色*/
void hanzi16(int x,int y,char *s,int colour)
{
FILE *fp;
char buffer[32]; /* 32字节的字模缓冲区*/
register i,j,k;
unsigned char qh,wh;
unsigned long location;
if((fp=fopen("hzk16","rb"))==NULL)
{
printf("Can't open hzk16!");
getch();
exit(0);
}
while(*s)
{
qh=*s-0xa0;
wh=*(s+1)-0xa0;
location=(94*(qh-1)+(wh-1))*32L; /* 计算汉字字模在文件中的位置*/
fseek(fp,location,SEEK_SET);
fread(buffer,1,32,fp);
for(i=0;i<16;i++)
for(j=0;j<2;j++)
for(k=0;k<8;k++)
if(((buffer[i*2+j]>>(7-k))&0x1)!=NULL)
putpixel(x+8*j+k,y+i,colour);
s+=2;
x+=16; /* 汉字间距*/
}
fclose(fp);
}
main()
{
int gd=DETECT,gm;
initgraph(&gd,&gm,"");
hanzi16(246,200,"****************************!",BROWN);
getch();
closegraph();
}
在TC 2.0下运行上面程序,就在屏幕上打印出你想要显示的汉字,例如该程序运行后会在屏幕上显示:**************************!
程序中每次将一个汉字的点阵字模存储于buffer[32]缓冲数组里面,因此我们可以编程从该缓冲数据组里面取出对应汉字的点阵模存储于另的一个数组里面,然后可以通过PC机串口发送给单片机,最后显示在LED点阵显示屏上。
在制作过程中我是用了别人已经写好了的点阵字模提取软件来提取点阵字模。
汉字字模提取技术
随着嵌 入式技术 的发展 , 各类智能 电子装置 日益增多 , 在这
pi t n o t f i e o oio vr t o n l p n il,o ot u eet ci e o s n l - l a o i e o t mps i o a aiy fo t e r cpe t f t fh r t nm t d dr a c i p n ov w n h c t n f e f f i i n o ot x a o h a et e c n l e. dt h o g s e o i
每个汉字 的字模生 成后 , 照区位码的顺序存储构成 点阵 阵 占 3 个 字 节 。 按 2 字库 文件 。使 用时需要打开字库文件 , 通过一定方法计算 出某 个汉 字字模 的存 储位置 ,然后从 该位置读 出若 干字节 的点 阵 数据 。
1计 算 区位 码 、 设 汉 字机 内码 的两 个 字 节 为 H L , H L 区码 q , 码 为 w , h位 h则
1 阵 字模 , 个 点 阵 由 2 6个 点 组 成 , 行 切 分 每 行 1 6点 每 5 按 6位 占
个 字 节 为 ( 6进 制 )0 07 4 FF 08 0A 。 1 :0 88 4 E5 05 O 8
2 计算汉字点阵数据存储位置偏移量 、
偏 移 量 是 指 字模 首 字 节距 离 文 件 头 的相 对 位 置 ,其 计 算原
一
个 n Xn的点阵字符 ,其生成方法就是 在一个具有 nXn 个小
汉字字模介绍

串行数据存储器 如 AT45DB041B 等 特点是占用口线少 体积小和成本低 如果对于速度要求不 是很高的场合非常适宜
三 硬件汉字库使用电路
在本节中 笔者使用 PHILIPS 公司的产品 P89C51RD2 作为主控 CPU 使用内置 T6963 控制器的 240
即区位码 机内码 0A0AOH 就 国 字而言 其区位码和机内码的关系为 195AH 区位码 0B9FAH 机内码 0A0A0H
记住这个关系 是我们理解下面有关程序的关键 2 国标汉字字符集与区位码 根据对汉字使用频率程度的研究 可把汉字分成高频字 约 100 个 常用字 约 3000 个 次常用 字 约 4000 字 罕见字 约 8000 个 和死字 约 45000 个 即正常使用的汉字达 15000 个 我国 1981 年公布了 通讯用汉字字符集 基本集 及其交换码标准 GB2312-80 方案 把高频字 常用字和次常用 字集合成汉字基本字符集 共 6763 个 在该字符集中按汉字使用的频度 又将其分为一级汉字 3755 个 按 拼音排序 二级汉字 3008 个 按部首排序 再加上西文字母 数字 图形符号等 700 个 国家标准的汉
广州周立功单片机发展有限公司 Tel: (020)38730976 38730977 Fax: 38730925
硬件汉字库设计原理与应用
青岛海洋大学 PHILIPS 单片机实验室 綦声波 刘滨 马志强
摘要 本文论述了硬件汉字库的基本原理和具体制作步骤 并利用 P89C51RD2 作为主控 CPU 240 128 点阵的液晶和硬件汉字库 将一部科幻小说嵌入其中 开机后即可阅读 文章中给出了具体的电路和相应 的软件
人工智能文本生成模型

人工智能文本生成模型随着人工智能技术的快速发展,文本生成模型成为了研究的热点之一。
人工智能文本生成模型通过深度学习算法和大数据的支持,能够自动生成高质量的文章、新闻、评论等文本内容。
本文将探讨人工智能文本生成模型的原理、应用领域以及未来的发展趋势。
一、人工智能文本生成模型的原理人工智能文本生成模型的核心原理是通过大数据集的训练,建立起一个深度神经网络模型。
该模型能够自动学习语言的规律和规则,并在此基础上生成新的文本内容。
具体而言,文本生成模型主要包括以下几个关键组成部分:1. 语言模型:语言模型是文本生成模型的基础,其目的是学习并理解语言的结构和规则。
通过对大量文本数据的训练,模型能够预测下一个单词或句子的出现概率。
常用的语言模型包括n-gram模型和循环神经网络模型。
2. 自动生成模型:基于语言模型的基础上,生成模型能够自动创作文本。
生成模型包括了生成式对抗网络(GAN)、变分自动编码器(VAE)等模型,能够根据给定的主题或条件生成符合语法和语义规则的文本。
二、人工智能文本生成模型的应用领域人工智能文本生成模型已经在多个领域得到了广泛的应用。
以下是几个重要的应用领域的介绍:1. 文章写作:人工智能文本生成模型可以帮助写作,辅助撰写文章。
它能够根据给定的主题、关键词或条件来生成高质量的文章内容,提高写作效率和质量。
2. 新闻报道:人工智能文本生成模型可以实现自动化的新闻报道。
在快速获取新闻信息的基础上,模型能够根据事实和数据生成具有条理和可读性的新闻报道。
3. 电商评论:人工智能文本生成模型可以用于生成电商评论。
通过学习大量的用户评论数据,模型能够生成真实、准确的评论,提供给用户参考和选择。
4. 智能客服:人工智能文本生成模型可以用于智能客服系统中。
通过分析用户问题和回答,模型能够生成合适的回复,提供给用户解决问题。
三、人工智能文本生成模型的未来发展趋势人工智能文本生成模型在未来的发展中还有很大的潜力和发展空间。
活字印刷术的制作工艺

活字印刷术的制作工艺活字印刷术是一种使用模具制作活字的印刷技术,它是由金属、木材、石膏等材料制作而成的字模,通过排列组合形成印版,再将墨水涂抹在字模上,最后将纸张印刷在字模上。
这项技术的制作工艺有以下几个主要的步骤。
首先,活字印刷术的制作工艺需要准备字模的制作材料。
在古代,金属、木材、石膏等材料都被用于制作字模。
金属字模制作需要先将供应商提供的金属材料进行加工,通常是将金属材料熔化并注入特定的模具中,然后通过冷却和切割来得到所需的字形。
木材字模则需要选取适合的木材进行切割和雕刻,而石膏字模制作则需要使用适合的石料进行雕刻和打磨。
其次,制作字模的工艺需要对字形进行设计和加工。
在设计字形时,制版工艺师需要考虑字形的美观、可读性和印刷质量。
在金属字模制作过程中,可以使用计算机辅助设计工具进行字模的3D设计和模拟。
在木材和石膏字模制作过程中,可以使用雕刻刀、铣床和打磨工具来手工制作字模。
无论哪种方法,都需要制版工艺师具备一定的艺术和工艺能力,以确保字模的精度和质量。
然后,制作完成的字模需要进行排版和组合。
排版是将字模按照字母或汉字的顺序进行组合,然后将其固定在印版上。
传统的排版方法需要手动将字模放入印版中,并使用工具来调整字模的位置和间距。
而现代印刷技术则使用数控技术和自动化设备来自动完成排版和组合的工作。
排版的目的是为了能够在印刷过程中准确地将墨水传递到纸张上,以获得清晰和准确的印刷效果。
最后,印刷工艺是将制作完成的活字排版放置在印刷机上进行印刷。
印刷机可以使用墨水辊和压力辊来将墨水传递到纸张上,并通过适当的压力确保墨水能够均匀地覆盖字模表面。
印刷机的设计和技术不同,但其原理都是基于相同的原理。
在印刷过程中,活字将在纸张上留下墨迹,形成文字和图片。
总结起来,活字印刷术的制作工艺包括字模的制作材料准备、字形的设计和制作、排版和组合以及印刷工艺。
这些步骤需要制版工艺师具备一定的工艺和技术能力,以确保活字印刷术能够产生高质量和准确的印刷效果。
ai造字方法

ai造字方法AI造字方法概述AI造字方法是利用人工智能技术来生成全新的字形和字体。
这些方法使用机器学习和神经网络等技术,分析和模拟人类书写的方式,从而创造出独特的字形。
本文将介绍几种常见的AI造字方法。
1. 字形生成方法字形生成方法主要是通过训练神经网络来生成新的字形。
以下是几种常用的字形生成方法:•循环生成模型(Recurrent Generative Models):这种方法使用循环神经网络(RNN)来学习和模拟人类书写的轨迹,从而生成新的字形。
RNN可以捕捉到字形的连续性和自相似性,能够生成具有自然流动感的字形。
•变分自动编码器(Variational Autoencoders):这种方法通过学习书写的变量和生成的变量之间的关系,来生成新的字形。
变分自动编码器能够生成多样性的字形,且具有较好的可控性。
•生成对抗网络(Generative Adversarial Networks):这种方法使用生成器和判别器的博弈过程来生成新的字形。
生成器生成候选字形,判别器评估字形的真实性,通过不断的对抗和迭代,生成器可以逐渐生成高质量的字形。
2. 字体生成方法字体生成方法不仅仅生成单个的字形,还能生成整个字体集合。
以下是几种常用的字体生成方法:•对抗生成网络(Adversarial GenerativeNetworks):这种方法将生成对抗网络应用于字体生成。
生成器生成整个字体集合的样本,判别器评估样本的真实性。
通过对抗和迭代,生成器逐渐生成具有自然流畅和多样性的字体集合。
•条件生成模型(Conditional Generative Models):这种方法考虑到不同条件对字体生成的影响。
通过设定条件,比如字体的风格、大小等,生成模型可以根据不同条件生成不同风格和特征的字体。
•迁移学习(Transfer Learning):这种方法通过利用已有字体的知识,将其转移到生成新字体的过程中。
通过学习已有字体的特征和规律,生成模型可以生成具有类似特征的新字体,同时减少训练的时间和数据需求。
原理——汉字字模提取技术
字节。 offset=(94×(qh–1) +(wh–1)) ×32 (3)移 动 文 件 指 针 读 出 点 阵 字 模 数 据 打开点阵字库文件, 将文件指针从文件头向 后 移 动 offset 个
字节, 然后使 用 文 件 读 取 函 数 读 出 字 模 。 如 使 用 Windows API 函 数:
以 UCDOS 的汉字矢 量 字 库 HZKPS××J 为 例 , 该 字 库 由 指 针 区与数据区两部分组成。每个汉字矢量指针占 6 个字节, 其格式 为: 前 4 个字节为汉字的矢量数据在文件中的偏移, 后 2 个字节 为汉字的矢量数据的长度。汉字指针在指针区的偏移由公式计 算:
pos=((qu- 16)*94+wei- 1)*6 ( 注:qu- - 区号 wei- - 位号) 根据 pos 读取 6 个字节, 前 4 个字节组合为一个偏移量定位 文件指针, 后两个字节的值作为需要读出的字节长度, 即可以读
本栏目责任编辑: 谢媛媛
开发研究与设计技术
汉字字模提取技术
张呈祥 ( 北京信息职业技术学院 自动化工程系, 北京 100016)
摘要: 汉字字模是各类电子装置显示汉字的依据, 在工程应用中汉字字模都是从计算机的各种字库文件中获取, 本文从应用的角度 介绍了各类字库文件的组成原理, 给出了提取字模的方法与相关的技术。
关键词: 点阵字库; 矢量字库; TrueType 字库; API 函数 中图分类号: TP 3 文献标识码: A 文章编号: 1009- 3044(2007)19- 40185- 02
Acquiring Technique of Chines e Character Matrix ZHANG Cheng- xiang
TrueType 字体, 但在 DSP 控制的大型显示屏的汉字显示中仍然是
大模型文本生成原理
大模型文本生成原理大模型文本生成技术的原理基于深度学习中的自回归模型架构,尤其是Transformer模型结构,如GPT(Genera tive Pretrained Transformer)系列模型。
以下是其基本工作原理:1. 预训练:大模型首先在大规模无标签文本数据上进行预训练,学习语言的基本规律和模式。
这个过程通常采用自监督学习的方式,例如使用掩码语言模型(Masked Language Model, M LM)或自回归语言模型(Autoregressive Language Model)的目标函数。
2. 自回归生成:在自回归生成过程中,模型逐个预测下一个词的概率,给定一个上下文输入,模型会根据之前预测出的序列部分来预测下一个单词。
以GPT为例,在生成新文本时,模型从一个起始提示符开始,并在其基础上迭代预测下一个词汇,每次预测都会作为下一次迭代的输入的一部分,直到生成结束符号或者达到预设的最大生成长度。
3. Transformer架构:GPT和其他大型语言模型采用了Transformer架构,该架构摒弃了传统的循环神经网络(RNN)或长短时记忆网络(LSTM),转而使用多头注意力机制,能够并行处理输入序列的信息,从而实现高效的训练和推理。
4. 参数量与表达能力:大模型之所以被称为“大”,是因为它们具有极高的参数量,如数十亿到数万亿个参数,这使得它们能够捕捉到极其复杂的语言结构和模式,以及细微的语义差别,从而更准确地生成自然流畅且内容丰富的文本。
5. 微调与任务适应:预训练完成后,模型可以根据特定任务的需求进行微调,通过在有限标注数据集上进一步训练,使模型能更好地适应文本生成、问答、摘要生成等各种下游自然语言处理任务。
总结来说,大模型文本生成的关键在于其强大的参数规模、先进的Transformer架构、大规模预训练数据集以及自回归式的生成策略,这些共同作用使得模型能够高效地学习和模拟人类语言的复杂性,进而生成高质量的新文本内容。
字模提取原理
5.7点阵字模生成原理与方法[3]5.7.1 字模生成原理本设计中因为使用汉字的点阵显示,需要提取汉字字模,因此我们首先来了解汉字点阵字模的提取方法。
汉字的点阵字模是从点阵字库文件中提取出来的。
例如常用的16×16点阵HZK16文件,12×12点阵HZK12文件等等,这些文件包括了GB 2312字符集中的所有汉字。
现在只要弄清汉字点阵在字库文件中的格式,就可以按照自己的意愿去显示汉字了。
下面以HZK16文件为例,分析取得汉字点阵字模的方法。
HZK16文件是按照GB 2312-80标准,也就是通常所说的国标码或区位码的标准排列的。
国标码分为 94 个区(Section),每个区 94个位(Position),所以也称为区位码。
其中01~09 区为符号、数字区,16~87 区为汉字区。
而 10~15 区、88~94 区是空白区域。
如何取得汉字的区位码呢?在计算机处理汉字和ASCII字符时,使每个ASCII字符占用1个字节,而一个汉字占用两个字节,其值称为汉字的内码。
其中第一个字节的值为区号加上32(20H),第二个字节的值为位号加上32(20H)。
为了与ASCII字符区别开,表示汉字的两个字节的最高位都是1,也就是两个字节的值都又加上了128(80H)。
这样,通过汉字的内码,就可以计算出汉字的区位码。
具体算式如下:qh=c1-32-128=c1-160 wh=c2-32-128=c2-160或qh=c1-0xa0 wh=c2-0xa0qh,wh为汉字的区号和位号,c1,c2为汉字的第一字节和第二字节。
根据区号和位号可以得到汉字字模在文件中的位置:location=(94*(qh-1)+(wh-1))*一个点阵字模的字节数。
那么一个点阵字模究竟占用多少字节数呢?我们来分析一下汉字字模的具体排列方式。
例如下图中显示的“汉”字,使用16×16点阵。
字模中每一点使用一个二进制位(Bit)表示,如果是1,则说明此处有点,若是0,则说明没有。
汉字取模原理
汉字的取模原理手工取模原理(详解)因本人这个取模原理也搞了一天,网上也没有现成的资料,包括纵向和横向取模,对照网上各位所说慢慢摸索,最终把原理搞清楚,最后写出来给大家参照一下。
这里,我们先以英文和中文来说明,说明前我们先统一标准。
标准1:显示大小为16*16,显示的像素为1,不显示的为0。
标准2:显示大小为16*16,显示的像素为0,不显示的为1.有的显示要“字节倒序”,主要是显示器的要求不一样。
这里我们用标准1.解说以下图片:1.英文”A”字的取模,我们这里采用横向,横向取模为“高位在左”,方式是按单片机的内存每一位的排列,排列方式为“7.6.5.4.3.2.1.0”,显示的为1,不显示的为0,这里文字大小采用小4,占用像素为8*16。
1.1.我们按图把要显示的字用“1”填起来,图片显示为用1做的“A”,再把没有显示的用“0”填起来。
1.2.我们从Y轴的16行到Y轴第1行,一行一行的取,取8位二进制码,每行方向从左到右取数,再把二进制码用“8421”码转换成16进制码,分别是。
二进制汇编十六进制C语言十六进制Y轴第16行00000000B 00H 0X00Y轴第15行00000000B 00H 0X00Y轴第14行00000000B 00H 0X00Y轴第13行00010000B 10H 0X10Y轴第12行00010000B 10H 0X10Y轴第11行00011000B 18H 0X18Y轴第10行00101000B 28H 0X28Y轴第9行00101000B 28H 0X28Y轴第8行00100100B 24H 0X24Y轴第7行00111100B 3CH 0X3CY轴第6行01000100B 44H 0X44Y轴第5行01000010B 42H 0X42Y轴第4行01000010B 42H 0X42Y轴第3行11100111B 0E7H 0XE7Y轴第2行00000000B 00H 0X00Y轴第1行00000000B 00H 0X00整理汇编为; DB 00H,00H,00H,10H,10H,18H,28H,28H,24H,3CH,44H,42H,42H,0E7H,00H,00H1.3.英文的纵向取模,纵向取模的高位在下。
汉字的显示原理
汉字一般是以点阵式存储的,如16×16,24×24点阵,汉字的字模其实是汉字字形的图形化,所谓16点阵字模,就是把汉字写在一个16×16的网格内,汉字的笔划通过某网格时该网格就对应1,否则该网络对应0,这样,每一网络均对应1或0,把对应1的网格连起来看,就是这个汉字,汉字就是这样通过字节表示其点阵存储在字符字库中的,为了方便查找所需汉字的点阵,每个汉字都与一个双字节的内码一一对应,通过汉字的内码可以计算出它的点阵起始字节。
现以16点阵为例来进行说明,首先,可由内码计算出他在汉字库中的区位码,其计算公式为:bq=bn1-160bw=bn2-160式中,bq表示区码,bw为表示位码,而bn1和bn2则分别表示内码的第一字节和内码的第二字节。
当这些区位码被计算出来之后,就可以用区位码得到它在汉字库中字模第一个字节的位置,即:(bq×94+bw)×32这样,接下来就可以向连续读出由32个字节组成的该字的点阵数据。
主要器件介绍◇ 显示模块lm12864lm12864是内置了hd61202u控制器的128×64点阵式液晶显示器,lm12864的显示区域被分为左右两个区,均为64×64大小,左右区的选择由csa和csb的组合来决定,当csa、csb的组合为01时,选择左区,当二者的组合为10时,选择右区,二者组合为00或11时均无效,lm12864内置的hd61202u为一可编程器件,通过对hd61202u控制器的编程可以实现液晶显示器的各种功能,所有显示功能均可由指令控制实现,本系统共有7条指令。
◇ flash存储器串行flash存储器以其体积小、密度高、功耗低、操作易而备受青睐,本文简单介绍了megawin公司生产的flash存储器mm36sb020e,mm36sb020e为2m×8bit串行flash,大小为256kbyte,接线方式可采用2线和3线制,器件的忙判断可以由内部的状态寄存器来判断,也可以通过外部引脚busy来判断,可以说,该flash不仅操作十分简单,并且可以适用于多个设计方案。